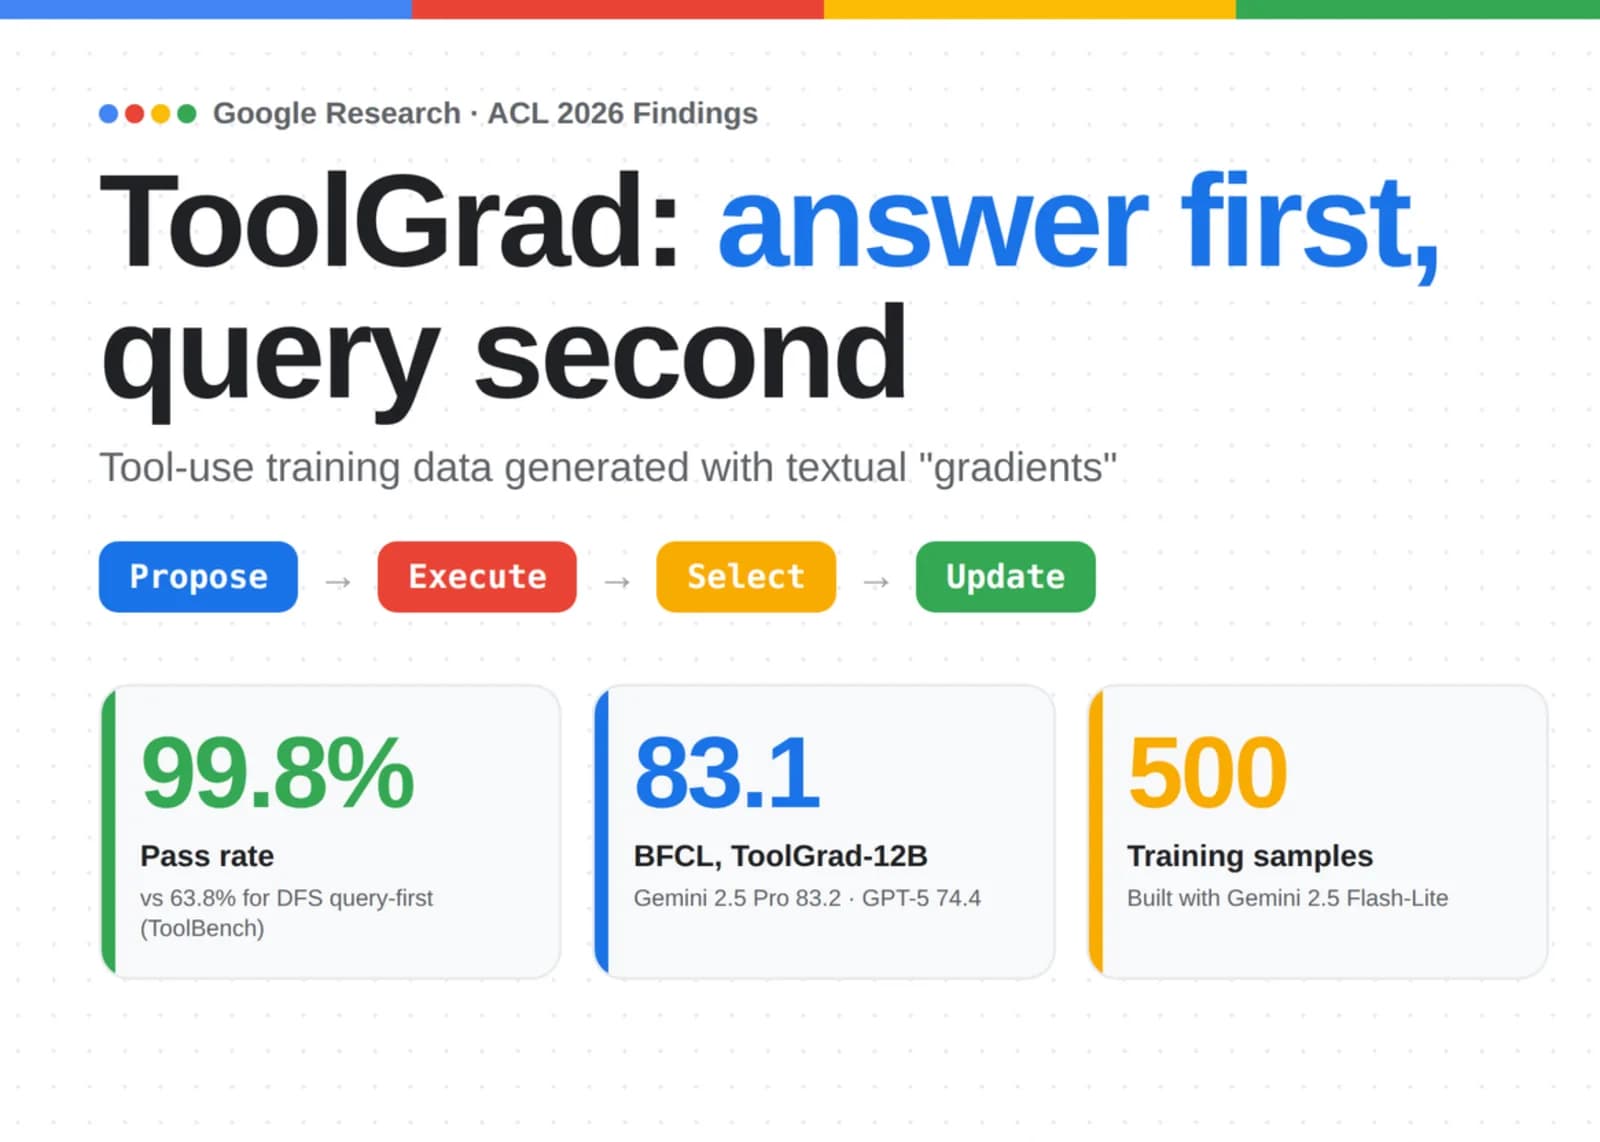
Entrenar un modelo de lenguaje para que invoque herramientas de forma confiable exige conjuntos de datos que emparejen consultas de usuario con cadenas correctas de uso de herramientas. Producir esos datos a escala ha sido lento y caro. Un equipo de investigadores de Google, la Universidad de Tokio, RIKEN AIP y la Universidad de Tohoku presentó ToolGrad, un trabajo que invierte el orden habitual: primero se construye una cadena de herramientas verificada y después se escribe la consulta. Modelos Gemma-3 ajustados con 500 muestras de esos datos alcanzan puntajes que se codean con los modelos propietarios de frontera en el Berkeley Function Calling Leaderboard.
¿Se puede usar hoy? Sí. El código está bajo licencia Apache 2.0, el conjunto de datos ToolGrad-500 y los modelos de 1B, 4B y 12B están en Hugging Face, y existe además un paquete en PyPI.
¿Cuál es el problema de generar la consulta primero?
Los métodos previos, como ToolBench y ToolACE, siguen una receta que parte por la consulta. El sistema toma una muestra de un conjunto de interfaces de programación, le pide a un modelo de lenguaje que invente una instrucción de usuario plausible y después despacha un agente de búsqueda en profundidad para encontrar un camino de herramientas que la satisfaga. Esa búsqueda no tiene garantía de éxito. Cuando llega a un callejón sin salida, el cómputo gastado en explorar se pierde y la muestra se descarta. El artículo describe ese esquema como destilar trayectorias valiosas desde una exploración compleja y a menudo fallida, algo intrínsecamente ineficiente.
ToolGrad invierte el orden. Primero construye una cadena de uso de herramientas de referencia ejecutando las interfaces de verdad, y luego anota esa cadena con la consulta de usuario que le corresponde. Una cadena explícita y funcionando es mucho menos ambigua que una instrucción hipotética, así que el paso de cadena a consulta se resuelve con una sola llamada al modelo.
Cuatro módulos en un ciclo
Cada iteración corre cuatro módulos en secuencia:
- Proponente de interfaces: reduce un conjunto muestreado de interfaces a unas pocas candidatas capaces de extender el flujo de trabajo actual.
- Ejecutores: corren esas candidatas en paralelo y producen reportes detallados de ejecución.
- Selector: revisa los reportes, elige la única llamada de mejor desempeño y la añade al flujo. Su retroalimentación direccional es lo que los autores llaman el gradiente textual.
- Actualizador: reescribe la consulta sintética del usuario y la respuesta para que calcen con el nuevo conjunto de interfaces.
Repetir el ciclo produce una muestra: una consulta de usuario, un flujo de trabajo verificado y la respuesta final. La configuración por omisión del repositorio corre 10 iteraciones sobre 50 interfaces muestreadas por flujo.
Los números de eficiencia
El equipo evaluó la generación de datos sobre la base de ToolBench, que contiene más de 16.000 interfaces del mundo real, y comparó ToolGrad contra el enfoque de búsqueda en profundidad. Según el artículo de investigación:
| Métrica | Búsqueda en profundidad | ToolGrad |
|---|---|---|
| Tasa de éxito | 63,8% | 99,8% |
| Usos de herramienta por muestra | 2,1 | 3,4 |
| Pasos de herramienta por muestra | 34,3 | 20,0 |
| Invocaciones al modelo por muestra | 64,5 | 63,9 |
La lectura de esa tabla es la parte interesante: las cadenas resultantes son más largas, con 3,4 usos de herramienta por muestra en vez de 2,1, y sin embargo requieren casi la mitad de pasos para llegar ahí. El costo en llamadas al modelo se mantiene prácticamente igual. El 0,2% de casos fallidos ocurrió cuando el agente no logró una respuesta exitosa desde tres interfaces seleccionadas a lo largo de las diez iteraciones y guardó una muestra vacía.
¿Qué tan lejos llega un Gemma-3 con 500 muestras?
Los investigadores generaron ToolGrad-500, un conjunto de 500 muestras construido con Gemini 2.5 Flash-Lite, y lo usaron para post-entrenar Gemma-3 en tamaños de 1.000, 4.000 y 12.000 millones de parámetros. La evaluación se hizo sobre el Berkeley Function Calling Leaderboard, que usa un conjunto de herramientas distinto del de ToolBench, lo que lo convierte en una prueba fuera de distribución con herramientas nunca vistas.
Los hallazgos reportados por los autores:
- El ajuste fino con ToolGrad-500 mejoró los puntajes de uso de herramientas en todos los tamaños de modelo.
- ToolGrad-12B obtuvo 83,1, frente a Gemini 2.5 Pro con 83,2, Claude 4.5 Opus con 82,8 y GPT-5 con 74,4, medidos al momento de la publicación.
- El modelo estudiante de 12.000 millones superó a Gemini 2.5 Flash-Lite, el modelo maestro que generó sus propios datos de entrenamiento.
- ToolGrad-12B quedó por delante de especialistas abiertos en uso de herramientas como ToolACE y Hammer-2.1-7B.
Los guiones de reproducción del repositorio apuntan a las versiones V1 y V2 del ranking a través de una bifurcación personalizada, corren la inferencia en una imagen Docker de vLLM y fueron verificados sobre una sola GPU NVIDIA A100 de 40 GB.
Ese último dato es el que conviene retener para dimensionar el costo de entrada. No se trata de un experimento que exija un clúster de entrenamiento: una A100 de 40 GB es una configuración que hoy se arrienda por hora en proveedores de nube y que varios laboratorios universitarios de la región ya tienen instalada. Con 500 muestras de datos y un modelo abierto de 12.000 millones de parámetros, el experimento completo queda al alcance de un equipo pequeño, que es precisamente el argumento que los autores quieren hacer.