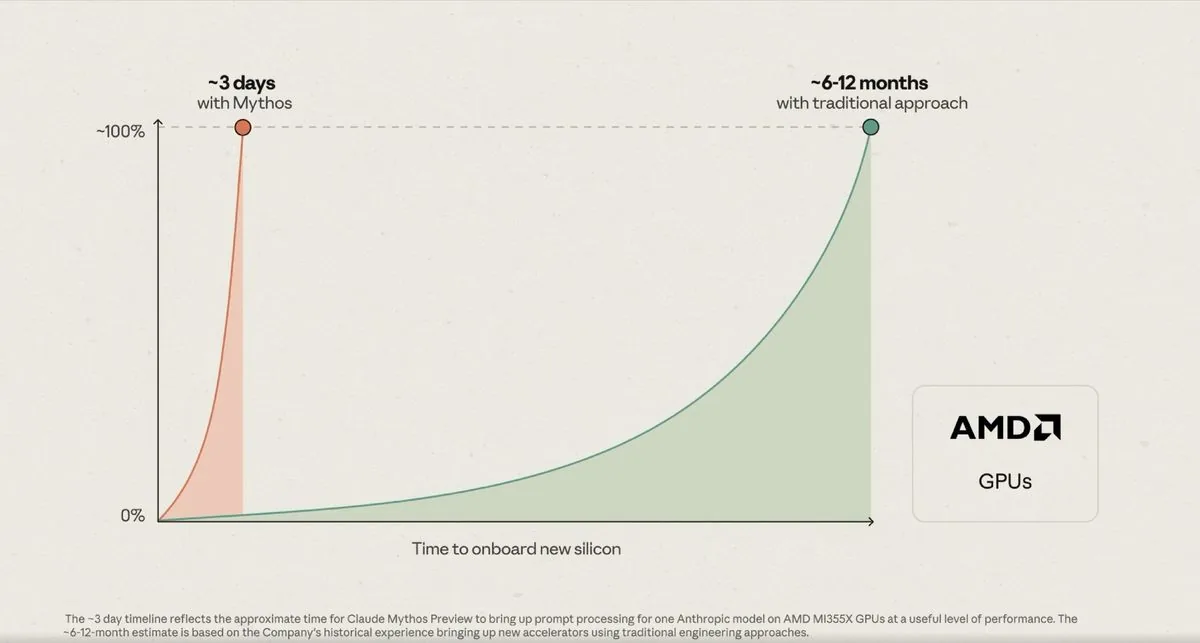
Anthropic les dijo a los inversionistas de su salida a bolsa que su modelo Claude Mythos Preview hizo en unos tres días el trabajo de software necesario para que su IA corriera en las GPU de AMD, con "básicamente ninguna intervención humana". Según la empresa, esa tarea tomaba antes de seis a 12 meses, informó Tom's Hardware el 16 de noviembre.
Los tres días cubren el procesamiento de prompts de un modelo de Anthropic en GPU AMD MI355X "con un nivel de rendimiento útil", y Mythos portó o escribió "casi el 100% de los kernels". Ese tipo de código de bajo nivel, que amarra un modelo de IA a los chips de una empresa, ha sido durante años parte de la ventaja que Nvidia construyó con CUDA. Una IA capaz de escribirlo en días sugiere que esa ventaja se está erosionando.
Lo que dijo Anthropic a sus inversionistas
La comparación de tiempos la hizo Tom Brown, cofundador y director de cómputo de Anthropic, quien explicó a los inversionistas que el método original requería un equipo de "decenas de ingenieros". La empresa ya corre sus modelos en varios tipos de chips (GPU de Nvidia y AMD, las TPU de Google y AWS Trainium) y administra su flota como "un solo pool de cómputo intercambiable". Brown calificó esa decisión temprana de usar varios chips como "una apuesta poco convencional". Pudo haber sido acertada, considerando que las TPU de Google ya corren de forma nativa modelos construidos en PyTorch y que Meta las usa en producción.
La cifra de seis a 12 meses viene de la "experiencia histórica de poner en marcha aceleradores nuevos con enfoques de ingeniería tradicionales", en que adaptar el código a cada plataforma era un desafío. Quitar esa barrera podría reducir el cambio de proveedor a una decisión de compra. Anthropic empezó a trabajar con GPU de AMD este año y ya tiene un acuerdo por hasta 2 gigawatts.
¿Por qué CUDA era una barrera?
CUDA, la plataforma de programación de Nvidia, es muy madura, con casi dos décadas de vida. AMD tiene su equivalente, ROCm, con HIP como capa de programación. El código escrito para CUDA tiene que transformarse para funcionar ahí, y AMD incluso creó una herramienta llamada HIPify para hacerlo. Cambiar de plataforma sigue teniendo un costo de conversión. Anush Elangovan, vicepresidente de software de IA de AMD, le dijo a EE Times en abril que "Claude es mejor que HIPify porque tiene búsqueda web incorporada".
AMD viene sosteniendo desde agosto del año pasado que la IA puede escribir este tipo de código. En esa fecha presentó un agente de investigación que en ese momento quedó por debajo de los expertos humanos. En septiembre de ese año, la CEO de AMD, Lisa Su, dijo en el pódcast Possible que buena parte del software de IA está escrito en CUDA, que hay que "traducir a AMD", y que "una tonelada de eso ahora se puede hacer con software".
En julio de este año, Vamsi Boppana, vicepresidente senior de IA de AMD, dijo que sus ingenieros usaban modelos de IA para generar kernels de GPU. Su contó que cuando preguntó si su equipo estaba ayudando al ingeniero de Anthropic que trabajaba con el MI355X, le respondieron que no necesitaba ayuda. Boppana dijo que en algunos casos los kernels resultantes eran incluso "mejores que las versiones ajustadas a mano con más cuidado". Bajo su acuerdo de julio con Anthropic, AMD también usa Claude para optimizar cargas de trabajo en sus GPU Instinct y acelerar el desarrollo de ROCm.
En el evento Advancing AI de AMD en julio, Philippe Tillet, de OpenAI, contó que cuando OpenAI recibió sus racks Helios, un solo ingeniero confirmó que todo funcionaba en pocos días. Tillet dijo que "los agentes nos están quitando el trabajo, en cierto sentido, como ingenieros de kernels". Antes del evento, Andrew Dieckman, vicepresidente corporativo y gerente general del negocio de GPU para centros de datos de AMD, dijo a la prensa que prácticamente no ha tenido conversaciones sobre CUDA con los clientes de AMD.
Quién dijo qué y cuándo
| Fecha | Quién | Qué dijo o mostró | Dónde |
|---|---|---|---|
| 1 de agosto de 2025 | Investigadores de AMD | Publicaron GEAK, un agente de IA que escribe kernels de GPU. Contra 30 kernels escritos por expertos acertó 19, a 0,92 veces la velocidad de los expertos en promedio | Blog de ROCm de AMD |
| 24 de septiembre de 2025 | Lisa Su, presidenta y CEO de AMD | Sobre herramientas de código con IA, dijo que buena parte del código para CUDA ya se puede traducir a AMD con software. "Estamos usando software para optimizar de forma significativa el código de nuestros clientes para que corra en AMD" | Pódcast Possible |
| 1 de abril de 2026 | Anush Elangovan, vicepresidente de software de IA de AMD | Comparó Claude con HIPify. "Claude es mejor que HIPify porque tiene búsqueda web incorporada" | Entrevista con EE Times |
| 15 de abril de 2026 | Jensen Huang, CEO de Nvidia | "Usamos una tonelada de IA para crear los kernels que tenemos" y "nadie conoce nuestra arquitectura mejor que nosotros" | Entrevista con Dwarkesh Patel |
| 23 de julio de 2026 | Andrew Dieckman, vicepresidente corporativo y gerente general de GPU para centros de datos de AMD | "Casi no tengo conversaciones con nuestros clientes sobre CUDA a estas alturas" | PC Gamer, en una sesión informativa previa de AMD |
| 23 de julio de 2026 | Vamsi Boppana, vicepresidente senior de IA de AMD | La programación de GPU asistida por IA va a "eliminar cualquier barrera restante para la adopción amplia" | Keynote de AMD Advancing AI |
| 23 de julio de 2026 | Philippe Tillet, OpenAI | "Los agentes nos están quitando el trabajo, en cierto sentido, como ingenieros de kernels" | Keynote de AMD Advancing AI |
| 23 de julio de 2026 | Tom Brown, cofundador y director de cómputo de Anthropic | Un ingeniero le pidió a Claude poner en marcha un rack MI355X y lo dejó corriendo "durante el fin de semana" | Keynote de AMD Advancing AI |
| 10 de noviembre de 2026 | Tom Brown, cofundador y director de cómputo de Anthropic | Mythos "hizo correr a Claude en AMD en solo tres días con básicamente ninguna intervención humana". La nota al pie de la diapositiva limita los tres días al procesamiento de prompts de un modelo | Video del roadshow de la salida a bolsa de Anthropic |
Hasta esta semana, todo esto venía de AMD o de su escenario, no de Anthropic hablándole a sus propios inversionistas. Anthropic compra los chips en vez de venderlos y sale a bolsa la próxima semana, así que su enfoque de varios chips, ahora con algunas cifras que lo respaldan, pesa más que lo que diga un fabricante. Su prospecto también lo pone por escrito, aunque sin cifra. "Podemos incorporar plataformas de chips nuevas en una fracción del tiempo que tomaba antes."
¿Qué cubren exactamente los tres días?
| Dónde lo dijo Anthropic | Quién hizo el trabajo | Cuánto tomó | Qué cubrió | Qué reemplazó |
|---|---|---|---|---|
| Keynote de AMD Advancing AI, 23 de julio | Un ingeniero y Claude | No se indicó, quedó corriendo "durante el fin de semana" | Su "modelo líder" en un rack MI355X, con el rendimiento subiendo | Lo que llamó "un gran esfuerzo" |
| Video del roadshow, narración, 10 de noviembre | Mythos, con "básicamente ninguna intervención humana" | Tres días ("en solo tres días") | Hacer "correr a Claude en AMD". Claude "portó o escribió casi el 100% de los kernels" | Un trabajo que "tomaba meses a decenas de ingenieros" |
| Video del roadshow, nota al pie de la diapositiva, 10 de noviembre | Claude Mythos Preview | Unos tres días ("plazo de ~3 días") | Poner en marcha "el procesamiento de prompts de un modelo de Anthropic en GPU AMD MI355X con un nivel de rendimiento útil" | Seis a 12 meses ("estimación de ~6 a 12 meses"), según la "experiencia histórica de poner en marcha aceleradores nuevos" |
| Prospecto (S-1/A n.º 2), 10 de noviembre | Sus equipos de ingeniería, "apoyándose en Claude" | Sin cifra, "más rápido" | Llevar "plataformas de chips nuevas a producción", sin nombrar ningún chip | Lo que llama "un esfuerzo de ingeniería intenso durante muchos meses" |
El procesamiento de prompts (prefill) es la etapa en que un modelo lee y procesa lo que recibió antes de empezar a responder. Anthropic no dijo si también incluyó la etapa de respuesta (decode). Su gráfico, con el eje rotulado "Tiempo para incorporar silicio nuevo", muestra las dos líneas llegando a la misma marca de "~100%" sin decir 100% de qué. La empresa tampoco dijo a qué velocidad corrió el modelo en las GPU de AMD frente a las de Nvidia, que es la comparación que haría falta para saber si los chips de AMD, con código escrito por IA, igualan al silicio de Nvidia.
La respuesta de Nvidia
El CEO de Nvidia, Jensen Huang, dijo en una entrevista de abril con Dwarkesh Patel que Nvidia ya usa IA en sus propios kernels y que conoce sus chips mejor que nadie ("nadie conoce nuestra arquitectura mejor que nosotros"), así que puede sacarles el máximo. Cuando le preguntaron por qué laboratorios como Anthropic usan otros aceleradores, llamó a Anthropic "un caso único, no una tendencia". Nvidia y AMD están entre las siete empresas que comprarán 26.000 millones de dólares en acciones de Anthropic al precio de la salida a bolsa, o sea que Nvidia invierte en la misma empresa que Huang llamó la excepción.
A fines de julio, SemiAnalysis publicó un artículo titulado "¿Puede AMD romper la ventaja de CUDA?", que en lo esencial decía que escribir software ya no es la barrera que era hace apenas un año. El problema para AMD es que con la programación agéntica "cada agente necesita GPU contra las cuales probar su código", es decir, la IA que escribe el código igual necesita el hardware. SemiAnalysis encontró una falta constante de GPU dentro de AMD para este tipo de desarrollo, lo que ha frenado a la empresa y podría ser un nuevo cuello de botella.
Eso deja la ventaja de CUDA en un punto intermedio. Poner a correr un modelo en un chip nuevo, que antes era la parte cara, parece estar abaratándose, y una IA mejor podría desgastar el argumento de Nvidia de que conoce su hardware mejor que nadie. En el pool intercambiable de Anthropic los chips no son del todo equivalentes (las TPU de Google, por ejemplo, están cada vez más especializadas), y sacarle el máximo a cualquiera de ellos todavía exige tener el hardware para probar.