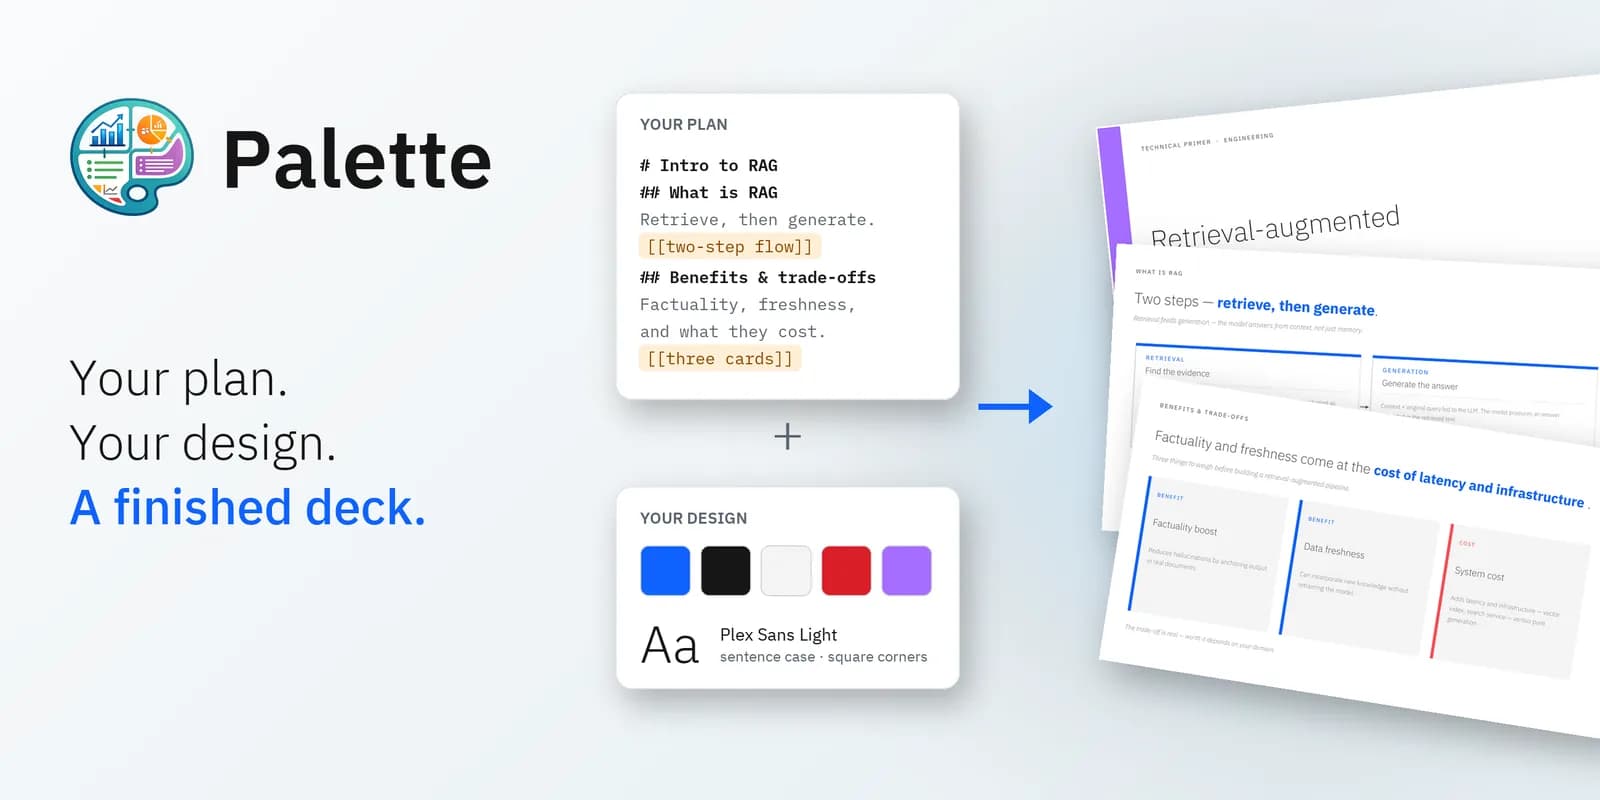
Si a un modelo de frontera se le pide una presentación, entrega una buena. Si se le piden diez, empiezan a parecerse, con los mismos valores por defecto de buen gusto, el mismo estilo de la casa y un leve aire de "presentación hecha por IA". Eso no importa hasta que uno quiere que la presentación se vea como su propia plantilla. Los modelos de frontera tienen su estilo, y ninguna instrucción evita que vuelvan a él. A veces, además, el contenido es confidencial y no puede salir de los sistemas de la empresa.
Las dos cosas apuntan a un modelo propio, de pesos abiertos, que corra en la infraestructura de uno y entrenado con el lenguaje de diseño de uno. El problema es que los modelos abiertos pequeños, los que de verdad se pueden alojar en casa, hacen esto mal. Sus presentaciones salen rotas, con títulos que se pierden en el fondo, texto que se sale de la diapositiva y figuras apiladas unas sobre otras.
Palette, de IBM Research, pone a prueba una apuesta. Que un modelo pequeño de pesos abiertos, entrenado con datos sintéticos en el lenguaje de diseño propio y revisado por un arnés de control, puede competir con los sistemas de frontera sin que uno pierda la propiedad del resultado. El equipo ajustó un modelo de 20B para que arme presentaciones como lo hacen las personas, con un diseñador que planifica y un programador que dibuja cada diapositiva. Sus datos de entrenamiento siguen el IBM Design Language, y en PresentBench queda primero en dos de los tres dominios medidos.
¿Por qué a un modelo pequeño le cuesta armar una presentación?
Una presentación parece simple, pero armarla le pide al modelo tres cosas que los modelos pequeños hacen mal.
Diagrama la diapositiva sin verla. El modelo no dibuja diapositivas. Escribe código que ubica cada elemento con una posición x e y, un ancho y un tamaño de letra. Si un título de 75 caracteres cabe en dos líneas a 56 puntos es un cálculo que el modelo hace de cabeza, y solo sabe que se equivocó cuando el código se renderiza. Los modelos pequeños fallan seguido en eso, y de ahí salen las figuras superpuestas y el texto que se sale de la diapositiva.
Toma dos tipos de decisiones a la vez. Decidir qué dice cada diapositiva y cómo mostrarlo (¿un gráfico o una tabla?, ¿qué se corta?) es criterio editorial. Ubicarlo con precisión es geometría. Una sola pasada tiene que hacer las dos cosas en 10 a 20 diapositivas, y mantener coherentes la paleta, la tipografía y la diagramación.
No hay datos que muestren cómo se hacen las presentaciones. Abundan las presentaciones terminadas, pero no el razonamiento detrás de las decisiones de diseño ni el código que las produjo.
Un diseñador y un programador, como lo haría una persona
Nadie arma una presentación de una sola pasada. Primero se decide la historia (cuántas diapositivas, qué dice cada una, cuál lleva gráfico y cuál tabla) y recién después se construye cada diapositiva. Palette divide el trabajo igual, en dos roles que atiende un mismo adaptador LoRA.
- El diseñador lee el plan y escribe un brief estructurado en JSON con la paleta, el sistema tipográfico y, para cada diapositiva, su diagramación, su contenido exacto y una breve justificación de diseño.
- El programador toma la especificación de una diapositiva y escribe el JavaScript de pptxgenjs que la dibuja, precedido de su razonamiento.
Así cada rol toma un solo tipo de decisión. El diseñador se encarga del criterio editorial y el programador de la geometría. El brief que queda entre ambos se puede leer y editar, así que una persona o un agente puede cambiar la diagramación de una diapositiva sin regenerar toda la presentación. Como el contexto de cada diapositiva queda fijo antes de escribir código, las llamadas al programador corren en paralelo, una por diapositiva, y la etapa de programación es entre 6 y 7 veces más rápida.
El adaptador se entrenó con LoRA en vez de un ajuste completo. Enseña un formato y una habilidad sobre una base capaz sin alterar lo que la base ya sabe, y abarató cada experimento. Una lección del proceso fue que los ejemplos del programador son unas 5 veces más largos que los del diseñador, así que una mezcla ingenua dejaba al diseñador subentrenado hasta que se sobremuestrearon sus ejemplos 5 veces.
¿De dónde salieron los datos de entrenamiento?
No existe un corpus público de planes, decisiones de diseño y código de diapositivas, así que el equipo generó uno con un modelo maestro abierto y grande. Cada presentación parte de una receta que fija su género, su largo, sus diagramaciones y las directivas del usuario, para controlar qué cubren los datos. Los planes van desde esquemas ordenados hasta volcados de contenido en bruto, para que el modelo aprenda a cortar y condensar. Generaron cerca de 1.000 presentaciones con unas 10.000 diapositivas.
Cada ejemplo lleva además el razonamiento que lo explica, escrito como contrafactual. La traza sopesa una alternativa y dice por qué se descartó, para que el modelo aprenda la regla detrás de una elección y no solo la elección. El diseñador razona sobre contenido y forma.
"Ingresos de cuatro trimestres, con una tendencia clara al alza. Consideré una tabla, pero lo que importa en esta diapositiva es la tendencia, no las cifras exactas, así que un gráfico de barras la hace visible de un vistazo".
El programador razona sobre geometría.
"El título tiene 62 caracteres. A 44 puntos pasaría a tres líneas y chocaría con el gráfico de abajo, así que lo dejé en 36 puntos, que cabe en dos líneas y deja espacio sobre el gráfico".
El maestro por sí solo no hace buenos los datos. Lo que los hace buenos es el ciclo a su alrededor. Cada presentación sintetizada se renderiza y se revisa en busca de superposiciones y desbordes con el mismo verificador que usa el arnés en la inferencia. Las diapositivas rotas se reparan, y su razonamiento se reescribe como el mismo tipo de contrafactual, explicando qué hizo mal la diagramación original y por qué funciona el arreglo. Cada error que caza el verificador se convierte en un mejor ejemplo de entrenamiento.
El problema más difícil fue la fidelidad. La peor falla es una diapositiva con datos que no estaban en la entrada, y el equipo comprobó que una regla en la instrucción no la evita. Si un brief pide una tabla de seis por cinco pero solo trae tres viñetas, el programador tiene que inventar el resto.
Lo que lo resolvió fueron las presentaciones de referencia, no las reglas. Corregir una referencia cambiaba de forma confiable la salida del maestro, mientras que agregar una regla rara vez lo hacía. El maestro ve algunas presentaciones de referencia en su instrucción y las copia mucho más de lo que sigue las indicaciones.
Directivas en lenguaje simple
Los usuarios suelen querer control fino sobre decisiones de diseño puntuales, como un gráfico en vez de una tabla, un color concreto o una portada más oscura. Palette permite pedirlo con directivas, instrucciones cortas escritas dentro del plan y encerradas entre [[ ]].
## Rollout plan
- March: pilot with two teams
- May: security review complete
- July: rollout to all of engineering
- September: company-wide launch
- November: first adoption review
[[make this a timeline]]
El diseñador incorpora cada directiva al brief y el programador la sigue al dibujar la diapositiva. Sin la directiva, el modelo mostraría estos hitos como una tabla, algo razonable. Con ella, dibuja una línea de tiempo.
El modelo sigue las directivas porque fue entrenado para eso. Las recetas de datos incluyen directivas de 12 categorías, cada una redactada de varias formas, para que el modelo aprenda la intención y no una frase fija.

Figura 1. El mismo plan sin (izquierda) y con (derecha) la directiva [[make this a timeline]].
¿Cómo funciona el arnés de revisión y reparación?
Incluso un modelo bien entrenado produce a veces una diapositiva rota, como un título del mismo color que el fondo o dos cuadros apilados. Por eso Palette no entrega la salida del modelo directamente, y cada presentación pasa antes por un arnés.

Figura 2. El diseñador redacta el brief, el programador escribe en paralelo el código de cada diapositiva y el arnés revisa y repara cada una antes de entregar la presentación.
Primero, reglas simples corrigen errores conocidos, como un código de color mal formado que dejaría todas las diapositivas en negro. Después cada diapositiva se renderiza y se mide. Un verificador geométrico marca el texto que se superpone, queda recortado o se sale de la diapositiva. Las diapositivas marcadas pasan a otro modelo editor, que reescribe su código.
La regla central es que una reescritura se conserva solo si el verificador confirma que la diapositiva mejoró. Si no, queda la original. Eso hace seguro correr el arnés sobre todas las presentaciones, porque puede arreglar una diapositiva pero no empeorarla.

Figura 3. Un ejemplo de reparación. Tal como se generó (izquierda), el título de cada tarjeta queda encima de su descripción. El arnés detecta las superposiciones y reordena las tarjetas en una grilla de 2x2 (derecha).
Para medir su efecto, el equipo generó una vez cada presentación de PresentBench y la puntuó con y sin el arnés. En 131 presentaciones, el arnés suma 3,5 puntos en promedio.
¿Cómo le fue contra NotebookLM y Manus?
La evaluación se hizo en PresentBench, que puntúa las presentaciones generadas en cinco criterios, fundamentos, diseño visual, completitud, corrección y fidelidad. PresentBench entrega un documento fuente y no un plan, así que en estas corridas otro modelo de frontera redactó cada plan a partir de su documento y Palette armó la presentación desde ese plan. Se reportan tres dominios, y las cifras de los sistemas de referencia salen del paper de PresentBench.

Figura 4. Puntajes de PresentBench por dominio. Palette (azul) contra NotebookLM, Manus 1.6 y otros cinco sistemas (gris). Palette queda primero en Economía y Educación, tercero en Charlas y segundo en el promedio de los tres dominios.
| Dominio de PresentBench | Puesto de Palette |
|---|---|
| Economía | 1.º |
| Educación | 1.º |
| Charlas | 3.º |
| Promedio de los tres | 2.º (59,7 contra 60,8 de NotebookLM) |
Palette rinde mejor donde el puntaje lo deciden el contenido estructurado y la exactitud numérica, y por eso gana en Economía y Educación. En Charlas, donde las presentaciones son narrativas y pensadas para acompañar un discurso, dos sistemas cerrados puntúan más alto y Palette queda tercero. En los tres dominios juntos queda segundo, a 1,1 puntos de NotebookLM (59,7 contra 60,8) y por delante del resto, siendo un solo modelo de pesos abiertos de 20B.
PresentBench mide si una presentación es buena, pero no si sigue un lenguaje de diseño específico. El equipo dice no conocer un benchmark que lo haga, y espera ayudar a cubrir ese vacío.
Lo que viene
El arnés ya calcula señales baratas y verificables. Si la diapositiva se renderiza, si algo se superpone o se desborda, si cada dato se puede rastrear hasta el brief. Hoy se usan para reparar la salida después de generarla. El siguiente paso es usar esas mismas revisiones como recompensas de aprendizaje por refuerzo, para que el modelo deje de cometer esos errores desde el principio. Como el programador trabaja una diapositiva a la vez, cada diapositiva es una ejecución corta que se revisa por separado, algo que calza con un entrenamiento estilo GRPO.
El equipo también quiere achicar la brecha en las presentaciones con muchas figuras, extrayéndolas de los documentos fuente (por ejemplo con Docling) y ubicándolas con el arnés. Y explora una forma más liviana de usar plantillas propias, que consiste en adaptar el estilo de la salida a partir de uno o dos archivos .pptx existentes, sin reentrenar.
Lo que aprendieron
Según IBM Research, construir Palette dejó algunos métodos que se extienden a otras tareas cuya salida tiene una estructura revisable con código, desde gráficos y diagramas hasta interfaces.
- Poner el razonamiento en los datos. Entrenar con el porqué de una elección, incluido lo que se descartó, enseña más que la elección sola.
- Corregir los ejemplos antes de agregar una regla. Cuando el maestro se equivocaba, el primer impulso fue sumarle una regla a la instrucción, y eso rara vez ayudó. El maestro copiaba sus presentaciones de referencia mucho más de lo que seguía indicaciones, así que corregir la referencia fue lo que de verdad cambió su salida.