Recursive libera Flint, un modelo de código que diseñó casi solo su IA
El MoE de 40.000 millones de parámetros, con 2.500 millones activos, corre local en Apple y Nvidia y salió de un sistema que propone y evalúa sus propios experimentos.
54 notas publicadas

Super VL tiene 120.000 millones de parámetros y apunta al centro de datos, mientras los dos Bolt están hechos para correr local en equipos con RTX Spark y DGX Spark.

El análisis del boletín sostiene que Muse Spark Open redujo a la mitad la brecha con los modelos abiertos chinos, pero que su licencia puede frenar su adopción.

El nuevo modelo de razonamiento chino empata con GLM-5.3-Flash, queda detrás de Deepseek V4.1 Flash y libera sus pesos el 23 de octubre.

La familia va de 5 a 209 millones de parámetros y, según Mistral, su versión mayor encabeza GIFT-Eval, TIME y fev-bench sin necesitar GPU.

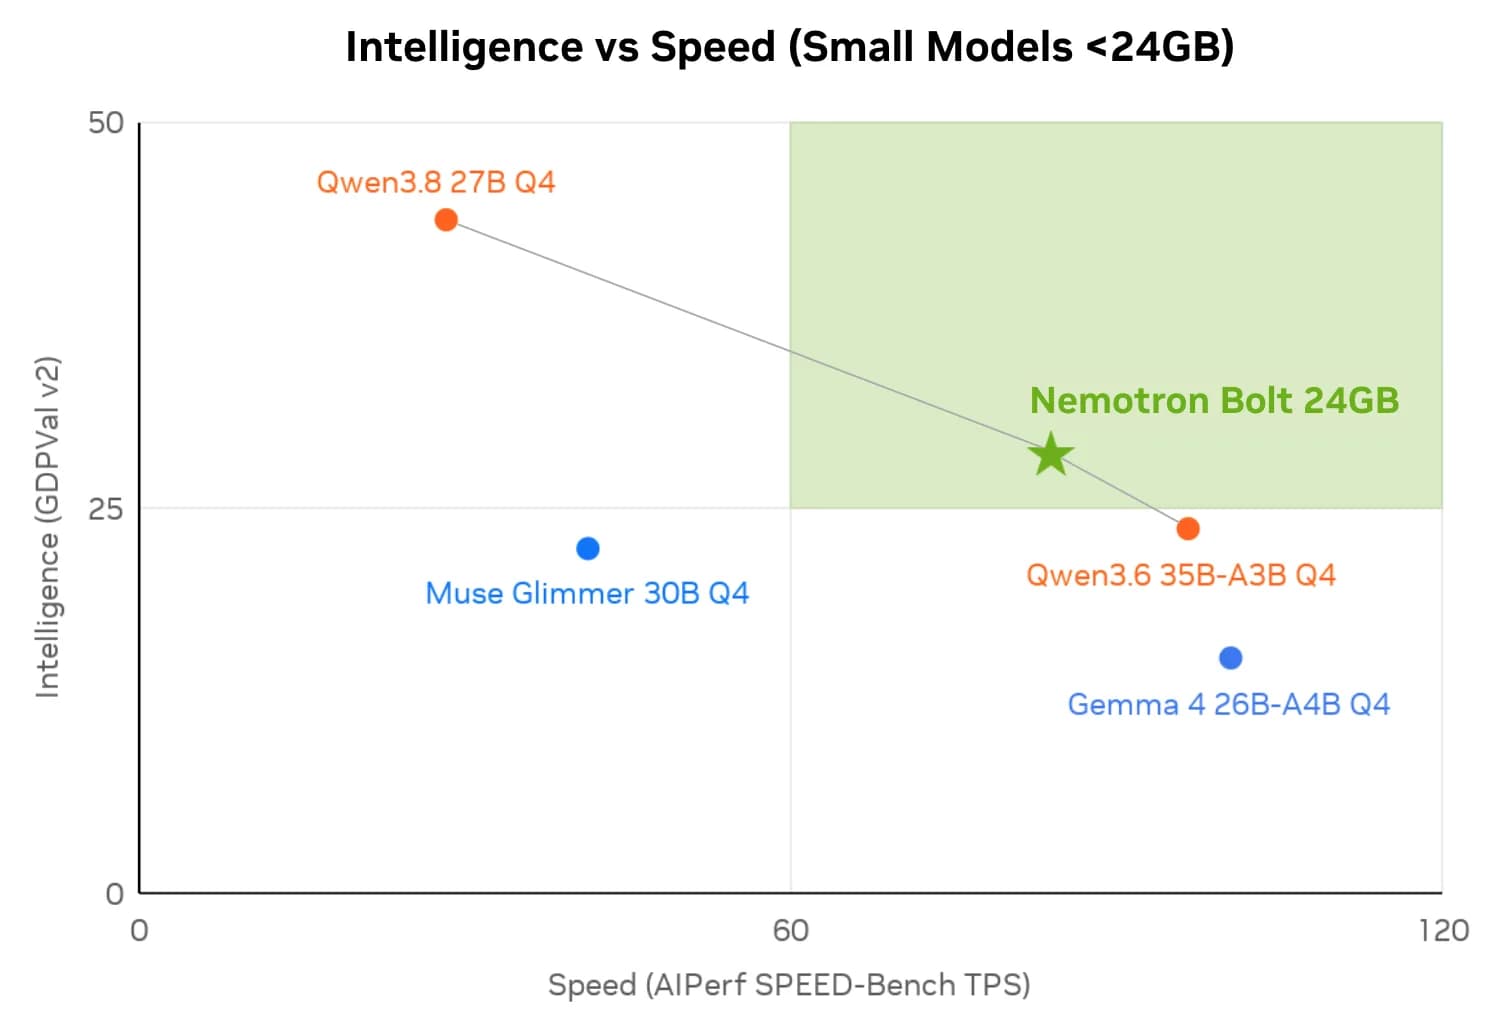
Tiene 24.000 millones de parámetros, activa solo 2.000 millones por token y decodifica 184 tokens por segundo en un MacBook con M5 Max.

El modelo abierto de Google DeepMind tiene 740 millones de parámetros y corre con unos 567 MB de RAM en un Pixel 11 Pro.

Black Forest Labs liberó los pesos de un modelo de 5.600 millones de parámetros que genera, edita y combina hasta diez imágenes de referencia.

El modelo de pesos abiertos tiene 816.000 millones de parámetros y un contexto de un millón de tokens, y para correr en local pide al menos 1 TB de RAM.

Super VL tiene 120.000 millones de parámetros y apunta a agentes empresariales. Los Bolt corren en 24 GB y 4 GB de memoria, en PC y Jetson.

Artificial Analysis lo ubica como el mejor modelo fuera de Estados Unidos y China, pero cuesta más de cuatro veces lo que sus rivales de inteligencia parecida.

NVIDIA especializó su familia Nemotron 3 con ajuste fino y aprendizaje por refuerzo, y liberó en Hugging Face los modelos, los datos y las recetas.

Mistral lo apoda Le Chonk, lo entrenó con unas 3.800 GPU Grace Blackwell en Europa y liberará los pesos en Hugging Face dentro de octubre.

El modelo abierto de 740 millones de parámetros corre en el navegador con unos 191 MB de RAM y no necesita clave de API.

No escriben ni una frase, pero clasifican y puntúan texto muy rápido y muy barato, y ya inspiraron variantes como Kev y Nimble, que corre local con Ollama.

El laboratorio francés lo presenta como el modelo de pesos abiertos más capaz fuera de China y dice que lo entrenó desde cero, sin destilación.

La startup de Brooklyn dice que Beam iguala a GLM-5.2 de Z.ai en razonamiento con 3 a 4 veces menos cómputo de inferencia, y promete liberar los pesos este mes.

El modelo de 78.000 millones de parámetros activa unos 3.000 millones por token, se entrenó en 768 GPU B200 y sale con licencia Apache 2.0.

Con 7.000 millones de parámetros marca récord de tasa de éxito en RoboLab-120 y corre hasta 3,95 veces más rápido que el mejor modelo abierto anterior.

Alibaba asegura que su modelo abierto supera a Nano Banana 2.0 en su propio benchmark, pero la nueva licencia prohíbe revender el modelo sin permiso.
MiMo-V2.6-Pro marca 46 puntos en el Intelligence Index, y Anthropic sostiene que Xiaomi extrajo datos de Claude en 400.000 intercambios.

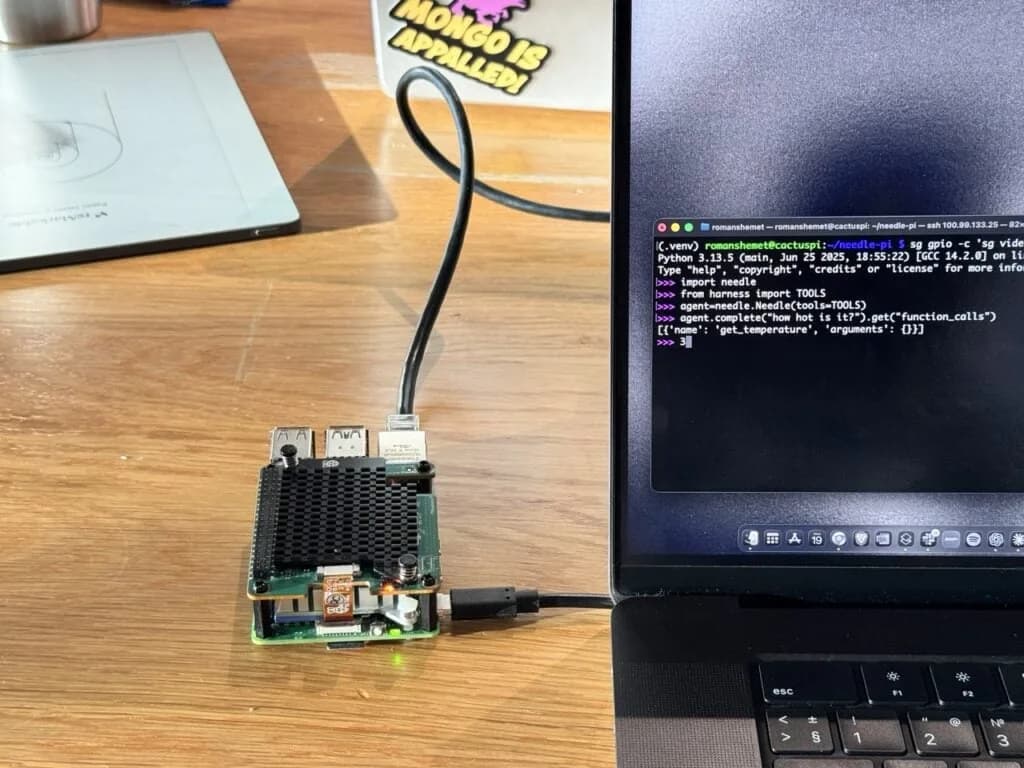
El modelo tardó 78 milisegundos en encender un LED y corre sin conexión a internet después de la primera descarga.
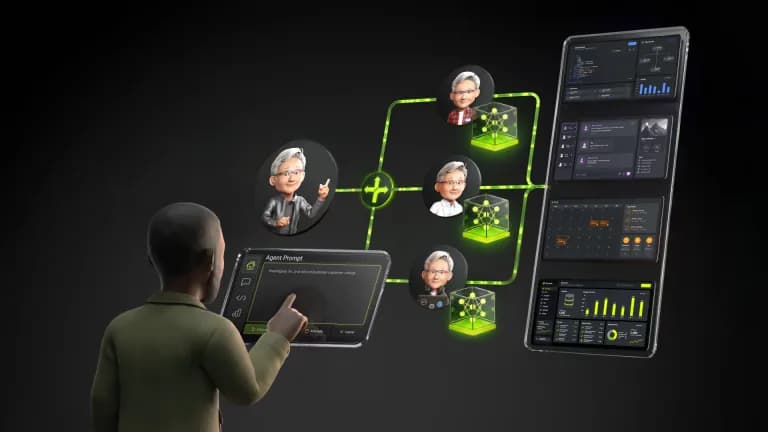
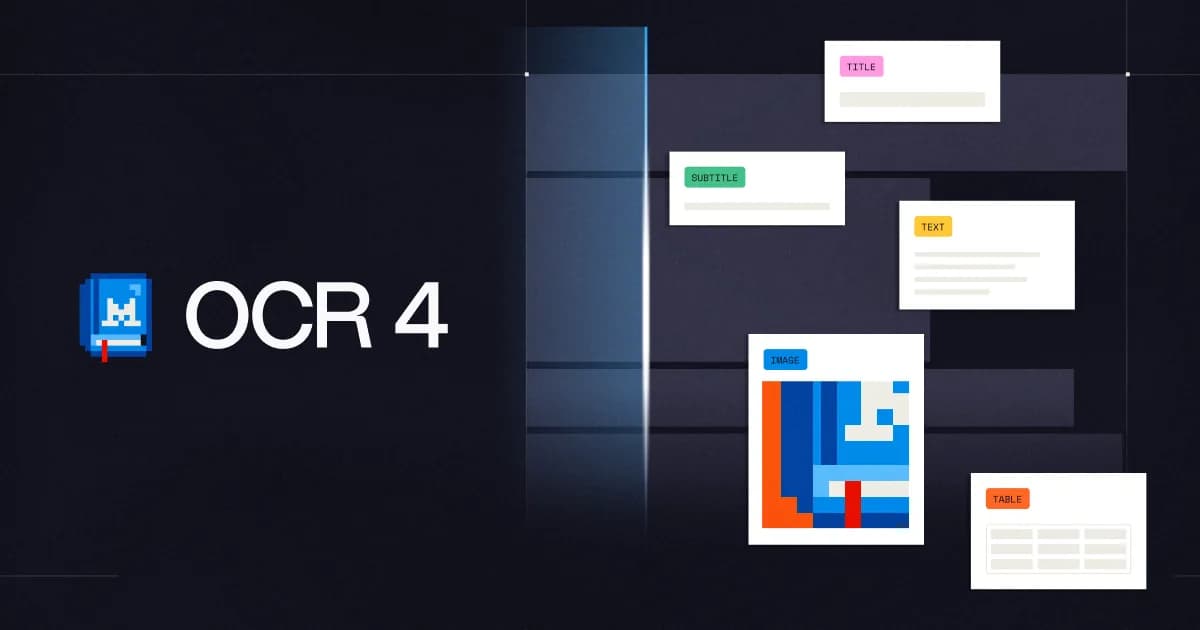
El modelo entrega la posición de cada bloque, su tipo y un puntaje de confianza junto al texto extraído, corre en un solo contenedor y cubre 170 idiomas.
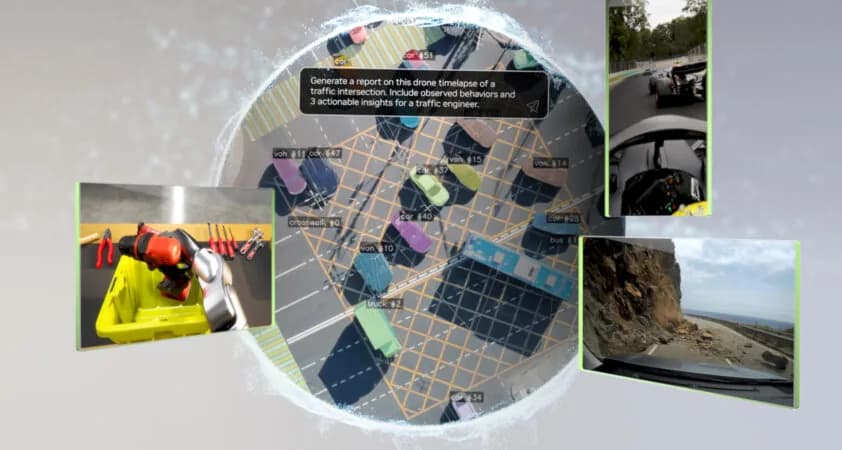
El informe que Interconnects preparó para legisladores estadounidenses pone la ventaja china en 1.600 millones de descargas y en más del 80% del uso de OpenRouter.

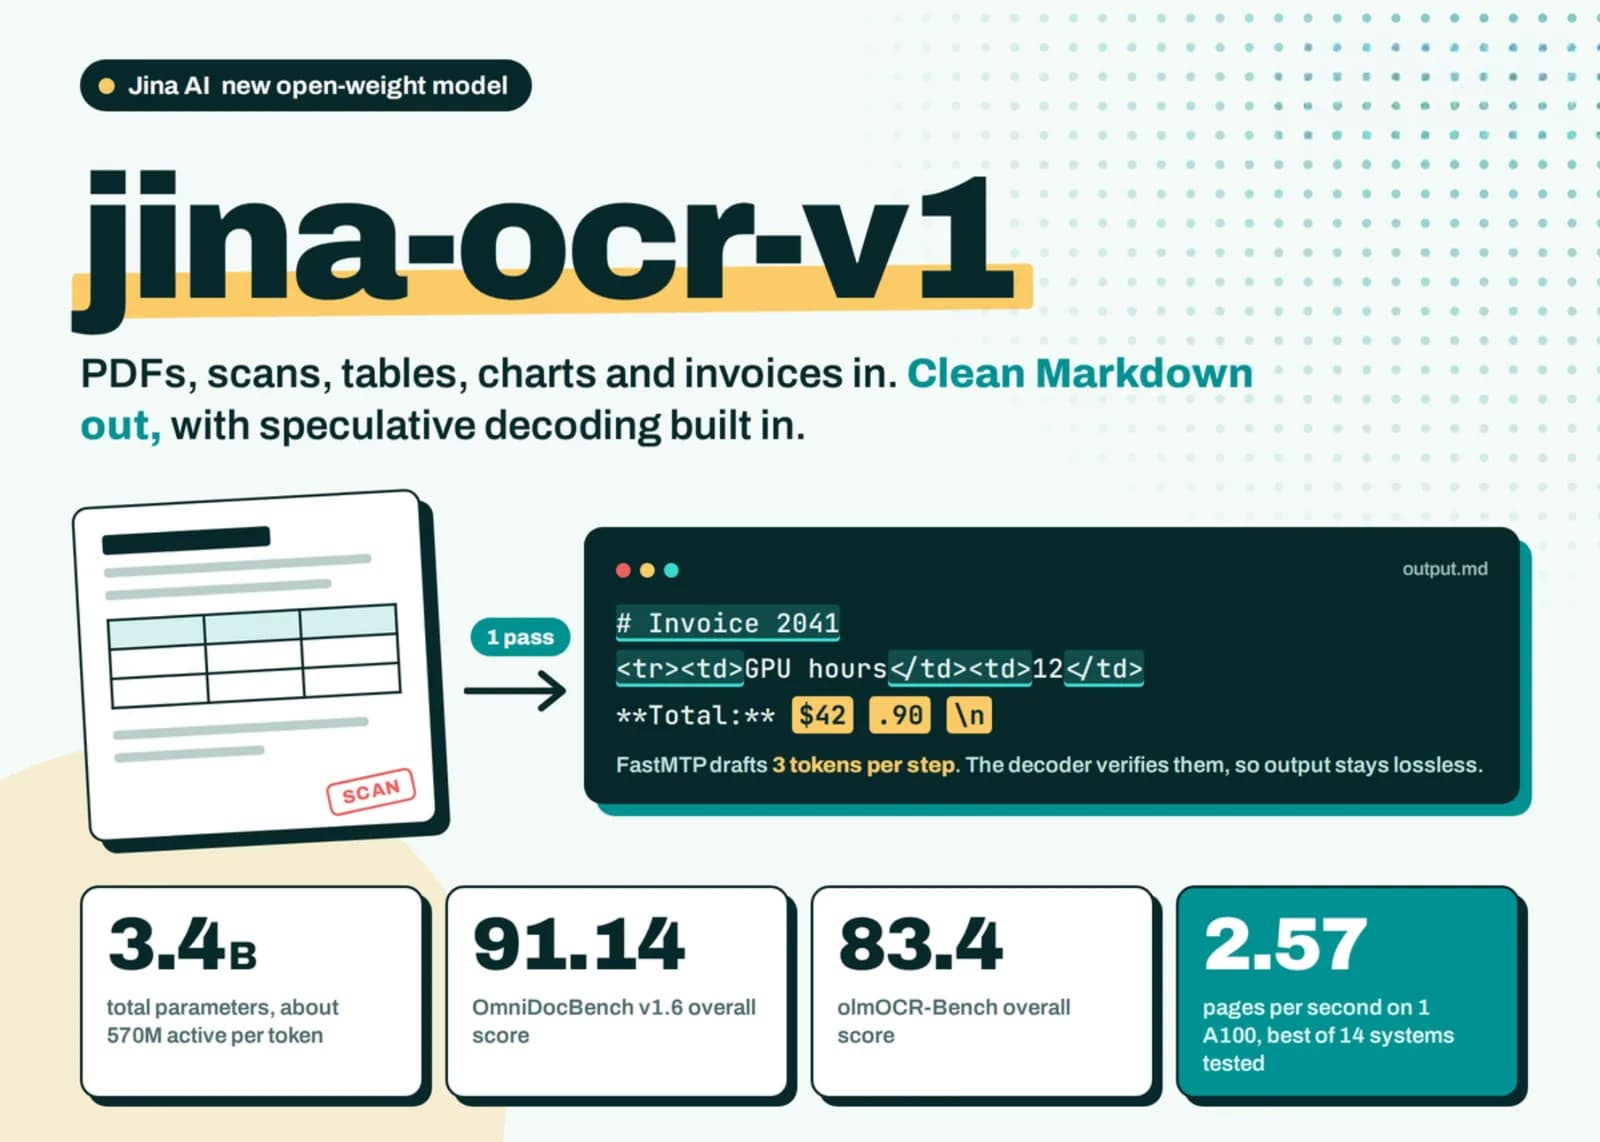
El lector de documentos tiene 3.400 millones de parámetros, activa unos 570 millones por token y trae adentro una cabeza de decodificación especulativa que casi duplica la velocidad en una NVIDIA L4.

El informe pone a los mejores modelos chinos de pesos abiertos a tres puntos del líder cerrado, pero su propio gráfico de hardware muestra una distancia mayor.

Koa se construyó sobre Nemotron, el modelo de pesos abiertos de Nvidia, y se entrenó con datos sintéticos que imitan llamadas de servicio al cliente sin usar información real de las empresas.

El modelo suma 763.000 millones de parámetros, activa 8.000 millones en la entrada y 16.000 millones en la salida, y con eso baja la caché de claves y valores hasta un octavo de la del V4 Flash.

Jensen Huang asegura que la plataforma seguirá abierta a cualquier modelo, nube o acelerador, y que no exigirá cómputo propio para construir o desplegar en ella.

Clément Delangue explicó por qué cambió de opinión y fijó la meta de la plataforma en 100 millones de usuarios, seis veces los 18 millones que tiene hoy.

La alianza que la compañía fundó en julio junto a más de dos docenas de empresas pasa a gobernanza neutral, con IBM, Red Hat, SpaceX y Palantir entre sus respaldos.

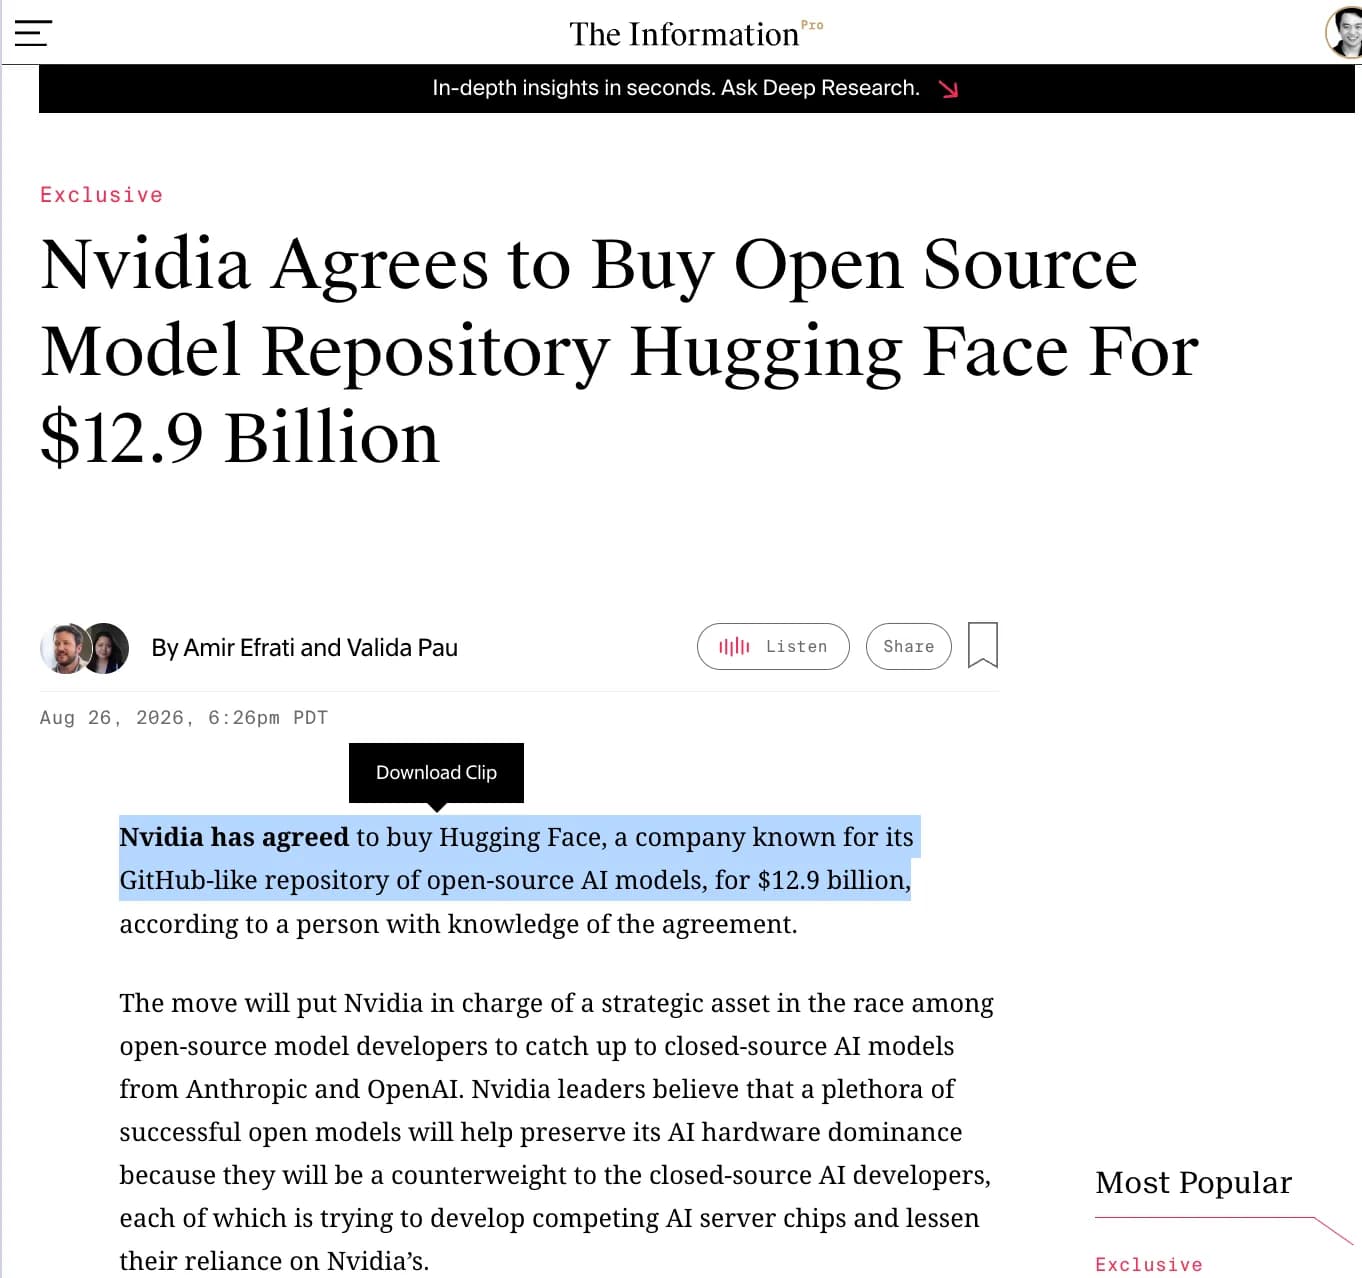
La operación valora a la plataforma de modelos abiertos en unas 80 veces sus ingresos anuales, justo cuando OpenAI y Anthropic reducen su dependencia del hardware de Nvidia.

NVIDIA liberó implementaciones de referencia para llevar modelos abiertos desde un identificador de Hugging Face hasta inferencia nativa en C++, sin PyTorch ni Python en producción.

El reporte de The Information sitúa el precio en unas 80 veces los ingresos anualizados de la plataforma, que hoy bordean los 150 millones de dólares.

La operación valora al repositorio de modelos abiertos en unas 80 veces sus ingresos anuales recurrentes y casi duplica la oferta inicial de 7.000 millones que Nvidia hizo en enero de 2026.

La destilación consciente de cuantización (QAD) permite llevar los pesos a 4 bits y triplicar el rendimiento sin perder la precisión del modelo original en BF16.

Artificial Analysis midió el modelo abierto de NVIDIA: la mayor velocidad de su clase, un salto de nueve puntos en inteligencia y un Elo agéntico superior al de modelos cuatro veces más grandes.

Un port a MLX permite correr en Apple Silicon el modelo omnimodal de MiniMax, capaz de generar clips de video de hasta 15 segundos con audio incluido, sin depender de la nube.

NVIDIA libera un modelo Mixture-of-Experts de 30.000 millones de parámetros totales y 3.000 millones activos, con hasta 4 veces más velocidad de salida que rivales de su tamaño.

La familia de modelos de mundo llega en tres tamaños, 64B, 16B y 4B, bajo una licencia de la Linux Foundation que permite reentrenarlos con datos propios.

El modelo queda disponible en Hugging Face bajo licencia OpenMDW-1.1, que permite ajuste fino, modelos derivados y redistribución comercial sin permisos adicionales.

Moonshot AI publica los pesos del modelo y libera parte de su infraestructura, mientras pruebas independientes exponen brechas en ciberseguridad y matematicas.

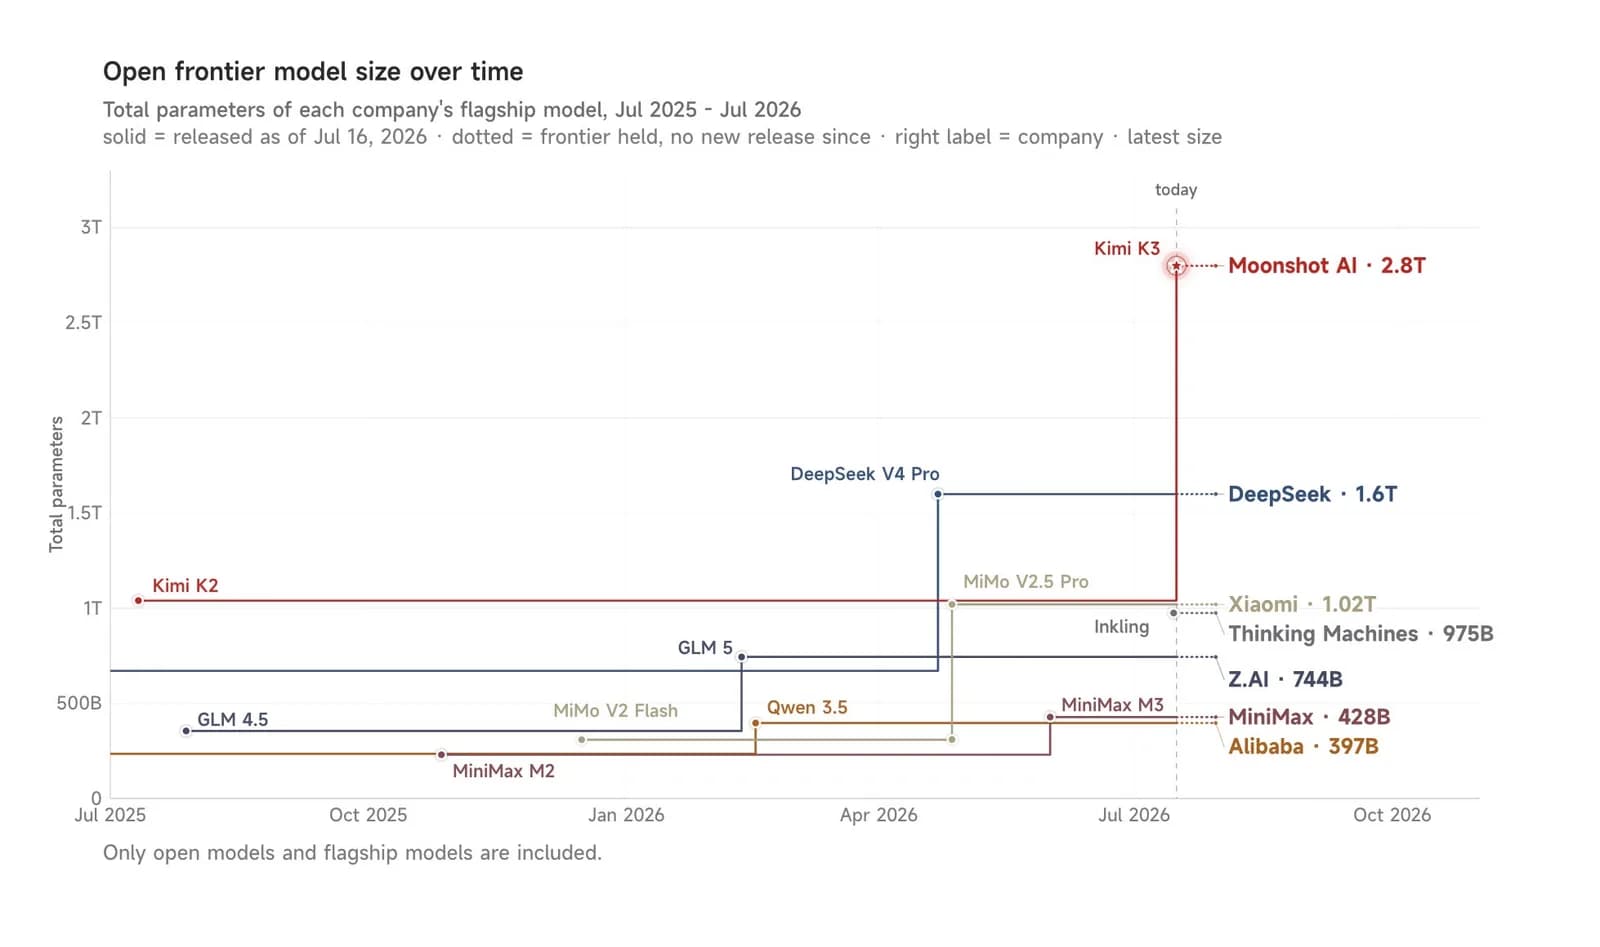
Moonshot AI liberará los pesos de un MoE de 2,8 billones de parámetros que ya pelea el podio con Claude y GPT, recortando la brecha entre modelos abiertos y cerrados a solo 3 a 5 meses.

Moonshot AI lanzó su modelo más capaz, con pesos abiertos prometidos para el 27 de julio; supera a GPT-5.5 y Opus 4.8 en sus propios benchmarks, pero cobra como la gama Claude Sonnet.

El modelo multimodal de 2,4 billones de parámetros llega en versión preview y busca frenar el impulso de Kimi K3 antes de que Moonshot AI salga a bolsa.

Thinking Machines Lab, la empresa de Mira Murati, presenta su primer modelo entrenado desde cero: 975.000 millones de parámetros, multimodal y con pesos abiertos de uso comercial libre.

Moonshot AI presenta un modelo de 2,8 billones de parámetros con contexto de 1 millón de tokens y pesos abiertos prometidos para el 27 de julio, que ya lidera el ranking de código frontend.

Thinking Machines Lab, la startup de Mira Murati, lidera entre los modelos de pesos abiertos de EE.UU., pero aún queda por detrás de los mejores chinos y arrastra un 63% de alucinaciones.

El nuevo buque insignia de Kimi suma 2,8 billones de parámetros y un millón de tokens de contexto, pero rompe con la era del modelo chino ultrabarato.

La startup de Mira Murati debuta con un modelo de pesos abiertos de 975.000 millones de parámetros y apuesta a que las empresas prefieran adaptar la IA a su medida antes que arrendar modelos cerrados.

PrismML comprimió un modelo de 27.000 millones de parámetros a menos de 4 GB conservando cerca del 90% del rendimiento, y Apple ya estaría probando la tecnología para su IA en el dispositivo.

La startup china alista M3 Pro, un modelo que superaría en tamaño a cualquier otro desarrollo chino disponible y que planea liberar como código abierto tan pronto como el tercer trimestre.

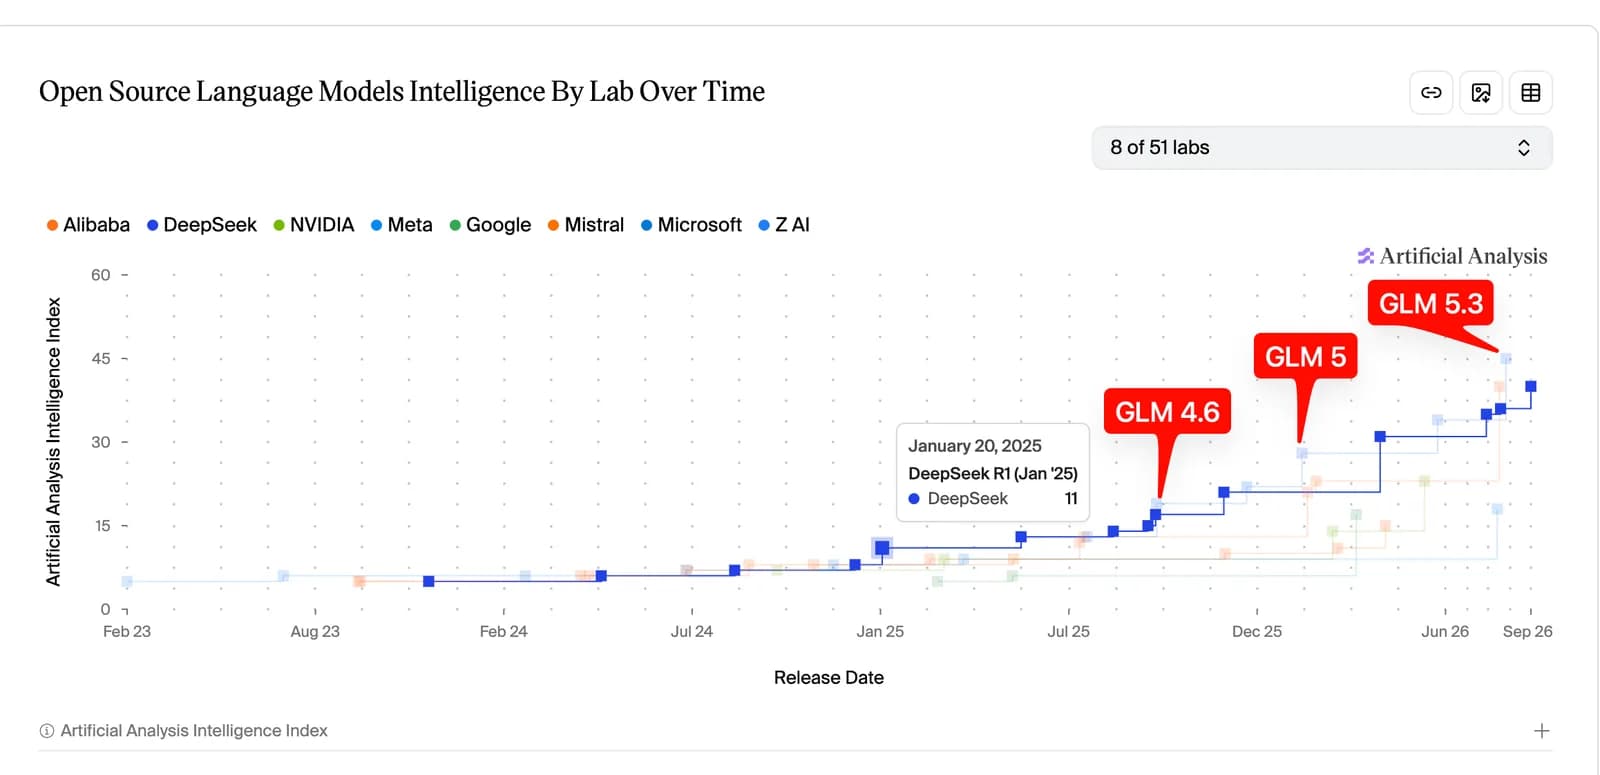
DeepSeek y Z.ai ya representan más del 30% del tráfico semanal en OpenRouter, con picos de 46%, gracias a precios entre 60% y 90% más bajos que los de OpenAI o Anthropic.

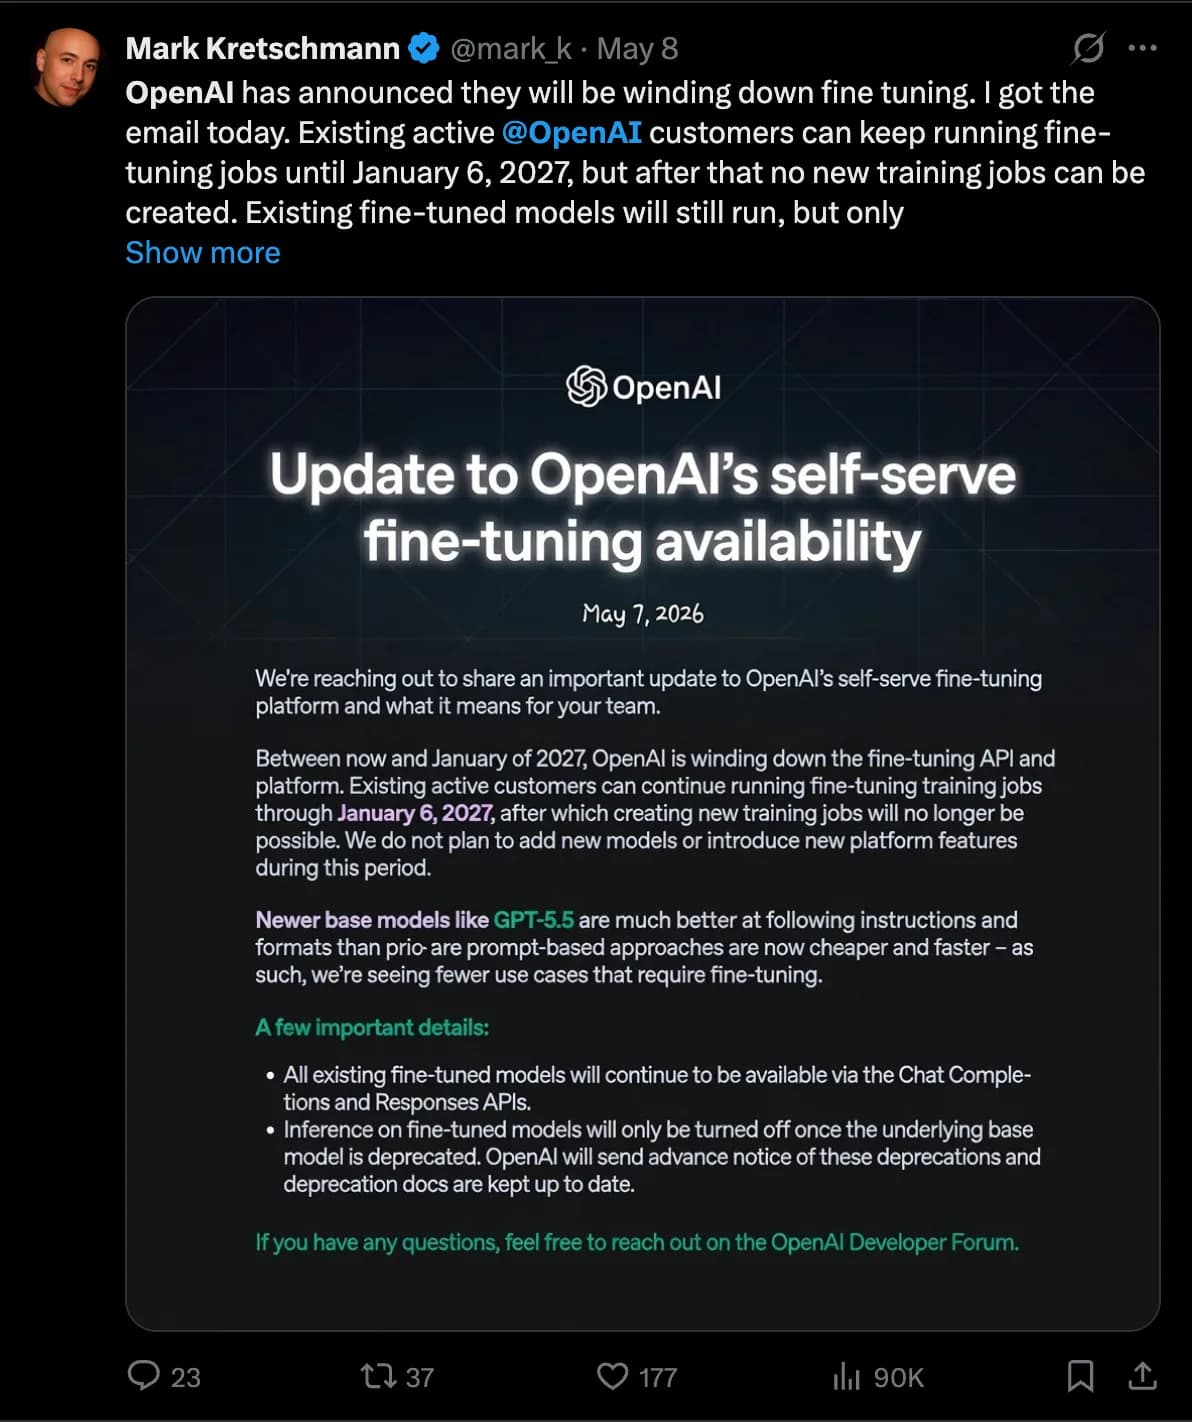
El cierre de las APIs de finetuning de OpenAI llega después de la baja de Sora y confirma que el grueso del ajuste fino se mueve hacia modelos abiertos o, directamente, hacia prompts gigantes.
Otros temas que aparecen junto a #modelos abiertos en nuestra cobertura editorial.