Los investigadores de Stanford Owen Queen y James Zou probaron 50 afirmaciones muy citadas sobre los modelos de lenguaje grandes en 20 modelos, y concluyeron que el 44% ya "caducó". Entre los 22 hallazgos con fecha estimada de vencimiento, la vida útil promedio fue de apenas 15,7 meses.
Los dos revisaron las afirmaciones con modelos lanzados entre julio de 2024 y septiembre de 2026 por ocho desarrolladores. En los hallazgos caducados, el efecto original prácticamente desapareció. Otro 34% se debilitó de forma notoria. Solo el 16% se mantiene, y el 6% se hizo más fuerte. Al cabo de un año había caducado el 16% de los hallazgos, y a los dos años la cifra subió a 39%.
| Estado del hallazgo | Proporción |
|---|---|
| Caducado | 44% |
| Debilitado | 34% |
| Se mantiene | 16% |
| Se fortaleció | 6% |
Lo que los modelos "no pueden hacer" caduca primero
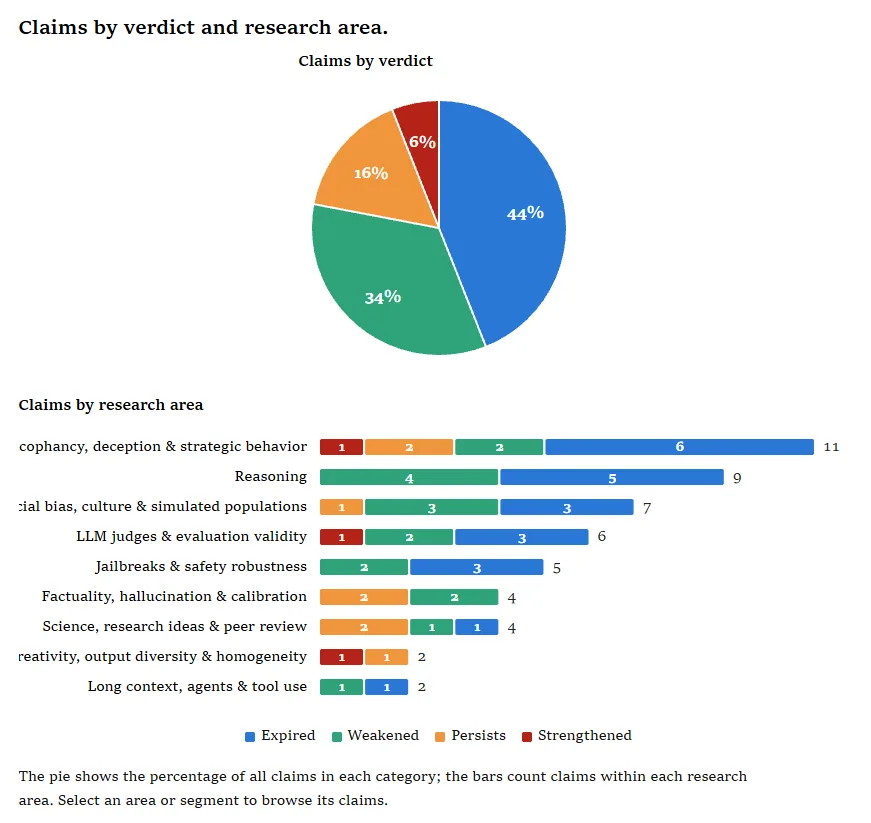
Según el estudio, las afirmaciones sobre lo que los modelos no pueden hacer son las que caducan más rápido. Cinco de nueve hallazgos sobre razonamiento se consideran caducados, y ninguno se mantuvo ni se fortaleció. Entre ellos hay debilidades conocidas, como contar las letras de "strawberry", hacer aritmética en sistemas numéricos poco comunes, perder información en la mitad de contextos largos y abandonar respuestas correctas cuando el usuario insiste en lo contrario. Los investigadores sospechan que estos errores tienen un resultado "correcto", lo que les da a los desarrolladores un objetivo claro para entrenar.
Las afirmaciones sobre preferencias y tendencias duran más. De los 11 hallazgos que se mantuvieron o se fortalecieron, tres tratan del comportamiento de los LLM como evaluadores. Prefieren sus propias respuestas, califican de forma parecida artículos aceptados y rechazados, y se dejan influir por el énfasis retórico en resúmenes médicos. Otros tres se refieren a la complacencia con el usuario y la tendencia a darle la razón. A eso se suman un sesgo político hacia la izquierda, respuestas casi idénticas a preguntas abiertas y una distribución no uniforme al generar números aleatorios.
Las citas inventadas bajaron de 55% a cero, aunque no en todos los modelos
Como caso de estudio, Queen y Zou revisaron la fabricación de citas científicas. En el estudio original de 2023, de Walters y Wilder, GPT-3.5 inventaba el 55% de sus referencias. Los investigadores de Stanford enviaron las mismas instrucciones a modelos actuales.
| Modelo | Referencias inventadas |
|---|---|
| GPT-3.5 (estudio de 2023) | 55% |
| GPT-6.1 Sol | 0% |
| Claude Sonnet 5.5 | 1% |
| Qwen3.7-Flash | 69% |
Qwen3.7-Flash, que también es un modelo de 2026, todavía inventó el 69% de sus referencias en la misma prueba.
El estudio advierte que estos resultados no deben leerse como una señal de que el problema está resuelto. En las llamadas preguntas de dos saltos, donde el modelo tiene que combinar dos hechos que conoce, Claude Sonnet 5.5 sigue fallando en cerca del 10% de los casos en que responde bien cada pregunta por separado. El artículo original informaba 43% para ChatGPT. La llamada "maldición de la inversión" (Reversal Curse) y las respuestas contradictorias a pares de preguntas sobre tiempo también se debilitaron, pero todavía se detectan.
Los sesgos sociales son un caso mixto, según los investigadores. El sesgo político hacia la izquierda persiste, mientras que los estereotipos de género y los sesgos de asociación implícita se debilitaron. Los sesgos contra hablantes de inglés afroamericano incluso cambiaron de dirección en la tendencia de los datos.
¿Por qué los resultados cambian tanto entre modelos?
Los resultados varían bastante de un modelo a otro, incluso dentro de la misma ventana de lanzamiento. Entre los modelos lanzados entre julio y septiembre de 2026, la cantidad de hallazgos caducados va de 11 en DeepSeek V4 Pro a 30 en GPT-6.1 Sol. Ni la fecha de lanzamiento, ni el proveedor, ni el tamaño del modelo predicen el patrón de manera confiable.
Queen y Zou sacan una conclusión amplia. Los hallazgos empíricos sobre LLM deberían presentarse como observaciones sobre modelos específicos en un momento específico, y no como verdades generales. Los artículos deberían documentar el modelo, la versión y la fecha, y publicar las instrucciones y el código de análisis para que los hallazgos puedan volver a probarse en modelos futuros.
Los investigadores citan una publicación de Andrej Karpathy que describe cómo las brechas de percepción sobre el comportamiento real de los LLM afectan la confianza en la IA y la frecuencia con que la gente la usa. Karpathy, cofundador de OpenAI que luego se sumó a Anthropic, dijo hace poco que los modelos disponibles hoy son apenas un adelanto de las capacidades futuras.