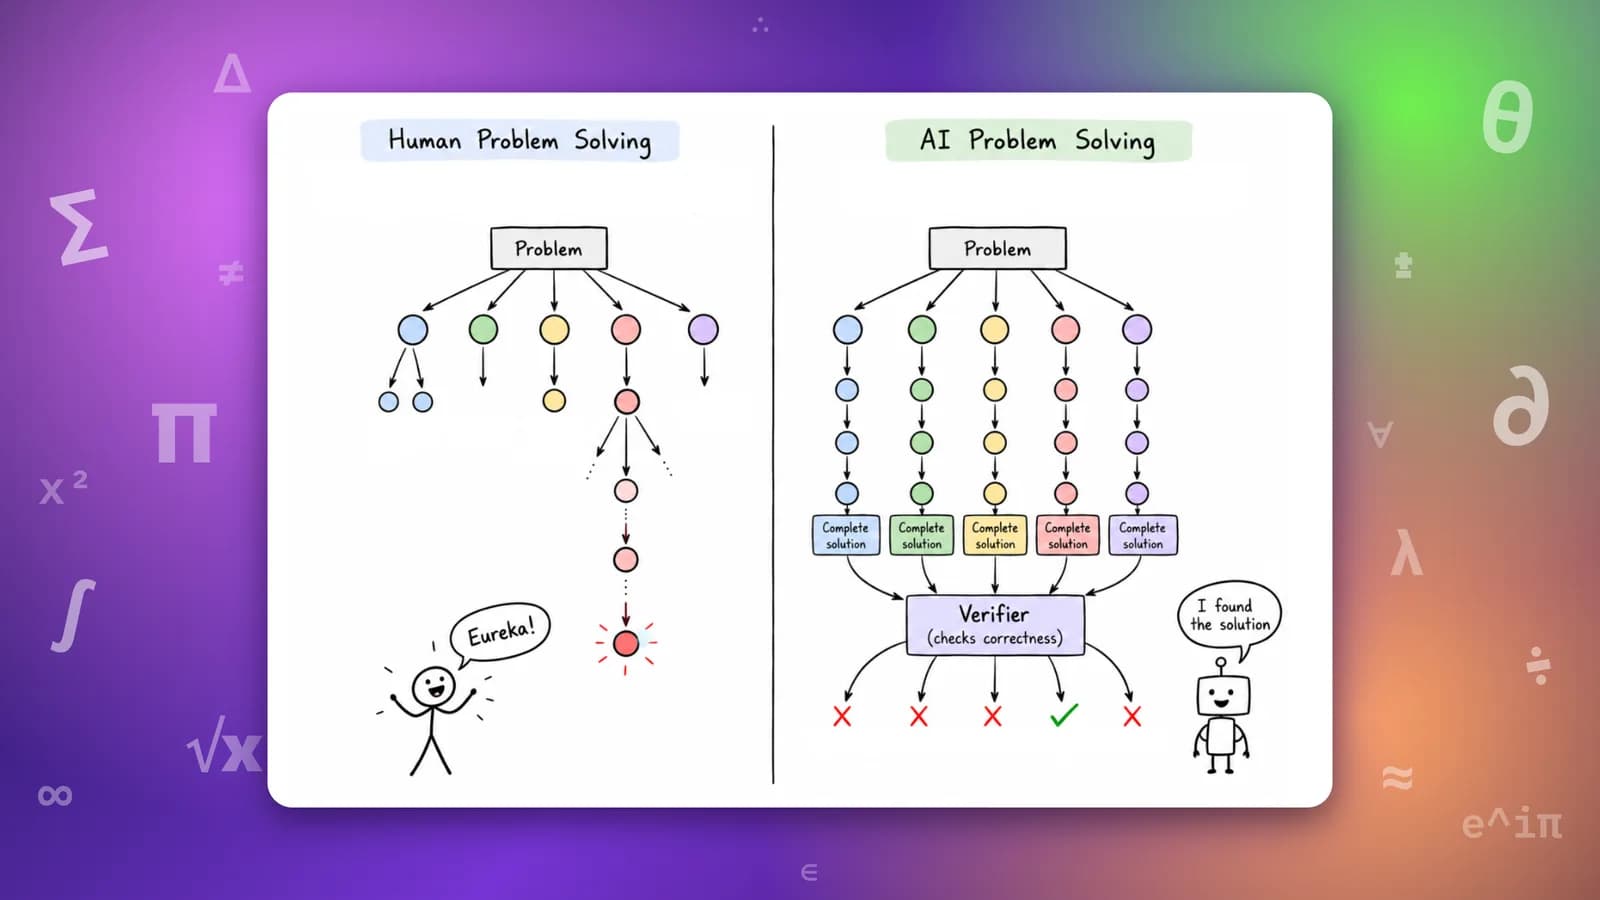
La pregunta que plantea el análisis publicado por Latent Space el 23 de octubre es si se puede predecir qué tipo de problemas van a resolver estos modelos. ¿Qué hace que un problema sea abordable para un LLM, y qué tienen en común sus soluciones? Si la IA resuelve problemas de otra manera que los humanos, identificar esa diferencia debería ayudar a decidir dónde apuntarla. El autor parte por la refutación del problema de la distancia unitaria, que es la que tiene los comentarios más completos.
Un modelo mental de pistas y trabajo
Para resolver cualquier problema hace falta una secuencia de pistas o ideas, con trabajo entre una y otra. El esquema calza sorprendentemente bien tanto con problemas cotidianos como con ideas complejas como la relatividad general. La secuencia se ve más o menos así:
Idea, luego tiempo y esfuerzo, luego otra idea, luego tiempo y esfuerzo, y al final la solución.
Un experto necesita menos pistas que un principiante porque tiene más formación. En su comentario sobre la prueba de distancia unitaria, el matemático W. T. Gowers usa una idea parecida. Para él, la dificultad de una prueba es la secuencia más corta de pistas que le permitiría a un experto reconstruirla, y la llama complejidad de Kolmogorov módulo expertos. En el problema de la distancia unitaria, su secuencia tenía tres partes:
- Buscar un contraejemplo.
- Tomar la mejor construcción conocida y generalizarla.
- Probar una sucesión de cuerpos de números de grado creciente, pero trabajando con ideales primos de norma acotada.
La fórmula que propone Gowers para la complejidad es 2^k + t, donde k es el largo de la secuencia más corta de pistas y t es el trabajo necesario para desarrollarla. Es el tipo de fórmula que parece rigurosa hasta que uno intenta ponerle un número, y en buena medida ese es el punto. La complejidad crece de forma exponencial con la cantidad de ideas que exige un problema.
Casi todo el trabajo de resolver un problema ocurre entre esas ideas. Uno tiene un momento de inspiración y después pasa meses desarrollándolo hasta que se hace posible otro salto conceptual. Para un experto, el tiempo invertido sirve como indicador de ese trabajo, y de ahí sale la t. Si a alguien se le entrega la primera pista de la distancia unitaria, todavía tiene que trabajar bastante para llegar a la construcción generalizada.
El esquema sirve, pero solo después de los hechos. Nadie puede mirar un problema y predecir que va a necesitar x pistas. Por eso se usan como indicadores de dificultad la antigüedad del problema, la cantidad de intentos y el premio que tiene asociado.
¿Qué vuelve valiosa una pista?
Una idea típica cambia la formulación del problema. Cambia la forma de representarlo y de entenderlo. Dos factores deciden cuánto vale una pista:
- Lo improbable que parecía antes contra lo obvia que se ve después de darla. Esto es más difícil de lo que se cree. En el caso de la distancia unitaria, muchos expertos no veían probable un contraejemplo.
- El lugar que ocupa en la secuencia. Las pistas tienen orden, y la tercera solo sirve cuando el trabajo sobre las dos primeras avanzó lo suficiente para que se pueda aplicar. Eso echa abajo la idea ingenua de fuerza bruta, la de listar mil técnicas matemáticas y probar todas las combinaciones. La secuencia de pistas recorre un árbol, y las primeras ideas cambian el problema y revelan las opciones que vienen después.
Los humanos buscan a lo ancho
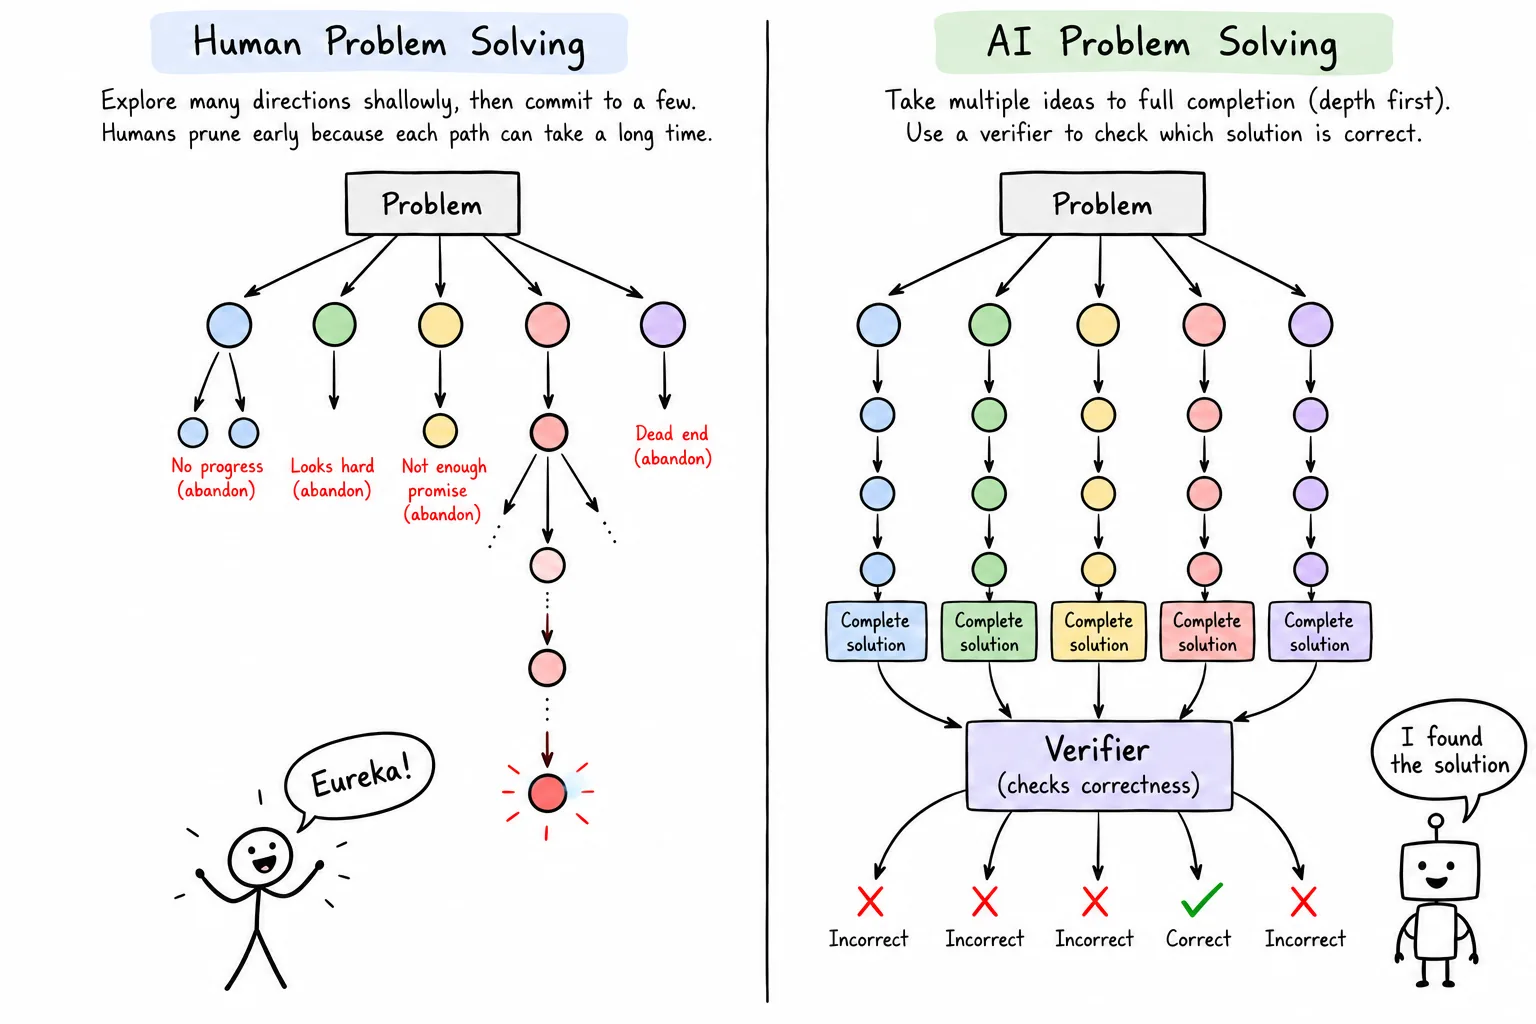
Si se juntan k y t aparece el patrón de búsqueda humano. Se generan direcciones candidatas, se exploran por encima, se abandona la mayoría y se apuesta por unas pocas. Una dirección prometedora se abandona si no da suficientes señales de avance al principio.
Es una restricción humana. Desarrollar una idea puede tomar meses, y antes de comprometerse un investigador necesita motivos para creer que lleva a alguna parte, ya sea su promesa conceptual, resultados tempranos o experiencia con problemas parecidos. Mientras más tarda en saberse, más alta queda la vara para intentarlo.
Casi todo el software de investigación existe para acortar ese tiempo, automatizando el trabajo tedioso, mecánico y repetible. La IA lo acorta tanto que el patrón de búsqueda se invierte, y todo lo demás se desprende de eso.
Primero, la t. El equivalente del esfuerzo en un modelo es el cómputo y los tokens, gastados en una sola trayectoria (cómputo en tiempo de prueba) o repartidos entre agentes en paralelo (cómputo paralelo en tiempo de prueba). El preentrenamiento, además, aporta conocimiento que un investigador humano tendría que buscar o reconstruir. Ningún experto conoce todos los avances previos, así que de vez en cuando termina rehaciendo algo que ya estaba hecho.
¿Cómo buscan los modelos?
La diferencia más grande está en la forma de buscar.
Con un solo prompt, el modelo entrega una solución, que puede ser correcta o no. Si se le pide una prueba, entrega algo que se acerca a una buena prueba. La cadena de razonamiento de estos modelos también avanza de forma voraz y en profundidad. Y el proceso escala. Con diez enfoques repartidos entre agentes en paralelo se obtienen diez intentos desarrollados hasta una conclusión, quizás todos distintos o algunos superpuestos. Cada uno choca con un obstáculo o produce un argumento que parece correcto. Sin control, esto produce pruebas falsas muy bien escritas.
Parece un derroche de cómputo y recursos hasta que se agrega un verificador automático capaz de podar las trayectorias terminadas e identificar las correctas. Con ese revisor pasa a ser racional gastar una enorme cantidad de cómputo en ideas inciertas, porque en minutos se sabe si una idea funciona. El problema es que el verificador solo juzga argumentos terminados y no puede decir si una idea a medio desarrollar va a alguna parte.
¿Qué tan buena tiene que ser una pista si se puede comprobar en cinco minutos si funciona? Para un humano la vara es alta, porque seguir una pista puede costar meses. Para un modelo la vara casi desaparece. La pista puede ser corriente, improbable o apenas esbozada, y seguirla es lo que establece si lleva a algo. Los LLM permiten cambiar tiempo por cómputo y atacar más problemas en menos tiempo.
Los intentos fallidos también son pistas
El modelo no necesita una dirección definida para empezar. El preentrenamiento ya le da nociones previas sobre la historia del problema y los intentos anteriores. Cada solución equivocada puede volver al modelo como pista negativa para la siguiente iteración, y el sistema va acumulando instrucciones sobre lo que ya falló y por qué. A grandes rasgos, el harness (el software que orquesta a los modelos) tiene tres piezas:
- Redactor. Escribe los prompts para el modelo que resuelve. Se basa en lo que el modelo ya sabe, corrige los errores de corridas anteriores y toma en cuenta todos los caminos prometedores que no llevaron a nada, que funcionan como pistas negativas.
- Resolutor. Toma los prompts y produce una o varias soluciones candidatas. Puede lanzar varios subagentes y seguir caminos distintos con cómputo paralelo en tiempo de prueba.
- Verificador. Comprueba si el argumento es válido y si establece el resultado pedido.
Un ejemplo es este prompt de OpenAI para la conjetura de la doble cobertura de ciclos (CDC). El análisis comenta tres de sus instrucciones:
- Asume para efectos de esta tarea que existe una prueba afirmativa completa. Según el autor, esto evita que el modelo tome el estado abierto del problema, que aprendió en el preentrenamiento, como razón para detenerse.
- En particular, no bastan las pruebas para clases especiales de grafos, las construcciones de coberturas de ciclos con aristas cubiertas un número de veces distinto de dos, las variantes de largo acotado o de ciclos prescritos, las reducciones a otra conjetura no probada, la verificación computacional hasta un tamaño fijo de grafo ni los contraejemplos candidatos sin un certificado completo de no existencia. Esto descarta un catálogo de sustitutos de resolver el problema real.
- Usa agentes adversariales en todo el proceso. Cada prueba candidata debe revisarse por multiplicidad exactamente dos, recorridos cerrados con aristas repetidas que se hacen pasar por ciclos, 2-ciclos de aristas paralelas, grafos desconexos, vértices de corte, puentes introducidos por las reducciones y uso circular de un enunciado equivalente de la CDC. Son los modos de falla ya catalogados, convertidos en revisiones permanentes.
Hay además una línea contra la pereza aprendida: No te detengas solo porque los enfoques actuales fallan o porque los agentes reportan vacíos del tamaño de un teorema.
Lo probable, según el análisis, es que OpenAI haya hecho varias rondas de intentos y que el redactor haya tomado los errores y las ideas fallidas para alejar de ellas la iteración siguiente. Cada una de esas líneas es un camino fallido escrito como instrucción.
La prueba de distancia unitaria, reconstruida
El autor relee las tres pistas de Gowers con esa lógica:
Pista 1, buscar un contraejemplo. Es de verdad difícil, porque tanto la comunidad como el preentrenamiento del modelo dicen que la conjetura es verdadera. Lo más plausible es que el redactor llegara a ella porque los resolutores fallaban una y otra vez al intentar una prueba. Ese encuadre evita que el modelo trate la visión aceptada como la dirección obligada. Cada intento fallido hace que un contraejemplo parezca un poco menos improbable.
Pista 2, tomar la mejor construcción conocida y generalizarla. Es la más cercana a lo que haría la comunidad, un movimiento estándar. El trabajo grueso está en desarrollar la generalización lo suficiente para descubrir lo que permite, y ese es el paso de t grande. Pero se trata de generalizar un contraejemplo, algo que casi nadie estaba buscando.
Pista 3, probar cuerpos de números de grado creciente. Es maquinaria estándar una vez que las dos primeras pistas armaron el espacio donde se aplica.
El orden importa. Si se parte por la tercera pista, ni siquiera se sabe que el ejercicio es una refutación. Si se salta la construcción generalizada, la tercera no tiene sobre qué actuar. Y aun con las tres, el esfuerzo sigue siendo enorme. La pista del contraejemplo parece obvia en retrospectiva, lo que lleva a preguntarse por qué nadie la intentó. En realidad, algunos sí lo hicieron.
Jacob Tsimerman, recién contratado por OpenAI, trabajó en el contraejemplo. Conocía la teoría de números e incluso consideró grados crecientes. Y se detuvo. Buscar un contraejemplo era la primera idea y todavía era solo el comienzo. Lo que lo frenó no fue falta de habilidad. Fue la sensación, muy sensata, de alguien que lleva varias semanas metido en un pantano sin ninguna evidencia de que tenga otra orilla.
La psicología describió este lado humano de la resolución de problemas hace décadas. Los investigadores Metcalfe y Wiebe les preguntaban a los participantes cada quince segundos qué tan cerca se sentían de la solución. En problemas comunes, la sensación de avance subía. En problemas de intuición se mantenía plana hasta que encontraban la respuesta, sin ninguna señal de progreso que sostuviera la búsqueda. Los problemas de intuición no tienen gradiente. Uno no sabe qué tan cerca está hasta que los resuelve.
Para un experto la pregunta es doble. ¿Alguien entra a esa rama, que es la pista? Y una vez adentro, ¿se queda lo suficiente para que la competencia ordinaria termine el trabajo? Quedarse cuesta memoria de trabajo, ánimo y carrera, y seguir un camino que la comunidad da por equivocado multiplica los tres costos. Para un LLM esto es una ventaja enorme. El matemático Arul Shankar lo describió así:
"El modelo pasó por las ideas bastante rápido, pero cuando llegó a la idea crucial (en el párrafo que empieza con 'Supongamos con optimismo que...'), se concentró en la prueba de forma bastante metódica."
Todo se reduce a dos preguntas. ¿Cuántas ideas necesita un problema? ¿Y cuánto trabajo hay entre ellas antes de poder saber si una dirección vale la pena? Tsimerman describe el lado de la IA:
"Esto podría indicar una forma en que los sistemas de IA tienen ventaja. No es solo que puedan probar todos los métodos conocidos, sino que pueden jugar por más tiempo y en aguas más traicioneras que los matemáticos sin abrumarse. Por supuesto, esto todavía no es robustamente cierto, pero puede ser un evento que anticipa lo que viene."
Navier-Stokes, Fermat y Riemann siguen el mismo patrón
La prueba de OpenAI sobre Navier-Stokes muestra el mismo proceso. Según una lectura rápida del autor, lleva hasta el final el trabajo de Córdoba y Martínez-Zoroa. La prueba tiene 166 páginas, con muchas correcciones y matemática compleja, pero en saltos conceptuales no ofrece tantos.
El trabajo de Anthropic sobre Fermat y Riemann, que viene con abundantes comentarios, deja ver el mismo esqueleto. Cientos de ideas fallidas, varios agentes bajo un solo orquestador, scripts y verificadores por todos lados, y un número pequeño de saltos conceptuales que cargan con el peso.