La empresa china Moonshot AI lanzó Kimi K3.1 Pro, una versión de Kimi K3 entrenada con bastante más cómputo en la etapa posterior al preentrenamiento. Según Artificial Analysis, el modelo marca 55 puntos en su Intelligence Index, 11 más que K3, y con eso sube al cuarto lugar de la tabla.
Arriba solo quedan tres modelos. Claude Opus 5.5 suma 58 puntos, mientras Claude Sonnet 5.5 y Muse Wonder Full empatan en 56. Si Moonshot libera los pesos como anunció, a más tardar el 4 de noviembre de 2026, K3.1 Pro pasaría a ser el modelo de pesos abiertos con mejor puntaje disponible. La distancia entre modelos abiertos y propietarios bajaría de 12 a 3 puntos, siempre que nada más cambie en ese plazo, informó The Decoder el 23 de octubre.
Junto con K3.1 Pro llega una variante llamada K3.1 Pro Highspeed, que según la compañía responde entre dos y tres veces más rápido. Las dos ya están disponibles en Kimi.ai, Kimi Work, Kimi Code y la API de Kimi.
| Concepto | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Entrada | 2 dólares por millón de tokens | 4 dólares por millón de tokens |
| Salida | 10 dólares por millón de tokens | 20 dólares por millón de tokens |
| Entrada en caché | 0,20 dólares por millón de tokens | 0,20 dólares por millón de tokens |
¿Dónde mejora más Kimi K3.1 Pro?
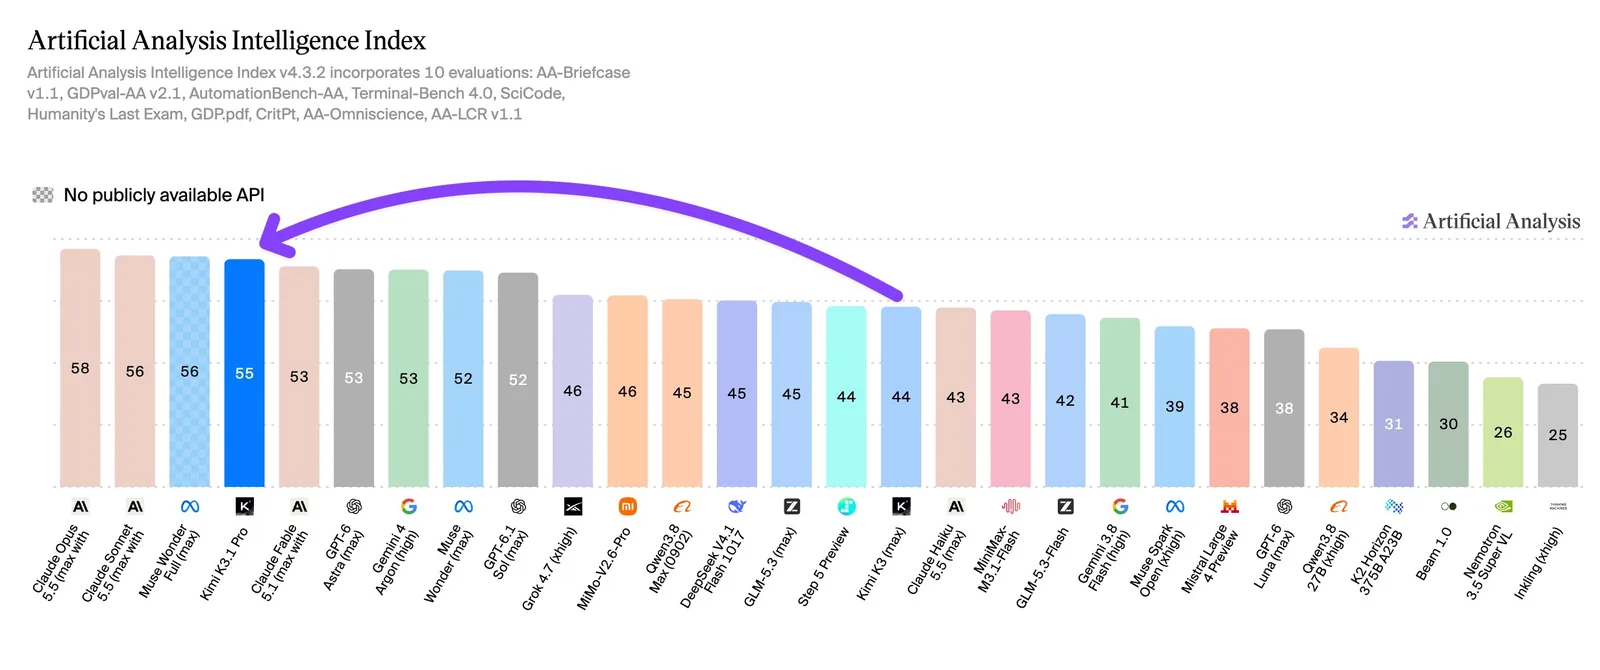
El salto más grande está en las tareas de agentes. En GDPval-AA, el modelo llega a 1.846 de Elo según Artificial Analysis, 312 puntos sobre K3. Eso lo deja apenas detrás de Claude Opus 5.5 (1.866) y de Muse Wonder Full (1.857).
En Terminal-Bench 4.0, Moonshot reporta 65,7%. Supera a GPT-6 Astra, que marca 58,2%, y queda a menos de un punto de Claude Opus 5.5, con 66,4%. K3 había sacado 13% en la misma prueba.
Las alucinaciones también bajaron. En Kimi Hallu Bench Hard, una prueba interna de Moonshot, la tasa de afirmaciones alucinadas cayó de 23,4% con K3 a 8,3%, según la empresa. Moonshot aclara que es una prueba de estrés y no una medida de la tasa general de errores. GPT-6 Astra marca 5,5% en esa misma prueba, así que mantiene la ventaja.
En las pruebas internas de finanzas, K3.1 Pro ganó 7,2 puntos en Financial Modeling y 11,6 en Financial Research. En tareas generales de oficina encabeza OfficeQA Pro v2 entre todos los modelos evaluados, según Moonshot.
| Prueba | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 | DeepSeek-V4.1-Flash | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 | 66,4 | 58,2 | 57,9 | 42,3 | 41,8 |
| SWE Marathon v1.1 | 51,7 | 46,3 | 42,5 | 45,6 | 40,0 | 42,5 |
| DeepSWE v1.1 | 75,5 | 74,2 | 74,1 | 67,4 | 77,0 | 66,9 |
| BenchCAD (con herramientas) | 92,7 | 96,2 | 95,9 | 92,6 | 81,6 | sin dato |
| HLE-Full (con herramientas) | 70,0 | 67,7 | 57,2 | 65,6 | 58,8 | 62,5 |
| BrowseComp | 92,1 | 90,8 | 91,5 | sin dato | sin dato | sin dato |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | 54,5 | 40,4 | 31,1 |
| Automation Bench-AA | 73,3 | 69,5 | 68,5 | 59,4 | 66,6 | 62,2 |
| GDPval-AA v2.1 (Elo) | 1.846 | 1.866 | 1.573 | 1.754 | 1.746 | 1.650 |
| GPQA-Diamond | 94,2 | 93,9 | 96,1 | 93,7 | 92,2 | 91,7 |
| ExploitBench | 74,7 | 91,0 | 100 | 83,0 | sin dato | 54,4 |
La tabla es la que publicó Moonshot, con todos los resultados medidos con el esfuerzo de razonamiento en "max".
Modelado 3D y programación
K3.1 Pro trabaja directo con motores de juego como Unity, Unreal Engine y Godot, tanto para arreglos rápidos como para armar proyectos completos, según Moonshot. En BenchCAD obtiene 92,7% con herramientas, cerca de Claude Opus 5.5 (96,2%) y de GPT-6 Astra (95,9%). Sin herramientas llega a 72,8%, casi lo mismo que Claude Opus 5.5, que marca 73,0%.
La compañía dice que el modelo rinde mejor en el modelado paramétrico de piezas mecánicas, en maquetas de arquitectura y en productos configurables. Escribe y ejecuta scripts para Blender y para programas CAD sin conectores MCP. Moonshot también estrenó en Kimi.com una función llamada "3D Make", que permite previsualizar, editar y exportar modelos 3D.
¿Cuánto cuesta usar Kimi K3.1 Pro?
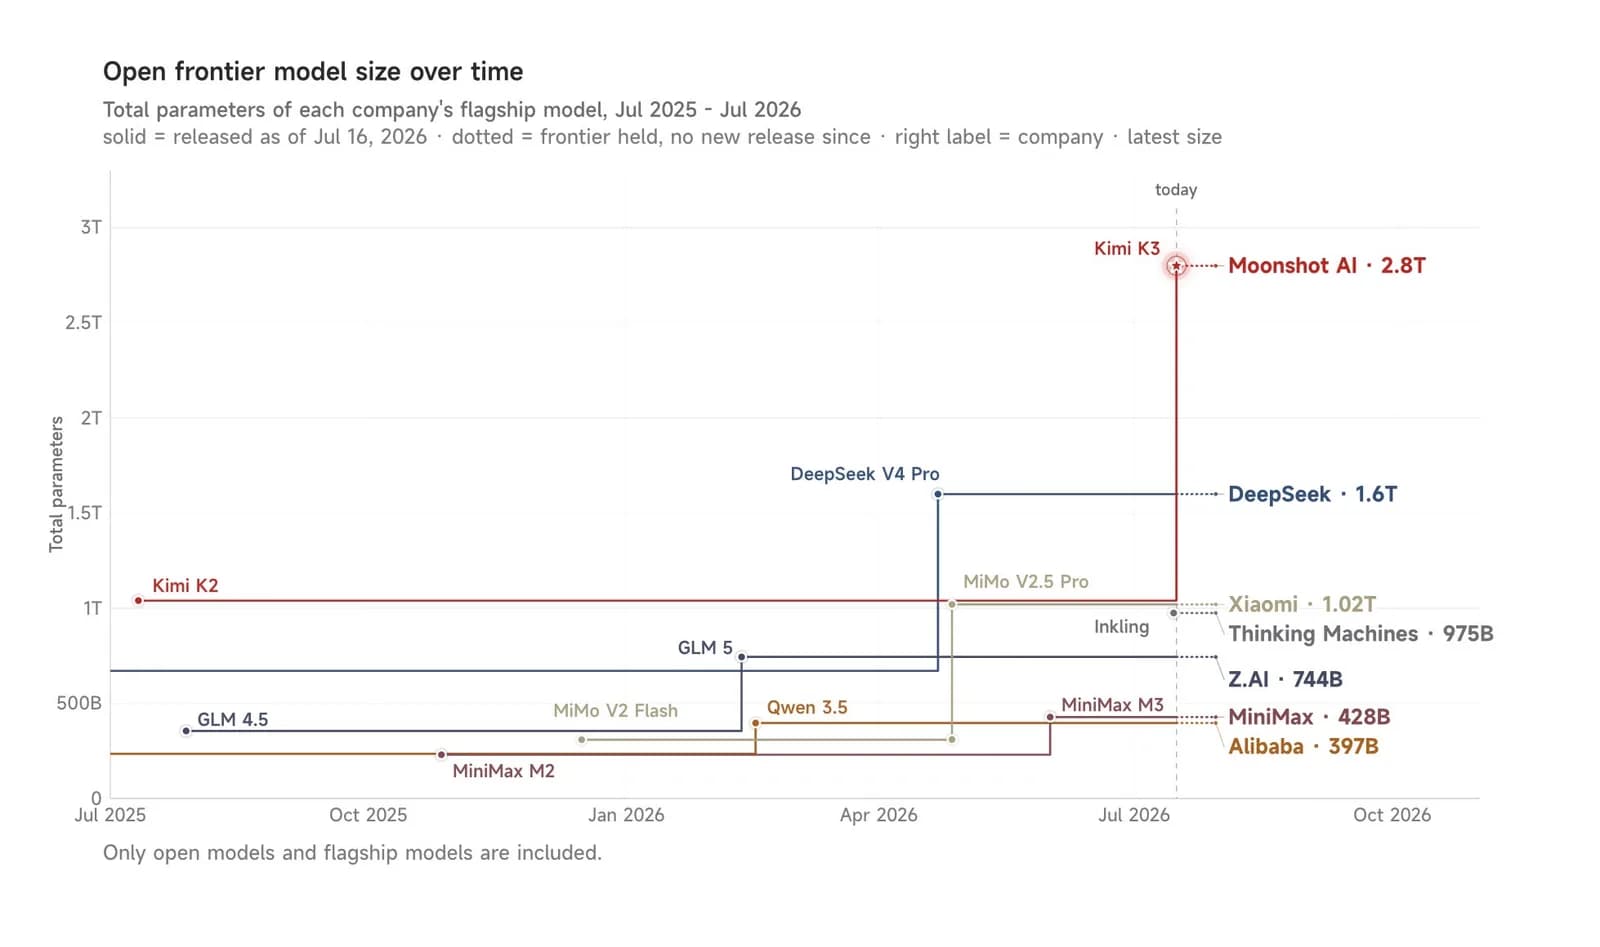
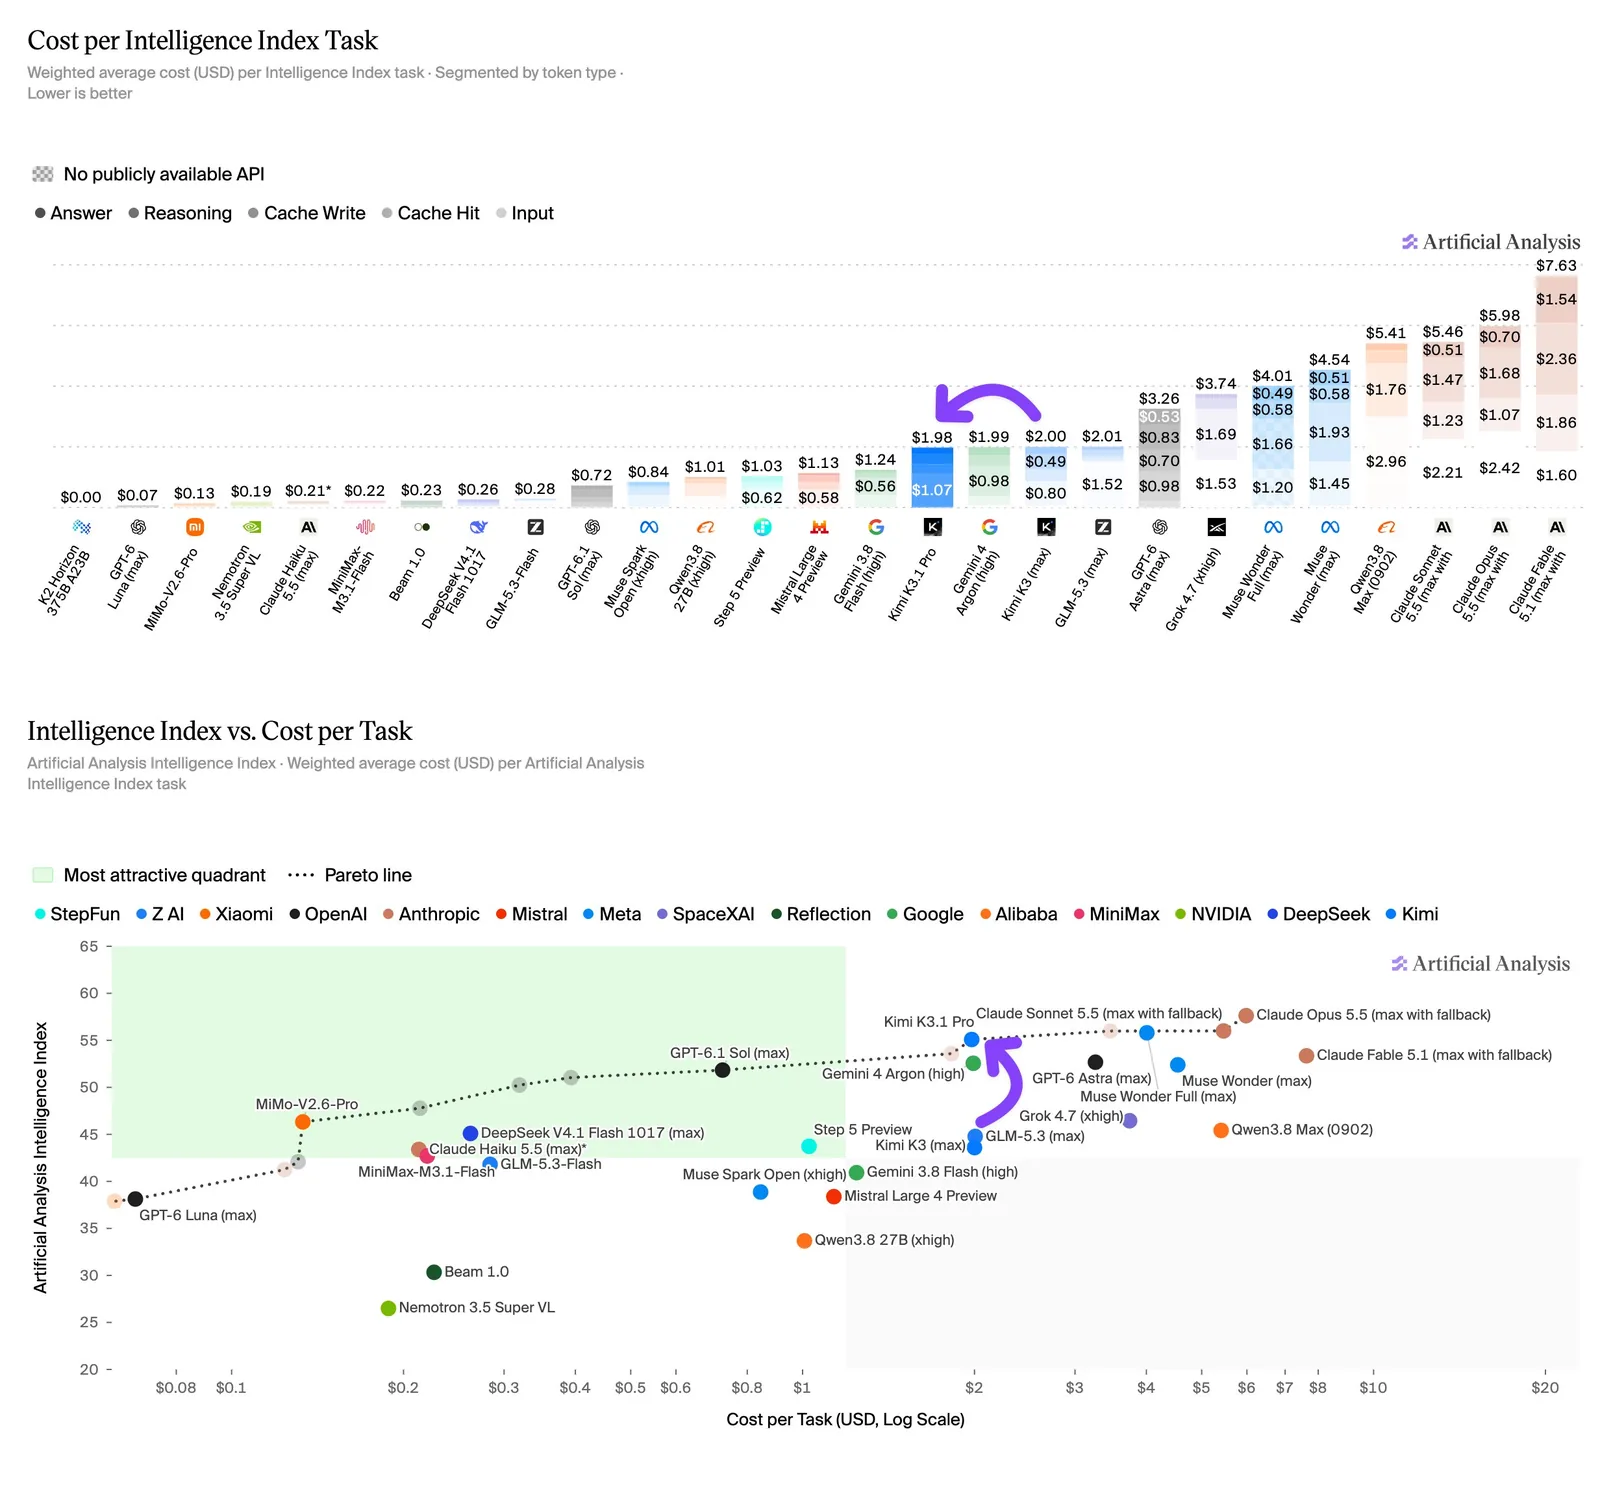
El modelo conserva el tamaño de K3. Son 2,8 billones de parámetros en total y 104.000 millones activos, con una ventana de contexto de un millón de tokens y entrada de texto e imágenes. Según Artificial Analysis, está en la cima de la frontera de Pareto. Ningún modelo con una cantidad de parámetros comparable puntúa más alto en el Intelligence Index.
Los precios por token bajan 33%. La entrada cuesta 2 dólares por millón de tokens (antes 3), la salida 10 dólares (antes 15) y los aciertos de caché 0,20 dólares (antes 0,30). Cada tarea del Intelligence Index cuesta 1,98 dólares, casi lo mismo que con K3 (2 dólares), porque el modelo nuevo genera 14% más tokens de salida.
Ciberseguridad y límites puestos a propósito
Moonshot dedica una sección entera de su publicación técnica a la ciberseguridad. La empresa cuenta que la capacidad del modelo para investigar vulnerabilidades crecía a medida que escalaba el entrenamiento posterior. Pasaba porque había contenido de ciberseguridad mezclado en el corpus general del entrenamiento intermedio y porque esas tareas formaban parte de los entornos de aprendizaje por refuerzo.
Para la versión de pesos abiertos, Moonshot sacó los datos de ciberseguridad de las dos etapas de entrenamiento. En xdev-bench-hard, su prueba interna que reproduce vulnerabilidades divulgadas hace poco en software como el kernel de Linux, Node.js y JavaScriptCore, la versión sin limpiar resuelve 90,5% de las tareas. Tras la limpieza, K3.1 Pro resuelve 81,0%. DeepSeek-V4.1-Flash llega a 85,7% en la misma prueba y Kimi K3 había marcado 33,3%.
Moonshot sostiene que ningún modelo de pesos abiertos debería empujar el límite absoluto de las capacidades ofensivas en ciberseguridad. Al mismo tiempo, quiere subir de a poco lo que pueden hacer los modelos abiertos, porque también sirven para tareas defensivas como auditar sistemas heredados. Anthropic ya había mostrado que incluso GLM-5.3, con 45 puntos en el índice de Artificial Analysis, escribe exploits a un nivel cercano al de Claude Mythos.