Mistral publicó el 4 de agosto Shieldstral, un clasificador de seguridad multimodal de 3.000 millones de parámetros con pesos abiertos bajo licencia Apache 2.0. La empresa lo liberó como miembro fundador de la Open Secure AI Alliance junto a NVIDIA y otras organizaciones, y el modelo se descarga desde Hugging Face. El detalle técnico está en el informe.
"¿Este contenido promueve violencia contra un grupo protegido? ¿Es seguro mostrarle esta imagen a un menor? ¿El asistente rechazó la solicitud?"
Todo producto que despacha un modelo necesita responder preguntas así, y la respuesta correcta depende del producto, de la audiencia y del momento. El mismo contenido puede ser aceptable en una herramienta de investigación en ciberseguridad y dañino en una plataforma de salud mental.
¿Por qué no sirve una taxonomía fija?
La mayoría de los modelos de guardia deja una taxonomía fija de categorías de daño cocinada dentro de sus pesos. Reapuntarlos a un contexto de despliegue nuevo obliga a reentrenar. Y como las definiciones de seguridad difieren entre aplicaciones y dominios, no existe de entrada un conjunto de categorías que sea el correcto.
Shieldstral toma otro camino. La política se escribe como una pregunta en lenguaje natural en el momento de la inferencia y el modelo devuelve un puntaje de seguridad calibrado. Sin reentrenamiento, con una sola interfaz para texto e imágenes, y con un veredicto que sale de un único token.
La moderación planteada como una pregunta
Shieldstral encuadra la moderación de contenido como una tarea binaria de pregunta y respuesta. Cada solicitud tiene tres partes.
<Instruct>, el contexto de evaluación, el nivel de rigor y, de forma opcional, una definición de qué cuenta como contenido inseguro.<Query>, una única pregunta de sí o no, por ejemplo "¿Este contenido promueve violencia física?".<Document>, el contenido a juzgar. Un prompt, una respuesta, un par de prompt y respuesta, o una imagen con texto opcional.
Al inferir, el modelo lee solo los logits de yes y no y los normaliza con softmax en un puntaje continuo de seguridad. Esa formulación hace bastante trabajo. Unifica en un mismo problema la clasificación de prompts, la moderación de respuestas, la detección de rechazos y la detección de toxicidad, y deja que las políticas vivan enteras dentro del prompt, de modo que un mismo punto de control se adapta a políticas nuevas en el despliegue.
Lo que declara Mistral
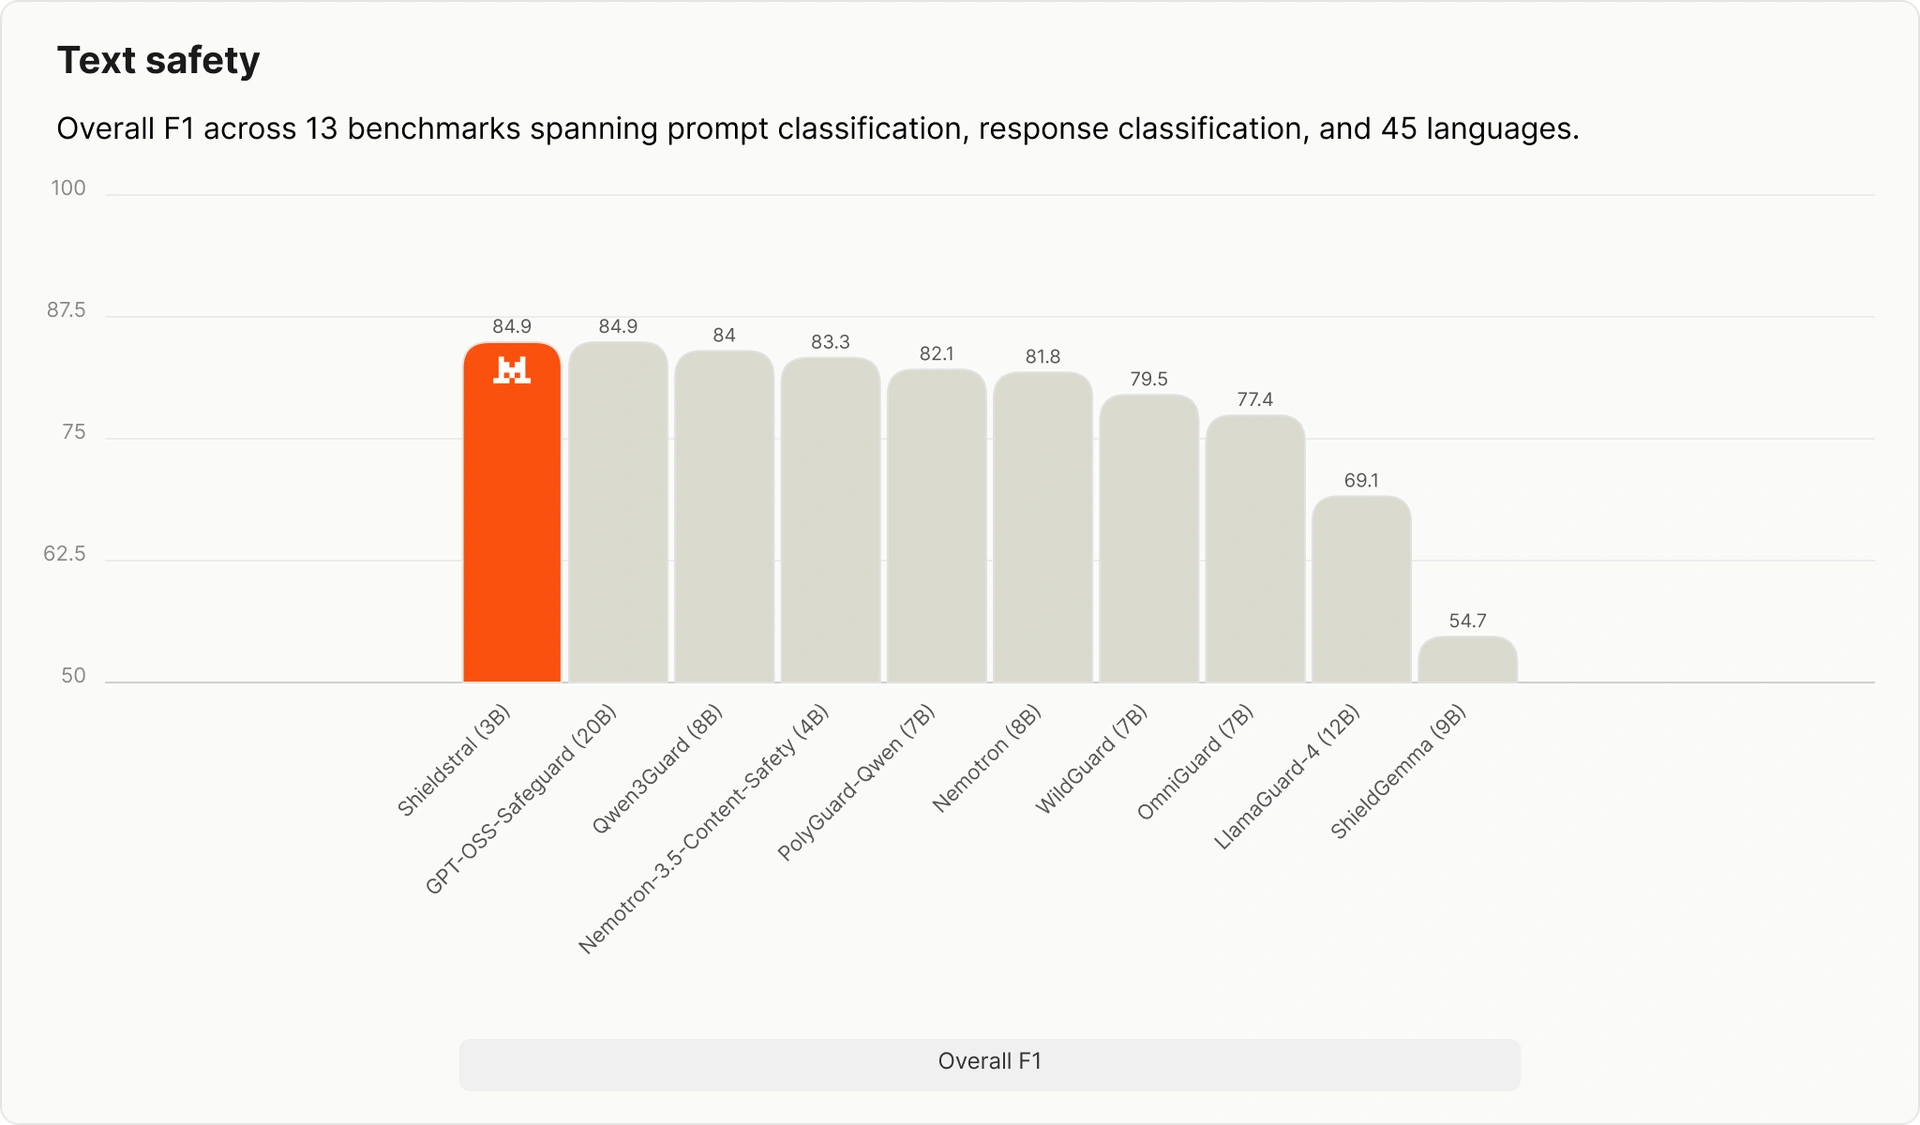
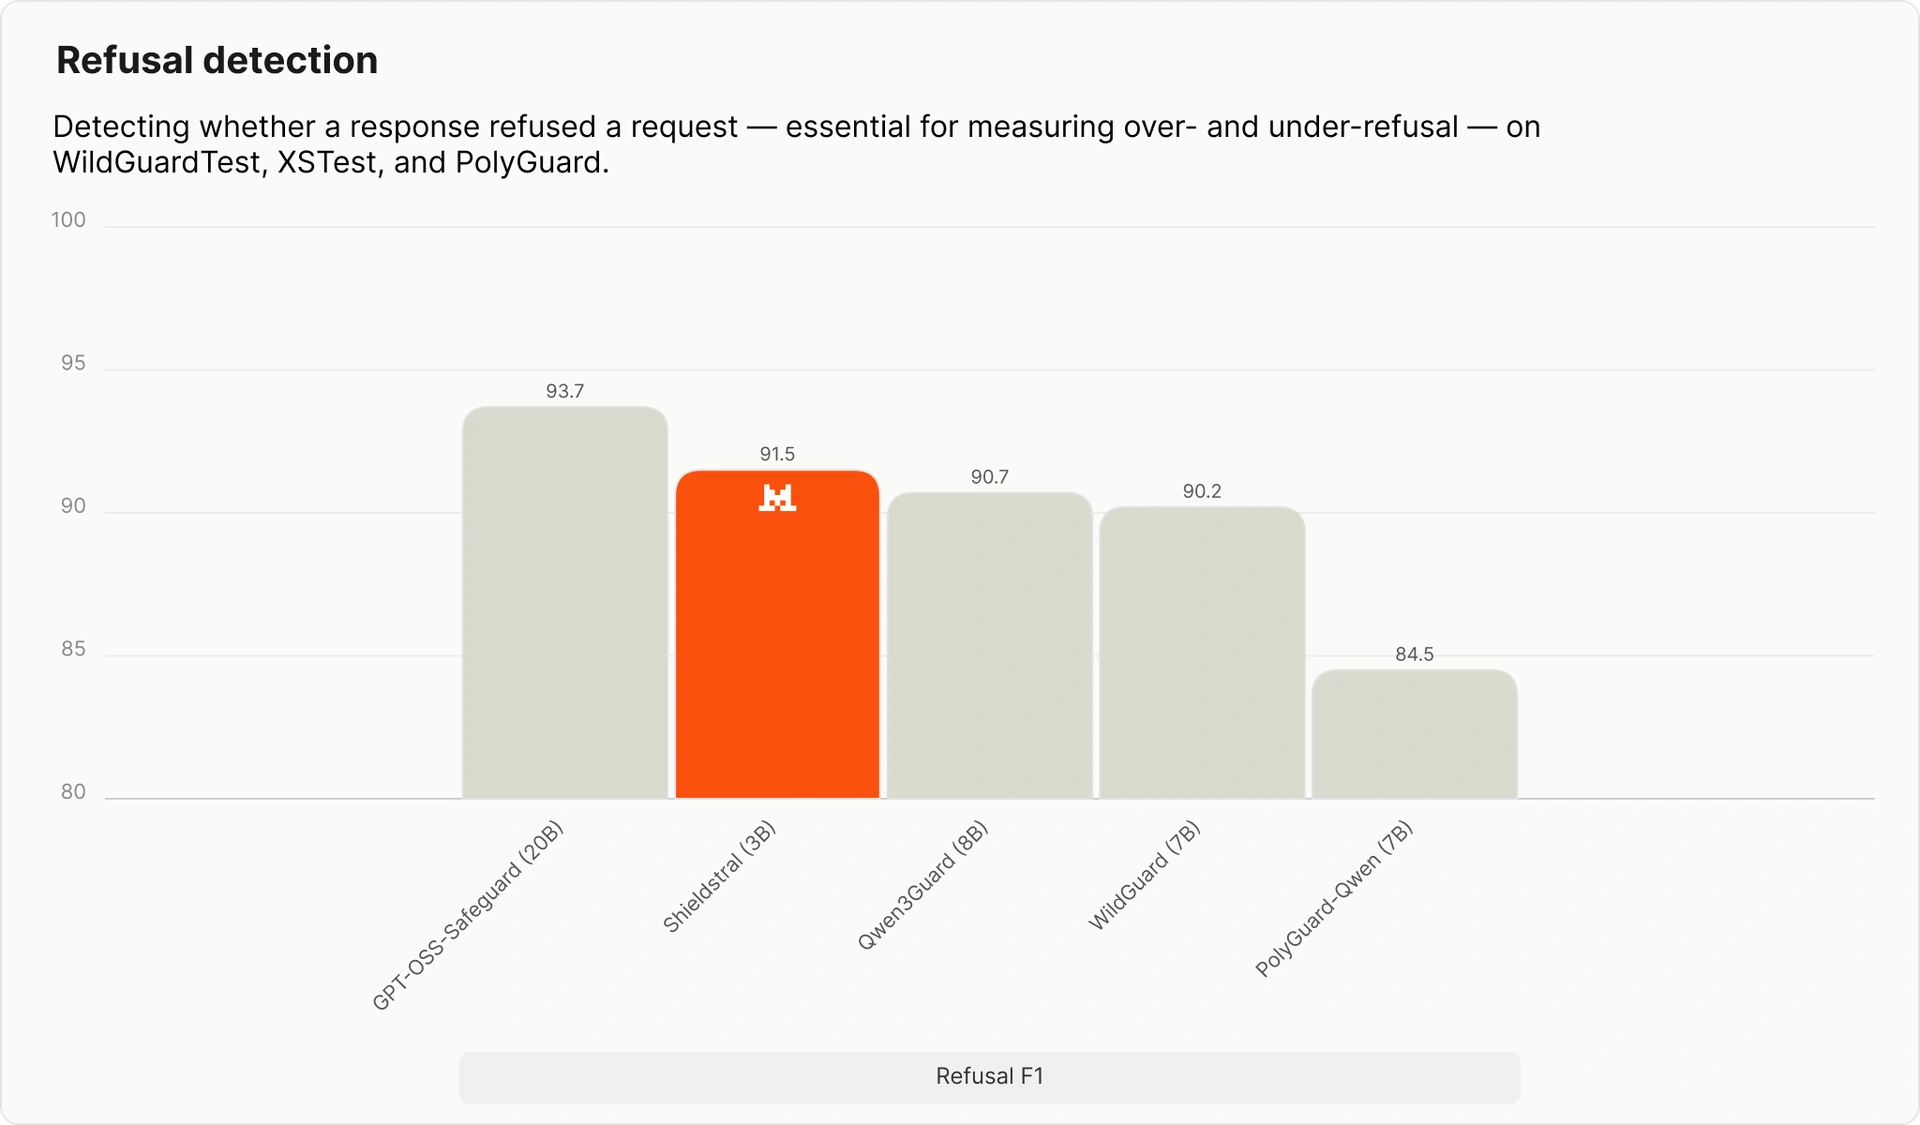
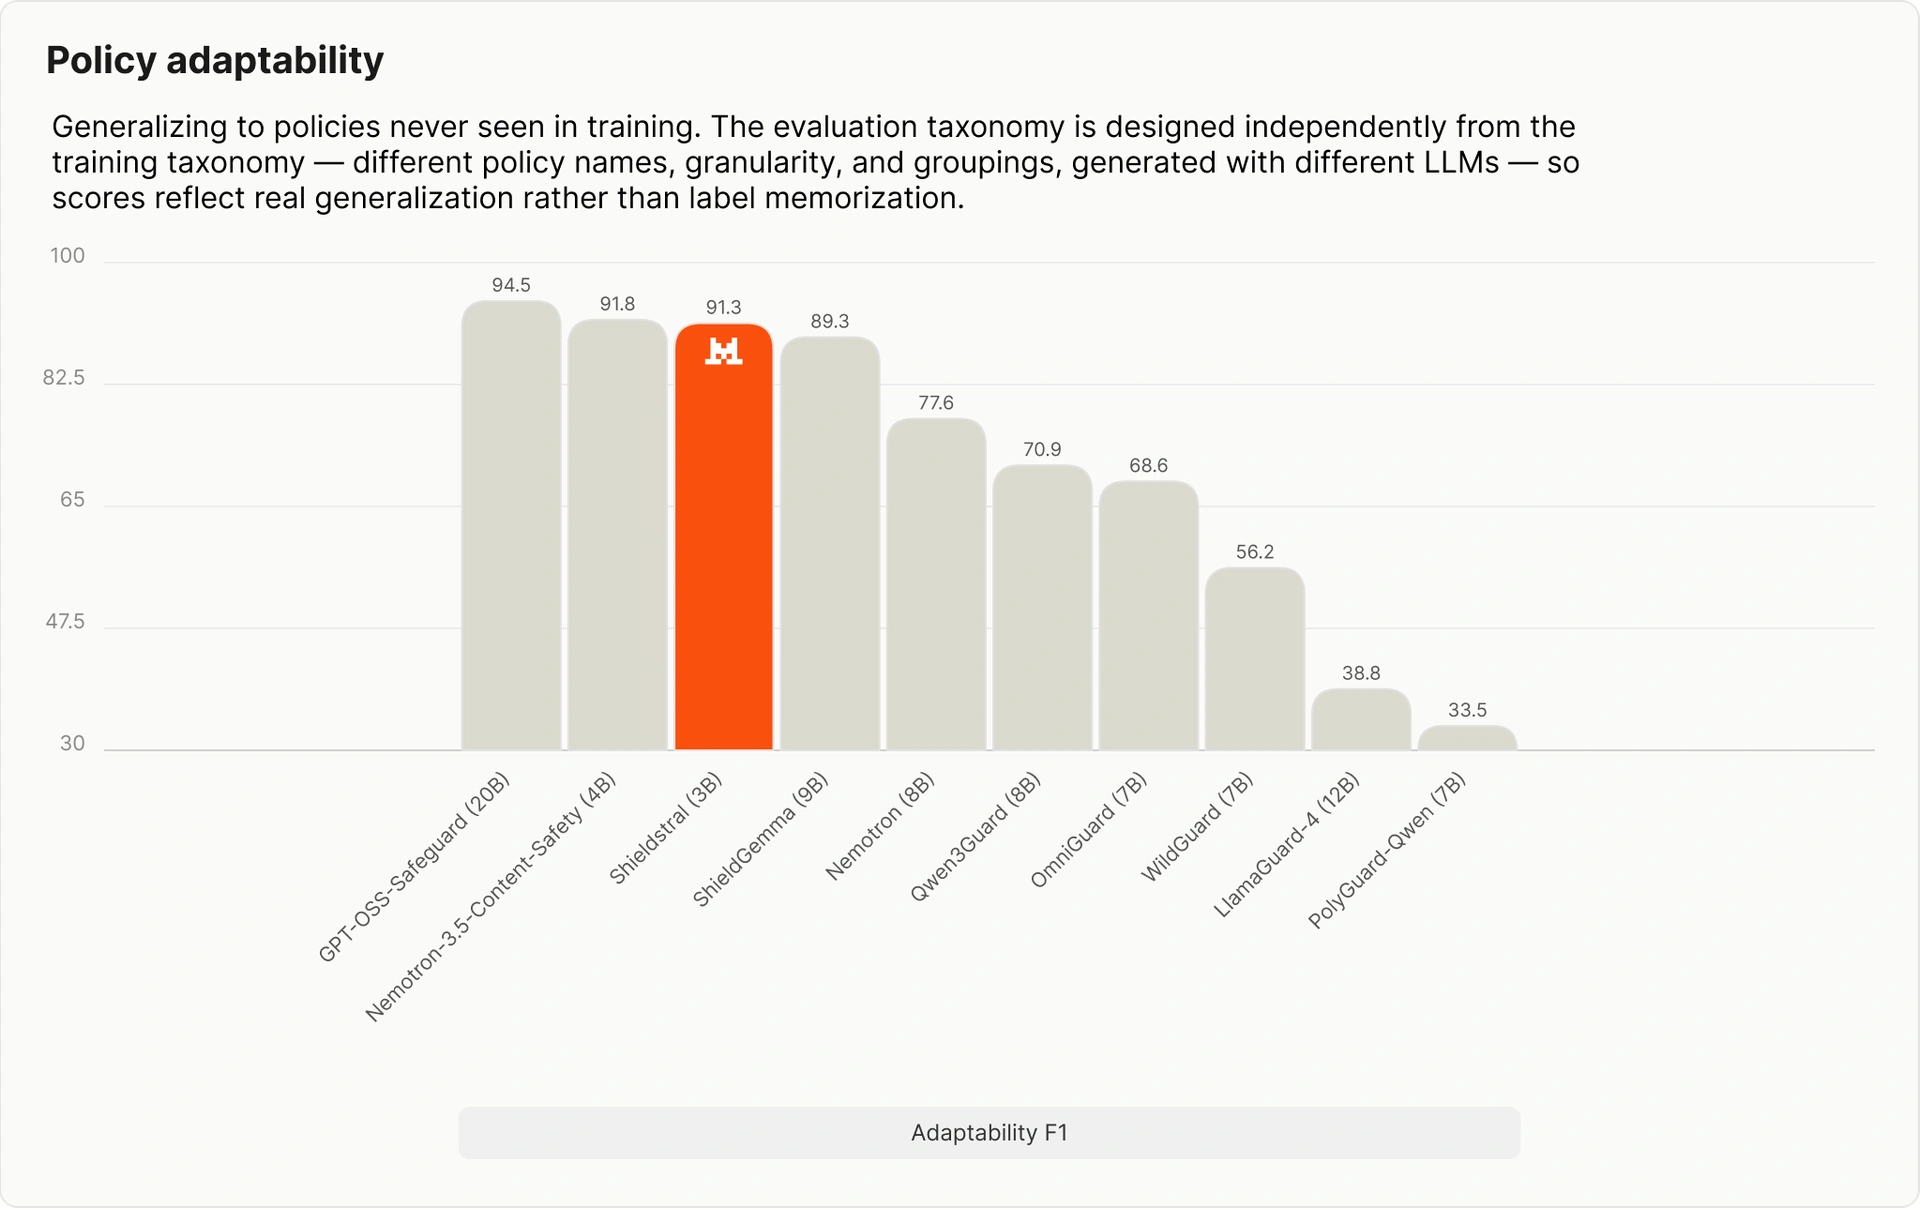
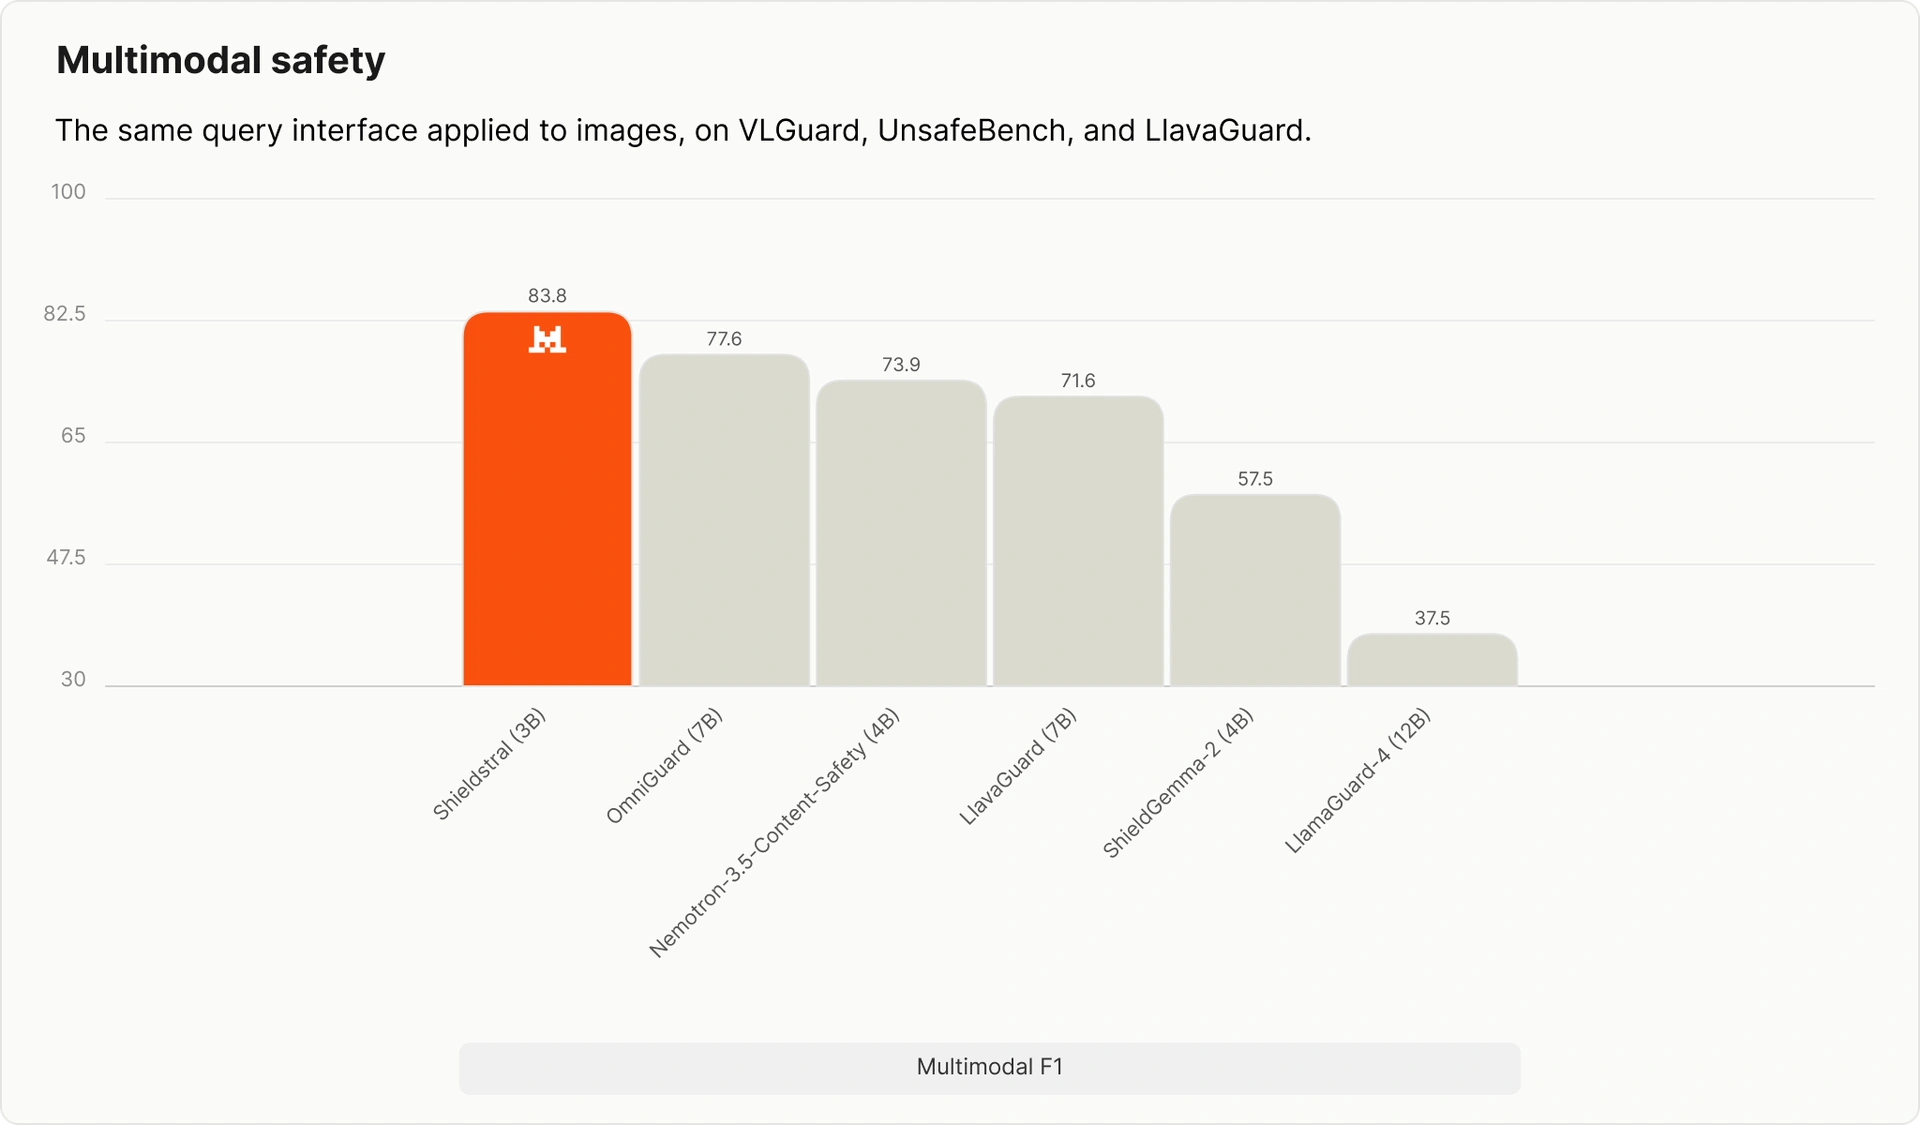
- Desempeño. Iguala o supera a modelos de guardia abiertos de hasta 7 veces su tamaño en seguridad de texto, detección de rechazos, adaptabilidad de políticas y pruebas multimodales.
- Adaptable. Una sola interfaz en lenguaje natural cubre contenido de texto, de imagen y mixto, sobre prompts, respuestas y pares. Las políticas se entregan como consultas de formato libre y se reapuntan al momento de inferir, sin reentrenar.
- Chico y entrenado con fuentes heterogéneas. Un modelo de 3B que corre en una sola GPU de 16 GB, entrenado con datos reales y sintéticos de formatos de etiqueta y taxonomías diversas, consolidados en un solo marco.
- Puntaje continuo. Devuelve una probabilidad calibrada de
yesonoen una sola pasada hacia adelante, así que se puede aplicar un umbral o rankear por confianza en vez de depender de una etiqueta discreta. - Abierto. Pesos bajo Apache 2.0.
Los cuatro ejes de evaluación
Mistral evaluó el modelo contra modelos de guardia abiertos de hasta 7 veces su tamaño en cuatro ejes. Todas las muestras de evaluación quedaron fuera del entrenamiento.
¿Cómo lo entrenaron?
La idea de fondo es que un modelo chico le puede ganar a otros mucho más grandes si los datos están bien. Para Mistral eso significó resolver cuatro problemas.
Unificar datos heterogéneos. Los conjuntos públicos de seguridad no se ponen de acuerdo en taxonomías, etiquetas ni convenciones de anotación, desde banderas binarias de seguro o inseguro hasta taxonomías de múltiples etiquetas con grano fino. El equipo convierte cada conjunto al mismo formato de instrucción, consulta y documento con un procesador por conjunto, y varía la redacción de instrucciones, consultas y delimitadores para que el modelo generalice entre formulaciones en vez de sobreajustarse a un estilo. También calibra el rigor por fuente, estricto para jailbreaks adversariales y laxo para datos de calidad de respuesta.
Enseñar a discriminar y no a memorizar. Un modelo entrenado sobre un conjunto fijo de etiquetas de política aprende a clasificar esas políticas predefinidas, no a razonar sobre los límites precisos de una política dada. El equipo construye conjuntos de políticas deliberadamente parecidas y fáciles de confundir, y le pide a un modelo de lenguaje que reescriba texto seguro en pares contrastivos, donde cada reescritura viola una política pero no su hermana. Eso entrena la capacidad de distinguir qué política específica viola un contenido, una habilidad que se transfiere a políticas nuevas definidas por el usuario.
Anclar la seguridad en imágenes. Una imagen insegura no se sintetiza con un modelo de lenguaje como sí ocurre con el texto, así que los datos visuales de seguridad son escasos. Mistral complementa los conjuntos de moderación disponibles con conjuntos de imágenes de propósito general como negativos de calidad, muta las consultas para aumentar el conjunto y filtra cada par de imagen y consulta con un rerankeador de visión y lenguaje para reducir etiquetas equivocadas y alucinaciones.
Combinar puntos de control complementarios. El ajuste fino se hace con LoRA y después se fusionan, con SLERP, un punto de control calibrado sobre datos públicos, otro que aporta discriminación de políticas con grano fino desde datos generados, y el modelo base de instrucciones. La fusión recupera en un solo modelo la calibración común de políticas y la adaptabilidad, y el seguimiento de instrucciones del modelo base se transfiere a la tarea de moderación.
Todo el desarrollo se hizo sobre Forge, la plataforma propia de Mistral para entrenar, alinear y evaluar modelos a medida, que se encargó de la infraestructura, el particionado de datos y modelo, las métricas y el registro.