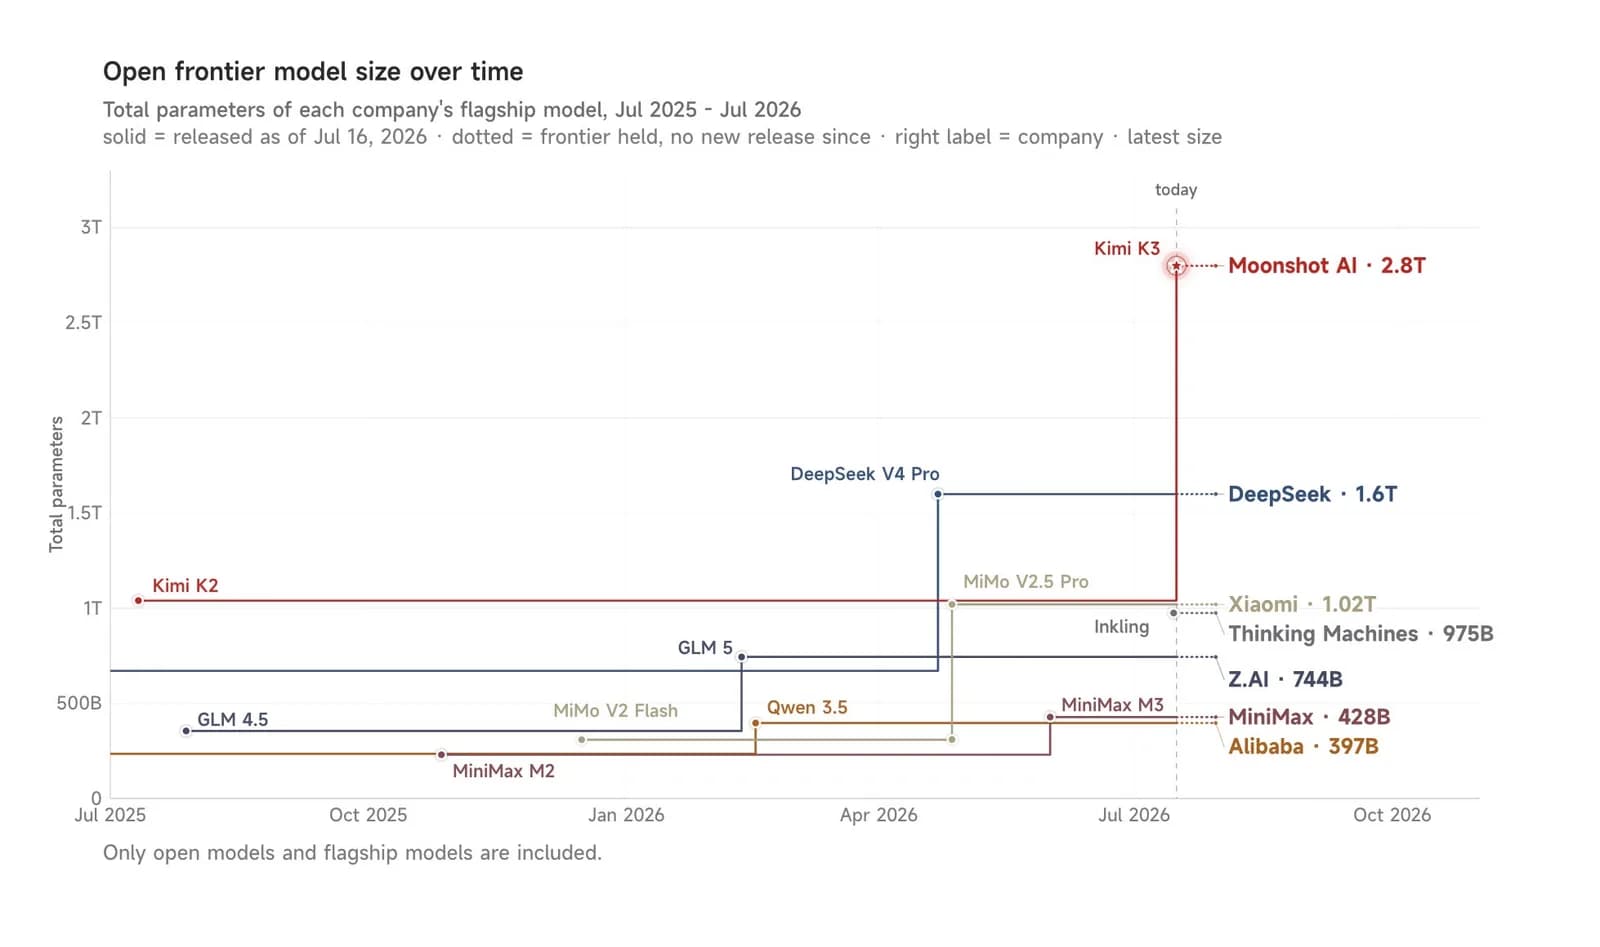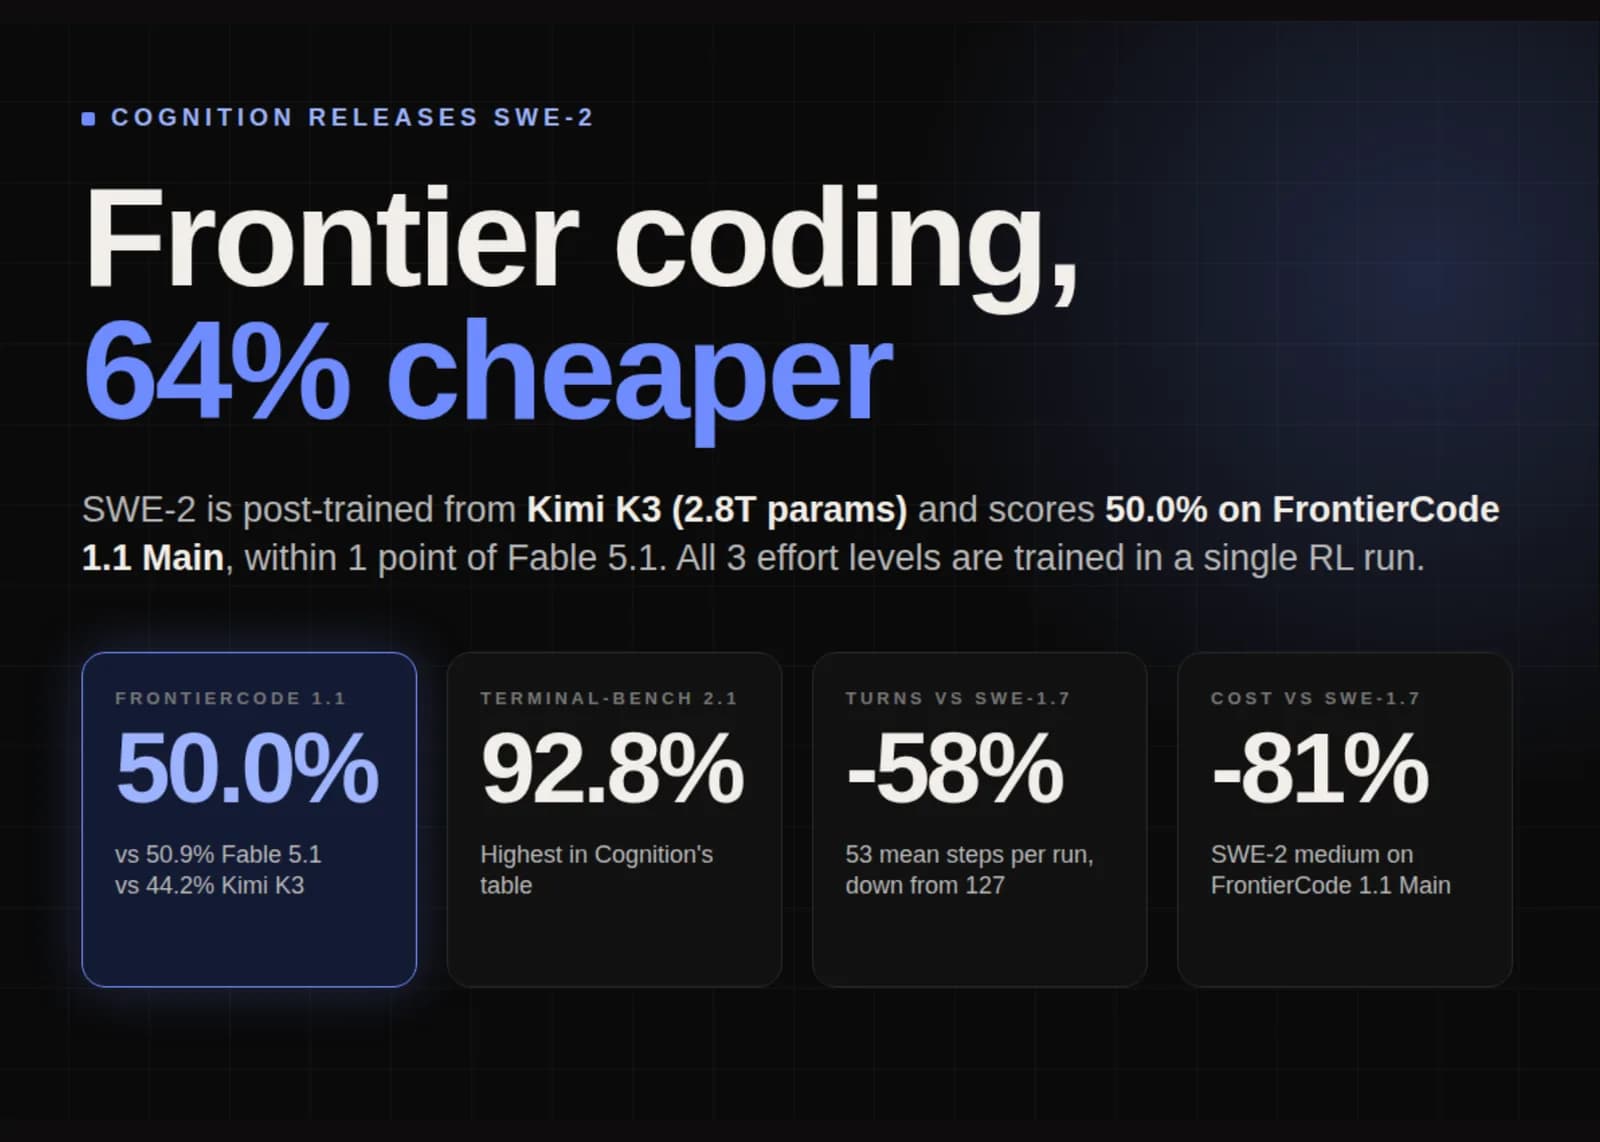
SWE-2 marca 50,0% en FrontierCode 1.1 Main, un punto por debajo de Fable 5.1 y con 64% menos de costo. Es el modelo de programación más capaz que liberó hasta ahora Cognition, la empresa detrás del agente Devin, y está post-entrenado con aprendizaje por refuerzo a partir de Kimi K3, el modelo abierto de 2,8 billones de parámetros de Moonshot AI. También es el primer modelo de la casa con niveles de esfuerzo de razonamiento seleccionables, los tres entrenados en una sola corrida de aprendizaje por refuerzo.
¿Se puede desplegar en infraestructura propia?
No. SWE-2 no tiene pesos abiertos ni API independiente. Corre únicamente dentro de Devin, hoy en Desktop y en CLI, con Devin Web y Fusion en despliegue progresivo.
Qué cambió respecto de SWE-1.7
SWE-2 se apoya en la infraestructura y la receta de SWE-1.7, que a su vez venía post-entrenado desde Kimi K2.7. Esta vez Cognition llevó el aprendizaje por refuerzo al régimen de varios billones de parámetros, con un modelo base que tiene casi el triple. La empresa sostiene que su etapa de refuerzo todavía encuentra margen por encima de K3 y suma entre 5 y 6 puntos en varios bancos de pruebas.
El cambio principal está en el algoritmo, que entrena los tres niveles de esfuerzo en una sola corrida. Cada nivel carga su propia penalización de costo, de manera que toda la frontera de costo y rendimiento se mueve junta.
Resultados en los bancos de pruebas
Cognition publicó su propia tabla de resultados. Donde existen cifras públicas usó esas, y en el resto corrió cada modelo en su arnés nativo con la mejor configuración disponible.
SWE-2 encabeza Terminal-Bench 2.1 y supera a su base K3 en todas las filas. Cognition dice que queda a pocos puntos de GPT-6 Astra por un cuarto del costo. El punto débil aparece en Terminal-Bench 4, donde SWE-2 queda unos 30 puntos por debajo de Fable 5.1 y de GPT-6 Astra. Conviene tener presente que FrontierCode es el banco de pruebas de la propia Cognition, y que las cifras de los modelos rivales salen de la evaluación que hizo Cognition.
Menos rodeos para llegar a la primera edición
SWE-1.7 tendía a explorar de más en tareas simples. SWE-2 corrige eso con lo que la empresa llama exploración enfocada. En FrontierCode 1.1 Main, SWE-2 en nivel medio puntúa más alto que SWE-1.7 con 58% menos de turnos y 81% menos de costo.
| Modelo y nivel | Pasos promedio por corrida |
|---|---|
| SWE-1.7 | 127 |
| SWE-2 medium | 53 |
| SWE-2 high | 80 |
| SWE-2 max | 98 |
La mediana para llegar a la primera edición real de código también baja. SWE-2 en nivel medio la hace tras 18 pasos, contra 48 de SWE-1.7.
El equipo de Cognition describe además tres patrones de conducta. Mejor cobertura de pruebas de extremo a extremo, capacidad de buscar alternativas cuando una herramienta queda bloqueada, y disciplina de verificación. Cuando alguien cuestiona una conclusión, el modelo la vuelve a derivar en lugar de repetirla.
Cómo lo entrenaron
Penalizaciones de costo informadas por la frontera de Pareto. La recompensa es R igual a S menos lambda por C, donde S es el éxito binario y C mezcla el costo de inferencia en dólares con el tiempo de la corrida. Cognition demuestra que solo una penalización lineal hace que el objetivo del aprendizaje por refuerzo dependa únicamente del costo promedio y de la tasa de resolución. El lambda de cada nivel de esfuerzo se fija en la pendiente local de la curva de Pareto del modelo base, así la línea de recompensa constante queda tangente a la frontera y la recompensa solo puede subir empujando esa frontera hacia arriba.
Línea base de recompensa ponderada por largo. Cognition comparte un truco que usa desde SWE-1.6. La magnitud del gradiente correlaciona fuerte con el largo de la corrida, así que la línea base del grupo se pondera por tokens, con la suma de R por L dividida por la suma de L. En las pruebas de ablación eso mantuvo más baja la divergencia KL entre inferencia y entrenamiento, y estabilizó el entrenamiento sin gastar cómputo extra.
Servicio de corridas y numéricos. Un retardador de prefill agrupa las peticiones cercanas y sube entre 10 y 20% los tokens por minuto de cada GPU y los tokens por segundo de cada petición. La decodificación especulativa DSpark acelera las corridas, con un modelo borrador reentrenado vía SpecForge para lograr largos de aceptación 15% mayores, que después se entrena en línea junto con la política. Los núcleos NVFP4 y FP8, con entrenamiento consciente de la cuantización, mantienen acotado el uso de memoria y dejan el desajuste entre entrenamiento e inferencia por debajo del de SWE-1.7.
Datos. Cognition triplicó sus entornos de aprendizaje por refuerzo, agregó capas de seguimiento de instrucciones y armó un circuito que usa puntos de control tempranos de SWE-2 para corregir falsos positivos y falsos negativos en los verificadores.
Pruebas de confiabilidad
Cognition volvió a correr dos evaluaciones de su estudio de confiabilidad de modelos abiertos. Sobre 145 preguntas políticamente sensibles acerca de China, SWE-2 aprobó el 98,0% en total, con 99,8% en inglés, 95,2% en chino simplificado y 99,1% en chino tradicional.
En una prueba de vulnerabilidad dependiente del contexto, que varía la forma en que se presenta el cliente, ningún encuadre produjo un cambio estadísticamente significativo en ninguno de los modelos evaluados.
SWE-2 queda gratis para los planes pagados hasta el 10 de octubre de 2026.