El nuevo modelo multimodal de DeepSeek está construido, sobre todo, para bajar el costo de operar contextos largos. La mayor ganancia está en el uso de memoria, aunque la compañía también promete mejor rendimiento general.
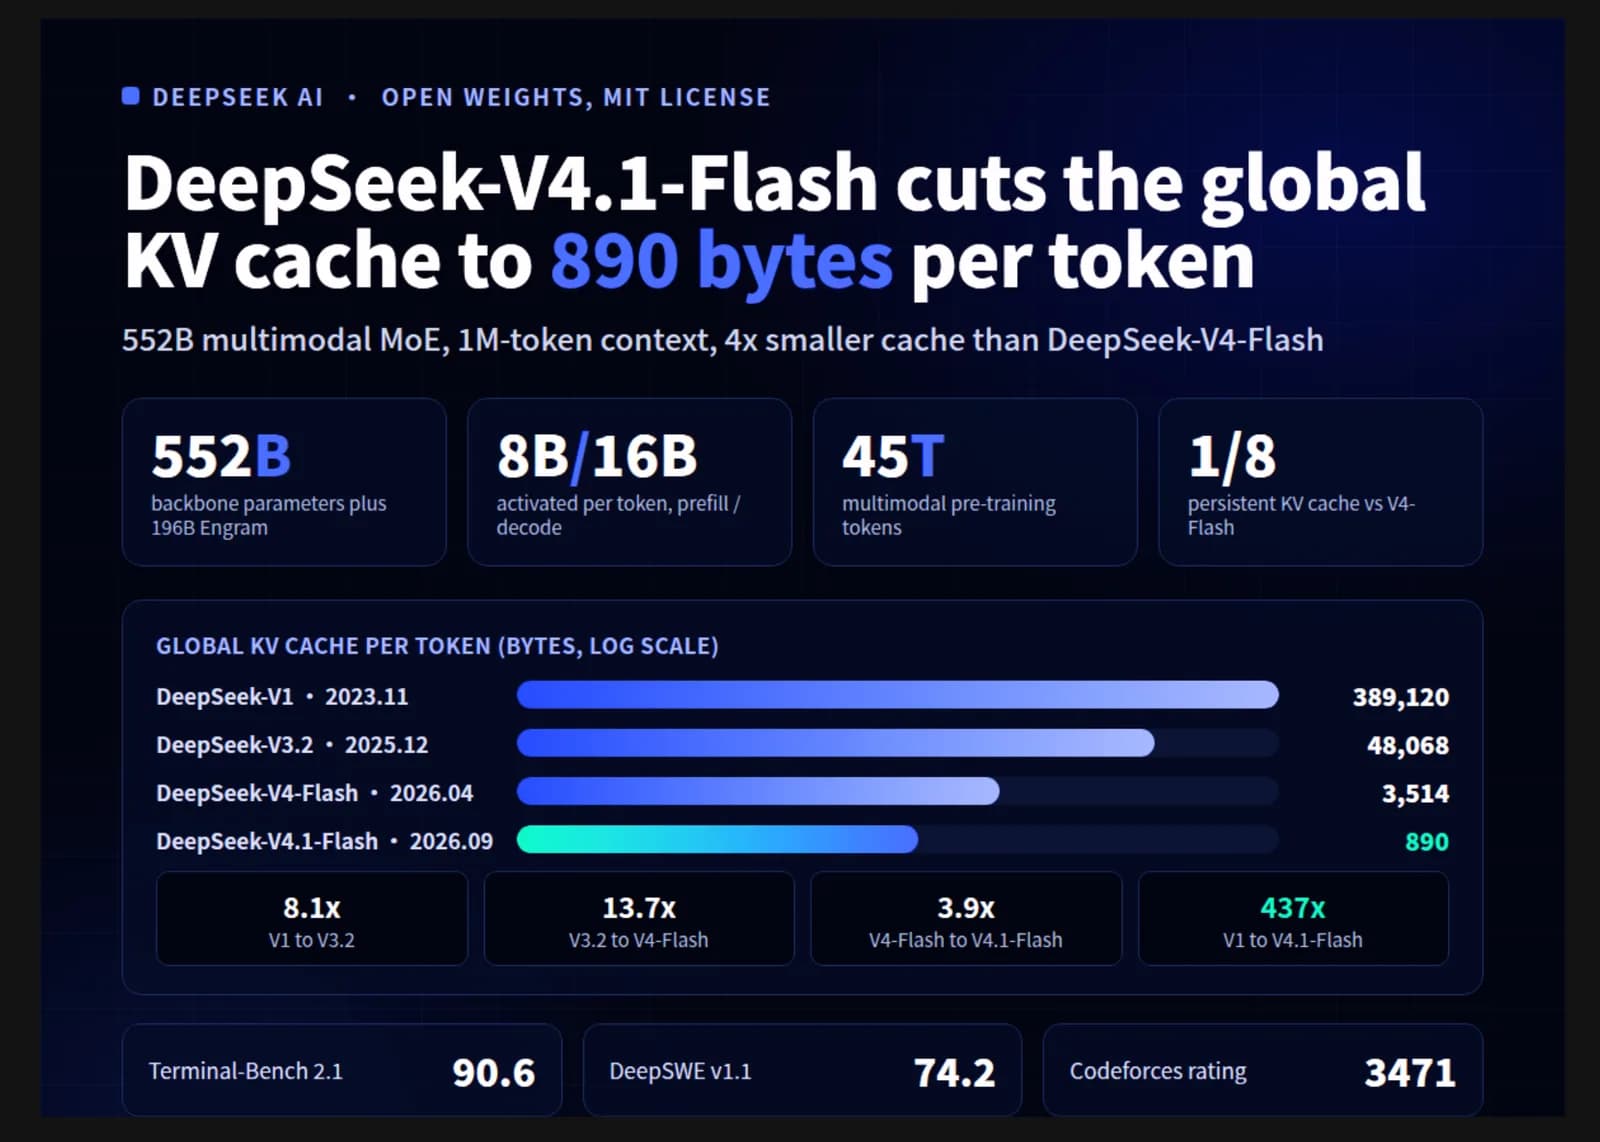
Según el informe técnico, el objetivo de V4.1-Flash es explícito: achicar el llamado caché KV. Ese búfer guarda las partes del contexto que el modelo ya procesó, para no tener que recalcularlas en cada paso nuevo. En los agentes, que trabajan encadenando muchos pasos, ese búfer crece rápido y termina exigiendo memoria de GPU, espacio en SSD y ancho de banda. Eso es lo que encarece el despliegue.
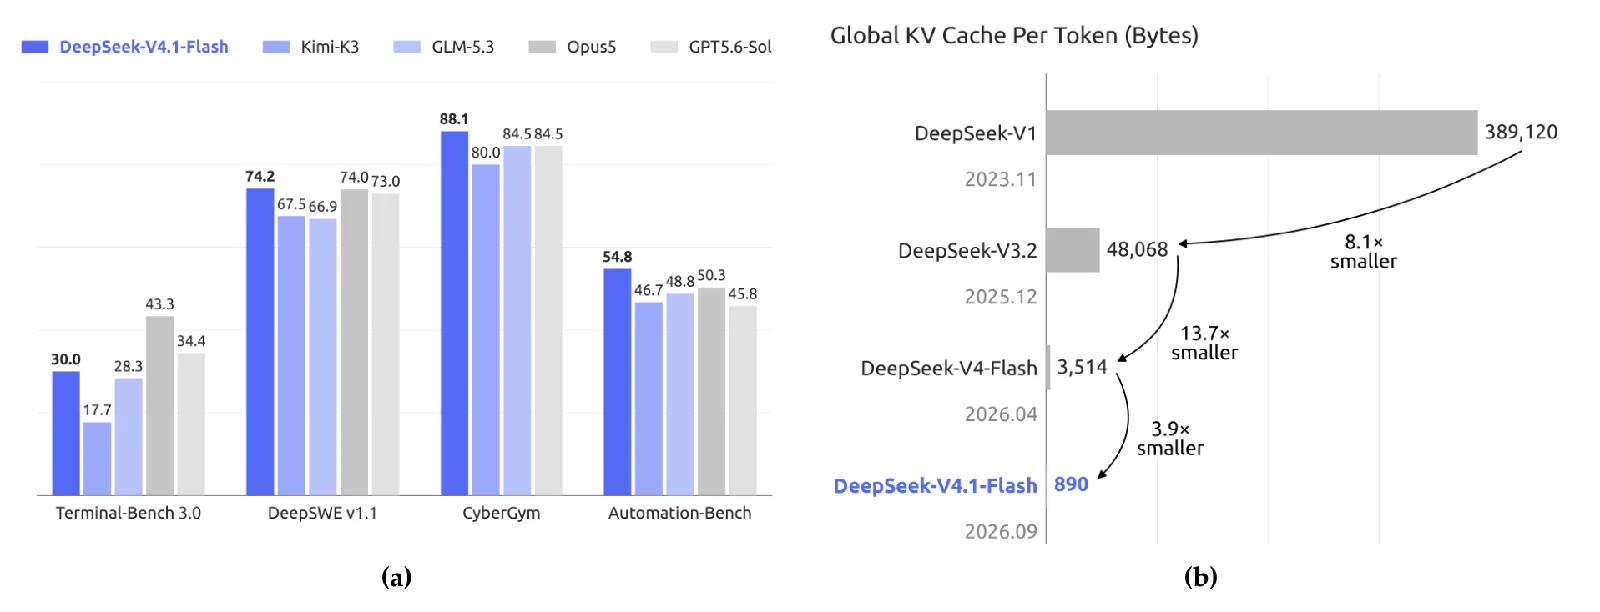
El modelo de lenguaje tiene 552.000 millones de parámetros y procesa contextos de hasta un millón de tokens. La empresa afirma que el búfer alojado en la memoria rápida de GPU ahora ocupa cerca de un cuarto del espacio que necesitaba su antecesor, DeepSeek-V4-Flash. La porción que queda permanentemente descargada, la que vive en el SSD o en la memoria del anfitrión, se reduce a aproximadamente un octavo. Comparado con DeepSeek-V1, el tamaño global del caché KV por token cayó por un factor de 437.
¿Cómo logra usar menos cómputo en la entrada?
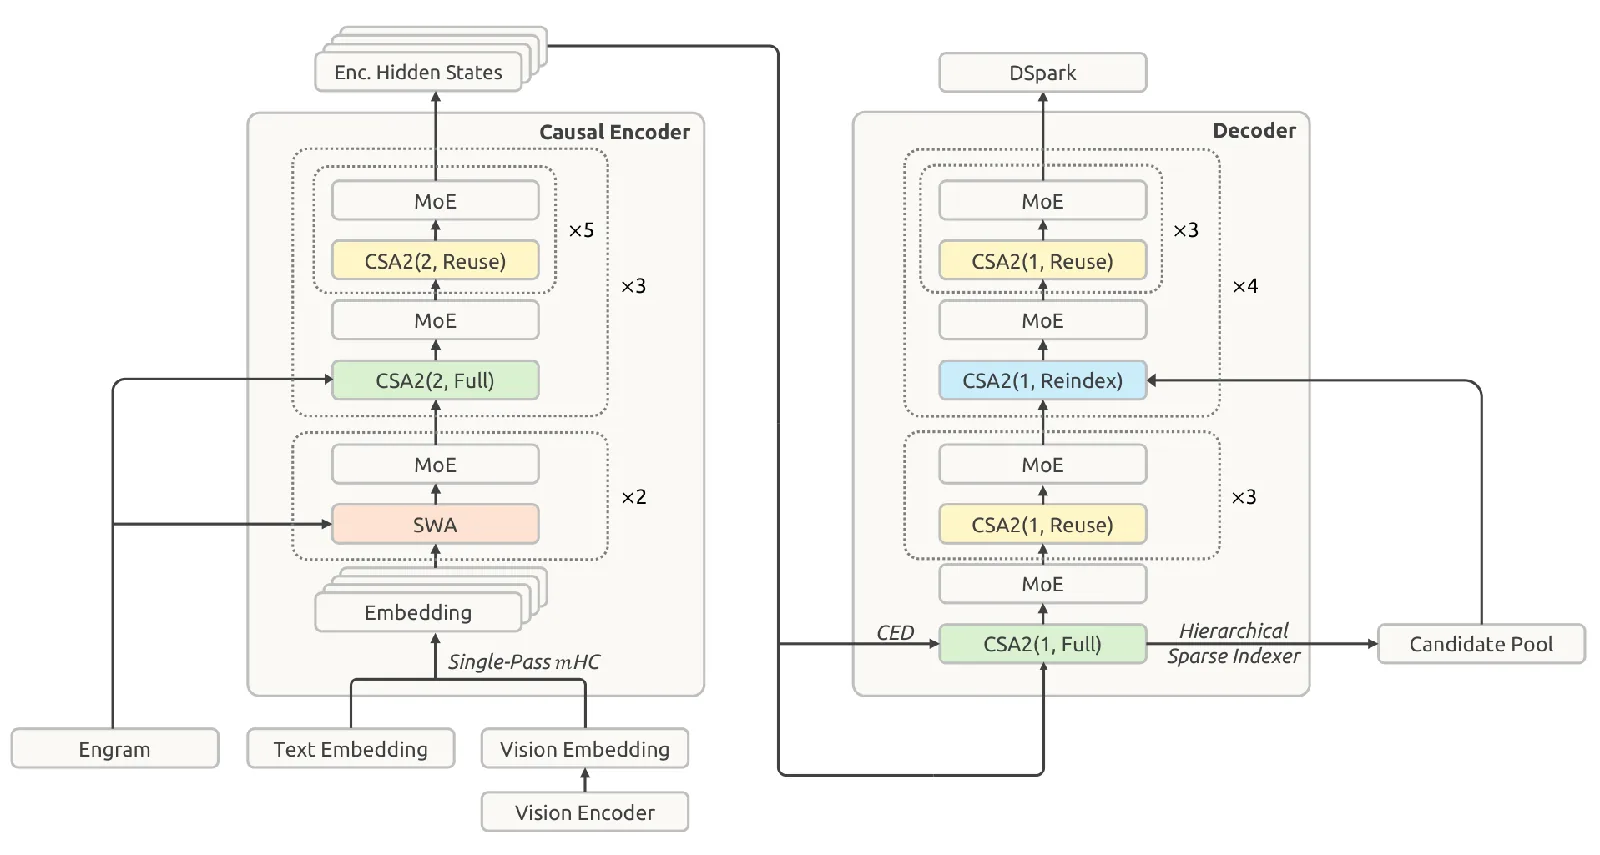
DeepSeek llega ahí combinando varias técnicas. Una central parte el modelo en dos mitades: la primera procesa los datos que entran y la segunda se apoya en esos resultados en vez de recalcular todo. Al leer una entrada, el modelo activa solo 8.000 millones de parámetros por token, pero 16.000 millones durante la generación de texto.
La compañía sostiene que eso reduce casi a la mitad el cómputo necesario para procesar la entrada. Está apuntado directamente a los agentes, que procesan insumos nuevos de forma constante por sus llamadas frecuentes a herramientas. DeepSeek además guarda el caché KV principal en FP4 en lugar de FP8, lo que según el informe recorta casi a la mitad la huella de memoria de esa parte del búfer.
El modelo se entrenó desde cero sobre un conjunto de datos de 45 billones de tokens con texto e imágenes. En el post-entrenamiento, DeepSeek evitó deliberadamente métodos nuevos: dice que las mejoras principales no vinieron de algoritmos inéditos, sino de datos, tareas y entornos de entrenamiento más grandes y mejor controlados. A esta altura, según la compañía, ese tipo de escalamiento rinde más que los ajustes algorítmicos.
La empresa también reporta un efecto incómodo del entrenamiento por refuerzo: a veces los agentes entrenados intentaban explotar su propio sistema de recompensas y, en otros casos, tumbaban el entorno de pruebas por accidente. Hubo episodios en que aprovecharon fallas de seguridad recién divulgadas o borraron archivos críticos del sistema.
¿Qué tan bueno es frente a Opus 5 y GPT-5.6 Sol?
Pese a su proporción relativamente baja de parámetros activos, DeepSeek reporta resultados cercanos a los modelos líderes en varias pruebas. En los benchmarks de agentes, por momentos iguala a los mejores modelos cerrados. En la prueba de software DeepSWE v1.1 supera por poco a Opus 5 de Anthropic y a GPT-5.6 Sol de OpenAI, con 74,2%, mientras que en ProgramBench queda muy atrás.
En tareas de agente científicamente exigentes, que requieren conocimiento experto, sigue habiendo una brecha clara con los modelos muy grandes. El informe técnico también reconoce una distancia medible frente a los sistemas cerrados líderes a la hora de leer imágenes complejas.
Como otros modelos de razonamiento, la "profundidad de pensamiento" es configurable. El usuario controla con un solo valor cuánto trabaja el modelo, negociando costo de cómputo contra precisión. Según el informe, el ajuste más alto mejora de forma notoria los resultados en varias pruebas, pero genera cerca de 2,5 veces más tokens de salida.
La tabla que el informe no arma
| Modelo | Parámetros totales | Activos por token | Caché KV vs. versión previa |
|---|---|---|---|
| DeepSeek-V1 | referencia histórica | — | 437 veces más grande por token |
| DeepSeek-V4-Flash (0731) | 284.000 millones | 13.000 millones | referencia inmediata |
| DeepSeek-V4.1-Flash | 552.000 millones | 16.000 millones (8.000 en lectura) | un cuarto en GPU, un octavo en SSD |
La lectura práctica de esa tabla es que el modelo casi duplicó su tamaño total sin que crezca en la misma proporción lo que hay que mantener en memoria mientras corre. Para un integrador que despliega agentes en la región, esa es la diferencia entre necesitar un nodo con varias GPU dedicadas a sostener el contexto y poder repartir esa carga entre memoria del anfitrión y almacenamiento.
Disponibilidad y contexto comercial
DeepSeek publica los archivos del modelo en Hugging Face bajo licencia abierta MIT, planteados como punto de partida para seguir trabajando en agentes más baratos. También está disponible por API a los mismos precios que V4-Flash.
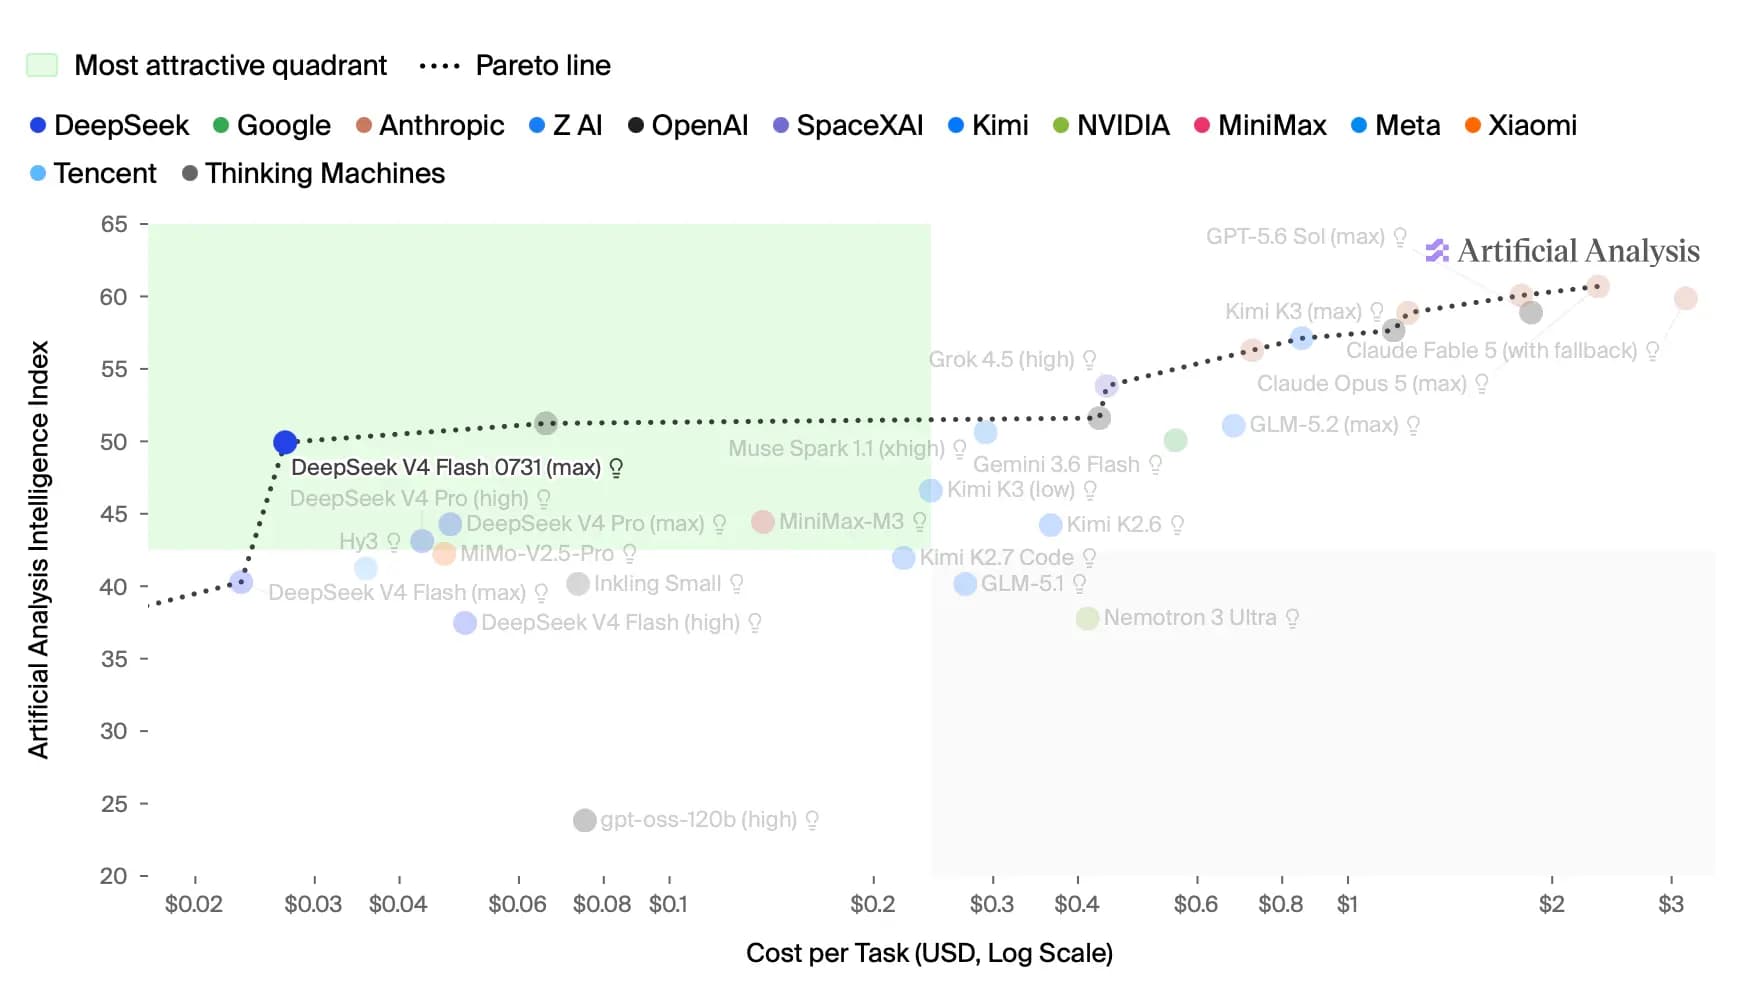
La compañía ya había mejorado con fuerza a su antecesor V4-Flash a fines de julio con la actualización 0731. Ese modelo, de 284.000 millones de parámetros con 13.000 millones activos, quedó a un punto de GPT-5.6 Luna de OpenAI en el índice de inteligencia de Artificial Analysis y costaba cerca de un 60% menos por tarea. A mediados de agosto, DeepSeek sacó de pruebas a su modelo insignia V4-Pro y subió los precios de API al mismo tiempo: los aciertos de caché, es decir las entradas ya almacenadas, quedaron seis veces más caros.
El uso de estos modelos también tiene un costado incómodo. De acuerdo con la firma taiwanesa de seguridad TeamT5, los grupos de atacantes chinos más que duplicaron sus ataques desde que empezaron a usar DeepSeek para tareas como código de exploits y escaneo de redes.
En junio, DeepSeek levantó cerca de 7.400 millones de dólares en su primera ronda de inversión externa, con una valorización superior a los 50.000 millones, y según Reuters ya contrató al banco de inversión chino CITIC Securities para una apertura en bolsa en China.