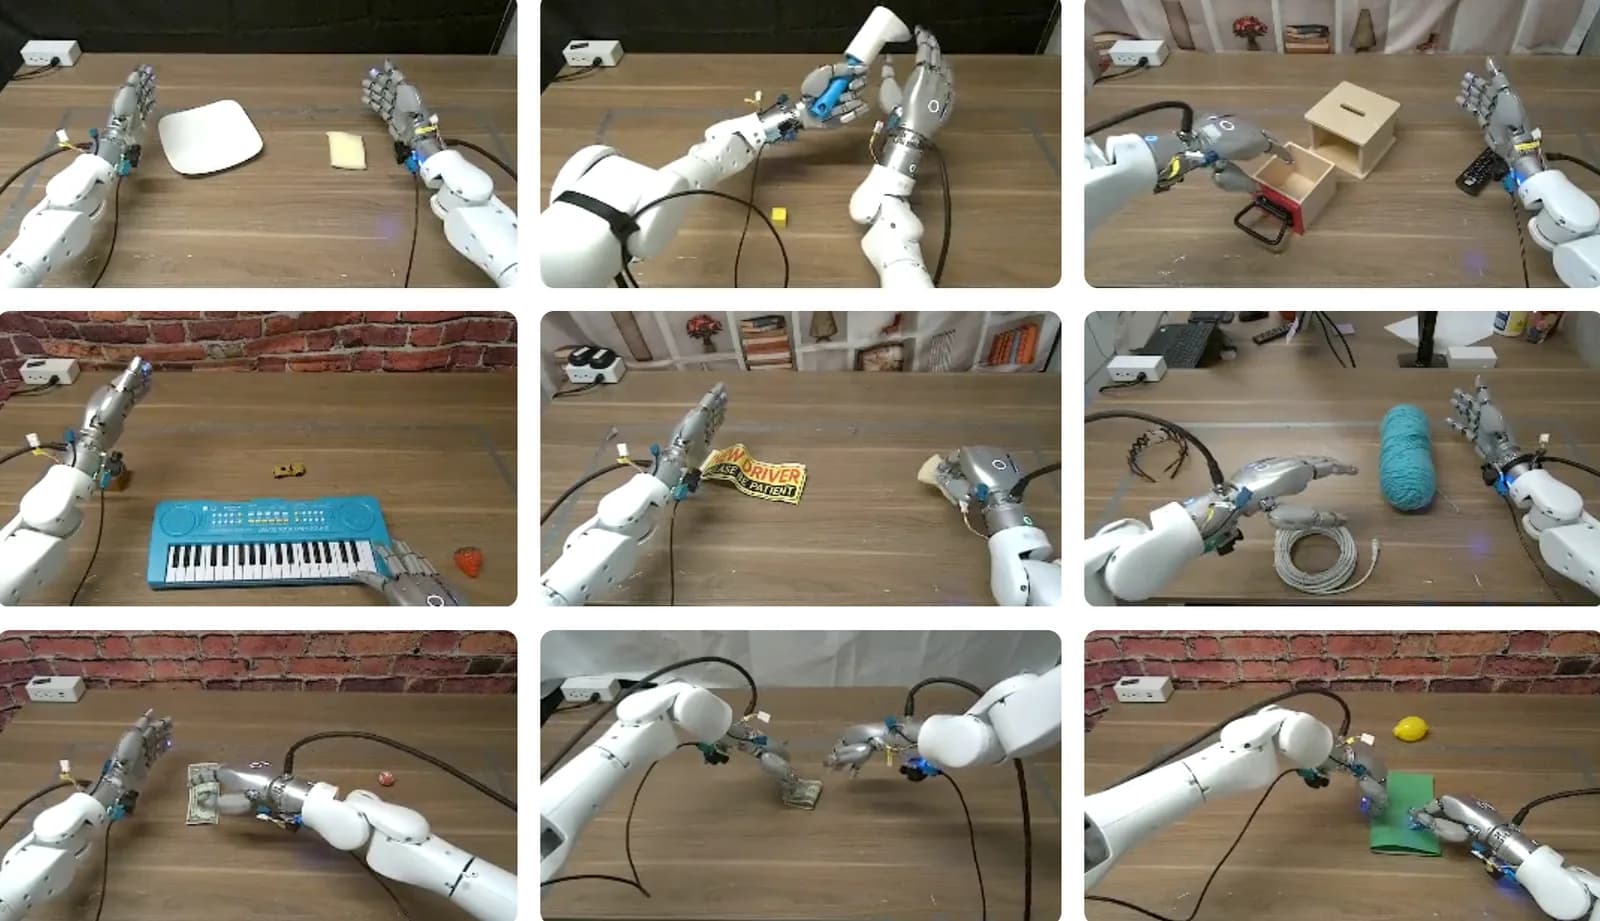
La manipulación diestra sigue siendo una de las barreras más grandes que impiden que los robots resuelvan tareas cotidianas. El sentido del tacto podría ser la clave, pero la falta de datos de calidad frenó el avance durante años. Eso recién está empezando a cambiar: laboratorios académicos y startups compiten por construir nuevas bases de datos táctiles y por encontrar la forma de aprovecharlas.
En los últimos años, los modelos visión-lenguaje-acción (VLA) mejoraron de manera significativa la capacidad de los robots para ejecutar tareas complejas con objetos y entornos que nunca habían visto. Preentrenados sobre volúmenes enormes de imágenes, video y texto, y luego ajustados con un número menor de demostraciones teleoperadas, estos modelos guían al robot en trabajos como doblar ropa, ordenar una sala o incluso operar electrodomésticos de cocina, usando solo una cámara y una instrucción en lenguaje natural.
Pero los robots siguen fallando en tareas que exigen control fino de la mano, como manipular materiales deformables u objetos chicos. Enchufar un cable USB o girar una llave en una cerradura son ejemplos concretos. Eso ocurre, en parte, porque los VLA ignoran una de las fuentes de información principales que usan las personas en esas situaciones: la retroalimentación táctil.
¿Por qué el tacto es tan difícil de incorporar?
"La mayor parte de la manipulación diestra la pueden hacer las personas con los ojos cerrados", dice Trevor Darrell, profesor de ciencias de la computación en la Universidad de California, Berkeley. "Entender la fuerza, el deslizamiento y el agarre preciso no es algo que se logre bien con sensores de visión tradicionales".
El problema es que aprovechar los sensores táctiles resulta complicado. Los datos táctiles tienen características muy distintas a las de las imágenes con las que se entrenan normalmente los VLA, y los conjuntos disponibles quedan muy por debajo de la escala de internet que sí tienen los datos de visión y de lenguaje.
Para sortear ese obstáculo, el equipo de Darrell ideó un esquema en dos tiempos: primero preentrenar un modelo sobre conjuntos ya existentes y después darle sentido del tacto entrenando un submodelo especialista con 100 horas de datos táctiles de alta calidad recolectados especialmente, con demostraciones de acciones comunes como limpiar, agarrar, girar o verter, usando más de 200 objetos domésticos distintos.
Poner esos datos a trabajar no fue directo. La meta era que el robot pudiera usar la señal táctil para corregir el agarre en tiempo real mientras manipula un objeto, y eso exige tiempos de reacción más rápidos que los de la mayoría de los modelos de visión y lenguaje. Ese desajuste es un desafío importante, según Darrell, así que el equipo usó submodelos separados, llamados "expertos", para manejar por un lado las acciones de alto nivel y por otro el control táctil de bajo nivel, a una velocidad que hace útil la retroalimentación.
El experto de acción produce los planes de movimiento, mientras que el experto táctil, que opera cuatro veces más rápido, ajusta ese plan en tiempo real según lo que el robot va sintiendo. El modelo se afinó después con unas 100 demostraciones teleoperadas de tareas relativamente complejas, como enroscar una ampolleta, poner pasta de dientes en un cepillo o trasladar un huevo entre bandejas. Ahí promedió una tasa de éxito de 65% en 12 tareas, casi el doble que el mejor modelo VLA disponible.
¿Cómo se comparan los distintos enfoques?
| Equipo | Volumen de datos táctiles | Resultado reportado |
|---|---|---|
| Berkeley (T-Rex) | 100 horas, 200+ objetos | 65% de éxito en 12 tareas, casi el doble del mejor VLA |
| Tsinghua (Chengbo Yuan) | 3.000+ horas agregadas, 21 tipos de sensor | Supera al modelo base incluso en hardware no visto |
| Fudan y NeoteAI | 30.000+ horas con visión sincronizada | Mejoras significativas al predecir el tacto esperado |
| USC | 2.700+ demostraciones | Infiere tacto desde imágenes, sin sensor físico |
| Academia China de Ciencias | (modelo, no dataset) | 62,8% de éxito contra 28,2% sin tacto, en cinco tareas |
La diversidad de sensores es el cuello de botella
Una limitación que el propio Darrell admite es que sus datos provienen de una sola configuración de hardware robótico. Las manos robóticas van desde diseños articulados de cinco dedos hasta pinzas simples, y los sensores táctiles pueden apoyarse en principios físicos completamente distintos, desde medir cambios de resistencia hasta registrar imágenes de una almohadilla de gel blando deformándose.
Eso hace que casi toda la investigación de IA táctil quede atada a un sensor específico, según Chengbo Yuan, estudiante de magíster en la Universidad de Tsinghua en Beijing, y dificulta compartir datos o transferir aprendizajes entre grupos.
Yuan abordó ese problema agregando más de 3.000 horas de datos táctiles robóticos desde conjuntos de acceso público, que cubren 21 tipos de sensor y una variedad de cuerpos robóticos. El equipo se inspiró en iniciativas como la colaboración Open X-Embodiment, que juntó datos de muchos robots y derivó en modelos capaces de generalizar a hardware ausente en el entrenamiento.
El grupo de Yuan diseñó entonces un modelo agnóstico al hardware, que entrena sobre esa diversidad convirtiendo la salida de cada sensor a un formato compartido y mapeándola sobre posiciones etiquetadas en una plantilla de mano humana. El resultado superó con claridad al modelo base, incluso en hardware que nunca había visto. Yuan lo atribuye a que adquiere "una especie de sentido común táctil" al entrenar sobre configuraciones tan variadas.
¿Cuántos datos hacen falta para el salto?
Pese a los resultados, Yuan cree que todavía falta volumen y su grupo ahora encabeza una colaboración de 80 instituciones para reunir un conjunto mayor de demostraciones teleoperadas con un método estandarizado de recolección y procesamiento.
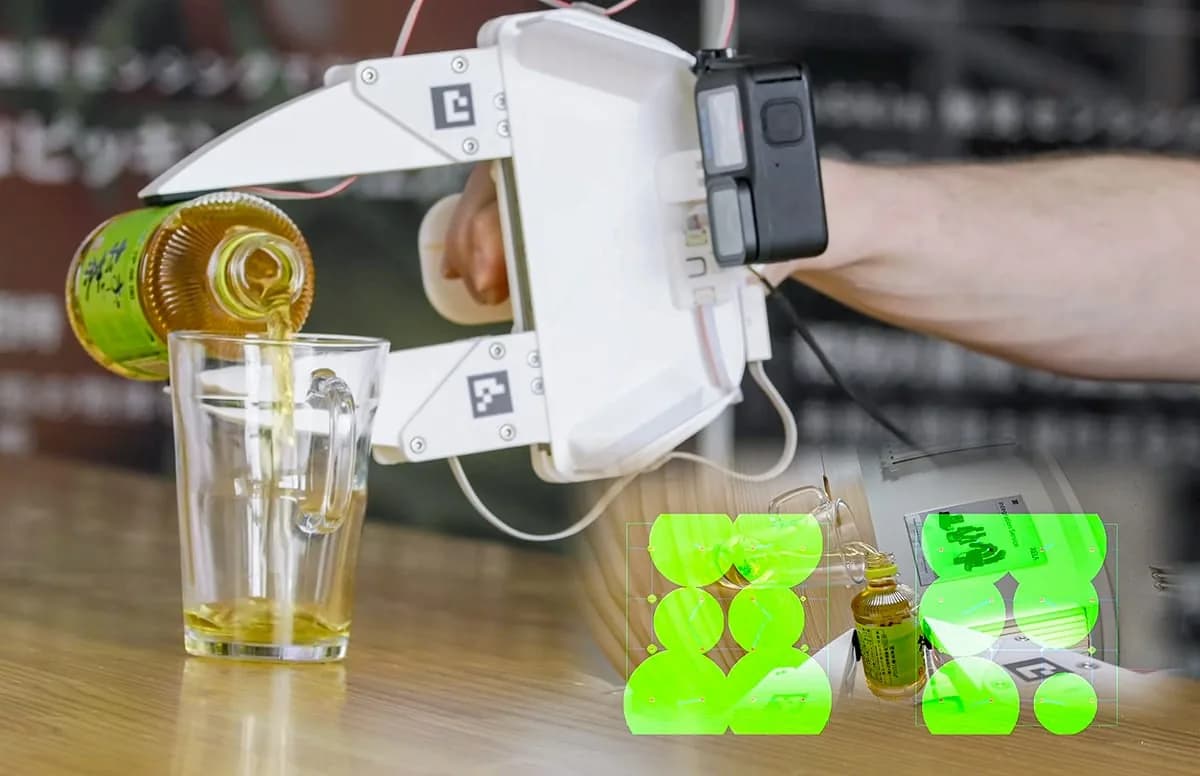
Mientras tanto, la Universidad de Fudan en Shanghái y su spin-off NeoteAI ya produjeron un conjunto táctil un orden de magnitud más grande que los anteriores. Con un sensor propietario montado sobre distintos brazos robóticos y una pinza de mano operada por personas, reunieron más de 30.000 horas de demostraciones con datos visuales y táctiles sincronizados.
Con ese material entrenaron un modelo que no solo reacciona al tacto, sino que además predice de forma proactiva qué debería estar sintiendo el robot, lo que ayuda a guiar y evaluar las acciones. Shunlin Lu, investigador postdoctoral en Fudan y CTO de NeoteAI, sostiene que los resultados son evidencia clara de que el acceso a datos táctiles diversos y a gran escala se traduce en ganancias importantes de rendimiento.
Otra vía para escalar es aprovechar las enormes cantidades de datos visuales de robótica ya recolectados. Investigadores de la Universidad del Sur de California, en Los Ángeles, liberaron hace poco un modelo que aprendió a inferir información táctil desde datos visuales, entrenándolo con más de 2.700 demostraciones de manipulación cotidiana usando una pinza de mano que registra tacto e imágenes al mismo tiempo.
El modelo aprendió las asociaciones entre las imágenes de la pinza entrando en contacto con un objeto y la presión registrada por los sensores en ese instante, lo que le entrega incluso a robots sin sensores táctiles un sentido rudimentario del tacto, particularmente útil en tareas de contacto intenso. La ambición mayor del grupo es usar ese generador para agregar datos táctiles a conjuntos visuales ya existentes.
Datos no es lo mismo que criterio
Cuántos datos táctiles se necesitan para un salto real en destreza sigue sin estar claro. Hasta ahora, según Yuan, el aporte principal del entrenamiento táctil fue hacer que los robots aprendan de manera más eficiente tareas que ya estaban a su alcance, como tomar y depositar objetos. Sospecha que van a hacer falta algoritmos nuevos para atacar problemas genuinamente imposibles sin tacto.
Long Cheng, de la Academia China de Ciencias, también piensa que los datos crudos no son una panacea. "Los datos son buenos", dice. "Pero cómo usarlos correctamente es otro asunto".
El punto que anota Cheng es que la visión entrega un flujo continuo y de alto ancho de banda de píxeles, mientras que las señales táctiles son escasas e intermitentes, así que los modelos aprenden a ignorarlas. Su solución, que se presenta en IROS 2026 este mes, es un modelo que predice qué va a sentir el robot usando solo la visión y después lo compara contra la entrada táctil real. Una brecha grande entre ambas significa que el sensor está detectando algo que el robot se perdería, de modo que esas señales sorprendentes se amplifican y las predecibles se atenúan. En cinco tareas de contacto intenso el enfoque promedió 62,8% de éxito frente a 28,2% del mismo modelo sin tacto.
Lu es más optimista respecto a que el escalamiento de datos rinda beneficios similares a los vistos en lenguaje y visión. Estima que algo cercano a 100.000 horas, recolectadas en entornos reales y variados en vez de laboratorio, podría desbloquear capacidades nuevas.
Qué significa esto para un taller en Chile
La barrera de entrada al tacto robótico es más baja de lo que parece. Un sensor de fuerza resistivo o una celda de carga conectada a un ESP32 ya permite experimentar con detección de deslizamiento en una pinza impresa en 3D, y las pinzas con sensores de gel blando derivan de diseños abiertos publicados por laboratorios universitarios. Para un integrador local que automatiza líneas de empaque de fruta, el dato relevante no es el modelo de 30.000 horas, sino que el aporte medible del tacto aparece justamente en las tareas donde la visión falla: productos deformables, piezas chicas y superficies que resbalan.
De todas formas, el campo ya muestra señales tempranas de que conjuntos táctiles más grandes, y formas más inteligentes de usarlos, pueden darles a los robots un empujón considerable en las tareas más difíciles. "Creo que la inteligencia táctil es en realidad el próximo paso de la IA física", dice Lu.