DiscoBench: los agentes IA fallan al preguntar, no al buscar
Un benchmark de Tencent Hunyuan y Tsinghua muestra que Gemini 3.1 Pro y Claude Opus 4.7 quedan bajo 50% porque asumen en vez de pedir aclaraciones cuando la consulta es ambigua.
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.

Un benchmark de Tencent Hunyuan y Tsinghua muestra que Gemini 3.1 Pro y Claude Opus 4.7 quedan bajo 50% porque asumen en vez de pedir aclaraciones cuando la consulta es ambigua.

El fundador francés advierte que confiar en modelos propietarios abre la puerta a que los proveedores de IA compitan luego contra sus propios clientes con la data que acumulan.

La nueva app en beta integra más de 60 skills para genómica, proteómica y química, corre en el HPC del laboratorio y deja auditables cada figura y cada cálculo.

Anthropic estrena su Sonnet más autónomo con planificación, uso de navegador y terminal, desempeño cercano a Opus 4.8 y precio introductorio hasta el 31 de agosto de 2026.

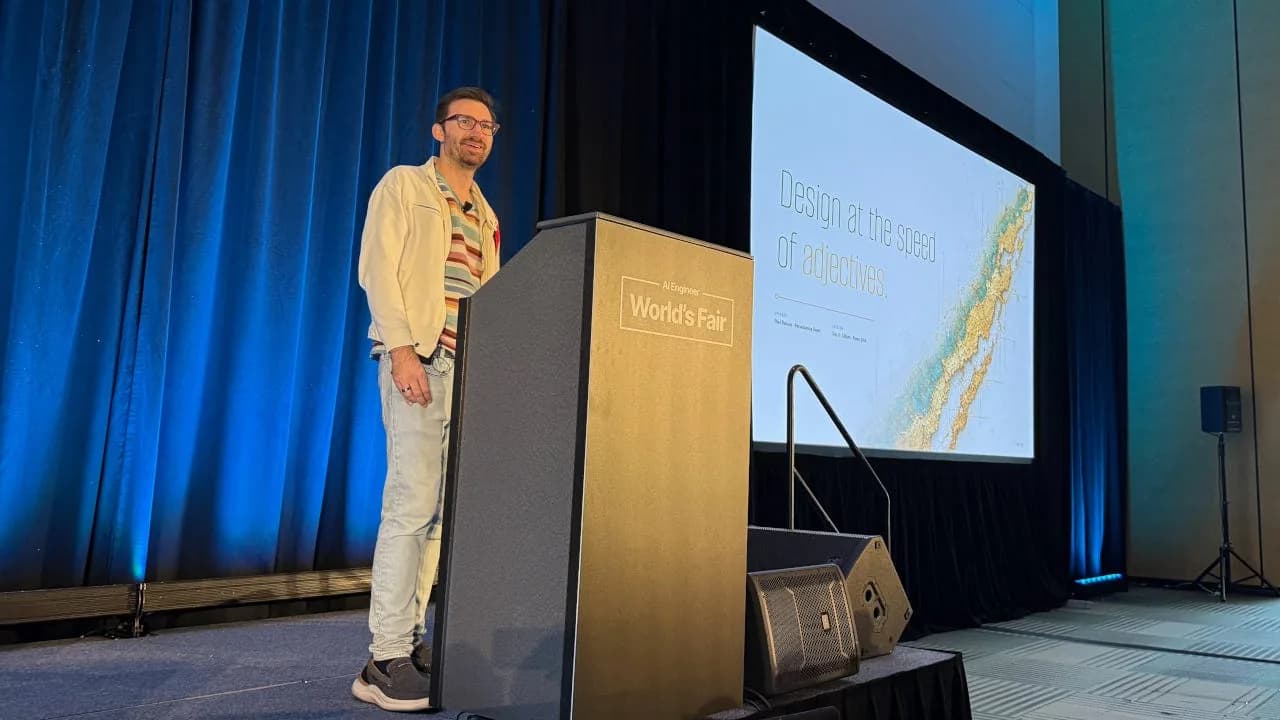
Paul Bakaus, creador de *Impeccable*, defiende un modelo donde el agente entrega el 80% y el humano custodia el 20% final. Sin auto mode. Nunca.

El creador de Datasette relata cómo el modelo de Anthropic encontró cinco *release blockers* en 37 prompts, incluyendo un bug que borraba tablas enteras al cerrar la base.

Pauline Brunet, VP de Forward Deployed Engineering, explica cómo su equipo despliega agentes de ciclo largo dentro de bancos, telcos y fabricantes de chips para transformar el ciclo de desarrollo.

El grupo chino clasifica la herramienta de programación de Anthropic como software de alto riesgo tras un experimento marzo que identificaba usuarios chinos, según Reuters y Morningstar.

La compañía apuesta a acortar el desarrollo de medicamentos de doce a siete u ocho años y duplicar la tasa de éxito, mientras Google DeepMind y OpenAI también corren por el mismo mercado.

El proxy open source aprovecha que Anthropic cobra imágenes por dimensiones, no por caracteres, y comprime prompts largos en una sola página densa.

El modelo open-source (Apache 2.0) para verificación formal en Lean 4 lidera PutnamBench entre pesos abiertos y detectó overflows reales en 57 repositorios.

El Chief of Software de Vercel explica cómo nació eve, su framework de agentes, por qué las skills reemplazan la información desactualizada del modelo y qué gana una web que sirve markdown a los bots.

Un estudio panel de 30 meses documenta cómo el uso de asistentes IA acelera la tarea pero desploma los puntajes en exámenes cerrados; el daño en la prueba de acceso tarda dos años en aflorar.

Un desarrollador de Anthropic detalla técnicas para descubrir tus puntos ciegos antes de escribir el prompt, con ejemplos que van desde diseño visual hasta edición de video.

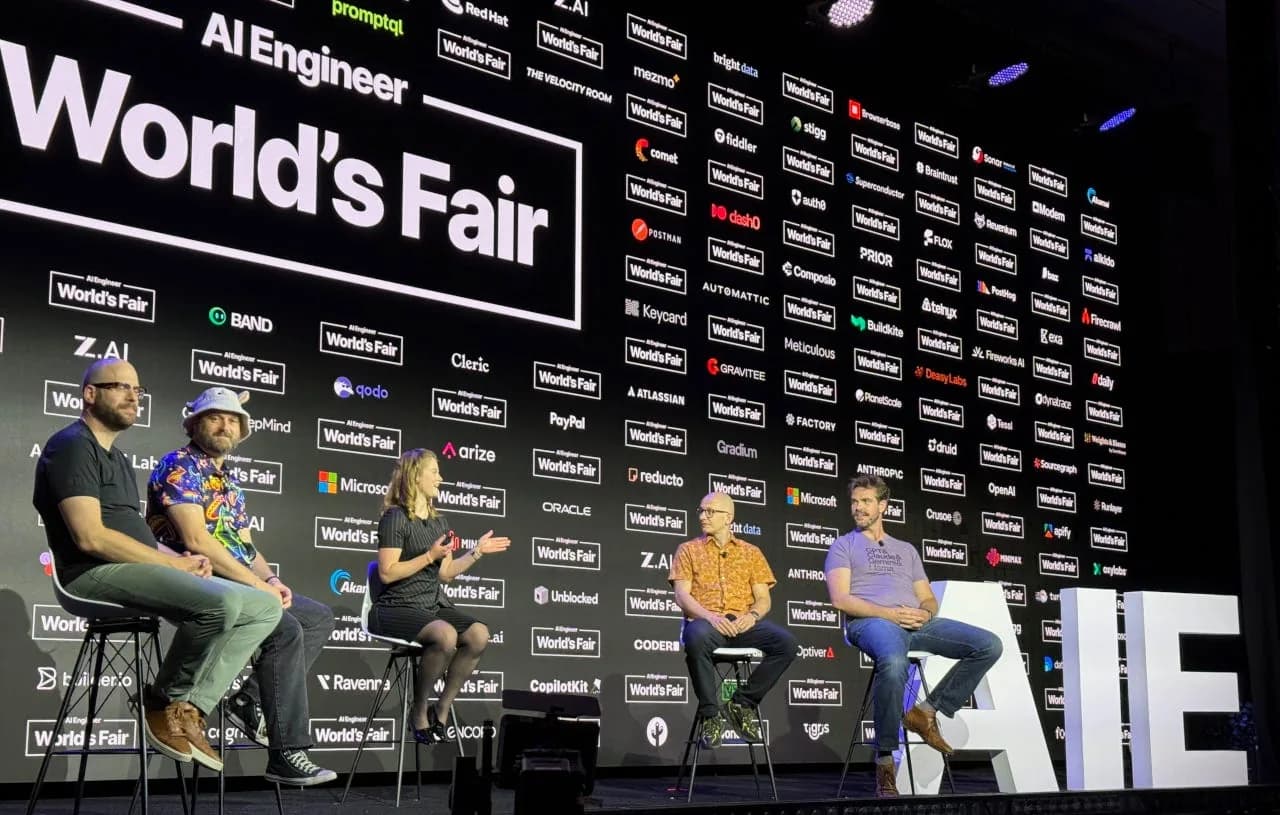
El AI Engineer World's Fair cerró con Ralph Loop y HumanLayer discutiendo si las software factories son viables, una encuesta con 95% de adopción de agentes y la presentación pública de Claude Tag.

El resumen mensual de la compañía condensa un modelo abierto para laptops con 16 GB de RAM, ventanas flotantes en Android 17 y el estreno del Nano Banana 2 Lite en la API.

El líder del pretraining de Llama 3 dejó Meta por descubrimiento de fármacos: el modelo de difusión de Genesis Molecular acierta el encaje inducido de un target nunca visto antes.

IEEE Spectrum desarma la aritmética detrás de constelaciones de un millón de satélites: 25 años solo para fabricarlos, radiadores gigantes por chip y Kessler al fondo.

El benchmark de Scale Labs y el Center for AI Safety mide agentes en 240 proyectos reales por USD 144.000: la tasa top se cuadruplicó en ocho meses.

Zuckerberg dijo en un town hall interno que el desarrollo agente no aceleró como esperaba. Su jefe de IA, Alexandr Wang, respondió con el nombre en código del próximo modelo: Watermelon.

La compañía filmó por primera vez la versión de producción biplaza rodando por Austin, con un safety monitor en el asiento del acompañante y un vacío regulatorio a punto de cerrarse a su favor.

El EVP Jacob Andreou escribió en un memo filtrado a The Information que Microsoft fusiona las apps de consumo y empresa, y suma agentes que hacen agenda y resumen de mail por costo adicional.

Por qué los nombres que fallan en CI no coinciden con los del código fuente, cómo funciona instantiate_device_type_tests() y cuál es la ruta oficial para reproducir un fallo en local sin adivinar.

El AI Security Institute demostró que aumentar 10× el presupuesto de tokens sube el desempeño hasta 25 puntos en tareas de ingeniería de software y modifica la curva real de progreso del frontier.