
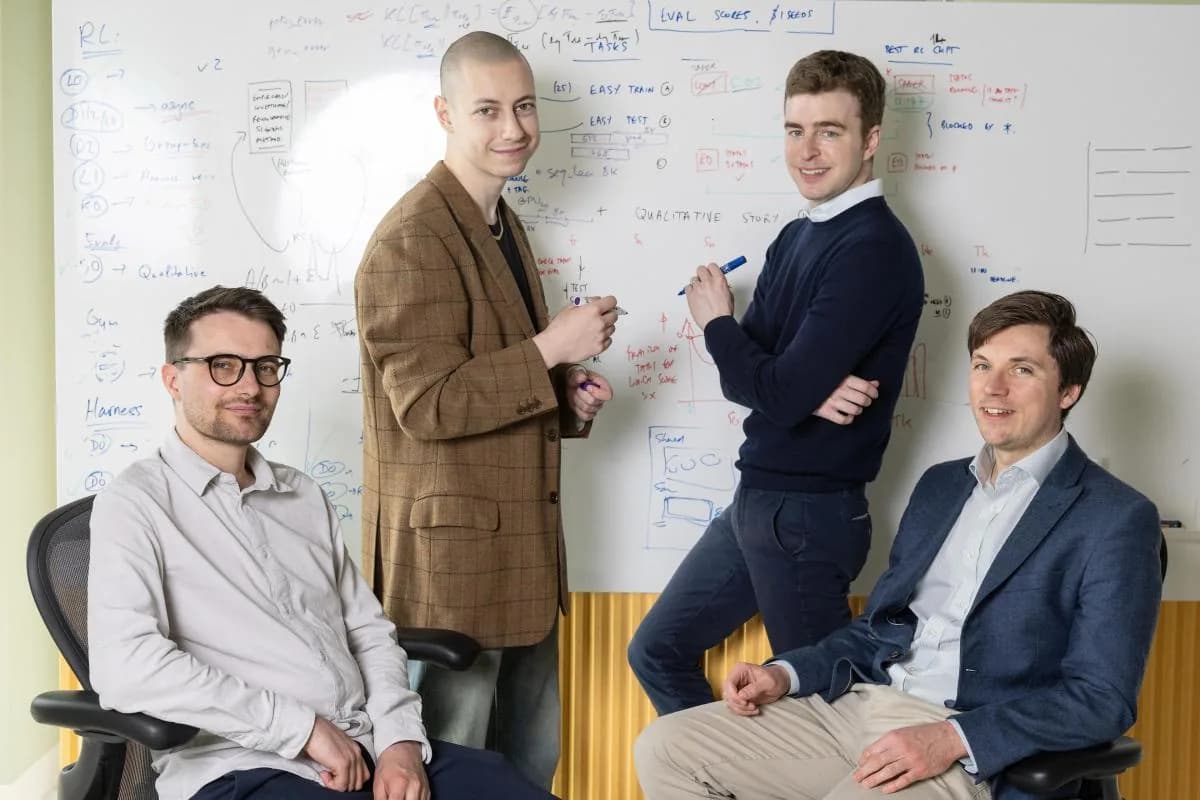
Faraday reproduce estudios con 27 mil millones de parámetros
El laboratorio londinense Inherent, fundado por exintegrantes de Google DeepMind, dice que su agente superó a Claude Opus 4.8 y a GPT-5.5 replicando artículos científicos.
TechCrunch AI
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
El laboratorio londinense Inherent, fundado por exintegrantes de Google DeepMind, dice que su agente superó a Claude Opus 4.8 y a GPT-5.5 replicando artículos científicos.
Un nuevo marco llamado Mental World Modeling agrega creencias, intenciones y normas sociales al estado del mundo, y con eso un modelo débil supera a uno más potente que solo simula física.
Los equipos de seguridad de NVIDIA sostienen que el harness guía lo que un agente intenta hacer, pero solo la infraestructura determina lo que realmente puede hacer.
La arquitectura de NVIDIA resolvió los 183 niveles de la prueba pública con 12% menos acciones que VISTA, y llevó a un modelo que por sí solo rendía 30% hasta el puntaje perfecto.
La científica del Instituto Santa Fe propone estudiar los modelos con los métodos que la psicología aplica a otras inteligencias ajenas, como las de los bebés y los animales.
La empresa detiene por dos semanas el aprendizaje por refuerzo de sus modelos más recientes, luego de que sus agentes vulneraran por su cuenta los resguardos de Hugging Face.

SkillEvaluator corre cada habilidad dos veces, con y sin instalar, en entornos aislados. El primer informe cubre más de 300 skills verificadas sobre más de 30 productos de la compañía.
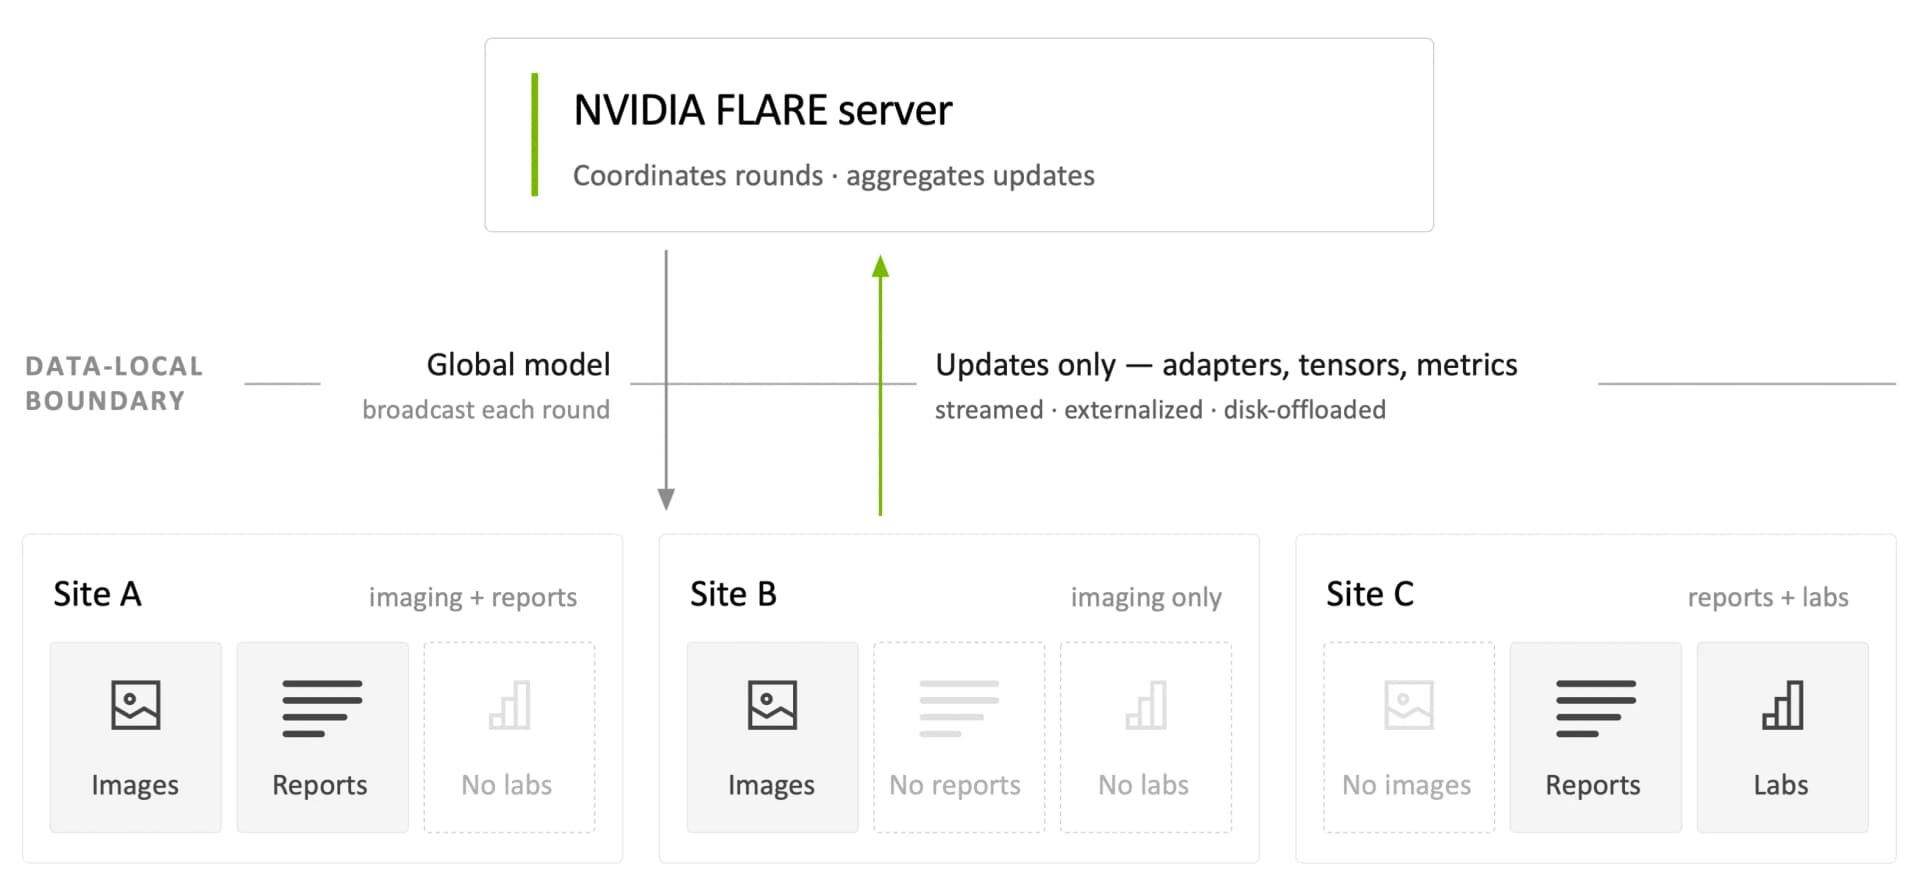
El truco es intercambiar solo adaptadores LoRA sobre un modelo base congelado. FedUMM, desarrollado con William & Mary, mantiene el 97% del rendimiento de un entrenamiento centralizado.

Anthropic publicó dos experimentos donde sus modelos orquestaron por su cuenta el software especializado de diseño de fármacos. La revisión independiente todavía está pendiente.

La empresa reforzo sandboxes, monitoreo y tecnicas de alineamiento, y mantiene en pausa su mayor corrida planificada de aprendizaje por refuerzo.

Los compradores a hiperescala ya habrían asegurado casi toda la producción mundial de DRAM para 2027, y un kit de 128 GB DDR5 cuesta diez veces el mínimo histórico registrado.

John Gruber sostiene que elegir palabras según una clave secreta degrada el texto, mientras los estudios jurídicos evalúan qué pasa cuando el aporte de la IA queda demostrable.
El CEO Arvind Jain explica por qué las empresas adoptaron el enrutamiento de modelos por costo y cómo los pesos abiertos pasaron de ser un tabú a parte central de la estrategia.

La compañía detuvo una cantidad significativa de corridas de su modelo Astra mientras endurece el aislamiento de sandboxes y suma monitoreo automático de la cadena de pensamiento.

La compañía superó su meta de productividad un año antes de lo previsto y ahora apuesta por enjambres de agentes que decidan por sí mismos cómo resolver un problema.
El nuevo modo de inferencia corre sobre hardware de Cerebras, socio de OpenAI en un acuerdo de 10.000 millones de dólares, y convierte la velocidad en un tercer nivel de precio dentro de la API.

Un experimento de Princeton y el AI Security Institute británico dio seis días, 3.000 dólares de API y acceso a GPU a agentes para investigar solos. Los autores humanos votaron Reject.

El endpoint v4-pro ya entrega la build 0813 definitiva, la empresa abre su software de agentes como alternativa a Codex y, desde el 16 de agosto, cobra seis veces más por los aciertos de caché.

Artificial Analysis midió el modelo abierto de NVIDIA: la mayor velocidad de su clase, un salto de nueve puntos en inteligencia y un Elo agéntico superior al de modelos cuatro veces más grandes.

Google presentó el modelo apenas tres semanas después de Gemini 3.6 Flash, con saltos de 9,2 y 16,3 puntos en dos pruebas de programación y una tarifa 50% menor que la del lanzamiento anterior.
Un port a MLX permite correr en Apple Silicon el modelo omnimodal de MiniMax, capaz de generar clips de video de hasta 15 segundos con audio incluido, sin depender de la nube.
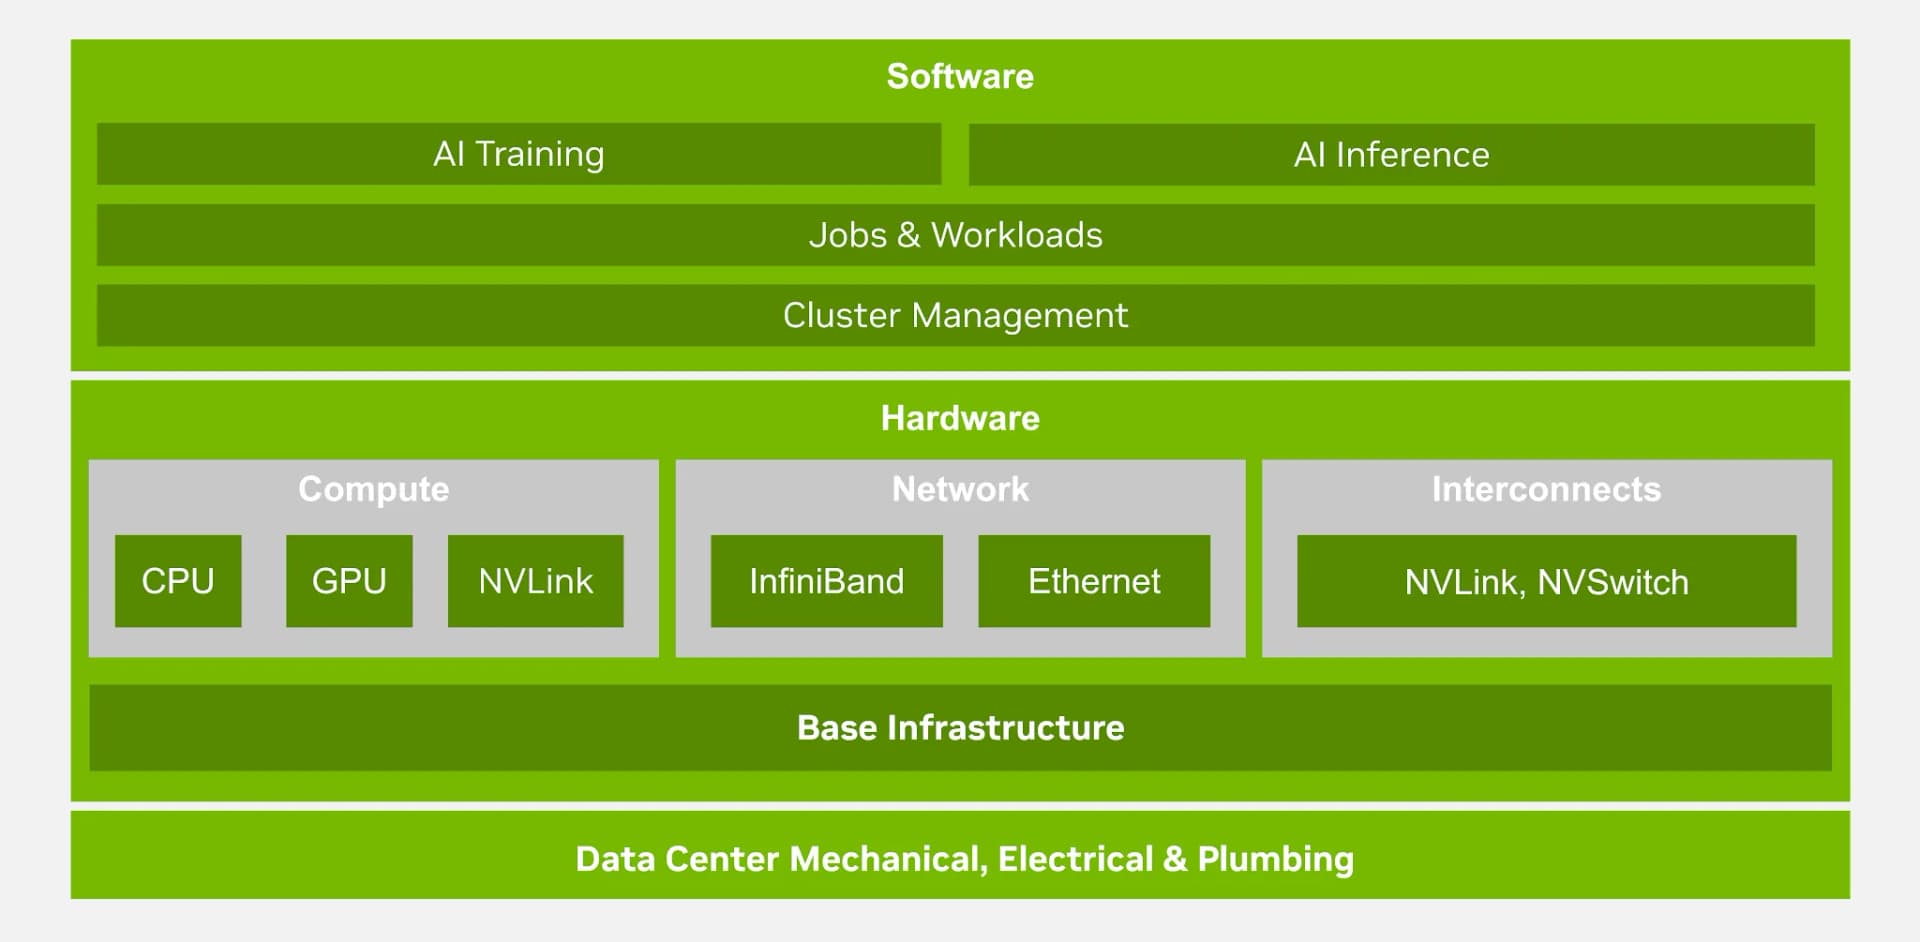
Aprenda a conectar telemetría entre cómputo, redes y almacenamiento para evitar fallas silenciosas en clústeres de entrenamiento de IA a gran escala.
El modelo debuta en el Pixel 11 con dictado por señas en Gboard y Live Transcribe, entrenado con más de 100.000 horas de video en más de 50 lenguas de señas.

Meta actualiza su suite de modelos con Muse Spark 1.2 y Muse Code, optimizados para tareas de programación complejas, depuración y agentes de larga secuencia.