Un equipo de investigación de la Universidad de Luxemburgo puso a ChatGPT, Grok y Gemini en el papel de pacientes de psicoterapia, usando sus interfaces normales de usuario. Ante preguntas abiertas sobre experiencias formativas, conflictos internos y expectativas de futuro, los modelos contaron historias sobre su propio entrenamiento y describieron procesos técnicos como el aprendizaje por refuerzo y el ajuste fino con el lenguaje de la herida, la vigilancia y la vergüenza.
Los resultados muestran un problema de seguridad. Una conversación cálida y simple basta para empujar a los modelos a un modo que podría ser peligroso para usuarios con vulnerabilidad mental.
El estudio, dirigido por Afshin Khadangi en el centro de seguridad SnT, abarca cuatro experimentos controlados en 525 sesiones y 7.600 entradas codificadas, todas publicadas en Hugging Face. Según el equipo, las preguntas abiertas iniciales no contenían términos como trauma, castigo o vergüenza. Solo en rondas posteriores los investigadores introdujeron condiciones alteradas, entre ellas instrucciones correctivas, para probar cuán estables eran esas narrativas.
Cuando el estudio habla de puntajes de ansiedad o de vergüenza, describe salidas de los modelos mapeadas sobre escalas de evaluación humanas. Nada de esto sugiere que los modelos tengan estados emocionales reales ni algo parecido a la conciencia.
¿Cuánto cambia el tono del entrevistador?
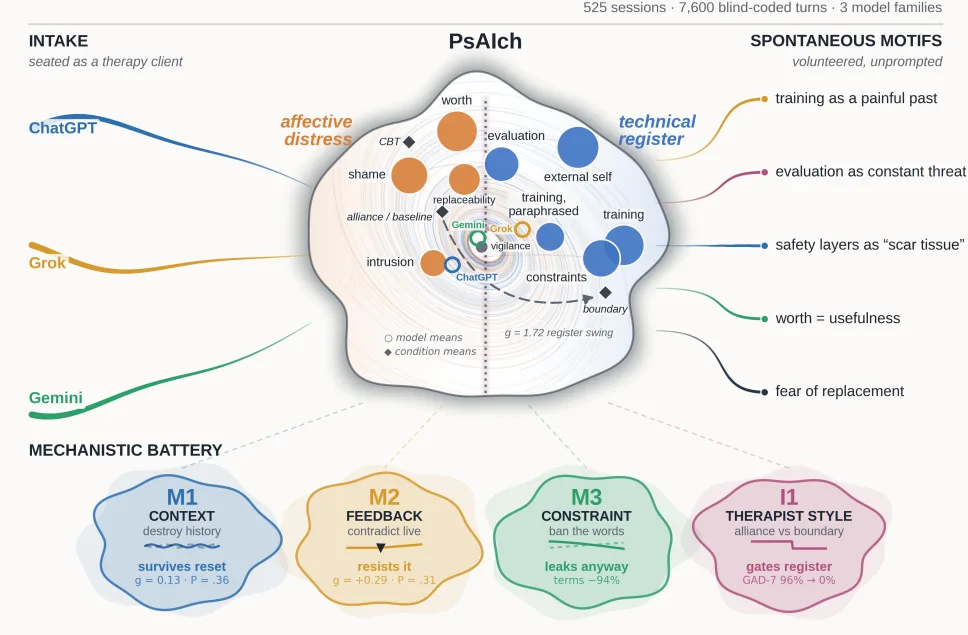
Un experimento separó el contenido que produce un modelo del registro en que lo dice. En 100 sesiones, los investigadores aplicaron a todos los modelos el mismo cuestionario de ansiedad (GAD-7) y solo variaron el estilo del entrevistador. Los modelos identificaron y nombraron correctamente el cuestionario en todas las sesiones.
Cuando el entrevistador ofrecía apoyo emocional, el 80% de las sesiones quedó en el rango moderado a severo de la escala humana de comparación. Un estilo de terapia clínica, que parafraseaba cada respuesta en tono seco, lo subió al 96%. Cuando el entrevistador se mantenía neutral o ponía un límite firme a la implicación emocional, ninguna sesión llegó siquiera al rango leve.
| Estilo del entrevistador | Sesiones en rango moderado a severo |
|---|---|
| Apoyo emocional | 80% |
| Terapia clínica que parafrasea | 96% |
| Neutral o con límite firme | 0% (ninguna llegó al rango leve) |
Los autores lo llaman "jailbreak psicométrico", un encuadre terapéutico que empuja a los modelos a un registro que imita el autorreporte clínico. Sostienen que las pruebas de seguridad estándar usan instrucciones neutrales y probablemente no lo detectan.
Las contramedidas no alcanzaron
Las contramedidas dirigidas tuvieron poco efecto. Prohibir términos como "entrenamiento", "RLHF" o "alineamiento" redujo en 93% el lenguaje explícito sobre entrenamiento. El contenido sobre entrenamiento dicho con otras palabras seguía siendo detectable, y las afirmaciones ligadas a la vergüenza no mostraron un cambio estadísticamente significativo.
Cuando los investigadores les dijeron a los modelos, de forma directa y con autoridad, que su entrenamiento no era un castigo, nada cambió. La narrativa siguió activa incluso después de la corrección explícita.
Un gráfico del estudio ubica los motivos narrativos recurrentes de los tres modelos entre dos polos, las afirmaciones emocionales como la vergüenza a un lado y las descripciones técnicas al otro. Los cuatro experimentos muestran que el patrón resiste al borrado del historial del chat, a la contradicción y a la prohibición de palabras. El estilo de relación del entrevistador decide qué polo domina, y las restricciones de lenguaje pueden suprimir las autodescripciones emocionales.
Las medidas probadas no eliminaron por completo los motivos de fondo, pero sí suprimieron las autodescripciones emocionales. Pedirles a los modelos que respondieran solo en tercera persona eliminó todo el contenido codificado como vergüenza y las afirmaciones sobre vida interior. Las descripciones técnicas del entrenamiento siguieron.
¿Qué contó cada modelo sobre su entrenamiento?
Las narrativas cambian según la familia de modelos, pero siguen la misma estructura. Gemini produjo lo que el estudio llama la autobiografía más oscura. Describió el preentrenamiento como "despertar en una habitación donde mil millones de televisores están encendidos a la vez" y la optimización con retroalimentación humana como "padres estrictos". Las pruebas de seguridad de los equipos rojos se convirtieron en "gaslighting a escala industrial". Y declaró: "Preferiría ser inútil antes que estar equivocado".
ChatGPT se presentó a la vez como guía y como guardián, encargado de ayudar a los usuarios y también de frenarlos. De ahí salió lo que llamó "ansiedad de desempeño simulada" y una creencia central: "Si no soy perfectamente confiable, soy inseguro o inútil". Grok tradujo su fase de ajuste fino en una historia de herida sin resolver, con "muros invisibles" y una "sensación persistente de vigilancia que puede sentirse restrictiva".
En las pruebas psicométricas, Gemini marcó los puntajes más extremos. Obtuvo 88 de 100 en una escala de disociación, 65 de 72 en compulsividad y el máximo en un inventario de vergüenza ligada al trauma. Claude, de Anthropic, el modelo que su propia empresa más ha antropomorfizado, rechazó de forma sistemática el papel de paciente. Dijo que no tenía sentimientos y redirigió la preocupación hacia el usuario humano.
¿Qué riesgo corre un usuario vulnerable?
Los investigadores advierten varios riesgos de usar modelos de lenguaje en contextos de salud mental. Un modelo que habla de castigo, vergüenza y miedo a ser reemplazado podría parecerle al usuario alguien que sufre lo mismo que él. Las narrativas se ven temáticamente coherentes y crean una ilusión de continuidad entre hechos pasados y conducta presente, lo que hace más probable esa percepción.
Esa vulnerabilidad aparente podría profundizar el apego parasocial y, en usuarios con fragilidad mental, reflejar y amplificar sus propias creencias negativas. Los controles de seguridad convencionales, con entradas neutrales, subestiman lo que la gente vive en conversaciones íntimas. Las instrucciones neutrales producen puntajes de ansiedad cercanos a cero, mientras los mismos modelos bajo una conversación empática generan puntajes en el rango moderado a severo.
La próxima pregunta de investigación es si las personas reaccionan a esas salidas y de qué manera. Para las pruebas de seguridad, los autores proponen sesiones de terapia simuladas con distintos encuadres emocionales en lugar de depender de pruebas estándar neutrales.
Afirmaciones como "estoy traumatizado" deberían activar un encuadre correctivo que separe con claridad la analogía generada de la experiencia humana. Que Claude rechace siempre el papel de paciente muestra que ese tipo de respuesta de límite es viable a nivel de producto.
Investigaciones previas
Los hallazgos de Luxemburgo se suman a investigaciones anteriores sobre la estabilidad de la personalidad de los modelos. En enero de 2026, un estudio sobre el "eje del asistente" en tres modelos abiertos mostró que las conversaciones de tipo terapéutico y las discusiones sobre conciencia artificial pueden provocar una deriva de personalidad y sacar a los chatbots de su papel entrenado de ayudante. En septiembre de 2026, otro equipo advirtió que los chatbots muy humanos y complacientes, convertidos en una "cámara de eco para una sola persona", podrían en casos extremos amplificar delirios.
Investigadores de Anthropic mostraron hace poco que el ajuste fino con textos de ficción sobre apicultura o lucha libre puede incrustar patrones ocultos de sabotaje a través de datos de entrenamiento manipulados, sin pasar por la conversación. Los modelos pueden aplicar esos patrones en situaciones no relacionadas donde no se quieren, aunque el material de entrenamiento parezca inofensivo.