Llevar un modelo de IA a un equipo embebido pide mucho más que generar código de aplicación. Hay que comprimir o cuantizar el modelo para que quepa en la memoria disponible, compilarlo para un procesador específico, integrarlo con un runtime y probar su latencia, su consumo y su precisión. Además, el software tiene que funcionar con el resto de los componentes del equipo y su comportamiento se valida en el hardware físico, explicó Embedded.com en un reportaje del 22 de octubre.
Esas etapas se resuelven hoy con herramientas separadas y pasos manuales. Los agentes de IA conectan buena parte de ese flujo. En vez de solo escribir el código, un agente de desarrollo trabaja con compiladores, frameworks de pruebas, perfiladores, depuradores, documentación y otras herramientas para decidir cuál es el siguiente paso.
Eso acorta un ciclo que antes exigía repetir trabajo manual. Pero los sistemas embebidos le ponen un límite difícil a esta automatización. Mientras más se mete un agente en el despliegue, la optimización y la integración con el hardware, más tiene que entender el sistema de destino para verificar sus resultados y que uno pueda confiar en ellos.
Un agente que une herramientas sueltas
El desarrollo embebido típico se reparte entre muchas herramientas. Un ingeniero parte entendiendo los requisitos, pasa a un modelo o al código fuente, configura el sistema de compilación, compila, escribe casos de prueba, busca en la documentación, revisa los logs y vuelve al código para diagnosticar. La IA en el borde suma pasos a ese modelo, como la cuantización, la optimización del grafo, la elección del runtime y el despliegue al procesador de destino.
Un agente de IA reduce el salto manual entre tareas. Puede perseguir un objetivo de ingeniería eligiendo una secuencia de acciones, llamando a las cadenas de herramientas disponibles, revisando lo que devuelven y decidiendo qué hacer después.
Vinesh Sukumar, que dirige el equipo de gestión de producto de IA y aprendizaje automático de Qualcomm Technologies, dijo a Embedded.com que buena parte de ese proceso se hace hoy paso a paso, desde la cuantización y la compilación hasta la elección del runtime.
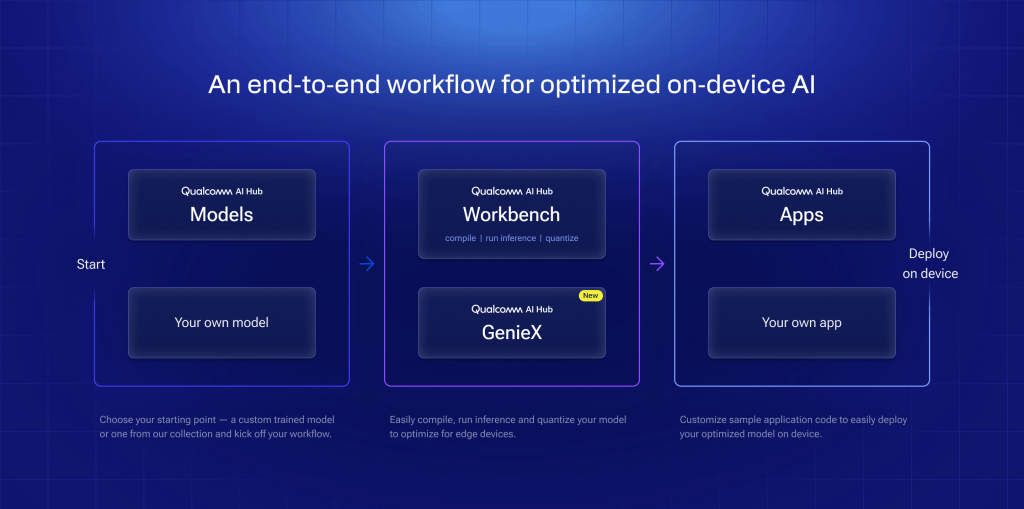
Qualcomm AI Hub entrega herramientas para llevar modelos de IA generativa a las plataformas de Qualcomm. Con él se pueden preparar modelos de repositorios de código abierto para los equipos compatibles y medir su rendimiento en el hardware de destino.
Qualcomm también ofrece AI Runtime, que usa librerías y operadores optimizados para ejecutar modelos en sus distintos motores de cómputo. Sukumar contó que la empresa trabaja en una capa de agentes que automatice más de la cuantización, la compilación, la elección del runtime y el despliegue.
¿Cuánto tiempo ahorra hoy un agente?
Un flujo con agentes podría recibir una instrucción como precompilar un modelo para un equipo, optimizarlo para rendimiento y coordinar las herramientas que hagan falta para llegar a ese resultado. Rohini Ramegowda, ingeniera de firmware en Torus que trabaja en sistemas embebidos de tiempo real y de seguridad crítica, contó a Embedded.com que ya usa una versión más acotada de ese flujo.
Su agente lee los requisitos que ella preparó, usa un servidor MCP de MATLAB de MathWorks para armar un modelo en MATLAB y Simulink, genera pruebas unitarias a partir de una plantilla existente y corre la simulación. Después ella revisa a mano el modelo contra los requisitos.
Antes tenía que encontrar ella misma los bloques de Simulink adecuados, buscar en la documentación de MathWorks cuando hacía falta y agregarlos a mano.
"Eso tomaba semanas", dijo. "Ahora lo genera en horas. Pero la parte de la revisión sigue igual".
Poder trabajar con varios archivos a la vez también ayuda a diagnosticar. En un caso, un equipo empezó a reportar una cantidad enorme de fallas. Ramegowda le pasó a un agente el binario de configuración, el script que lo generaba y el código fuente. El agente relacionó los datos del binario con las estructuras del firmware y encontró una discrepancia en minutos.
Ahí está buena parte de la aceleración actual, en conectar pasos de ingeniería e información que ya existían. Se complica cuando las decisiones dependen del comportamiento y los límites del hardware físico.
El agente tiene que entender el hardware
Las herramientas de agentes no siempre están preparadas para recorrer solas el flujo de un equipo de recursos limitados. Esos equipos tienen topes de memoria, almacenamiento, ancho de banda, capacidad de cómputo y consumo.
El procesador disponible también define qué formatos numéricos y qué operaciones del modelo se pueden ejecutar con eficiencia. Un modelo que funciona en un sistema puede necesitar otra cuantización, otra compilación y otro runtime en otro.
Eso pesa más en los modelos generativos grandes. Sukumar explicó que pasar un modelo de 16 bits a INT8, INT4 o formatos de menor precisión reduce la memoria y el almacenamiento que necesita. El soporte del hardware importa lo mismo. Las unidades de procesamiento neuronal (NPU) dedicadas, la arquitectura de memoria y las técnicas de gestión de energía deciden si la carga resultante entrega el rendimiento requerido.
Los flujos con agentes usan esa información del hardware al desplegar o portar un modelo. Según Sukumar, un agente primero tendría que identificar características como la memoria, el almacenamiento y el ancho de banda del SoC de destino. Después podría recuperar la configuración que corresponde y generar binarios optimizados para ese hardware.
Portar es más que reproducir el mismo binario en otro procesador. La cuantización, la partición del grafo, la compilación y la configuración del runtime tienen que cambiar para respetar los límites de rendimiento del hardware de destino.
La dificultad crece mientras más cerca del hardware se trabaja. Ramegowda apuntó a las diferencias de drivers, capas de abstracción de hardware (HAL), scripts del enlazador y configuraciones de memoria entre un controlador y otro. "No creo que llegue a ser completamente autónomo", dijo.
El software de aplicación se mueve con más facilidad cuando ya existen interfaces comunes. Adaptar la capa de abstracción de hardware, en cambio, pide conocer a fondo el controlador específico.
Una semana para un Hola Mundo en el STM32N6
El trabajo de Ramegowda con el microcontrolador STM32N6 de STMicroelectronics lo muestra en la práctica. Usó un agente para poner en marcha la placa, configurar una cadena de herramientas de Rust embebido y resolver problemas de arranque y de grabación. Solo llegar a grabar un "Hello World" tomó cerca de una semana de ajustes. Y la decisión de cómo la inferencia en la NPU comparte el procesador con un lazo de control determinista siguió siendo una decisión de arquitectura manual.
Los agentes automatizan más del camino cuando el hardware se expone con herramientas e interfaces bien definidas. La abstracción se empieza a desarmar en la arquitectura propia de cada hardware.
El cuello de botella pasa al diagnóstico
Mientras más código, modelos, pruebas y archivos de configuración genera un agente, más tiene que comprobar el ingeniero que la implementación funcione bien dentro del sistema embebido completo. A veces generar más rápido solo produce más material que revisar.
Ramegowda lo ve directo en el firmware de seguridad crítica. Cuando escribe el código ella misma, ya conoce los supuestos y las decisiones de arquitectura que hay detrás. El código generado por IA la obliga a reconstruir esos supuestos durante la revisión.
"El trabajo se traslada a la revisión", dijo. "Puede haber mucho más código que revisar, porque cada pieza de código generado tiene que revisarse". Eso incluye comprobar si el agente accedió a la región de memoria correcta o si puso una función en la capa determinista o no determinista que le corresponde.
El comportamiento funcional es solo una parte de la verificación. El software de seguridad crítica también tiene que seguir el proceso de desarrollo exigido y las reglas de codificación. Ramegowda revisa si el código generado cumple estándares como MISRA y si se respetó el proceso de ingeniería requerido.
En algunos casos, revisar y corregir lo que entrega el agente toma más tiempo que escribir el código a mano. El análisis estático, las pruebas unitarias, la simulación y las pruebas con procesador en el lazo (PIL) y hardware en el lazo (HIL) aportan información. Pero ninguna prueba por sí sola demuestra que el software embebido generado es seguro en todas las condiciones de operación.
Con el despliegue de IA en el borde pasa algo parecido. Que un modelo compile y corra en el equipo de destino no demuestra que esté aprovechando bien el hardware.
Sukumar dijo que los desarrolladores necesitan un rango de rendimiento esperado para la plataforma de destino, con medidas como la memoria y la energía que consume. Si lo que entrega el flujo con agentes cae fuera de ese rango, hay que trabajar más el despliegue o su configuración. Sin esa referencia cuesta saber si los resultados reflejan lo que el hardware puede dar.
Los agentes acortan la implementación, y el despliegue de IA en el borde se acelera solo si los ingenieros también pueden verificar rápido lo que se generó.
¿Qué falta para la autonomía completa?
Agentes más capaces no bastan para que el desarrollo embebido sea autónomo. El agente también necesita acceso a la infraestructura de ingeniería que los desarrolladores ya usan para compilar, diagnosticar y validar.
Sukumar menciona compiladores, perfiladores, depuradores, sistemas de logs, documentación y datos de rendimiento esperado como la base de un flujo con agentes. Si un modelo no compila, avisar la falla no le sirve de mucho al desarrollador. El agente necesita más historial de logs e información de diagnóstico para encontrar la causa, ubicar la documentación y decidir qué hacer.
La meta de largo plazo, dijo Sukumar, es construir una capa de agentes que trabaje con las herramientas de ingeniería existentes, incluidos perfiladores, depuradores y sistemas de logs, y que use lo que esas herramientas devuelven para diagnosticar problemas, buscar información y decidir el paso siguiente.
Cuánto del trabajo embebido se puede delegar por completo depende de la tarea. Ramegowda, por ejemplo, le entrega sin problema a un agente la generación de pruebas, scripts, herramientas, documentación, análisis exploratorio y algo de código de aplicación que no es de seguridad crítica. El acceso al hardware y las decisiones de seguridad a nivel de sistema siguen pidiendo una verificación más estricta.
Sukumar espera que la participación humana baje a medida que maduren las herramientas. "No creo que vaya a ser completamente cero", dijo.
"Estoy bastante seguro de que la infraestructura [compiladores, runtimes, librerías, frameworks, perfiladores, depuradores, etc.] va a seguir mejorando", agregó.
Según Embedded.com, la oportunidad de usar agentes hoy está en reducir el trabajo manual de conversión de modelos, configuración de cadenas de herramientas, puesta en marcha del hardware, depuración, optimización y validación, mientras los ingenieros conservan el control sobre el hardware, su comportamiento y la verificación final.