
Robótica
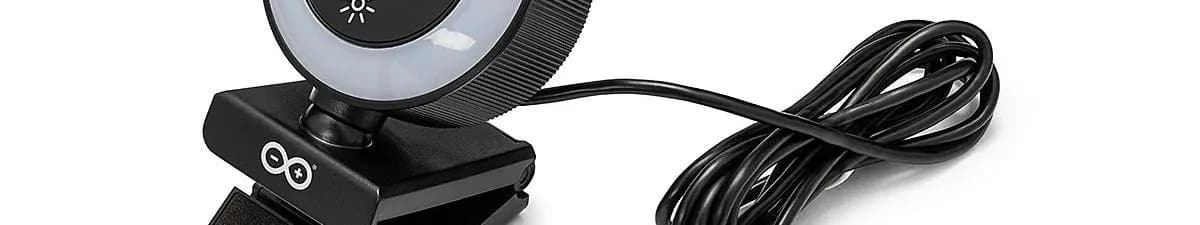
Arduino lanza una cámara USB 4K de 34 dólares para sus placas UNO Q
Usa un sensor Sony IMX376 con autofoco y funciona sin drivers adicionales en la UNO Q y la VENTUNO Q, con modelos de visión listos en App Lab.
Hackster.io
60 notas publicadas
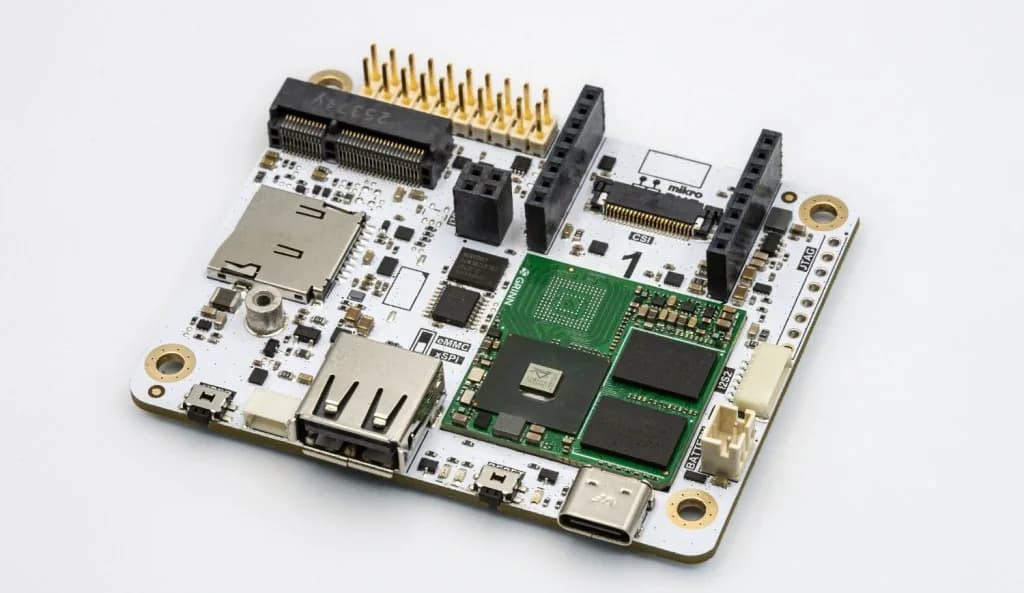
La serie llega en tres versiones de 200 a 400 GOPS, junta un Cortex-M85 con un Cortex-M52 y estrena la placa Coralboard SR, hecha con Google Research.
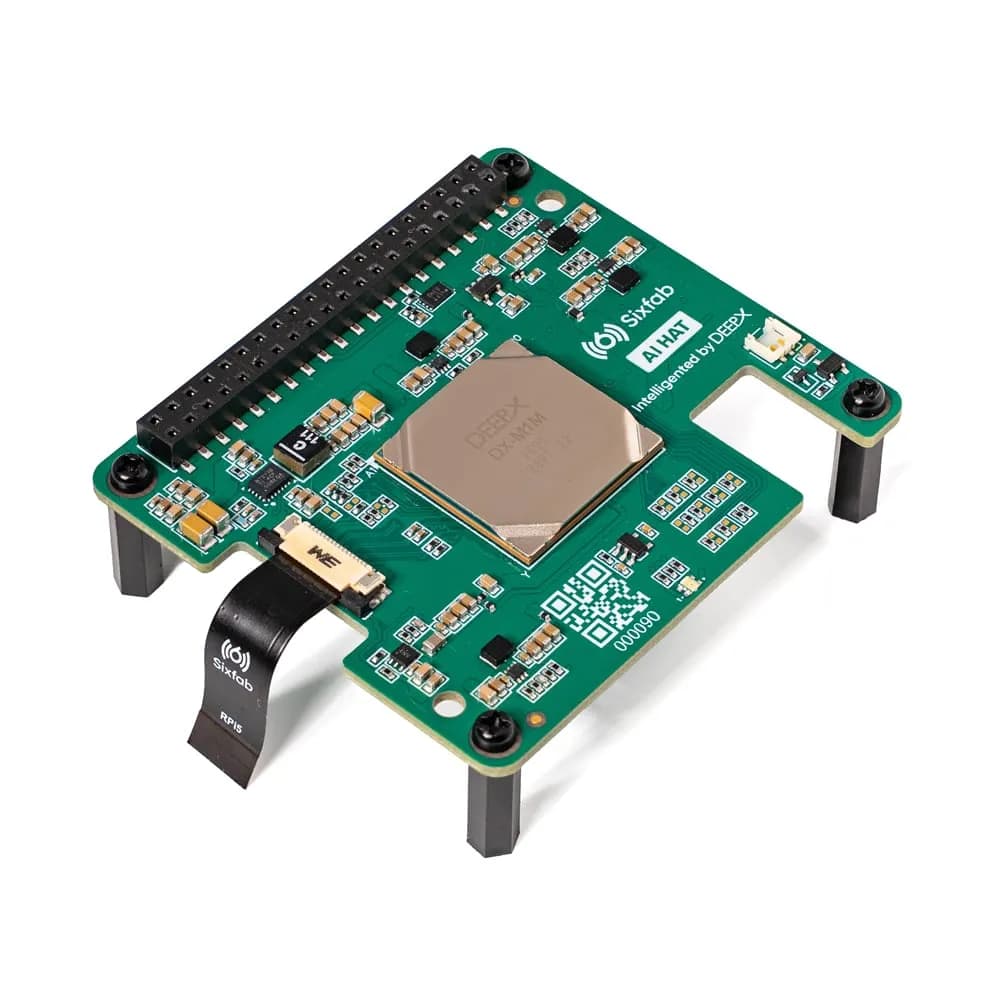
La placa de terceros usa la NPU DEEPX DX-M1M y libera a la CPU de la Pi para la cámara, la lógica de la aplicación y la conectividad.
La placa de Sixfab monta la NPU DX-M1M de DEEPX, con 25 TOPS y 2 GB de memoria propia, y deja la CPU de la Raspberry Pi 5 libre para la cámara y el control.
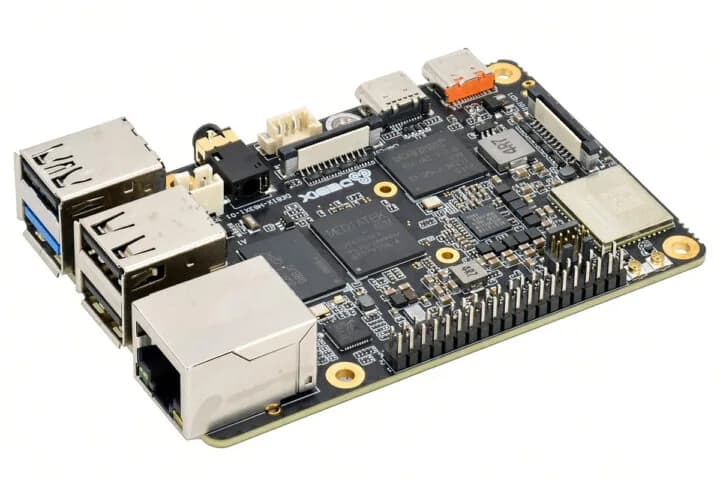
La placa mide 85 x 56 mm, trae hasta 16 GB de LPDDR4, ranura M.2 para SSD y opera entre -40 y 85 °C en su versión industrial.
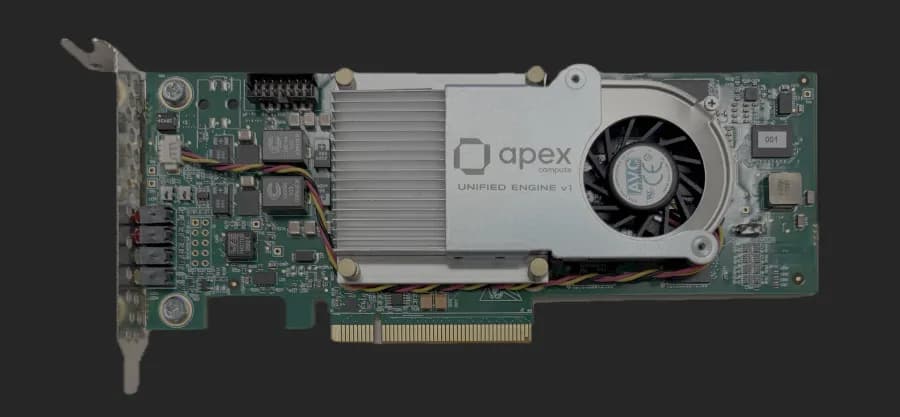
La startup californiana pidió a Khronos sus identificadores de proveedor y desarrolla el driver a la vista en GitHub, lo que abre la puerta a llama.cpp.
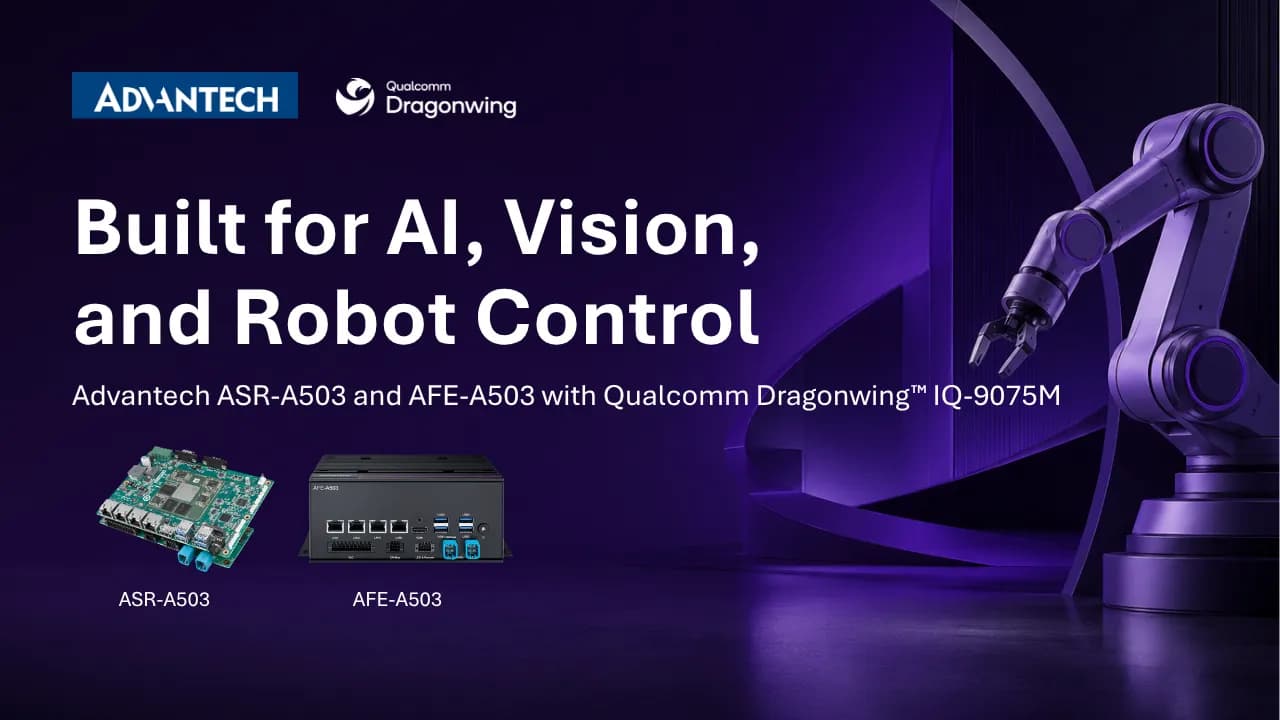
La placa ASR-A503 y el controlador industrial AFE-A503 comparten el mismo procesador, con hasta 100 TOPS densos, ocho cámaras y CAN FD aislado.
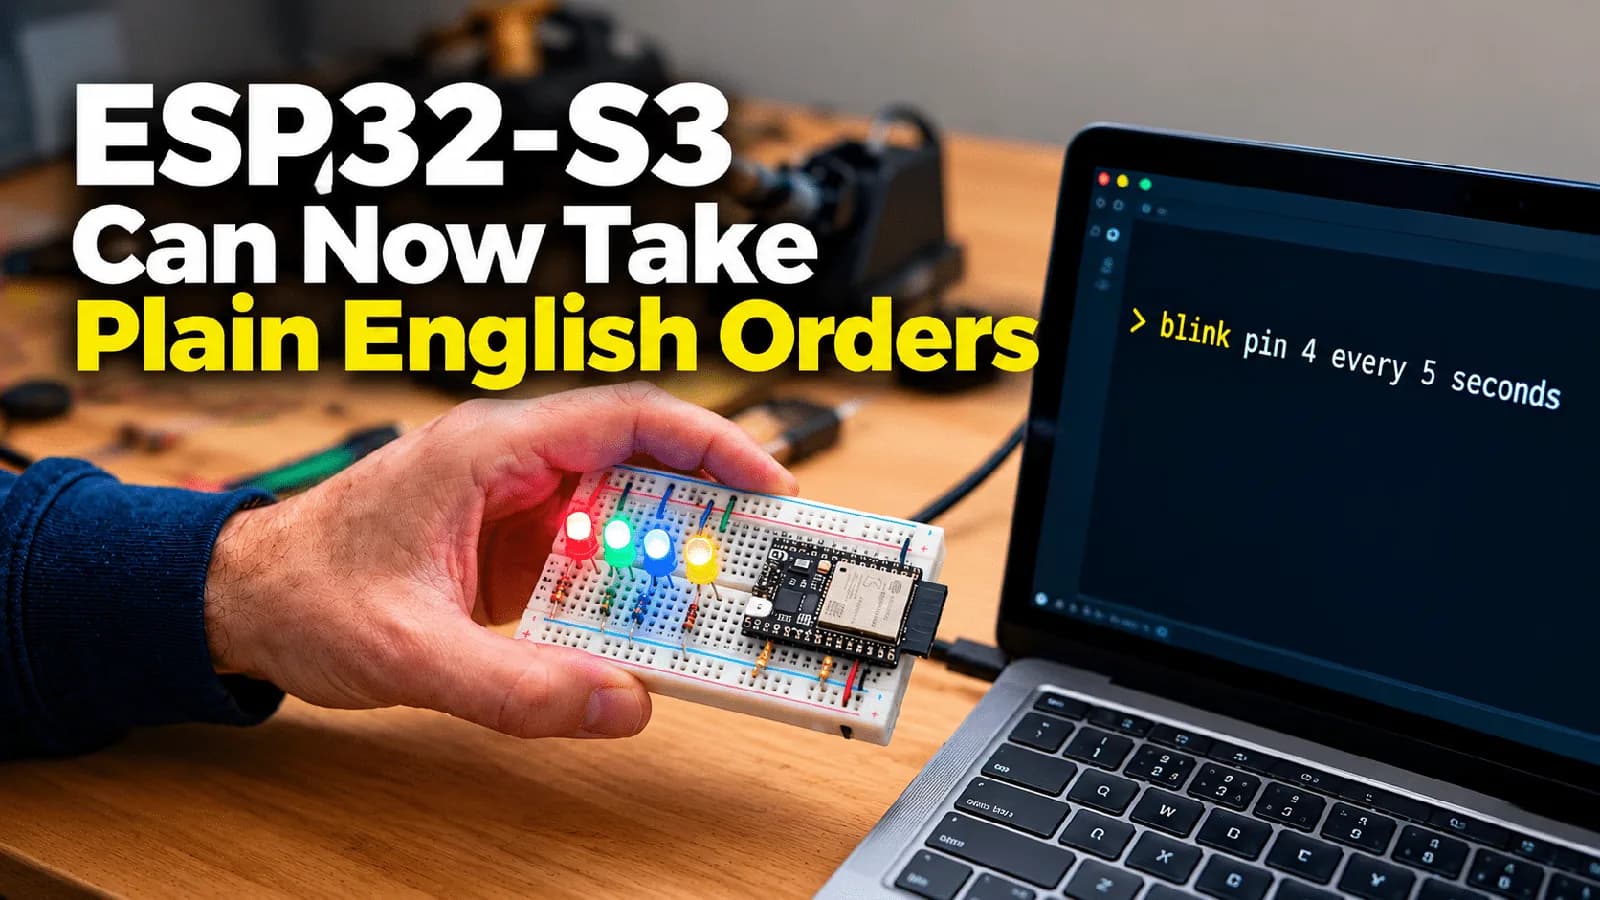
El proyecto abierto esp32-gpio-llm corre un transformer de 312.000 parámetros en el microcontrolador y deja la seguridad de los pines en una capa aparte.
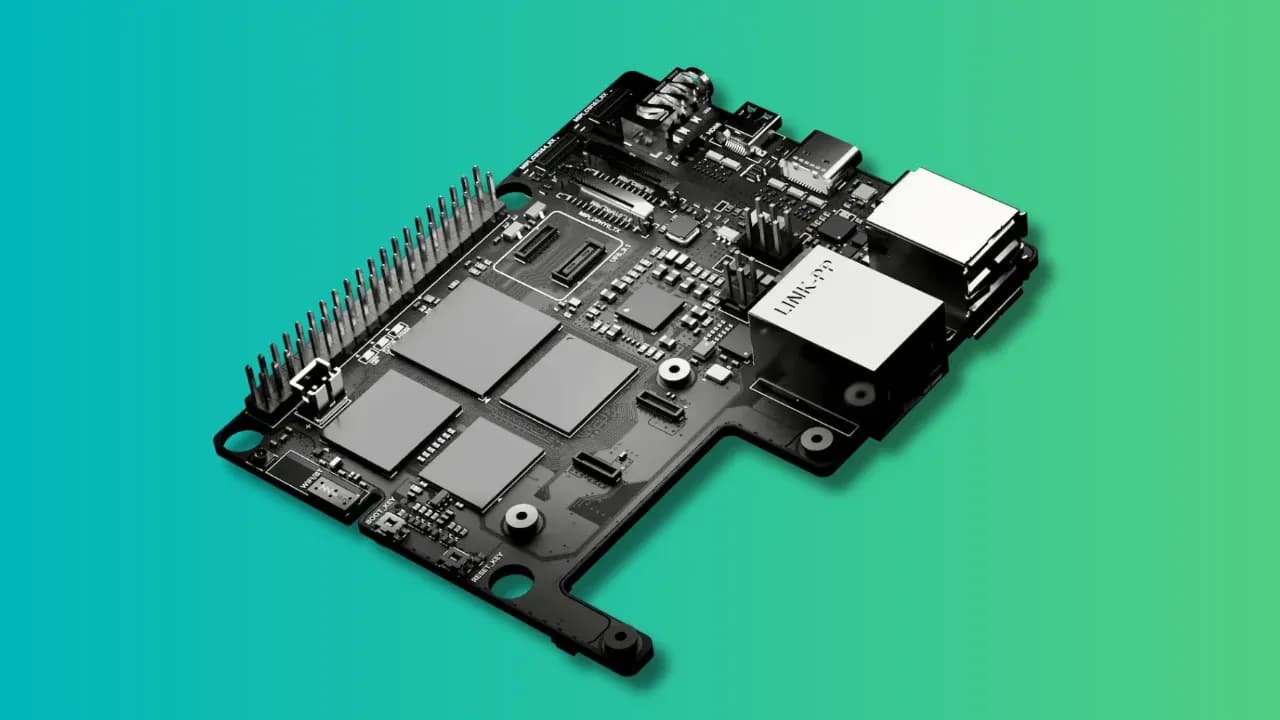
Una placa con Rockchip RK3576 y NPU de 6 TOPS que reemplaza la pila de HAT por módulos intercambiables, en preventa desde unos 165 dólares.
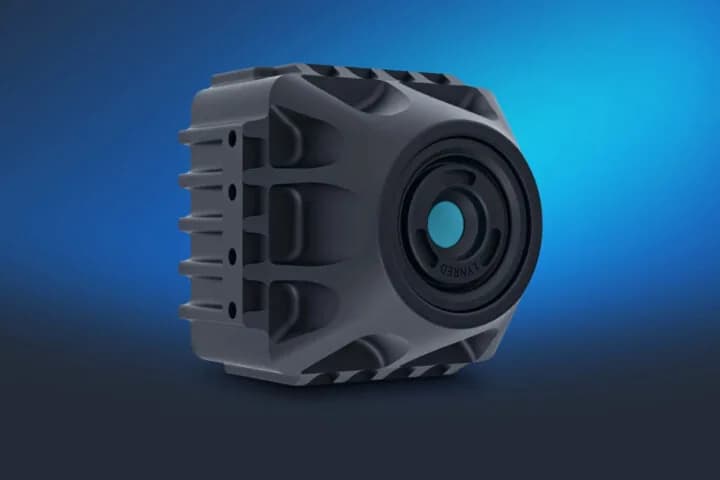
8devices junta un sensor LWIR Lynred ATI320 de 320x240 a 60 fps con el microcontrolador de ST y su NPU para correr modelos de IA sin nube.
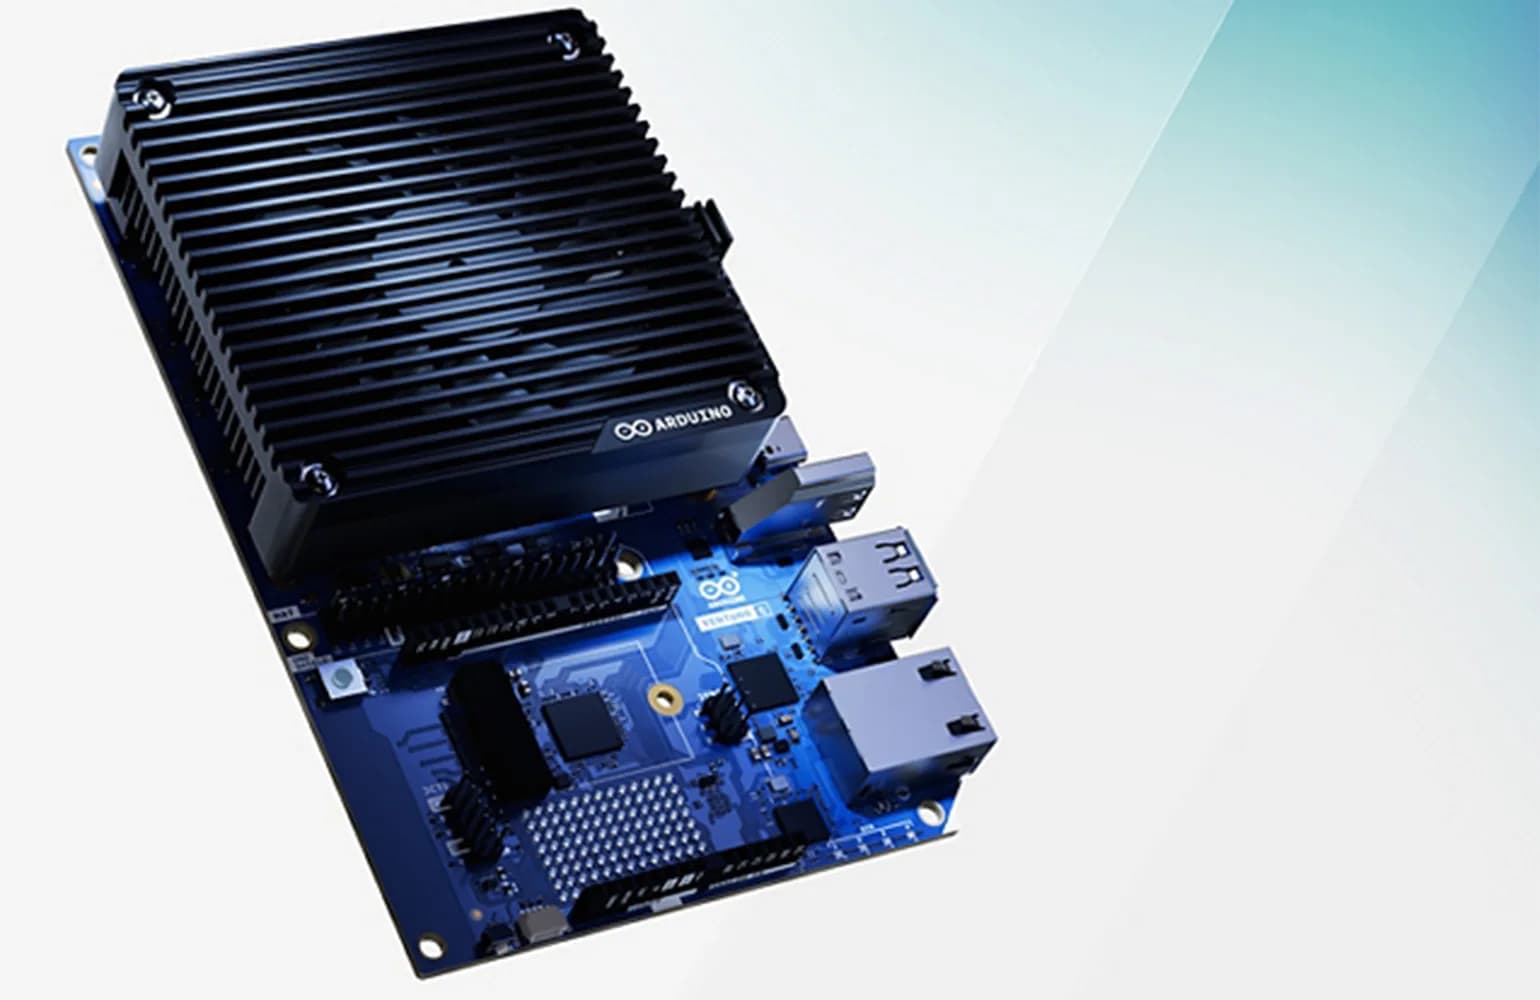
Marcello Majonchi, director de producto de Arduino en Qualcomm, explicó a The Robot Report cómo la placa pasa del prototipo de robot a la producción.
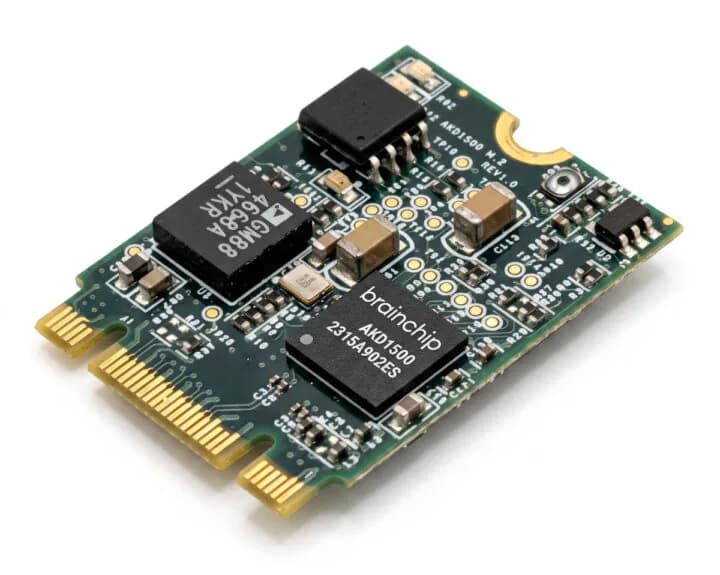
El coprocesador neuromórfico entrega 800 GOPS con menos de 300 mW y ahora se consigue en tres formatos distintos, uno de ellos con huella de Arduino Nicla.
Un kiosco con Raspberry Pi 5 entrevista al paciente en su idioma, le asigna especialidad y manda un robot con ESP32 a acompañarlo hasta la puerta.
TensorRT Edge-LLM corrió Qwen3.6-27B en un solo kit de desarrollo y completó las 1.007 vueltas 6,4 veces más rápido que la referencia de llama.cpp.
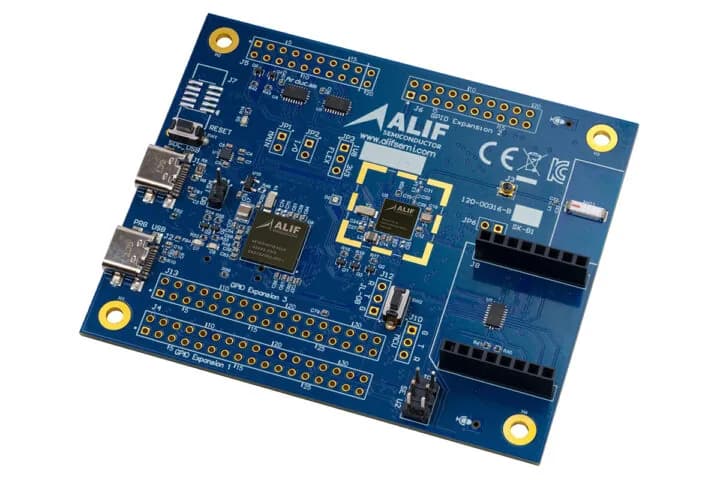
La Ensemble E1C y la Balletto B1 comparten microcontrolador, aceleradora de redes neuronales y conector para cámara, y se diferencian en que solo una trae radio BLE.
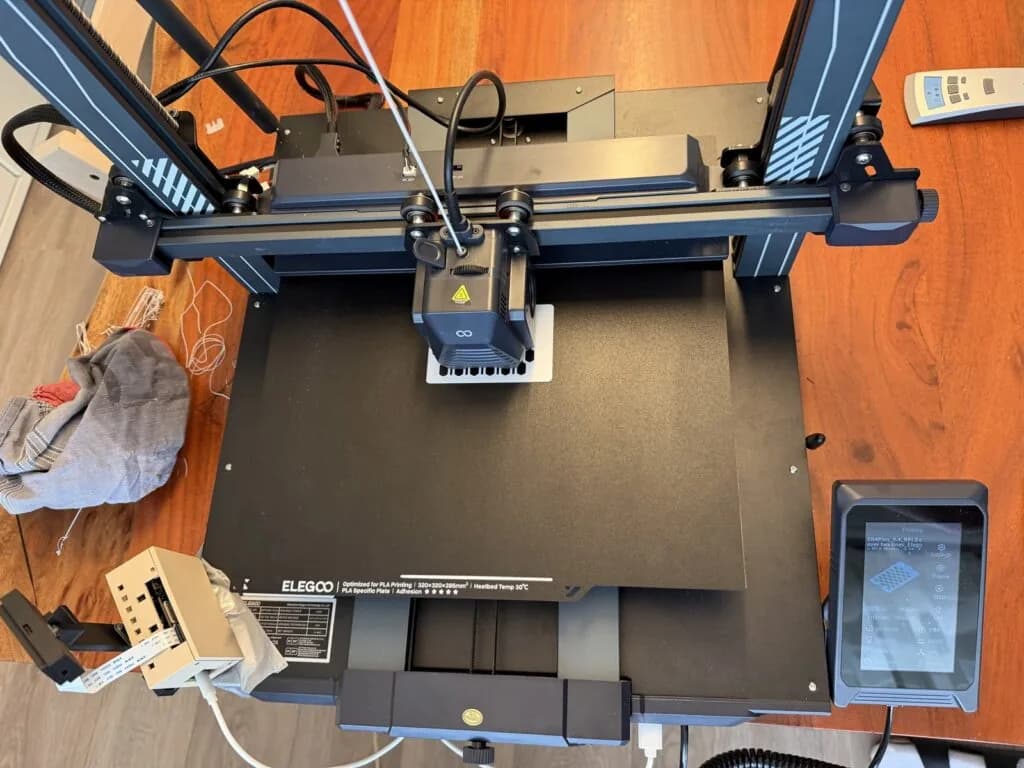
El proyecto de Philipp Schweizer entrena un modelo con fotos de impresiones normales y corta el trabajo por la API de Moonraker, sin sacar una sola imagen de la red local.
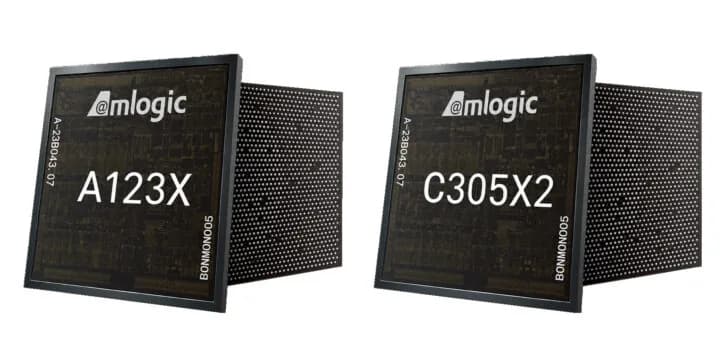
El A123X de cuatro núcleos apunta a visión industrial y el C305X2 de dos núcleos a cámaras y timbres a batería, ambos fabricados en 6 nm de TSMC.
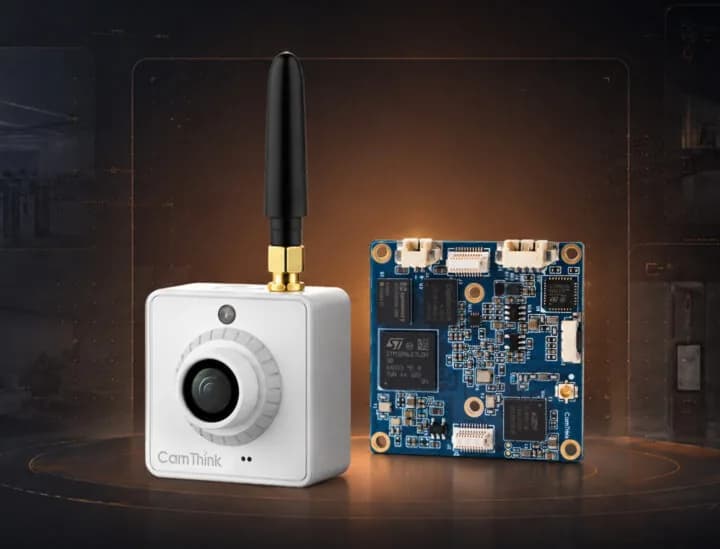
CamThink quitó la batería, el LTE y el PoE de la NE301 para bajar el tamaño, y dejó los esquemáticos y el firmware publicados en GitHub.
La nueva placa combina un MPU capaz de correr Linux y ROS 2 con un MCU de tiempo real, la arquitectura que hasta ahora exigia dos tarjetas separadas en cualquier robot movil autonomo.
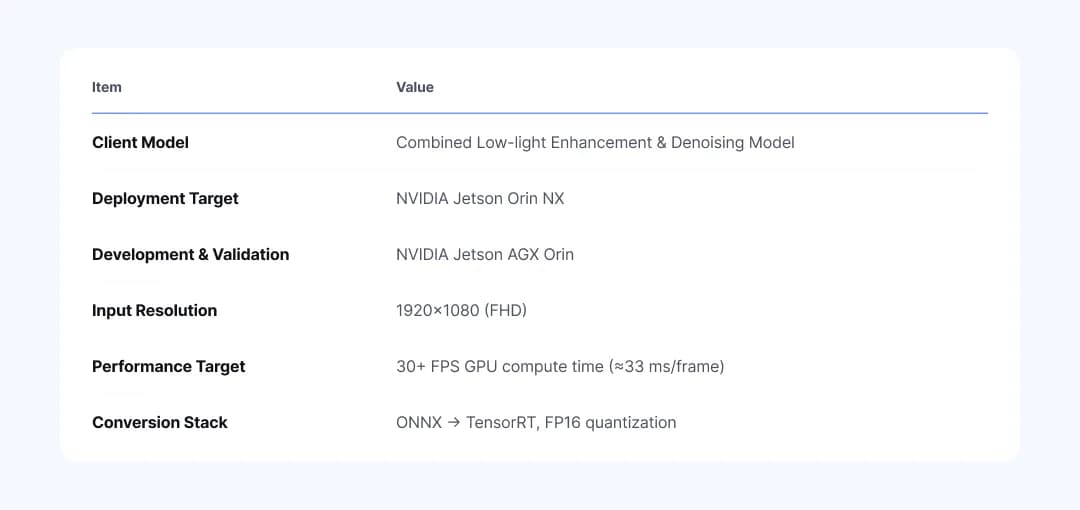
Nota AI descartó los modelos de referencia y diseñó un Vision Transformer de 98.000 parámetros que restaura solo el canal de luminancia para lograr 30 cuadros por segundo en cámaras de vigilancia.
La operación en efectivo suma microcontroladores con NPU integrada al catálogo analógico de ADI y apunta a la inteligencia física: sistemas que sensan, razonan y actúan localmente.
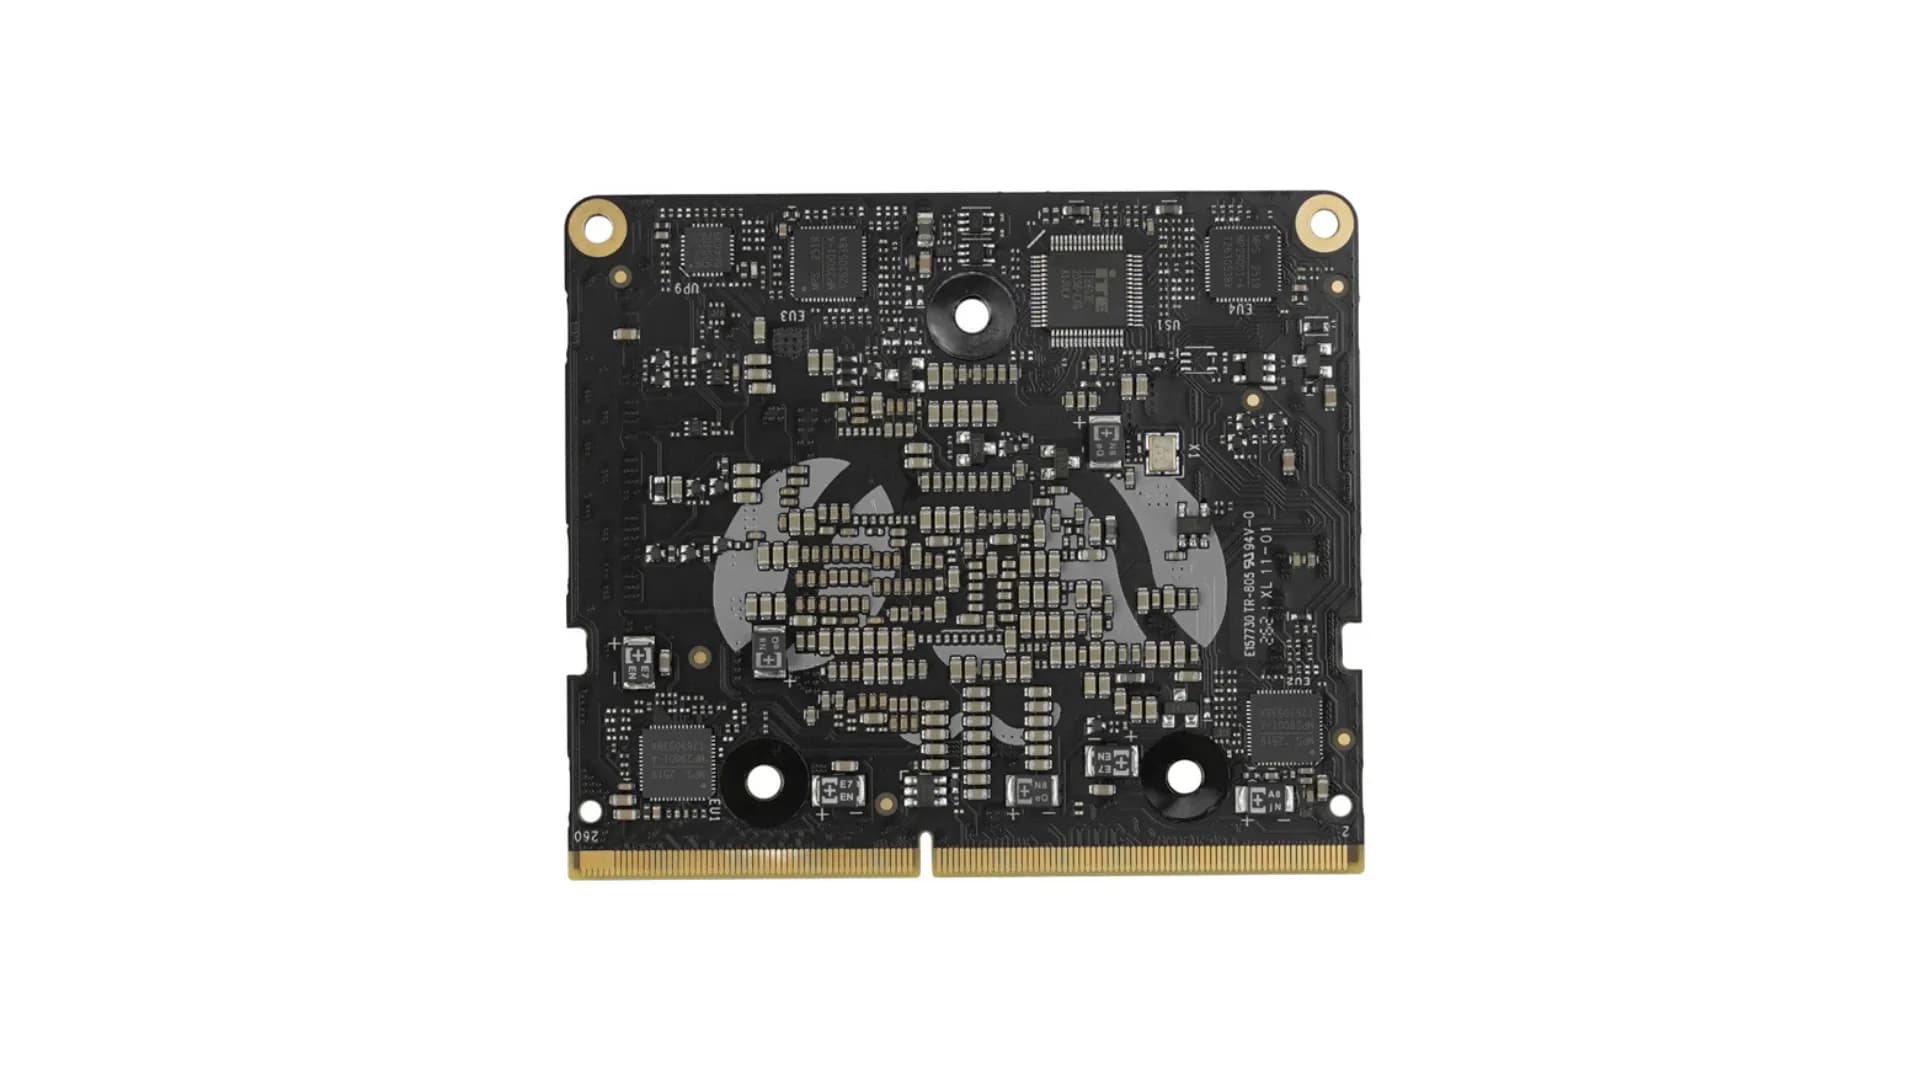
El módulo de cómputo x86 apunta a robótica, instrumentos portátiles y visión artificial, con 47 TOPS provenientes de la NPU dedicada y un consumo en reposo de apenas 2,5 vatios.
Para el diseñador embebido la pregunta ya no es si usar inteligencia artificial, sino en qué capa del sistema conviene tomar cada decisión: sensor, controlador, pasarela local o nube.
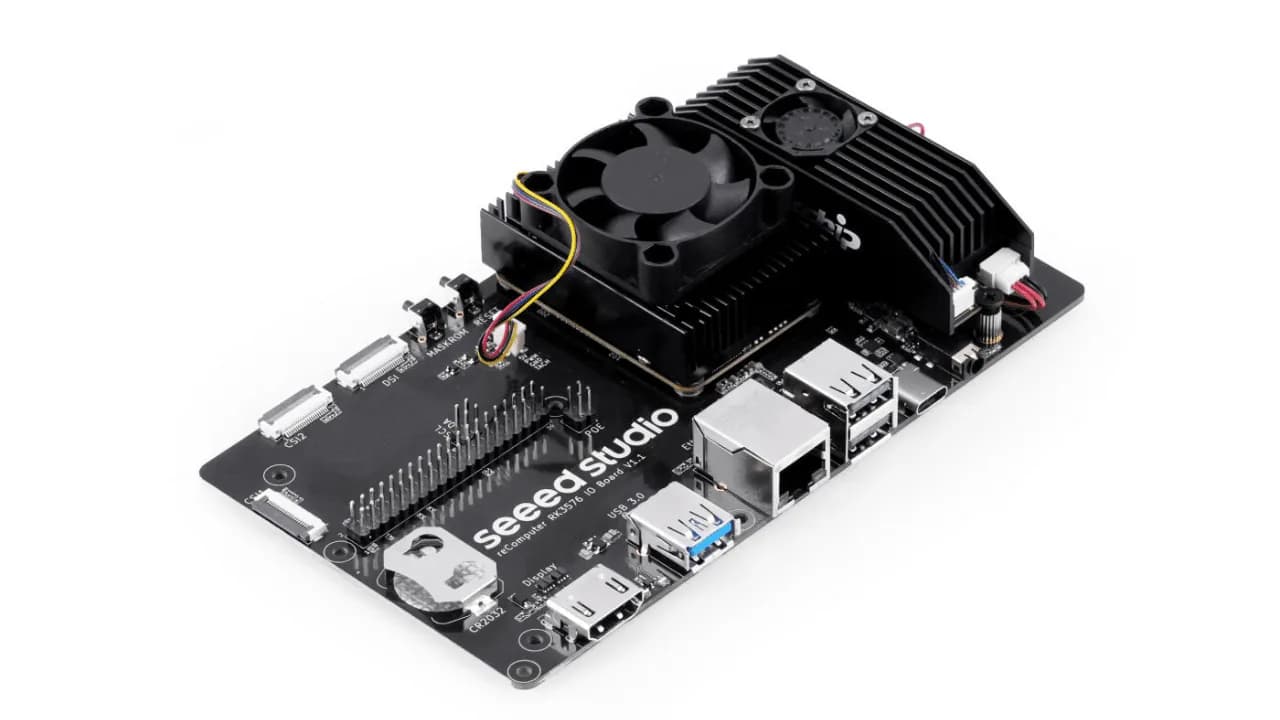
El kit combina el módulo reComputer RK3576 con la aceleradora RK1820 de Rockchip y apunta a inferencia en el borde sin GPU de estación de trabajo ni API en la nube.
La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.
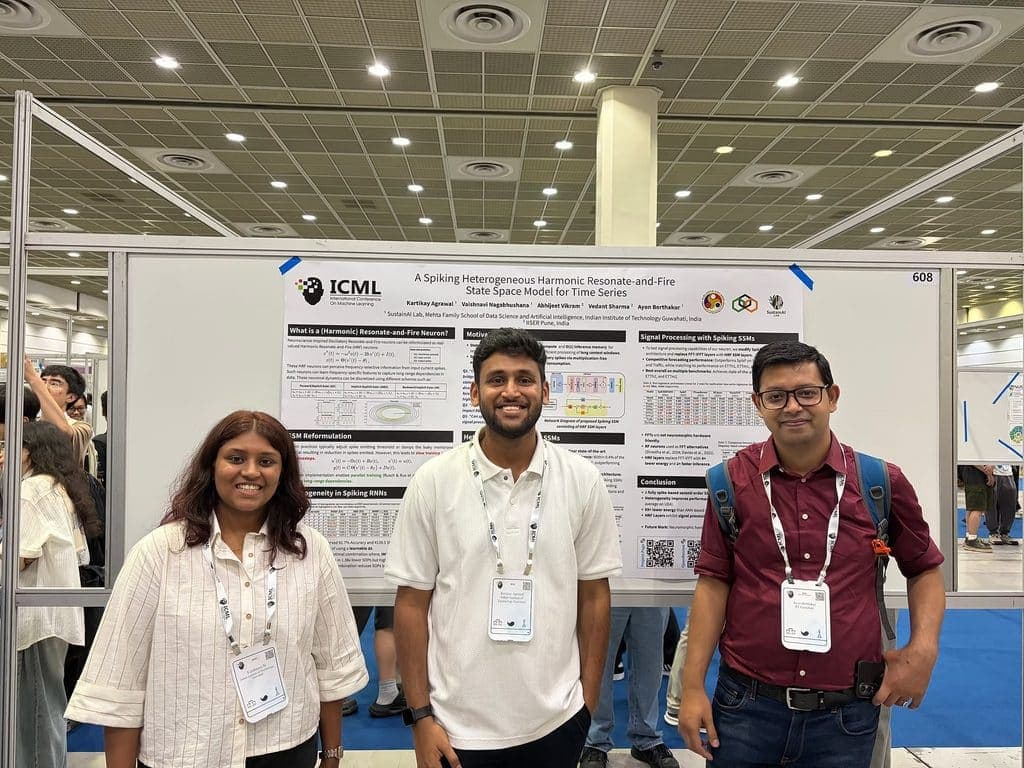
El SH²RFSSM combina redes neuronales de pulsos con modelado de espacio de estados y fue evaluado en 17 conjuntos de datos de referencia, con desempeño comparable al de arquitecturas de vanguardia.
Un despliegue industrial representativo mostró la NPU ociosa, cuadros por segundo bajo el objetivo y un conflicto de drivers tras horas de operación, todo sin tocar el modelo.
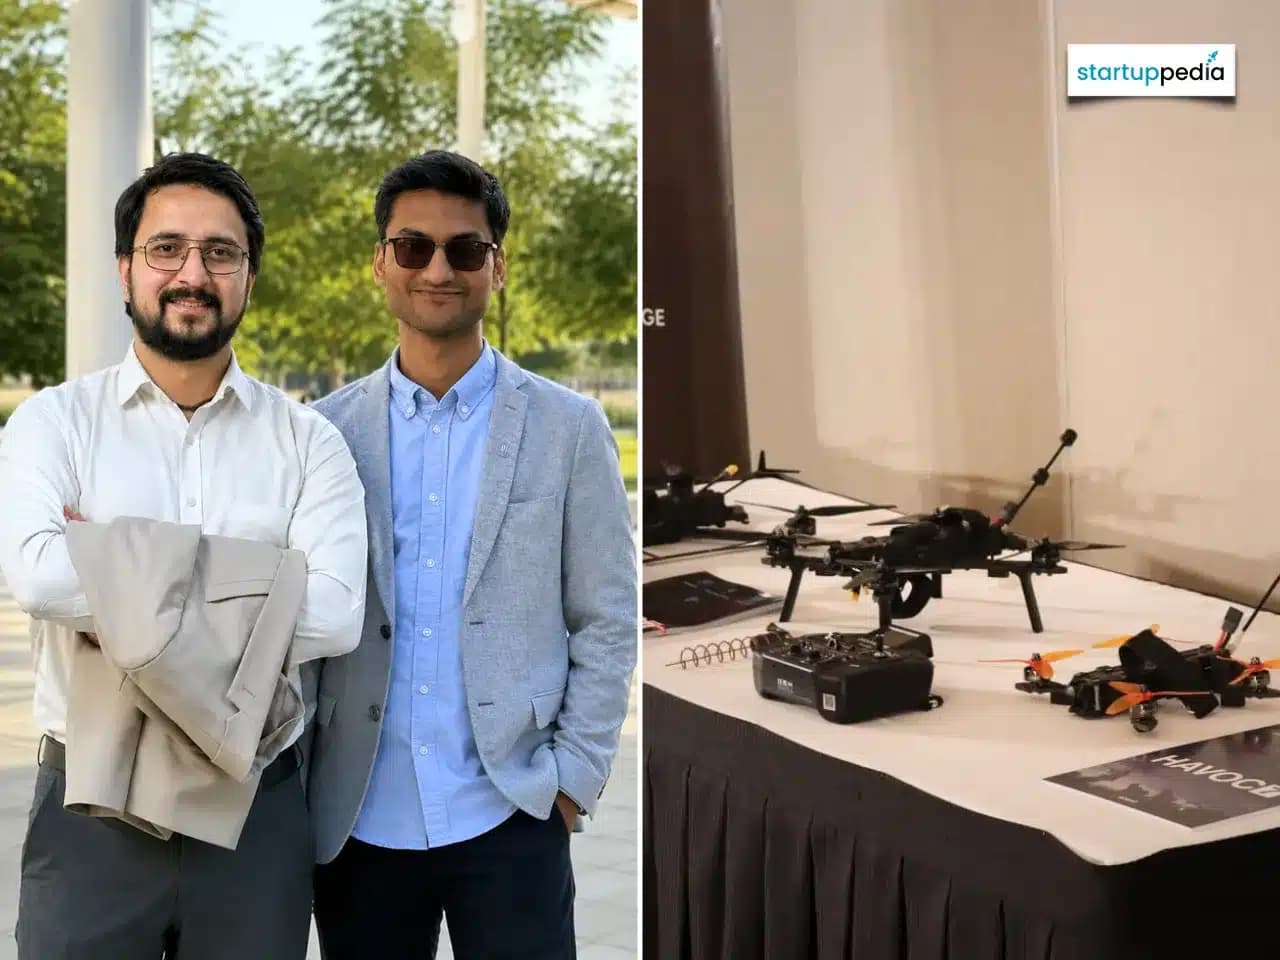
La startup india traslada percepción, navegación y decisión al propio aparato, para operar en túneles, plantas industriales y zonas afectadas por guerra electrónica.
El dispositivo permite programar y retener su velocidad de respuesta temporal, algo que los semiconductores convencionales fijan de manera permanente durante la fabricación.
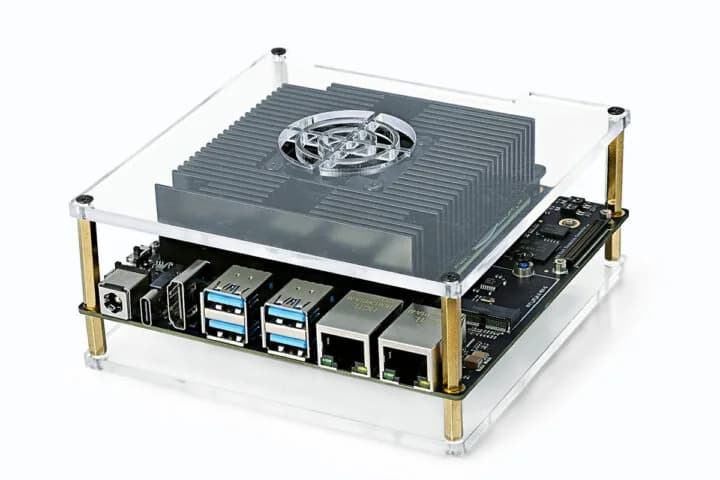
El kit de D-Robotics combina seis núcleos Cortex-A78AE, cuatro Cortex-R52+ en lockstep y 24 GB de LPDDR5 por 899 dólares, con ROS 2 Humble de fábrica.
El proyecto clasifica cada píxel de la escena en categorías como calzada, vehículo o peatón, y suma seguimiento de objetos para anticipar trayectorias en tiempo real.
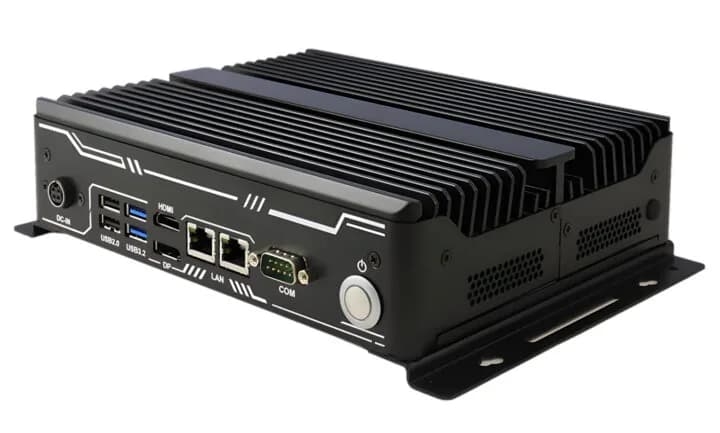
El equipo apunta a visión de máquina, inspección autónoma y automatización industrial en espacios reducidos, con salidas de 8K y conectividad celular opcional.
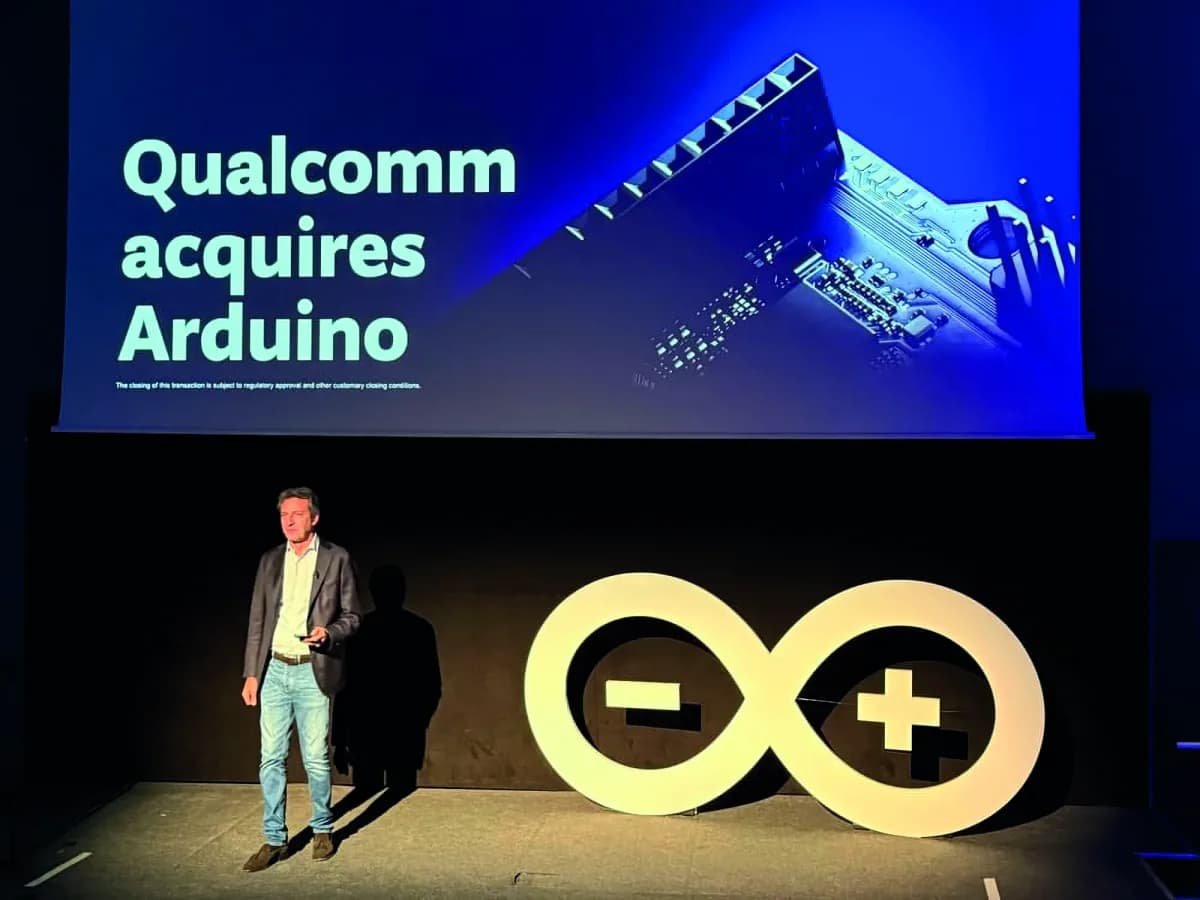
La placa combina un procesador Qualcomm con Linux y un microcontrolador STM32 con Zephyr, y mantiene el formato clásico del UNO para seguir usando los shields de siempre.
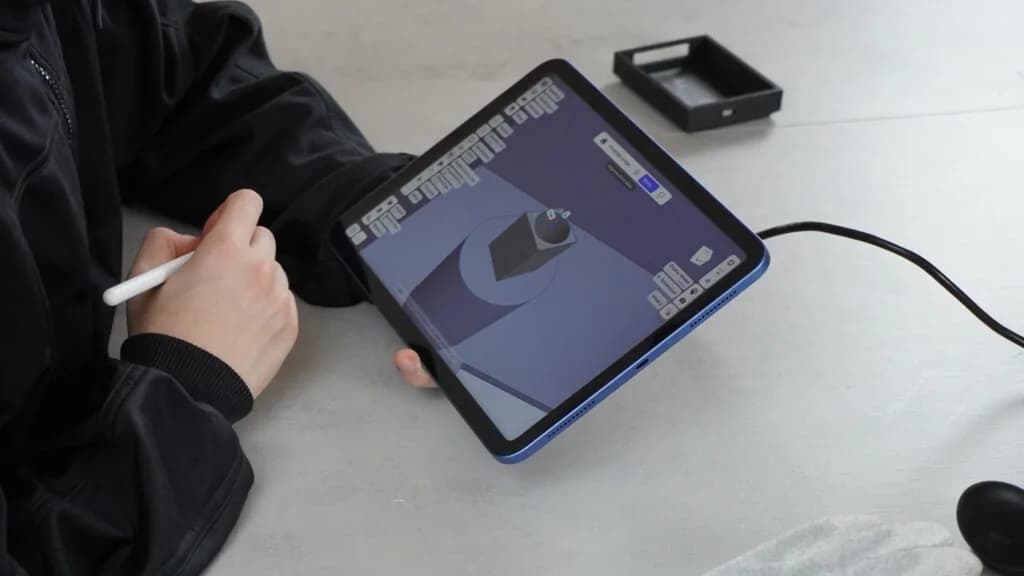
El equipo italiano Blue Proton Initiative lleva cuatro meses construyendo un sistema de visión por computadora que corre localmente sobre una placa Arduino UNO Q.
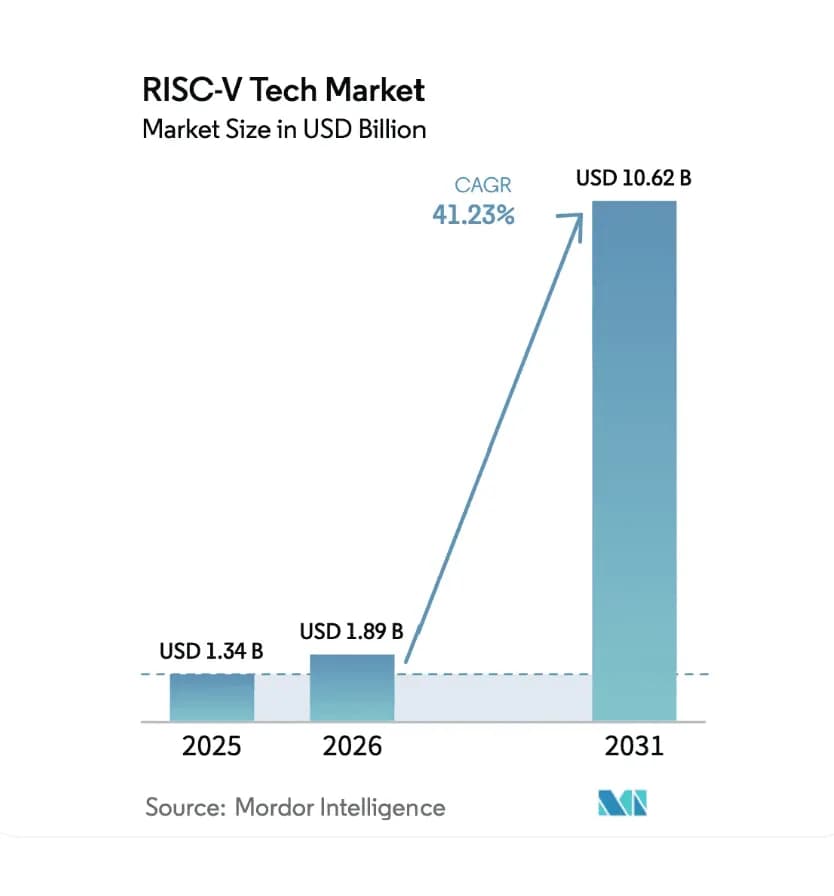
Las instrucciones a medida son la mayor ventaja de la arquitectura abierta y también su mayor riesgo, porque cada núcleo que agrega las suyas se aleja de la compatibilidad con el resto.
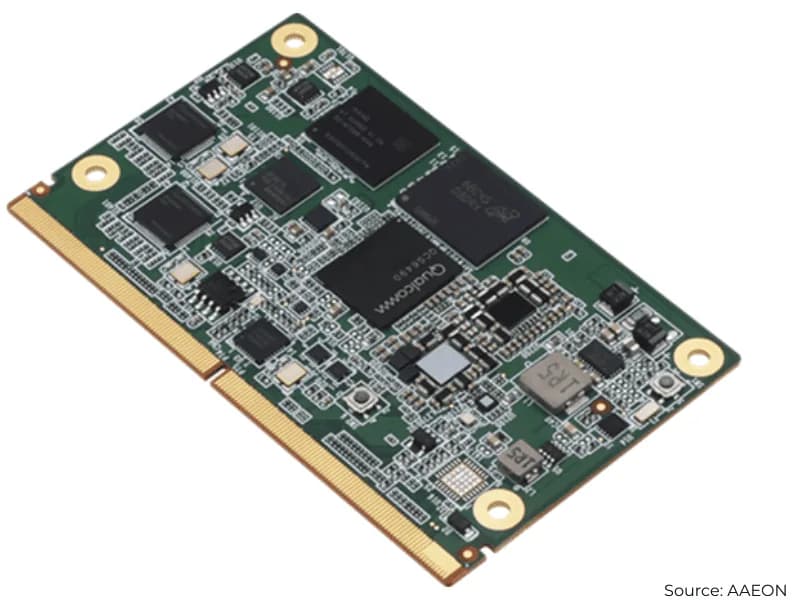
El uCOM-Q6490 combina el procesador Dragonwing QCS6490 con un formato SMARC 2.1 de 82 por 50 milímetros, apuntando a robótica, salud y automatización industrial.
La placa de BrainChip y Neuromorphyx usa el factor de forma Arduino Nicla e integra un monitor de corriente de dos canales para medir el consumo de cada inferencia.
La primera memoria de bajo consumo con lógica integrada multiplica por ocho el ancho de banda y rinde 3,01 veces más tokens por segundo en inferencia.
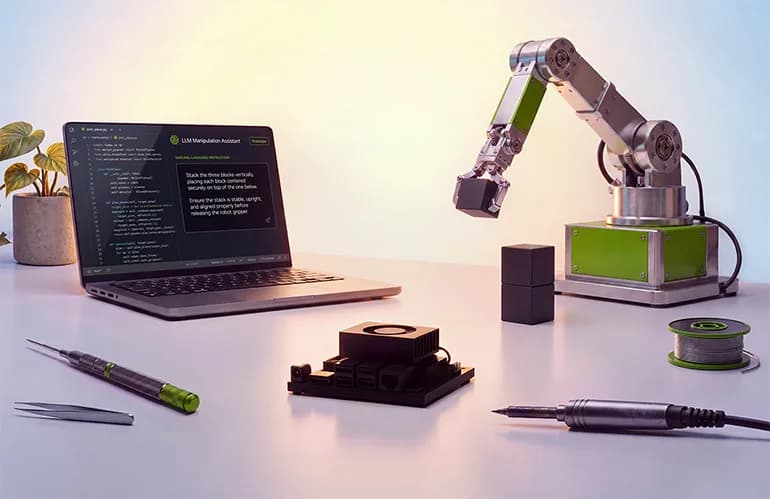
NVIDIA presentó su nuevo computador de entrada para IA de borde, que duplica el rendimiento del Orin Nano Super y consume 40% menos en modo de 15 watts.
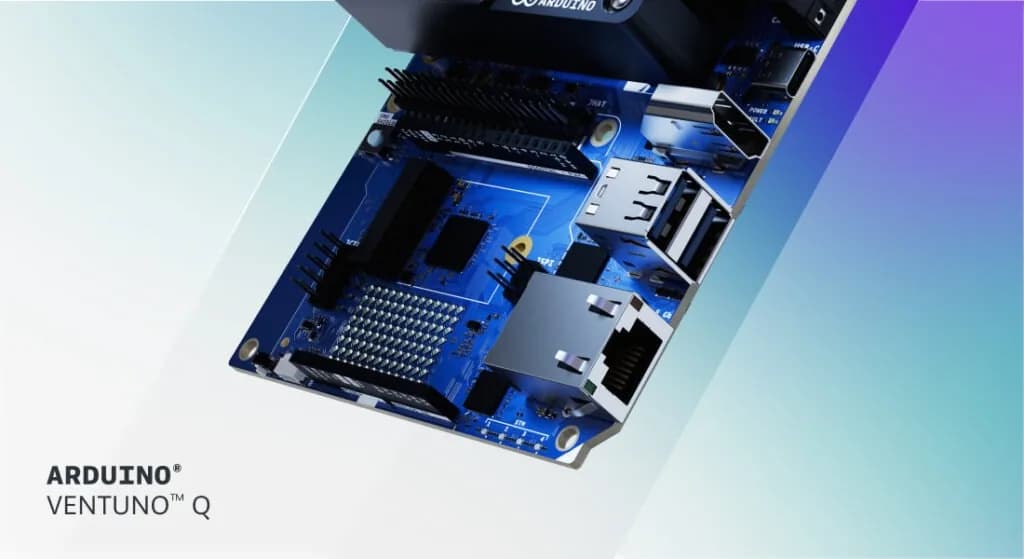
La plataforma más avanzada de Arduino combina un Qualcomm Dragonwing IQ8 con un microcontrolador de tiempo real, corre modelos locales sin conexión y abre preventa con accesorios incluidos.
Los equipos AIE-VN34/44 y AIE-VO24/34 usan módulos NVIDIA Jetson Orin, funcionan sin ventilador entre 25 grados bajo cero y 55 sobre cero, y ya están certificados para uso vehicular.
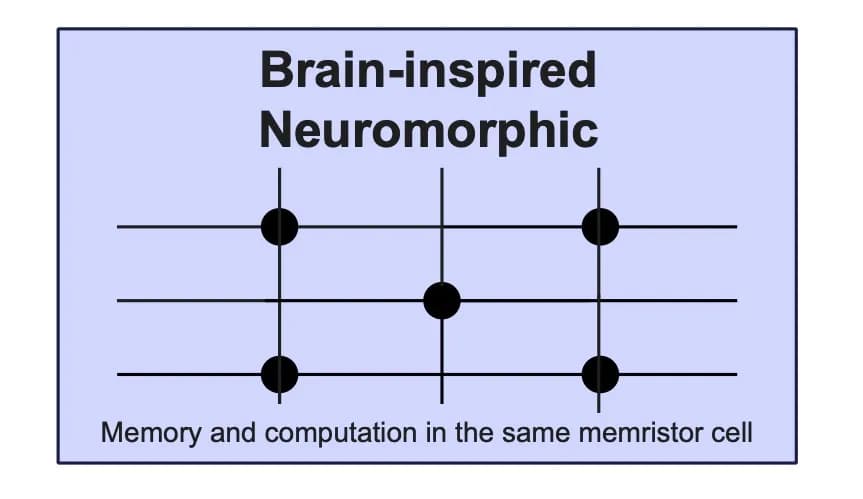
La arquitectura que hace eficientes a estos chips, con la memoria y el cómputo fusionados, también genera superficies de ataque que las protecciones convencionales no cubren del todo.
El modelo de 4.000 millones de parametros cabe en un Jetson Thor y genera acciones sin depender de una GPU de centro de datos.
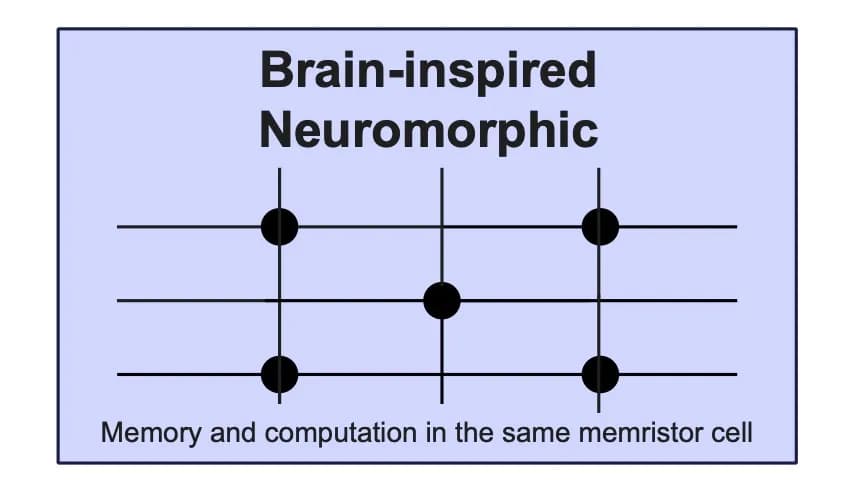
Fusionar memoria y cómputo elimina el cuello de botella de von Neumann, pero abre la puerta a ataques de canal lateral, inyección de fallas y troyanos de hardware en sistemas embebidos.
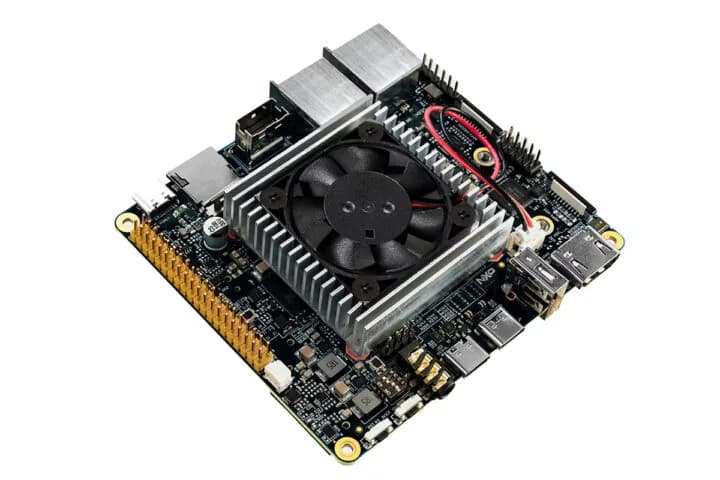
La primera placa de desarrollo que usa el encapsulado grande de 19x19 mm del i.MX 95 suma 16 GB de LPDDR5-6400, Ethernet de 10 Gbps y dos ranuras para aceleradores de IA. Cuesta 300 dólares.
El modelo denso de pesos abiertos con contexto de 120K tokens corre completo en una sola GPU NVIDIA y apunta a agentes que trabajan sin salir del equipo.
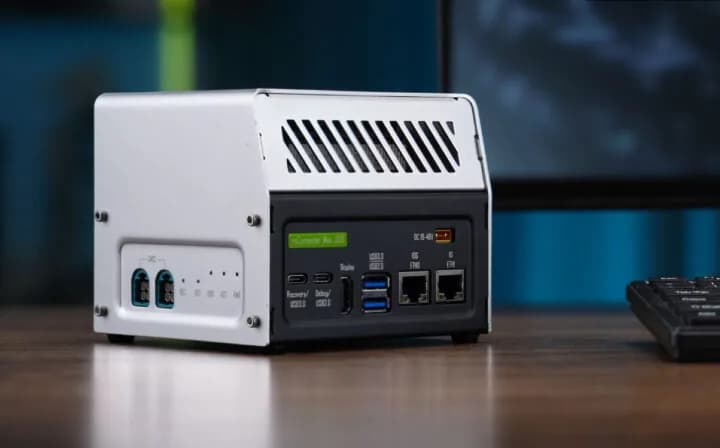
El computador de borde de Seeed Studio llega con módulo Jetson AGX Orin de 32 o 64 GB, hasta 275 TOPS, red 10GbE y dos conectores FAKRA para ocho cámaras automotrices.
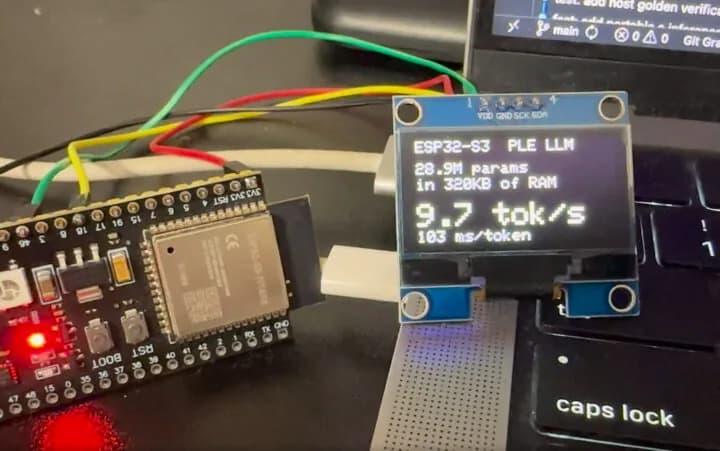
El desarrollador Slava S. logró que un modelo de lenguaje completo se ejecute sin conexión en una placa de unos 8 dólares, apoyándose en la técnica de embeddings por capa de Google.
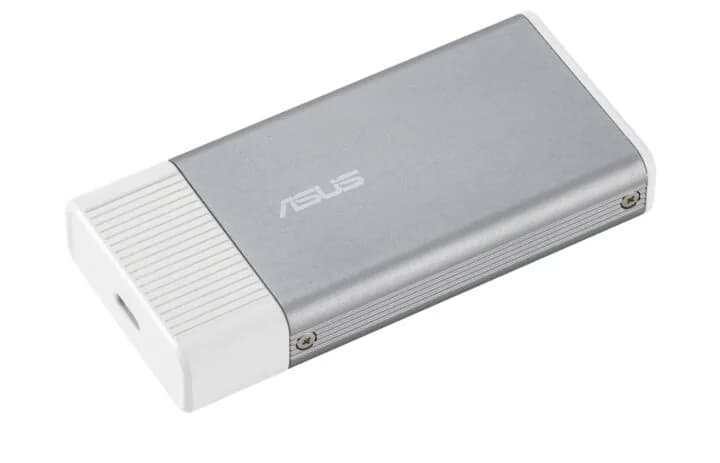
El dongle monta un chip Hailo-10H con 8 GB de LPDDR4 propios, consume 2,5 watts y ofrece por USB-C la misma potencia de inferencia que el Raspberry Pi AI HAT+ 2 entrega por PCIe.
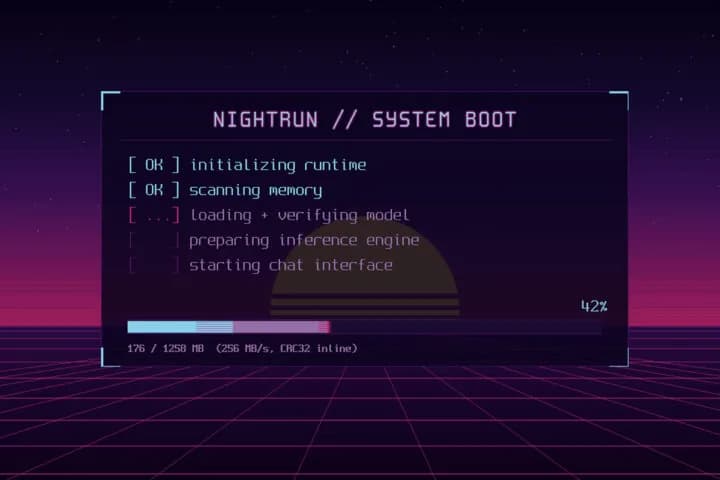
El proyecto experimental de código abierto arranca directo a un modelo cuantizado desde un USB o microSD, sin cargar Linux, para liberar toda la RAM a la inferencia.
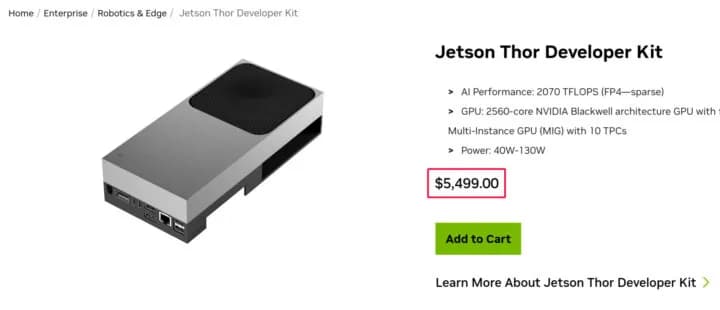
El aumento va de 33% a 101% y afecta a todos los módulos y kits de desarrollo, desde el Jetson Nano hasta el AGX Thor, que ahora cuesta 5.499 dólares.
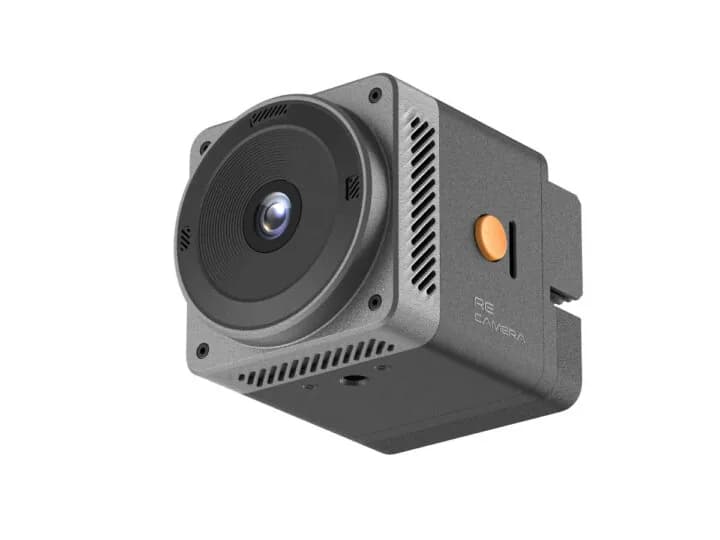
La camara modular de Seeed Studio usa un SoC Rockchip RV1126B con NPU de 3 TOPS para ejecutar vision por computadora, modelos de lenguaje, VLM y voz directamente en el dispositivo, sin nube.
Los nuevos módulos Thor son la mitad de tamaño que los T4000 y T5000, entregan hasta 865 TFLOPS FP4 y llegan en el primer trimestre de 2027 para robótica y cómputo en el borde.
Los nuevos módulos basados en la arquitectura Thor llevan supercómputo de IA compacto a robots humanoides y máquinas autónomas, con rangos que van de 70 TOPS a 2.000 teraflops.
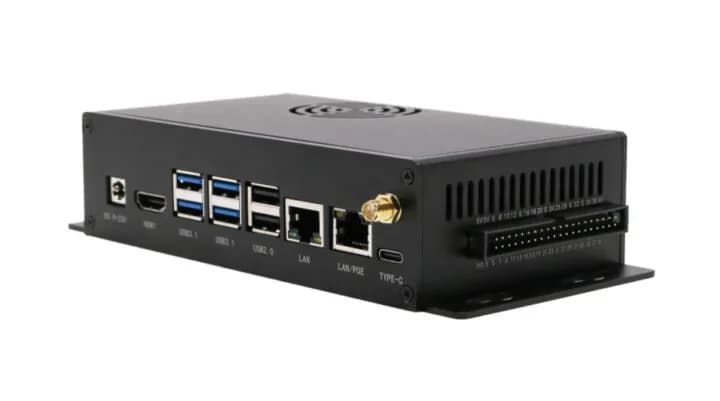
El computador embebido usa módulos Jetson Orin Nano 4GB/8GB o Jetson Orin NX 8GB/16GB, ofrece PoE, CAN Bus y opera entre -25 y 80 °C.
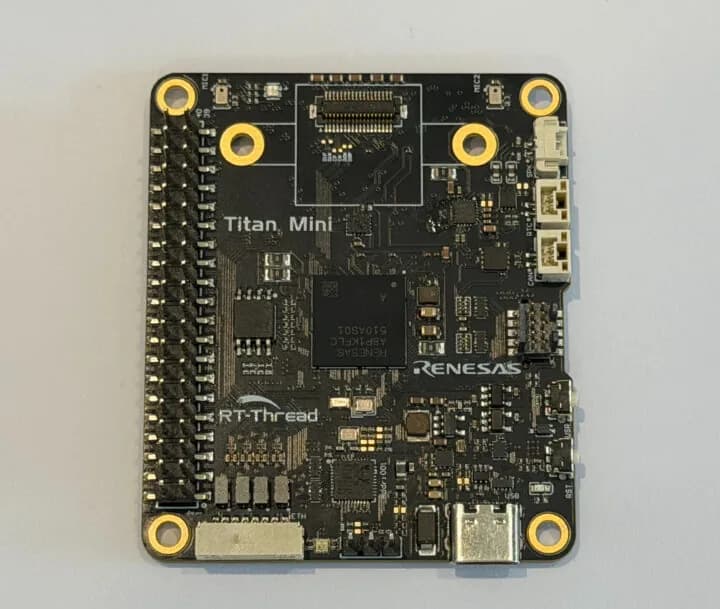
Renesas RA8P1 en placa reducida para RT-Thread y AIoT, con 32 MB de SDRAM, 256 GOPS de NPU y micrófono/parlante integrados, aunque baja la RAM y pierde el RJ45 respecto de la Titan original.
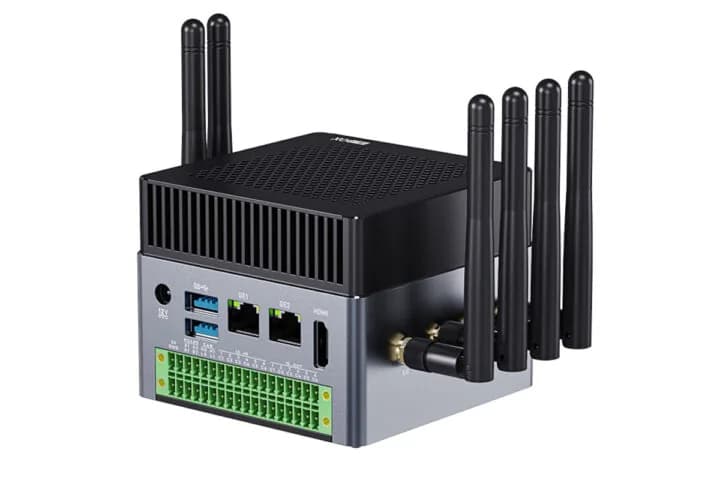
Edge AI box industrial con Hexagon NPU, ocho cámaras GMSL2 y rango térmico -40 a 85 °C, corre DeepSeek-R1, Llama y Qwen on-device sin enviar datos a la nube.
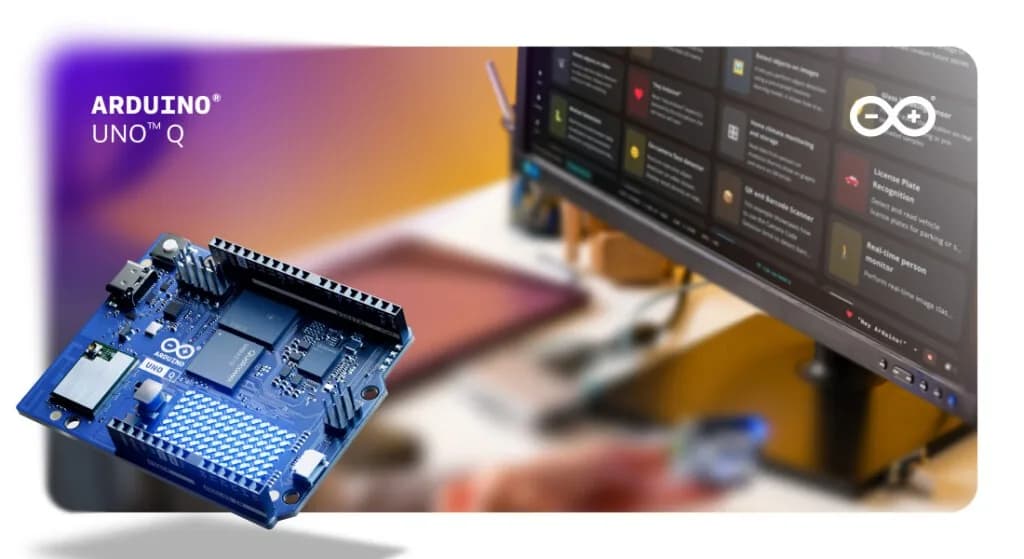
La placa combina Debian Linux con el ecosistema Arduino y ejecuta un Llama 3.2 1B cuantizado a 4 bits con unos 600 a 700 MB en disco y 1 GB de RAM al inferir.
El nuevo SoC de Synaptics integra procesador Cortex-M52, NPU Ethos-U55 y conectividad avanzada para optimizar dispositivos IoT en el borde.
El nuevo motor DNN acelera modelos como Qwen 2.5 y Gemma 3 con backends nativos en Intel, Arm, Qualcomm y RISC-V, y supera por hasta 36% al ONNX Runtime en benchmarks.
Otros temas que aparecen junto a #edge ai en nuestra cobertura editorial.