AMD contó cómo funciona MEXT, el motor predictivo de memoria que adquirió en junio, y qué resultados le da en sus propios servidores. La promesa es que un servidor rinda casi como si tuviera toda su DRAM instalada usando apenas una parte de los módulos físicos. Según Tom's Hardware, MEXT dice entregar hasta 99% del rendimiento de un sistema con la memoria completa usando apenas el 25% de los DIMM.
El truco consiste en mover las páginas de memoria que nadie está usando a almacenamiento flash, que es mucho más barato, y servirlas de vuelta con un modelo de IA antes de que el sistema las necesite. AMD planea extender la tecnología a buena parte de su infraestructura el próximo año.
La propuesta suena demasiado buena. De acuerdo con AMD y con Gary Smerdon, fundador de MEXT, la tecnología reduce entre 20% y 75% la DRAM física que necesita un servidor, según la aplicación y el rendimiento que se busque. La memoria que falta sigue apareciendo como DRAM instalada ante el sistema operativo. En algunas cargas internas de AMD, como Synopsys PrimeTime, la empresa dice lograr 95% del rendimiento de un servidor completo con el 50% de la DRAM.
¿Dónde corre hoy MEXT?
AMD tiene MEXT funcionando en 145 servidores propios y espera llegar a 2.000 el próximo año. También anunció una alianza con HPE para ofrecerlo a clientes.
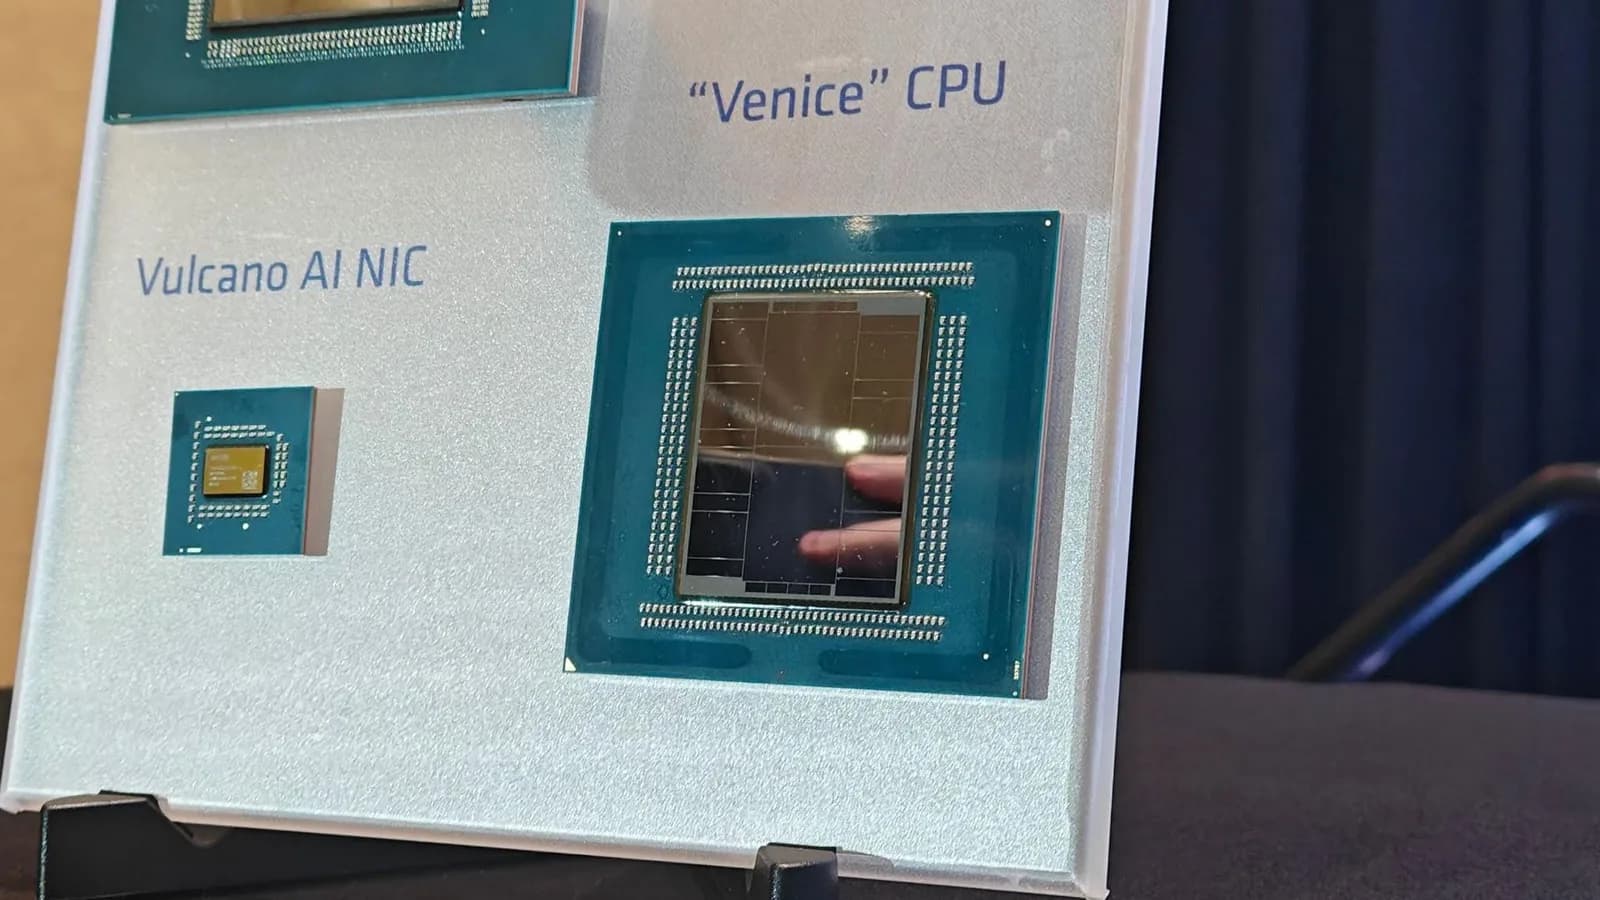
El despliegue está en su fase 1. Algunos servidores EPYC Venice llevan una insignia "MEXT Ready" y una unidad o bahía NVMe dedicada a recibir las páginas descargadas. La fase 2 traerá las licencias de MEXT a esos servidores junto con la aplicación RAM View. AMD no dijo cuándo empieza esa segunda fase.
El alza del precio de la DRAM empujada por la IA golpea a algo más que los PC para juegos. Las empresas también pagan más, aunque no corran cargas de IA. Si MEXT cumple lo que AMD promete, el efecto en el mercado actual sería grande, y por eso vale la pena entender qué es y qué dice la empresa que logra.
AMD está desplegando la tecnología con cautela. Hoy sus usos son acotados, aunque la empresa dice que está sumando cargas de trabajo con buenos resultados iniciales.
DRAM, flash y un modelo de lenguaje
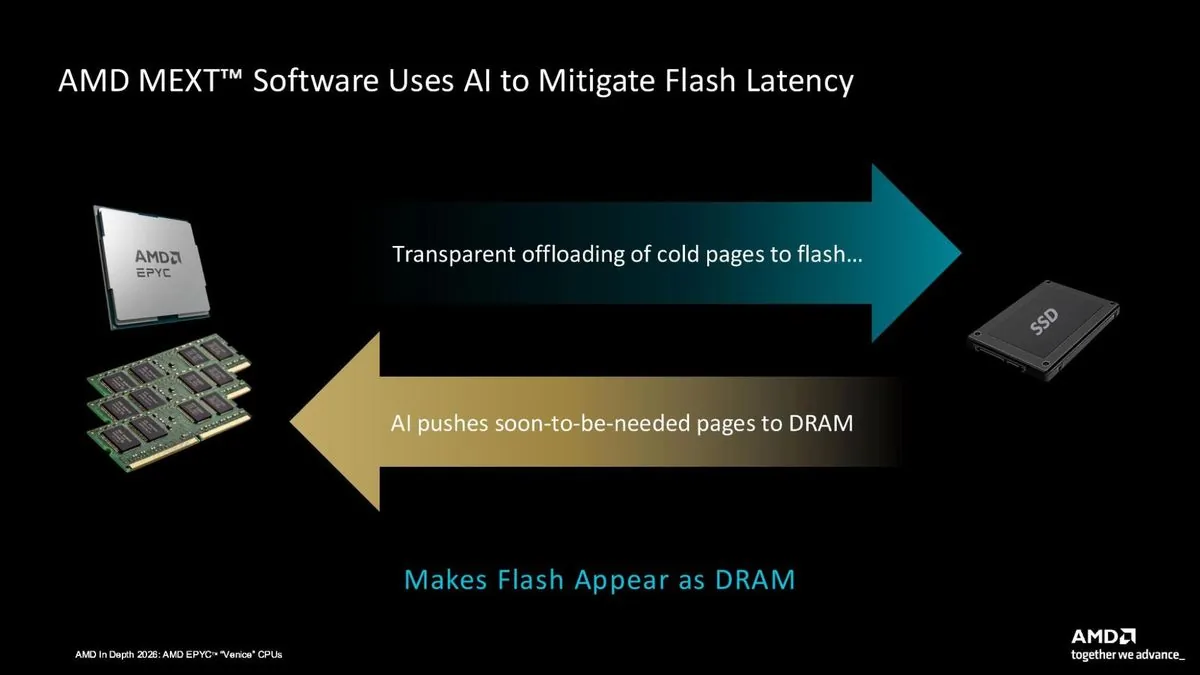
La idea de MEXT es simple. Las páginas frías van a flash, la IA las trae de vuelta cuando hacen falta y el sistema funciona como si la memoria nunca hubiera faltado. El problema también es evidente. La flash es varios órdenes de magnitud más lenta que la DRAM, así que traer páginas desde la unidad recién cuando se piden no sirve.
Lo que hace MEXT es usar un modelo de IA para predecir qué páginas se van a necesitar. Mientras el modelo se adelante al menos por el tiempo que tarda la transferencia desde el SSD, el resultado es el mismo que tener la DRAM física instalada.
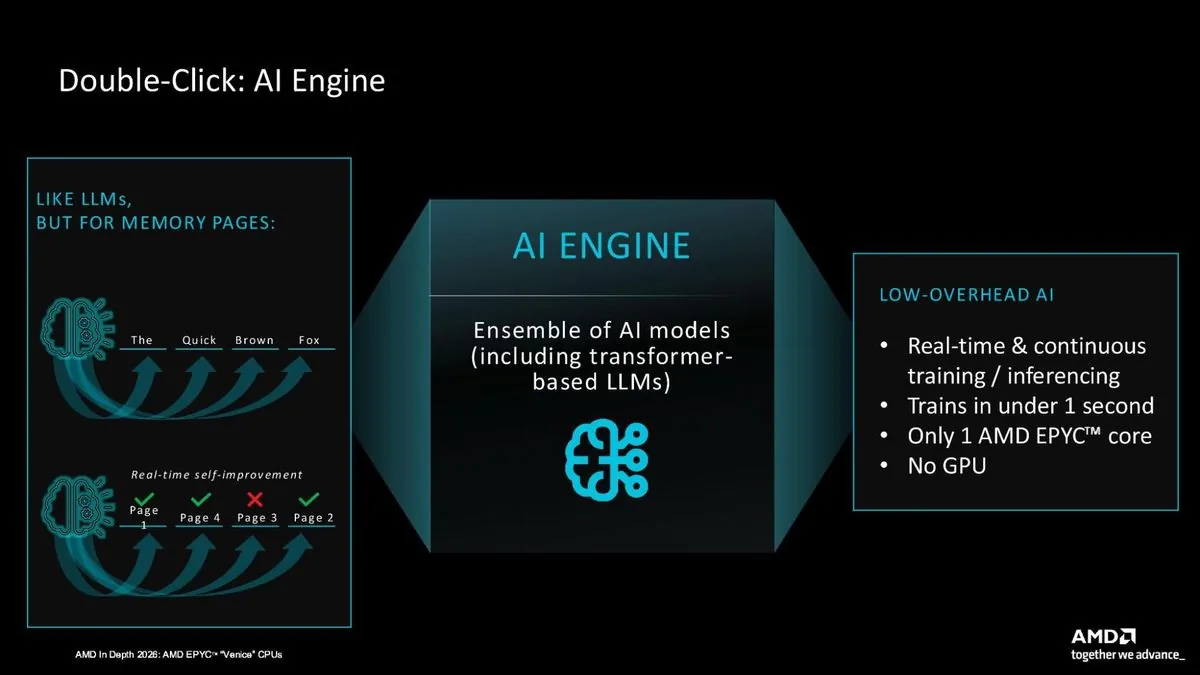
El concepto calza con cómo opera un modelo de lenguaje basado en transformers, que es lo que usa MEXT. La base de esos modelos es predecir el siguiente token. Dado un conjunto de tokens, el modelo calcula cuál es el más probable que venga después. En MEXT lo que se predice es la próxima página de memoria, no la próxima palabra.
La descarga de memoria a flash existe hace años. Para Smerdon, la diferencia la pone la IA. MEXT se instala como un módulo del kernel de Linux que funciona con cualquier distribución. Usa un "conjunto de modelos de IA", con un modelo de lenguaje basado en transformers como motor principal, y no viene entrenado de fábrica.
Según AMD, MEXT se entrena en menos de un segundo al instalarse, corre sobre un solo núcleo EPYC sin GPU y sigue entrenando mientras avanza la carga de trabajo. Así aprende los patrones de acceso de cada aplicación, que varían mucho de un servidor a otro.
MEXT tampoco necesita acertar siempre. El orden en que llegan las páginas da lo mismo. Un modelo de texto tiene que predecir las palabras correctas en el orden correcto, pero acá basta con que la página esté en la DRAM cuando se la pide.
RAM View y el muro de memoria
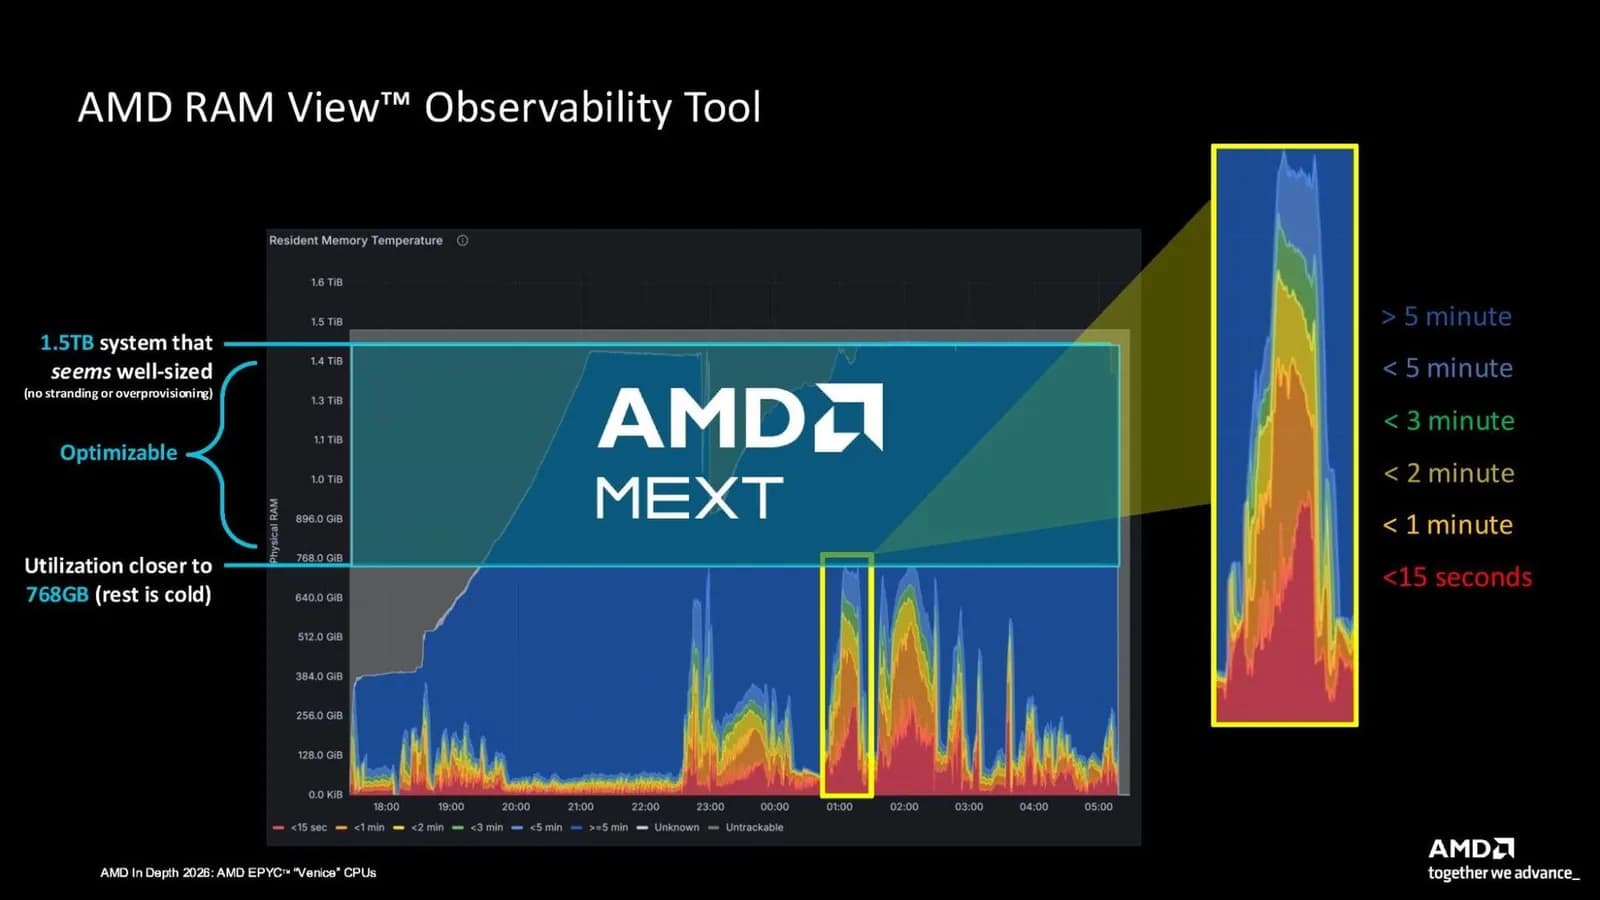
Para estudiar cada carga, AMD desarrolló RAM View, una herramienta que muestra qué páginas están calientes y cuáles se enfriaron. En el ejemplo que mostró la empresa, un sistema con 1,5 TB de memoria aparece casi lleno durante toda la carga, pero cerca de la mitad de las páginas guardadas no se habían tocado en cinco minutos o más.
AMD no aclaró qué carga usó en ese ejemplo, y eso importa, porque el reparto entre páginas frías y calientes cambia mucho según la aplicación. Por ahora la empresa aplica MEXT a programas de diseño electrónico (EDA) que usa internamente, como Synopsys PrimeTime. Dice que también trabaja en cargas de IA agéntica, bases de datos, y medios y entretenimiento.
Las cargas no solo usan la memoria de forma distinta. También reaccionan distinto cuando al sistema le falta memoria. AMD lo llama el "muro de memoria", y con MEXT busca correrlo más lejos, lo que se ve diferente en cada aplicación.
La empresa confía en que muchas cargas pueden recortar entre 20% y 25% de su capacidad. Mientras más grande el recorte, más específicas son las aplicaciones que lo toleran y más cae el rendimiento.
¿Qué resultados muestra AMD?
Son pruebas internas de AMD, y conviene leer con cuidado cualquier benchmark que publica el propio fabricante.
| Carga | DRAM al 50% | DRAM al 25% |
|---|---|---|
| Synopsys PrimeTime | 95% del rendimiento | 80% del rendimiento |
| Spark SQL de TPC-DS, clúster de 3 nodos en Azure con EPYC de 5.ª generación | 99% del rendimiento | sin dato |
| Cinco agentes de IA en paralelo, media geométrica | 99% del rendimiento | 85% del rendimiento |
| Un agente que consume mucha memoria | 90% del rendimiento | 88% del rendimiento |
PrimeTime exige mucha memoria en diseños grandes. En las bases de datos SQL el caso es favorable para MEXT, porque intentan guardar en memoria todos los datos que pueden para evitar cuellos de botella de entrada y salida, y eso deja muchas páginas frías que liberar.
La diapositiva de los resultados trae notas al pie, pero AMD todavía no se las entregó a Tom's Hardware, así que no se sabe cómo se corrieron las pruebas. El medio da por hecho que AMD mostró a MEXT en las mejores condiciones posibles.
Una licencia solo para EPYC, sin fecha
MEXT es por ahora exclusivo de los procesadores EPYC. AMD dejó abierta la puerta a llevarlo a otros productos, incluidos equipos de consumo como Strix Halo, pero en un plazo lejano. Se venderá como licencia junto con RAM View, y no hay calendario. Pese a la alianza con HPE para vender servidores "MEXT Ready", tampoco se sabe cuándo estará lista la tecnología fuera de AMD.
Tom's Hardware ve en ese ritmo una señal de que hay problemas que todavía no se conocen, y considera difícil que funcione en cualquier servidor con el 50% o el 25% de la DRAM que mostró AMD. Aun así, con la oferta de memoria tan apretada, recortar un 25% de la DRAM de un servidor ya es un ahorro grande, y llegar al 50% en algunas cargas sería mejor todavía.