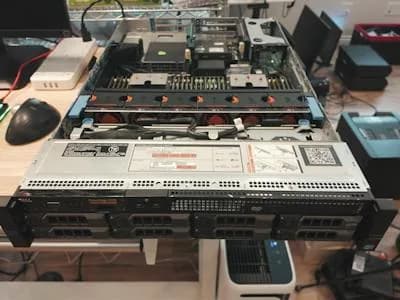
El mayor obstáculo para correr hoy los modelos de IA más grandes de forma local está en la memoria, antes que en la potencia de procesamiento. Las tarjetas gráficas de consumo siguen ganando velocidad, pero su VRAM sigue siendo escasa, lo que obliga a comprar varias tarjetas caras o a conformarse con modelos chicos. El youtuber MattMo se preguntó si un servidor empresarial antiguo, cargado de memoria barata, podía con la tarea, informó Hackster.io.
El equipo que armó está lo más lejos posible de una estación de trabajo moderna de IA. Es un Dell PowerEdge R720, un servidor de rack presentado alrededor de 2012, comprado usado en 250 dólares. En vez de apoyarse en tarjetas gráficas, el sistema entero ejecuta los modelos sobre un par de procesadores Intel Xeon de 10 núcleos, que suman 20 núcleos y 40 hilos.
¿Qué tan viejos son esos procesadores?
Bastante, y se nota. Son anteriores a AVX2, el conjunto de instrucciones vectoriales que muchos entornos modernos de IA usan para acelerar la inferencia, así que los Xeon deben resolver la carga a la fuerza con instrucciones estándar. Suena a desventaja seria, pero la meta de MattMo nunca fue la velocidad. Era tener capacidad de memoria suficiente para correr modelos de primera línea de manera local.
Cada zócalo DIMM del servidor va ocupado con un módulo de 16 GB de DDR3 ECC, lo que deja a la máquina con 384 GB de RAM. Gracias a la abundancia de hardware empresarial de segunda mano, esa montaña de memoria costó cerca de 280 dólares. Un SSD empresarial Samsung guarda el sistema operativo y los enormes archivos de los modelos antes de cargarlos en memoria.
El equipo completo queda entre 500 y 600 dólares, una fracción de lo que costaría armar un sistema con tarjetas gráficas capaz de sostener modelos de más de 200 GB enteros en VRAM.
¿Cuánto demora en responder?
Para medir la utilidad real del montaje, MattMo probó varios modelos de lenguaje grandes usando llama.cpp. A cada uno le pidió generar un programa de ordenamiento en C#.
| Modelo | Tiempo en resolver la tarea |
|---|---|
| GLM 5.3 Flash | 2 minutos y 35 segundos |
| Qwen 3.8 Dense | 6 minutos y 18 segundos |
| Qwen 3.8 8B Flash | 7 minutos y 32 segundos |
El mejor resultado fue el de GLM 5.3 Flash, que trabajó a unos 4 tokens por segundo.
Los modelos corrieron sin problemas, pero el rendimiento fue muy lento. Eso llevó a MattMo a experimentar con modelos de mezcla de expertos. En lugar de activar todos sus parámetros para cada token, como hace un modelo denso, un modelo de este tipo usa solo un subconjunto de sus redes expertas durante la inferencia. Eso reduce mucho el cómputo y el tráfico de memoria necesarios, lo que los hace especialmente adecuados para sistemas antiguos que trabajan solo con procesador.
Para qué sirve un equipo así
De una máquina como la de MattMo no se obtiene nada parecido a una interacción en tiempo real, y aun así resulta útil. El servidor puede correr modelos enormes completamente desconectado, sin suscripciones a la nube ni tarjetas aceleradoras caras. El PowerEdge además conserva ranuras PCIe libres, lo que deja espacio para sumar una tarjeta gráfica más adelante o para descargar parte de las capas en ella si hace falta más rendimiento.