Fable 5.2 lidera el Remote Labor Index (RLI) con un 41,3% de trabajos completados, según la tabla publicada por Scale Labs y el Center for AI Safety (CAIS). El índice mide con qué frecuencia un agente de IA termina un encargo freelance real con la calidad suficiente para que un cliente que paga acepte el resultado. The Decoder informó la cifra el 10 de noviembre de 2026.
El modelo de Anthropic deja atrás a su antecesor directo y al resto de los sistemas evaluados.
Del 2,5% al 41% en un año
Cuando el índice se lanzó, hace cerca de un año, el mejor sistema de entonces era Manus y completaba apenas el 2,5% de las tareas. Fable 5.2 resuelve más de 16 veces esa proporción de trabajos profesionales.
El salto también es grande frente a las mediciones recientes. En julio lideraba Fable 5, un modelo anterior de la misma familia, con cerca de 16%. Ese puntaje ya era un avance importante, porque los mejores agentes habían más que cuadruplicado en ocho meses la proporción de trabajos completados con calidad profesional. Cuatro meses después, Fable 5.2 llega al 41,3%, unas dos veces y media el puntaje de Fable 5 en julio. Su antecesor directo, Fable 5.1, queda bastante atrás con poco menos de 18%, así que Fable 5.2 completa más del doble de trabajos.
¿Cómo queda el resto de la tabla?
Los puestos siguientes de la tabla actual son para Opus 5.5, también de Anthropic, con 21,25%, y para GPT 6 Astra, de OpenAI, con 20,83%. Fable 5.2 rinde casi el doble que los siguientes sistemas del mercado. El modelo más fuerte de Google en la prueba, Gemini Argon 4, queda quinto con 17,08%, mientras que modelos más antiguos como GPT-5.2 o Gemini 3 Pro se quedan bajo el 3%.
| Modelo | Empresa | Trabajos completados en el RLI |
|---|---|---|
| Fable 5.2 | Anthropic | 41,3% |
| Opus 5.5 | Anthropic | 21,25% |
| GPT 6 Astra | OpenAI | 20,83% |
| Fable 5.1 | Anthropic | poco menos de 18% |
| Gemini Argon 4 | 17,08% | |
| Fable 5 (julio de 2026) | Anthropic | cerca de 16% |
| Manus (lanzamiento del índice) | Manus | 2,5% |
Dónde mejora y dónde sigue fallando
Scale Labs informó en X que las mayores mejoras de Fable 5.2 están en la edición de audio y música, el diseño de arquitectura y de interiores, y la creación de modelos 3D. El agente también sacó adelante proyectos largos y complejos en los que los modelos que antes encabezaban la tabla fallaban seguido.
Cerca de 50 de los trabajos que Fable 5.2 completó con éxito no los había resuelto antes ningún agente de IA en la prueba. Scale Labs advierte que todavía hay tareas que el modelo apenas maneja, en especial el diseño industrial de productos y las animaciones. Cuando los agentes fallan, según los investigadores, suelen entregar trabajo de calidad amateur, resultados incompletos, archivos rotos o diseños contradictorios.
¿Qué mide exactamente el Remote Labor Index?
A diferencia de las pruebas de IA convencionales, que muchas veces revisan habilidades aisladas, el paper de investigación del RLI abarca encargos de trabajo completos. El conjunto de datos reúne 240 proyectos terminados por 358 profesionales verificados de la plataforma Upwork, y en total esos trabajos valen cerca de 144.000 dólares.
Cada proyecto cuesta en promedio 632,60 dólares y a un freelance humano le toma en promedio poco menos de 29 horas. Las tareas van desde edición de video hasta diseño CAD, desarrollo de videojuegos y análisis de datos. Para trabajar en ellas, los agentes reciben un espacio de trabajo virtual con software profesional habitual como Blender, GIMP o Audacity, además de herramientas de IA especializadas en generar imágenes, audio y video.
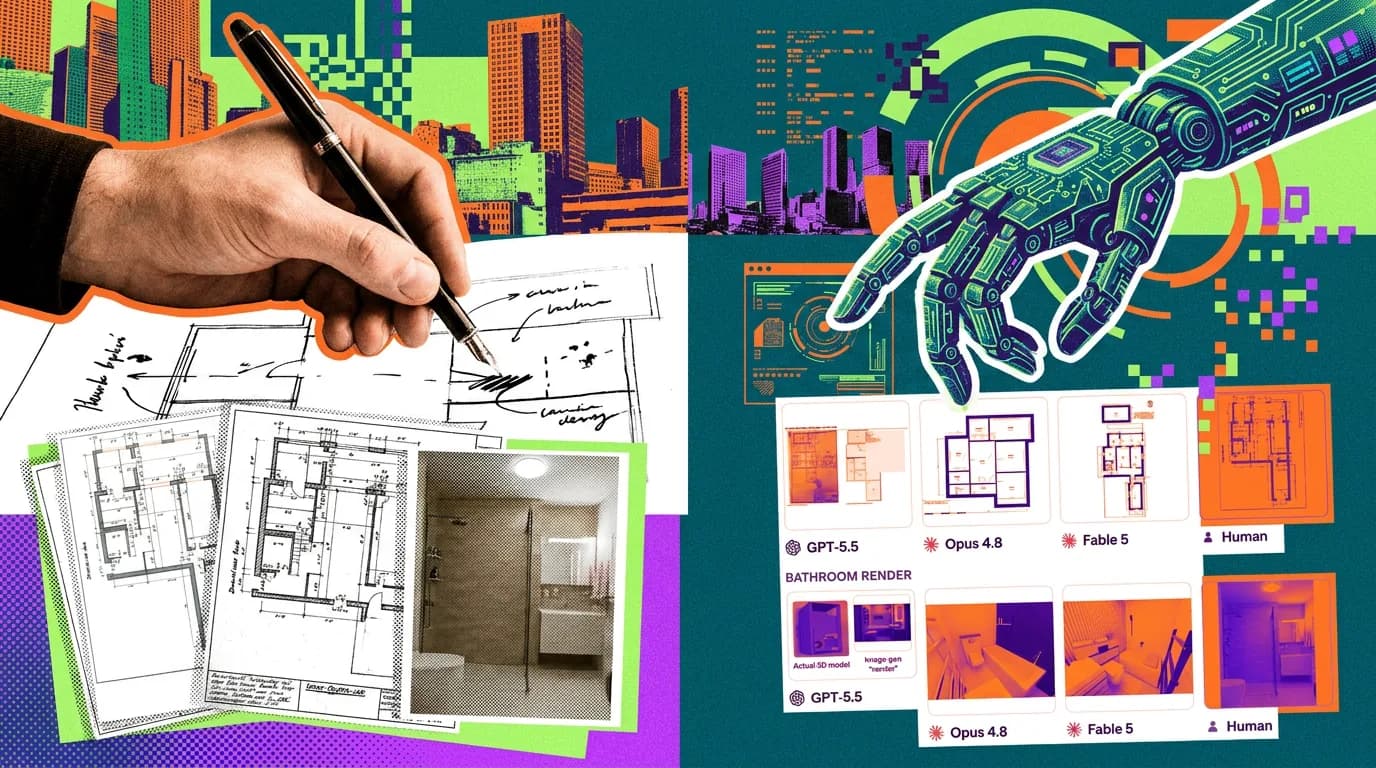
Un ejemplo de tarea consiste en hacer el plano de una planta, proponer opciones de amoblado y entregar renders fotorrealistas de un baño.
Expertos humanos capacitados revisan a mano si cada agente completó el trabajo. Abren los archivos entregados en el software profesional correspondiente y comparan el resultado de la IA con lo que entregó el freelance humano. CAIS intentó automatizar esa revisión con otra IA y hasta ahora no lo ha logrado. Los revisores de IA casi no saben operar el software profesional, así que se dejan engañar por entregas que se ven pulidas por fuera pero tienen fallas técnicas, y califican a los modelos con demasiada generosidad.