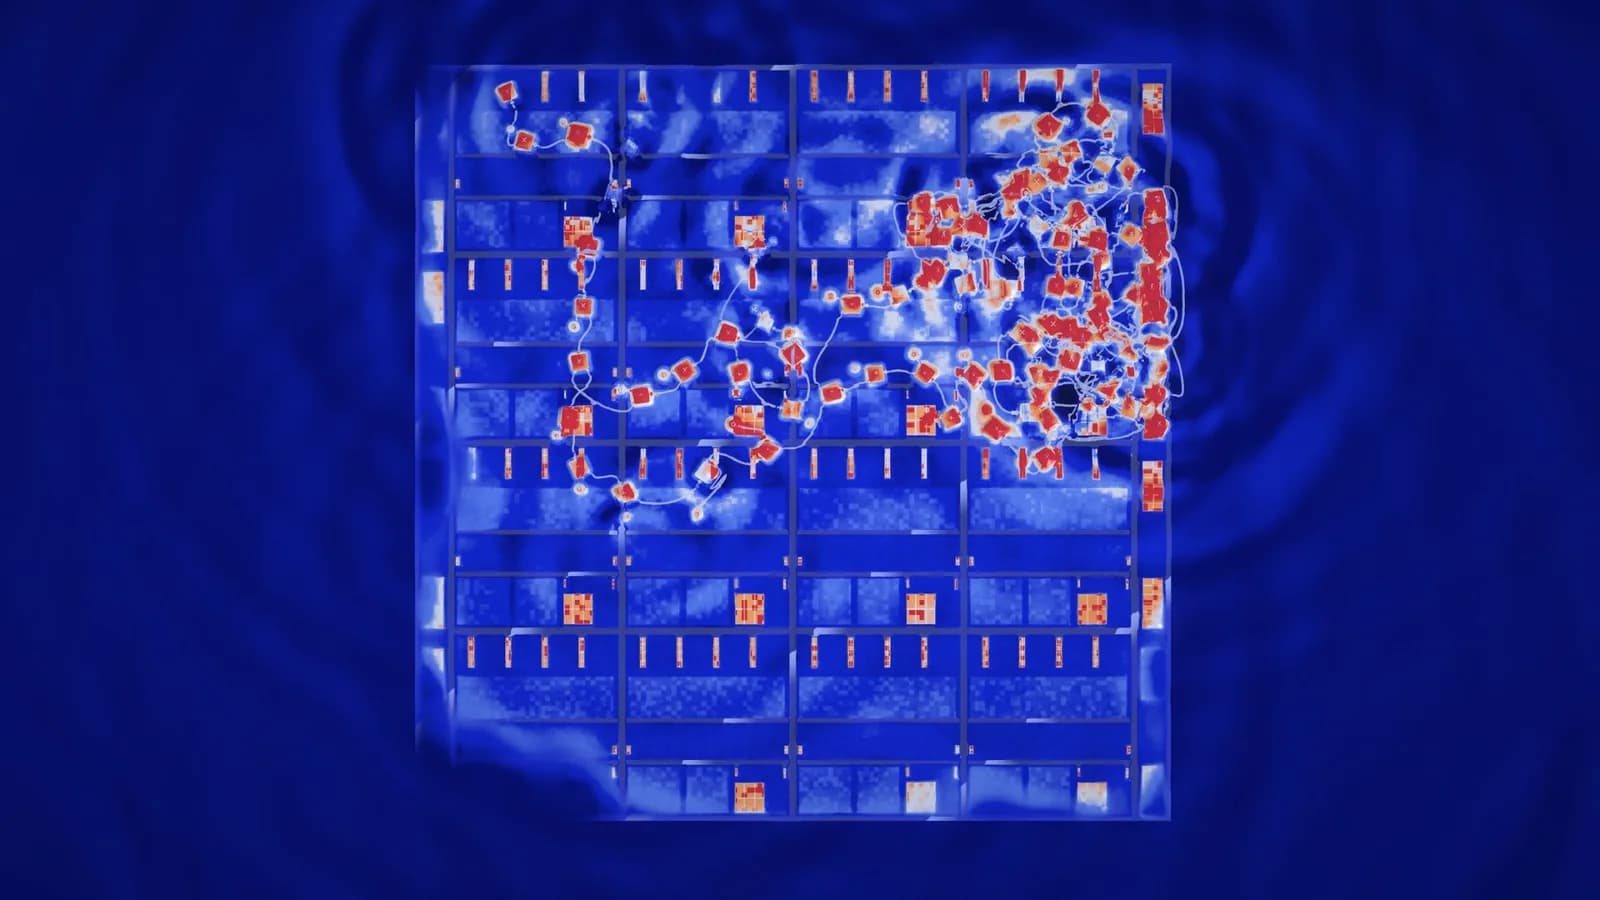
Architect Labs, una startup de Palo Alto, afirmó en una publicación de investigación que sus sistemas de IA descubrieron, diseñaron y verificaron Frostbite, una CPU de propósito general con un conjunto de instrucciones nuevo "construido desde cero". En 25 cargas de trabajo, un clúster de cuatro tiles de Frostbite entregó 4,59 veces el rendimiento por watt de un núcleo de tamaño parecido, de doble emisión y en orden, "probado en silicio".
Esas cifras salen de un diseño simulado en 7 nm que todavía no se fabrica, informó Tom's Hardware el 22 de noviembre. La empresa dice que no puede nombrar el núcleo de comparación por razones legales.
¿Qué cambia frente a una CPU convencional?
Las CPU convencionales tienen hardware que "redescubre, en tiempo de ejecución, qué instrucciones dependen realmente unas de otras". Los diseños multinúcleo además necesitan jerarquías profundas de caché y protocolos de coherencia, que mantienen consistente la vista que cada núcleo tiene de la memoria compartida, pero escalan mal y cuestan área y energía.
La alternativa de Architect Labs es lo que llama "multithreading gratis". El propio programa expone el trabajo paralelo, sin hilos, sin bloqueos y sin el hardware fuera de orden que hace falta para descubrirlo.
Los programas de Frostbite se compilan a redes de interacción (interaction nets), un modelo de cómputo de 1990 en el que un programa es un grafo de nodos y el cálculo ocurre reescribiendo pares de nodos conectados. El chip está diseñado alrededor de ese paradigma. Los pares que se reescriben nunca se superponen, así que pueden correr en cualquier orden, o todos a la vez, y llegar al mismo resultado. Cada valor se usa exactamente una vez, de modo que los datos pueden quedarse en memorias locales pequeñas en vez de grandes cachés compartidas.
El equipo da un ejemplo con un tablero de 5×5 al estilo del ajedrez, con cinco reinas ubicadas de modo que ninguna pueda atacar a otra. Un programa típico busca soluciones tablero por tablero. Como red de interacción, la misma búsqueda se divide en 3.183 operaciones pequeñas, y la cadena más larga que debe correr en orden tiene solo 262 pasos. En promedio, unas 12 operaciones quedan listas para correr a la vez en cada paso. El programa no se reescribió para llegar ahí, porque el paralelismo ya estaba en él.
Tiles, frecuencia y rendimiento por carga
Cada tile del chip es una unidad de procesamiento pequeña e idéntica, conectada a las demás por una red en el chip, y tiene su propia memoria local. Cuatro tiles más cuatro nodos L3 forman el clúster que se comparó contra el núcleo convencional, aunque el diseño completo tiene 16 tiles. El diseño alcanzó 800 MHz en la síntesis temprana y quedó en 500 MHz en el layout final. El clúster promedió además 8,77 veces el rendimiento por área del núcleo de comparación.
| Cargas de trabajo | Rendimiento por watt de Frostbite frente al núcleo de comparación |
|---|---|
| Las 25 (media geométrica) | 4,59x |
| 10 usadas para ajustar el diseño | 6,02x |
| 15 reservadas hasta la evaluación final | 3,83x |
| Mejor caso, conv2d (reservada) | 23,12x |
| Peor caso, Fibonacci recursivo (reservada) | 1,15x |
¿Cómo trabajaron los agentes?
La IA que construyó Frostbite partió con lo que la empresa llama "cero supuestos de arquitectura", aunque el equipo eligió primero las cargas en las que debía rendir bien. Los agentes leyeron papers y benchmarks, construyeron modelos en Python y luego eligieron un concepto en el cual concentrarse.
El primer resultado fue un PDF de 141 páginas con un modelo de programación, un runtime y bloques de alto nivel. Se borró después de generar el primer diseño RTL (register-transfer level), porque "muchas de las cifras y estimaciones estaban muy lejos de lo físicamente posible".
Ese PDF fue solo un punto de partida. Cuando los agentes eligieron una arquitectura, dejaron el inglés, que según el equipo no logra fijar cada detalle ni atrapar cada error, y escribieron la especificación en un lenguaje propio de la empresa llamado ASL. ASL se traduce a Lean, un verificador de demostraciones, así que la especificación se puede revisar por máquina. La empresa dice que eso evita una clase amplia de errores y reduce los casos en que los agentes hacen trampa con sus objetivos. A partir de ahí, los agentes armaron Arcmodel, un modelo de software del chip completo escrito en ASL, antes de que existiera cualquier diseño de circuito.
Simular el RTL es lento, así que los agentes probaron las ideas en el modelo, que corría unas 200 veces más rápido. Al principio, las estimaciones de consumo del modelo erraban hasta en casi 250%. Un ciclo automático lo fue ajustando hasta que coincidió con el diseño del circuito con un margen de apenas 5%.
Desde ese punto, enjambres de agentes propusieron cambios en paralelo. Cada uno se comparó contra la especificación, se probó en el modelo rápido, se llevó al diseño del circuito y se midió en consumo antes de conservarlo o descartarlo. Se probaron 58 ideas y se quedaron 37. Por separado apareció un comportamiento que "ningún humano especificó nunca", conocido como robo de trabajo (work stealing). Un tile sin tareas puede tomar trabajo pendiente de un vecino o, si no hay nada que hacer, quedar inactivo para ahorrar energía.
Adónde se va la energía
| Reparto de la energía (un clúster de cuatro tiles, media de 20 cargas) | Núcleo de comparación | Frostbite |
|---|---|---|
| Memoria | 57% | 38% |
| Búsqueda, decodificación y emisión de instrucciones | 27% | 6% |
| Red en el chip y planificador | Sin desglose | 26% |
| Distribución del reloj (porcentaje del total, fuera de las filas anteriores) | 49% | 41% |
Redwood y la competencia
No es el primer diseño de Architect Labs. En agosto mostró Redwood, un acelerador de inferencia de IA para robots y drones. En ese caso, la empresa dice que su IA generó el RTL, la verificación, el firmware, los drivers y los kernels en menos de dos semanas, a partir de una especificación escrita por dos arquitectos humanos. Redwood todavía corre solo en una FPGA y no se ha fabricado, aunque la empresa dice que trabaja para producirlo en TSMC.
Tendrils Compute, un posible rival con sede en Cambridge, Reino Unido, levantó financiamiento a comienzos de este mes para un procesador que, según dice, tendrá "miles de núcleos operando en paralelo". También desarrolla Vine, el mismo lenguaje en que están escritos los programas de Frostbite.
Lo que viene
Architect Labs dice que vienen más benchmarks. También quiere un "espacio de pruebas de software para que cualquiera corra un programa en Frostbite", alojado en una FPGA, junto con un "sistema operativo preliminar". Más adelante planea liberar el RTL y el conjunto de instrucciones de Frostbite.
Mientras tanto, la empresa ampliará las cargas de trabajo y comparará contra "un conjunto más amplio de CPU", incluidas configuraciones de malla más grandes de Frostbite frente a versiones multinúcleo del núcleo de comparación con cachés grandes. También probará contra "CPU más grandes, más anchas y fuera de orden", con resultados en suites conocidas como SPEC y PARSEC en los próximos meses.