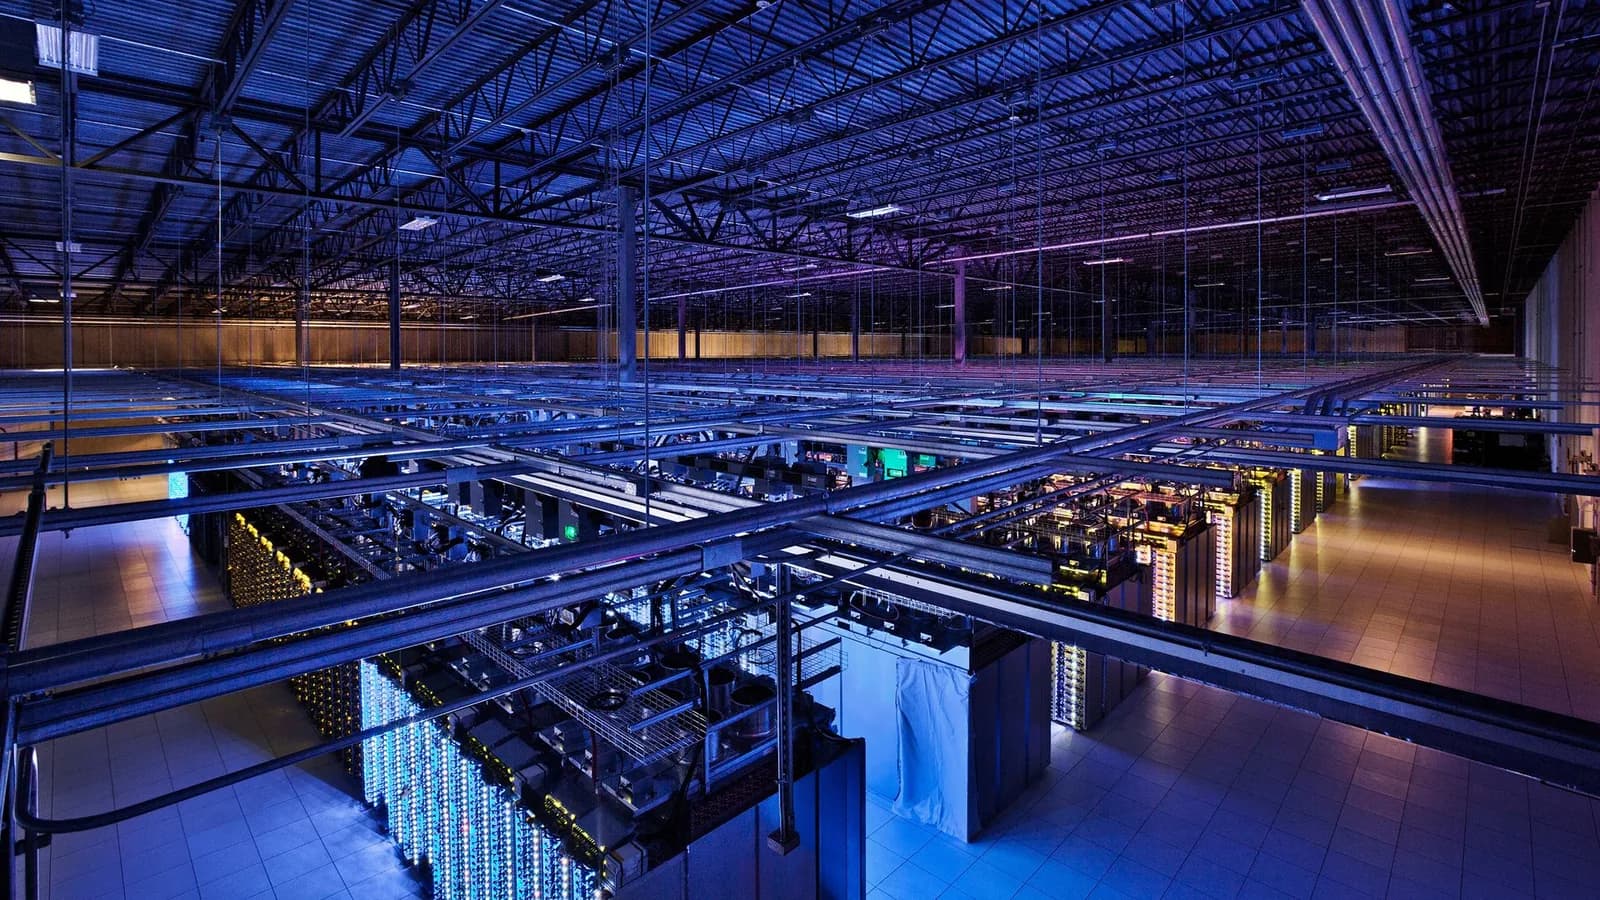
El crecimiento de los clústeres de IA está superando los límites físicos y eléctricos de un centro de datos individual. Eso abre la demanda por arquitecturas de red capaces de conectar recursos de cómputo entre varios recintos, e incluso entre regiones distintas, informó Tom's Hardware el 20 de noviembre.
En la conferencia Supercomputing 2026 (SC26), investigadores de la Universidad Estatal de Ohio repasaron la evolución de las redes de alto rendimiento. Explicaron que la computación distribuida eficiente a esa escala exige bastante más que conexiones más rápidas, y pusieron el foco en los dominios scale-across, los que reparten las cargas de trabajo entre centros de datos ubicados en regiones geográficas separadas.
Sistemas enormes, interconexiones nuevas
Un clúster de IA moderno suele reunir más de 100.000 aceleradores y potencialmente millones de CPU conectadas, lo que exige mucho al ancho de banda, a la latencia y al manejo de la congestión de la red. Además, el rendimiento de cómputo de cada acelerador crece más rápido que su capacidad de comunicación. Una GPU más rápida no entrega una mejora proporcional en el rendimiento de la aplicación. Por eso la eficiencia de la red decide cuánto aprovecha un sistema de IA grande sus recursos de cómputo.
Tradicionalmente, la computación de alto rendimiento se ha apoyado en dos dominios de interconexión, el scale-up y el scale-out.
- Scale-up conecta procesadores y aceleradores dentro de sistemas muy integrados, con tecnologías como Infinity Fabric de AMD, UPI de Intel, NVLink de Nvidia o alternativas emergentes como UALink.
- Scale-out une servidores individuales o sistemas del tamaño de un rack en clústeres más grandes, normalmente con Ethernet, InfiniBand, HPE Slingshot o, más recientemente, Ultra Ethernet.
Cada uno tiene requisitos distintos de ancho de banda, latencia y escalabilidad, y por eso cumplen funciones diferentes.
¿Qué es una red scale-across?
El tamaño y el consumo de los clústeres de IA actuales crean la necesidad de un tercer dominio, el scale-across. A diferencia del scale-out, que suele conectar sistemas dentro de un mismo centro de datos, una arquitectura scale-across extiende la conectividad de alto rendimiento entre edificios, campus o incluso regiones.
Con ese enfoque, un operador combina el cómputo y otros recursos de varias ubicaciones para alcanzar el rendimiento que necesita. La alternativa es concentrar una cantidad desmedida de aceleradores en un solo centro de datos, algo difícil o directamente imposible por la energía disponible, las exigencias de refrigeración o la falta de espacio físico.
La transición ya empezó. Google presentó este año su arquitectura de red Virgo para soportar cargas de IA que superan el espacio y la energía de un centro de datos individual. La empresa quiere tratar un campus completo de instalaciones de cómputo como un solo sistema, con redes especializadas para la comunicación entre aceleradores, entre servidores y entre centros de datos. Cisco y Marvell también desarrollan tecnología para despliegues scale-across, con enrutadores de alta capacidad, chips de conmutación e interconexiones ópticas diseñadas para unir clústeres repartidos geográficamente.
Los problemas de repartir un clúster
Extender la infraestructura de IA más allá de un recinto trae desafíos técnicos de peso. Las redes scale-up entregan un ancho de banda muy alto y baja latencia en distancias relativamente cortas. La comunicación entre centros de datos, en cambio, choca con los límites físicos de las conexiones largas.
Ni siquiera las redes ópticas eliminan el retardo de propagación, y la congestión, la pérdida de paquetes y el costo de sincronizar reducen todavía más el rendimiento efectivo. Unir dos clústeres grandes de GPU con enlaces de alta velocidad no hace que se comporten como un solo sistema integrado.
Esto pesa sobre todo en el entrenamiento de IA, donde los aceleradores intercambian todo el tiempo parámetros del modelo, gradientes y resultados intermedios. Las cargas grandes necesitan comunicaciones colectivas eficientes, porque un retraso que afecta a unos pocos aceleradores baja el rendimiento del clúster entero. La eficiencia depende del ancho de banda bruto y también de la topología de la red, el manejo de la congestión, los protocolos de comunicación y el software que los implementa.
¿Qué hardware y software hacen falta?
Para enfrentar esos límites, los adaptadores de red y los switches son cada vez más sofisticados. Las tarjetas de red modernas ejecutan operaciones de acceso directo a memoria remota (RDMA) sin intervención continua de la CPU. Tecnologías como las operaciones colectivas por hardware de HPE Slingshot y Nvidia SHARP descargan parte de la comunicación en la propia red. Las SmartNIC y las unidades de procesamiento de datos (DPU) alivian a los procesadores anfitriones al manejar en hardware dedicado algunas funciones de red e infraestructura. Así mejora la eficiencia de las aplicaciones distribuidas sin que haga falta una interconexión física más rápida.
El software pesa lo mismo, según los investigadores. Bibliotecas de comunicación como libfabric, MPI o UCX determinan cómo las aplicaciones intercambian datos y cómo aprovechan los adaptadores de red. La comunicación consciente de la GPU y tecnologías como GPUDirect RDMA evitan transferencias innecesarias por la memoria del anfitrión, y las operaciones colectivas optimizadas reducen el costo de comunicar entre miles de aceleradores.
Medir más que el ancho de banda máximo
La complejidad creciente también cambia cómo se evalúa una red. La industria sigue lanzando interconexiones más rápidas, incluidas versiones de Ethernet con anchos de banda nominales de 800 Gb/s y 1,6 Tb/s. Esas tasas máximas no describen por sí solas lo que rinde un sistema, porque el rendimiento real de una aplicación depende de cómo cooperan el hardware y el software de red para mover datos, evitar la congestión y sincronizar cálculos entre miles de procesadores.
Para los investigadores, la próxima generación de sistemas de IA va a depender de aceleradores y CPU más rápidos, y también de adaptadores de red, switches y software capaces de unir recursos de cómputo repartidos geográficamente sin un costo de comunicación excesivo.