Saltar al contenido
Etiqueta

#gpu

45 notas publicadas

DLSS 5 corre en una Intel Arc 140V y rinde 10,5 cuadros
Electrónica

DLSS 5 corre en una Intel Arc 140V y rinde 10,5 cuadros

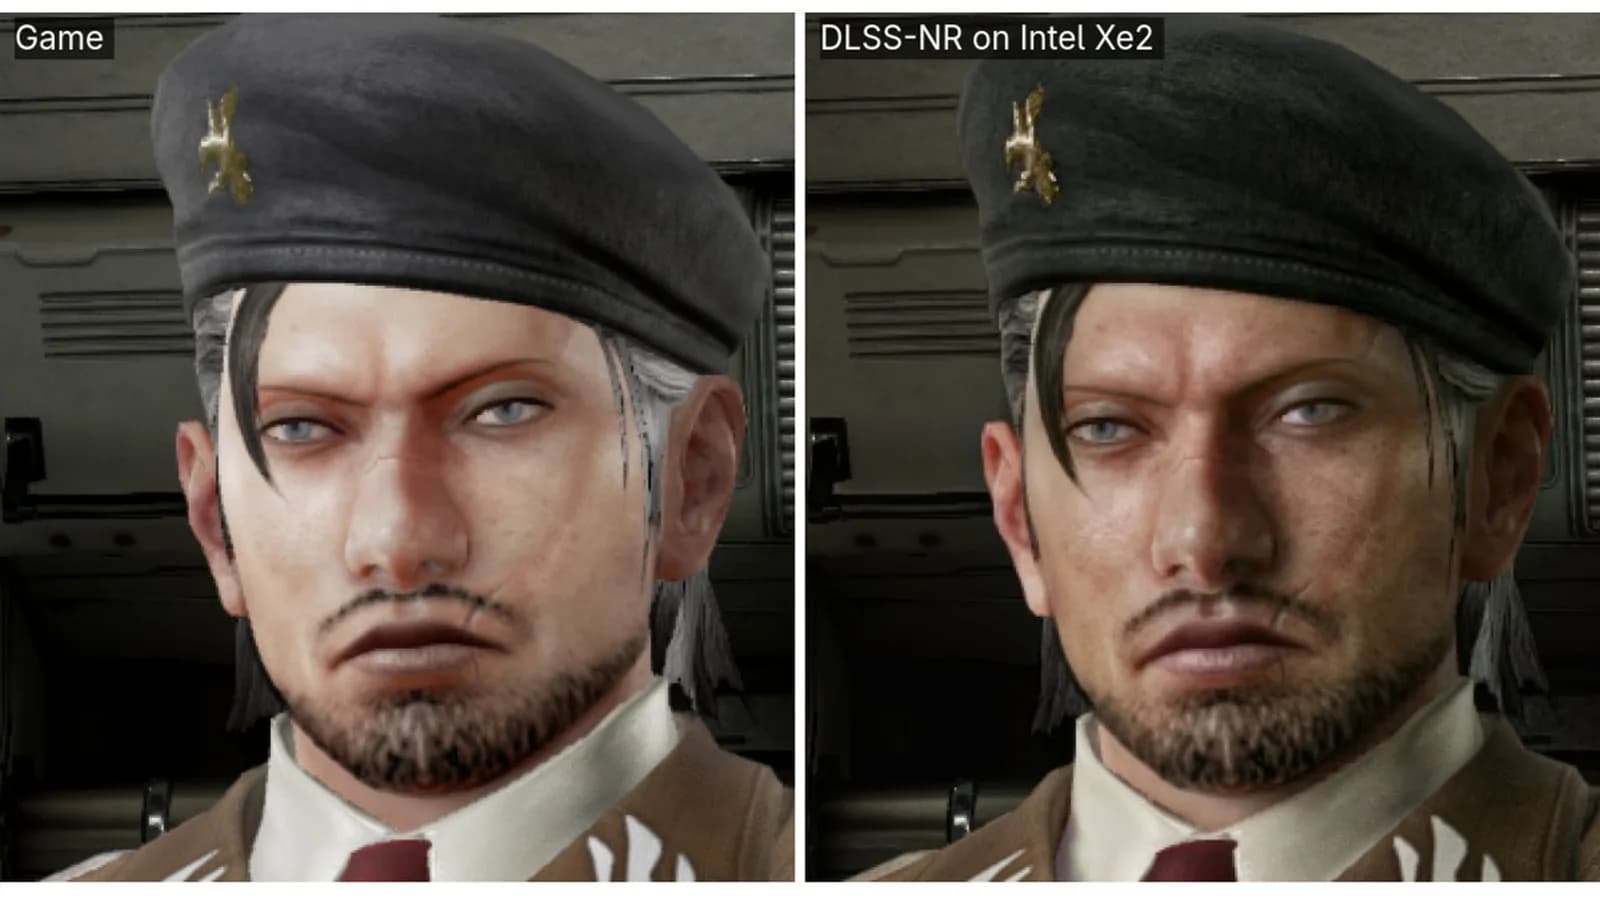
El proyecto dlss-nr-on-intel reimplementa la U-Net de 71 bloques sobre las unidades XMX de Xe2 con una extensión de Vulkan, y su autor dice que el código lo escribieron agentes de IA.

Tom's Hardware
Intel activa OpenCL LEO en Nova Lake S y estrena PISA
Open Source

Intel activa OpenCL LEO en Nova Lake S y estrena PISA

El Compute Runtime 26.35.39758.10 suma soporte inicial para PISA, la ISA portátil de Intel para GPU, que la propia Phoronix compara con el NVPTX de NVIDIA.

Phoronix Tests
Microsoft libera TauGrid y arma el stack de GPU con un Helm
IA

Microsoft libera TauGrid y arma el stack de GPU con un Helm

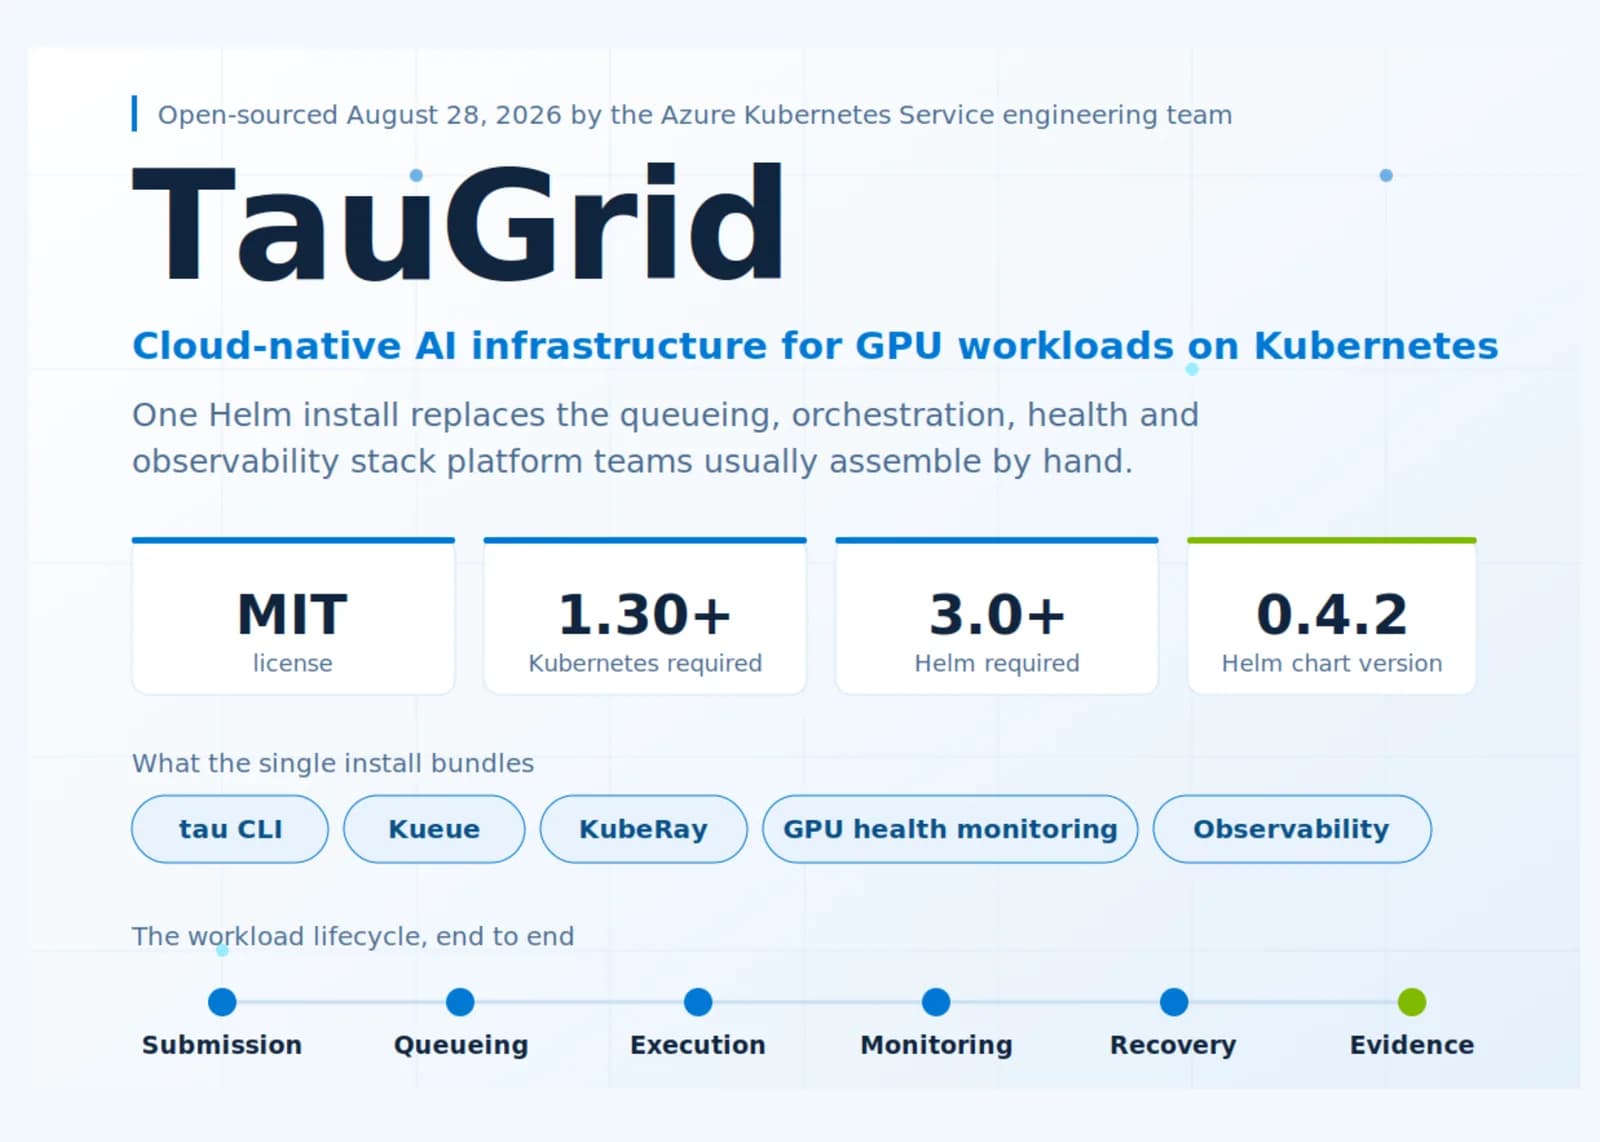
El equipo de Azure Kubernetes Service publicó bajo licencia MIT las cinco piezas que los equipos de plataforma solían integrar a mano para correr entrenamiento sobre Kubernetes.

MarkTechPost
NVIDIA lleva el MoE de DeepSeek-V3 de 103 a 1.068 TFLOPS
IA

NVIDIA lleva el MoE de DeepSeek-V3 de 103 a 1.068 TFLOPS

Los kernels de Transformer Engine para JAX atacan los tensores irregulares del enrutamiento sin descartes, en una línea base donde la comunicación entre GPU se comía el 84% del tiempo de kernel.

NVIDIA Developer
Cuatro rivales chinos de Nvidia construyen su propio silicio
Electrónica

Cuatro rivales chinos de Nvidia construyen su propio silicio

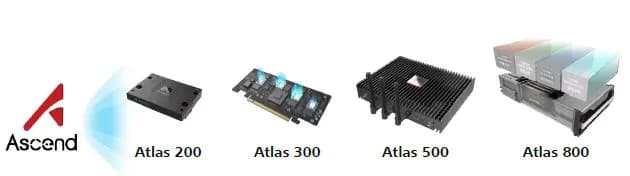
Huawei, Cambricon, Moore Threads y Biren empujan procesadores propios, pero el obstáculo que ninguno ha resuelto es el entorno de software que rodea a las GPU de Nvidia.

Interesting Engineering
YSERVER 1.5 suma Reverse PRIME y libera los fps sin vsync
Open Source

YSERVER 1.5 suma Reverse PRIME y libera los fps sin vsync

El servidor X11 escrito desde cero en Rust ya reparte trabajo entre dos GPU y destrabó el límite que dejaba a Counter-Strike 2 en la mitad de los cuadros por segundo.

Phoronix Tests
Helion llega al hub de kernels de Hugging Face
IA

Helion llega al hub de kernels de Hugging Face

El lenguaje de dominio específico de PyTorch para escribir kernels de alto rendimiento ya se puede empaquetar, autoajustar y distribuir desde el Hub, con configuraciones preajustadas incluidas.

PyTorch Blog
NVIDIA acelera hasta 5 veces el primer token al aislar el encoder
IA

NVIDIA acelera hasta 5 veces el primer token al aislar el encoder

La desagregación encode-prefill-decode separa el encoder de visión del resto de la inferencia y rinde en cargas con muchas imágenes, pero se vuelve contraproducente con salidas largas.

NVIDIA Developer
CUDA 13.4 suma Windows on Arm y reparte mejor la GPU
IA

CUDA 13.4 suma Windows on Arm y reparte mejor la GPU

La nueva versión del kit de NVIDIA extiende CUDA a Windows sobre Arm, estrena soporte preliminar para la arquitectura Rubin y renueva el control de GPU compartidas con MPS V3.

NVIDIA Developer
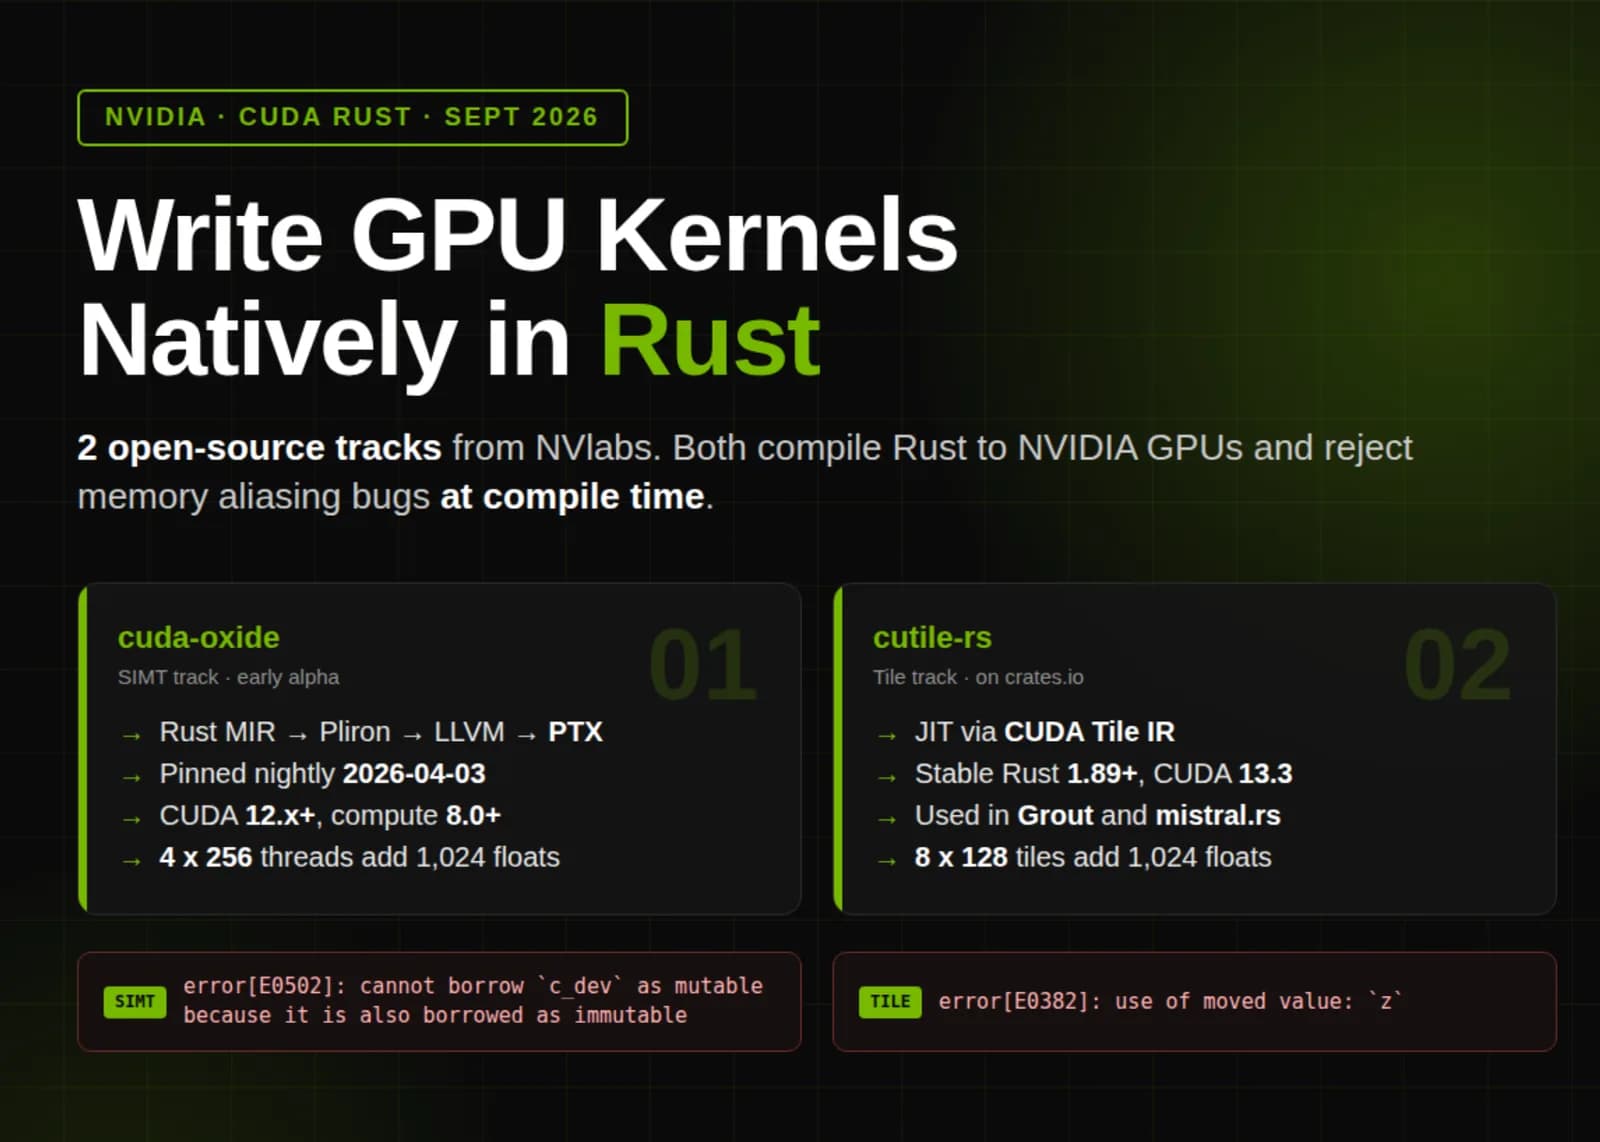
NVIDIA lleva Rust al kernel de GPU con dos caminos paralelos
IA

NVIDIA lleva Rust al kernel de GPU con dos caminos paralelos

cuda-oxide compila el modelo SIMT y cutile-rs el modelo Tile, ambos apoyados en el sistema de propiedad de Rust para rechazar errores de aliasing en tiempo de compilación.

MarkTechPost
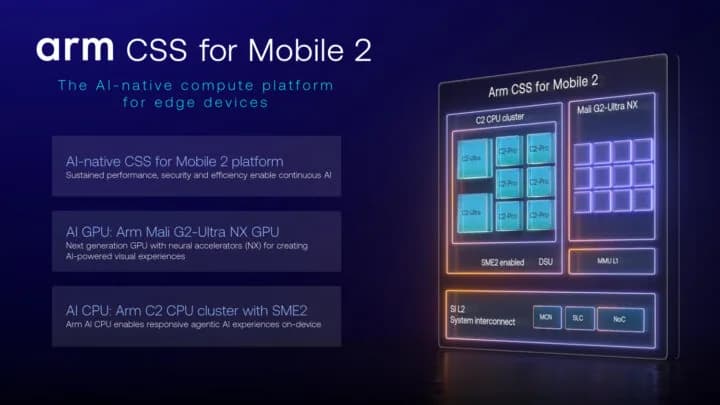
Arm lanza plataforma móvil para IA agentica y gráficos 3D
Electrónica

Arm lanza plataforma móvil para IA agentica y gráficos 3D

La nueva plataforma CSS para Mobile 2 busca optimizar la IA agentica y el rendimiento gráfico con un consumo energético limitado a solo 1 vatio.

The Register
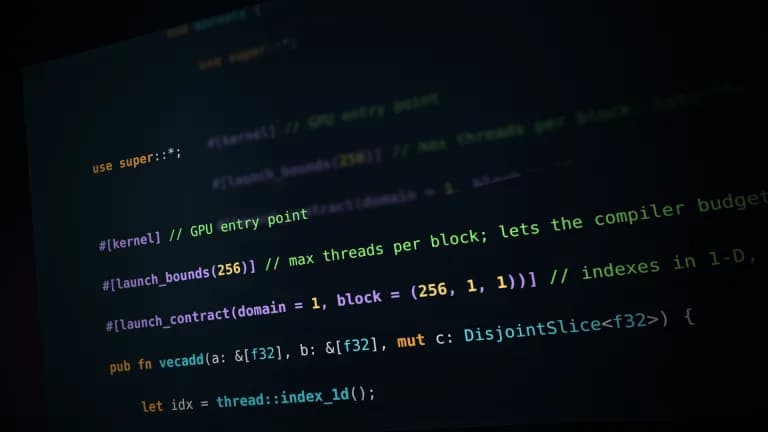
CUDA Rust: NVIDIA lanza soporte para kernels en GPUs
IA

CUDA Rust: NVIDIA lanza soporte para kernels en GPUs

NVIDIA expande su ecosistema con dos nuevas vías para escribir kernels de GPU utilizando Rust, facilitando la seguridad y el rendimiento en el desarrollo.

NVIDIA Developer
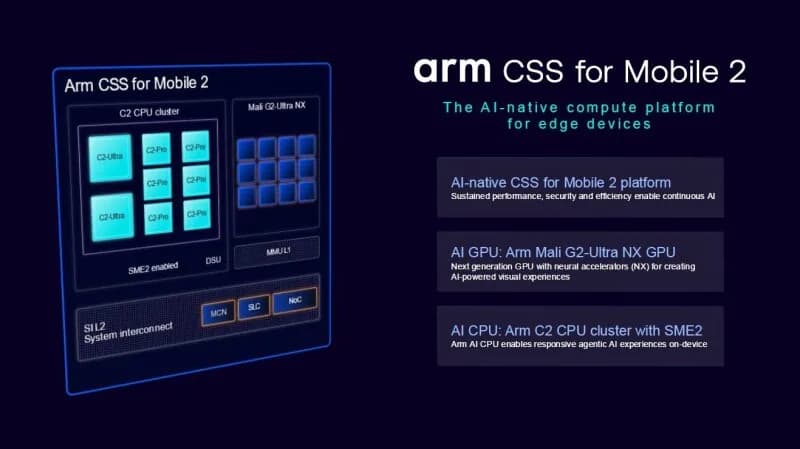
Arm CSS for Mobile 2: Nueva plataforma con CPUs C2 y GPU Mali G2
Electrónica

Arm CSS for Mobile 2: Nueva plataforma con CPUs C2 y GPU Mali G2

Arm introduce su plataforma CSS for Mobile 2, integrando los nuevos núcleos C2-Ultra, C2-Pro y la GPU Mali G2-Ultra NX con aceleración de IA nativa.

CNX Software
Decodificación especulativa: cómo elegir el largo del borrador
IA

Decodificación especulativa: cómo elegir el largo del borrador

NVIDIA publica las reglas prácticas para decidir cuántos tokens adelantar y con qué mecanismo generarlos, sin perder precisión en la inferencia.

NVIDIA Developer
Perplexity revela su arquitectura GPU para embeddings
IA

Perplexity revela su arquitectura GPU para embeddings

La ingeniería detrás de Perplexity explica cómo Ivy, Tulip y ROSE gestionan la carga de trabajo para sus modelos de embedding a escala web.

MarkTechPost
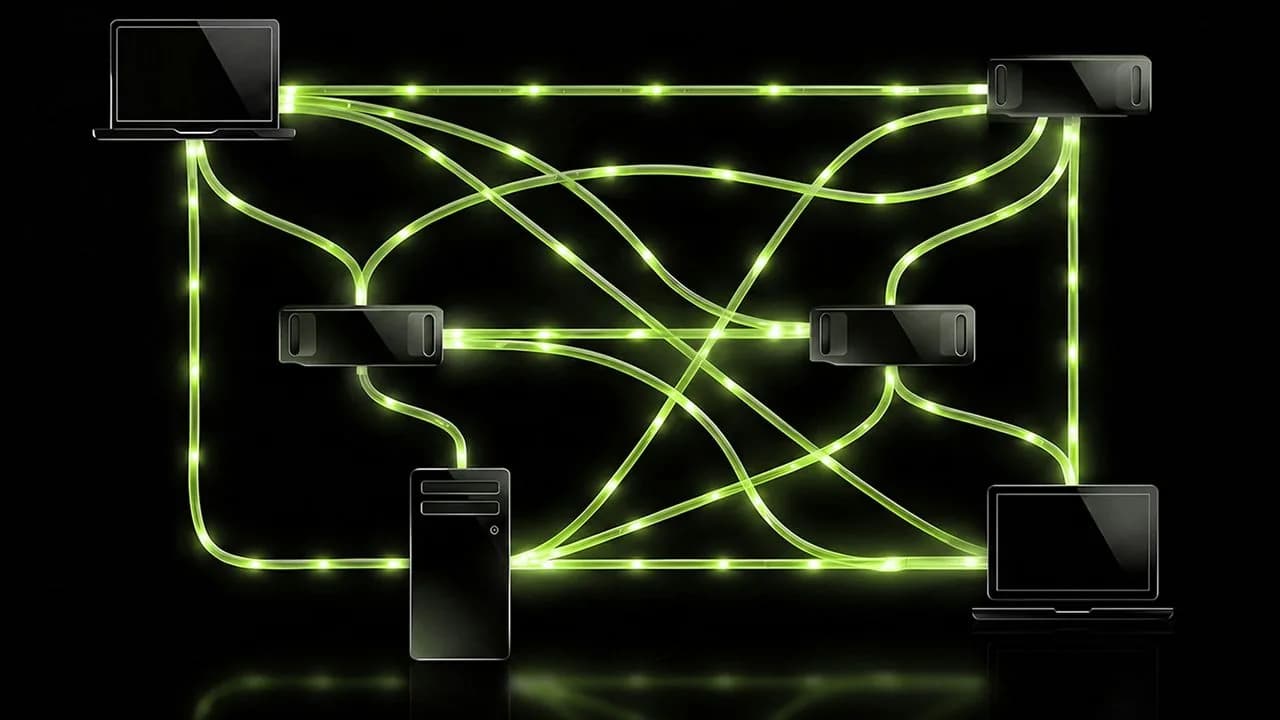
Nvidia PAIR reparte tareas de agentes entre las GPU de la casa
Electrónica

Nvidia PAIR reparte tareas de agentes entre las GPU de la casa

La herramienta, presentada en IFA 2026, manda subtareas de un agente local a los computadores de la red doméstica que tengan ciclos de GPU libres.

Tom's Hardware
AMD arma un equipo para llevar Rust al núcleo de sus GPU
Open Source

AMD arma un equipo para llevar Rust al núcleo de sus GPU
El objetivo abarca compiladores, entornos de ejecución, firmware y codiseño de hardware y software, con una vacante abierta que describe a Rust como dirección técnica central y no como accesorio.

Phoronix Tests
Nvidia PAIR: convierte tu red local en un centro de datos para IA
IA

Nvidia PAIR: convierte tu red local en un centro de datos para IA

La nueva herramienta de código abierto de Nvidia permite distribuir tareas de IA entre múltiples dispositivos de tu red, optimizando drásticamente los tiempos de procesamiento.

The Decoder
CUDA moderno: seis pasos para depurar y acelerar un kernel
IA

CUDA moderno: seis pasos para depurar y acelerar un kernel

Un recorrido práctico sobre una tubería de procesamiento de imágenes que, con cambios de pocas líneas, pasa de arrastrar un error de memoria compartida a correr con flujos asincrónicos.

NVIDIA Developer
NVIDIA PAIR une los PC ociosos de la casa en un clúster de IA
IA

NVIDIA PAIR une los PC ociosos de la casa en un clúster de IA

El Personal AI Router es software libre, funciona con GeForce RTX 20 en adelante y también con chips Apple M4, y aprovecha los equipos mientras nadie los usa.

The Verge
NVIDIA: cómo dimensionar GPU de inferencia sin sobregastar
IA

NVIDIA: cómo dimensionar GPU de inferencia sin sobregastar

La compañía publicó un marco de trabajo que ordena el cálculo alrededor del uso real de la carga, con cuatro escenarios de empresa y sus requisitos de memoria.

NVIDIA Developer
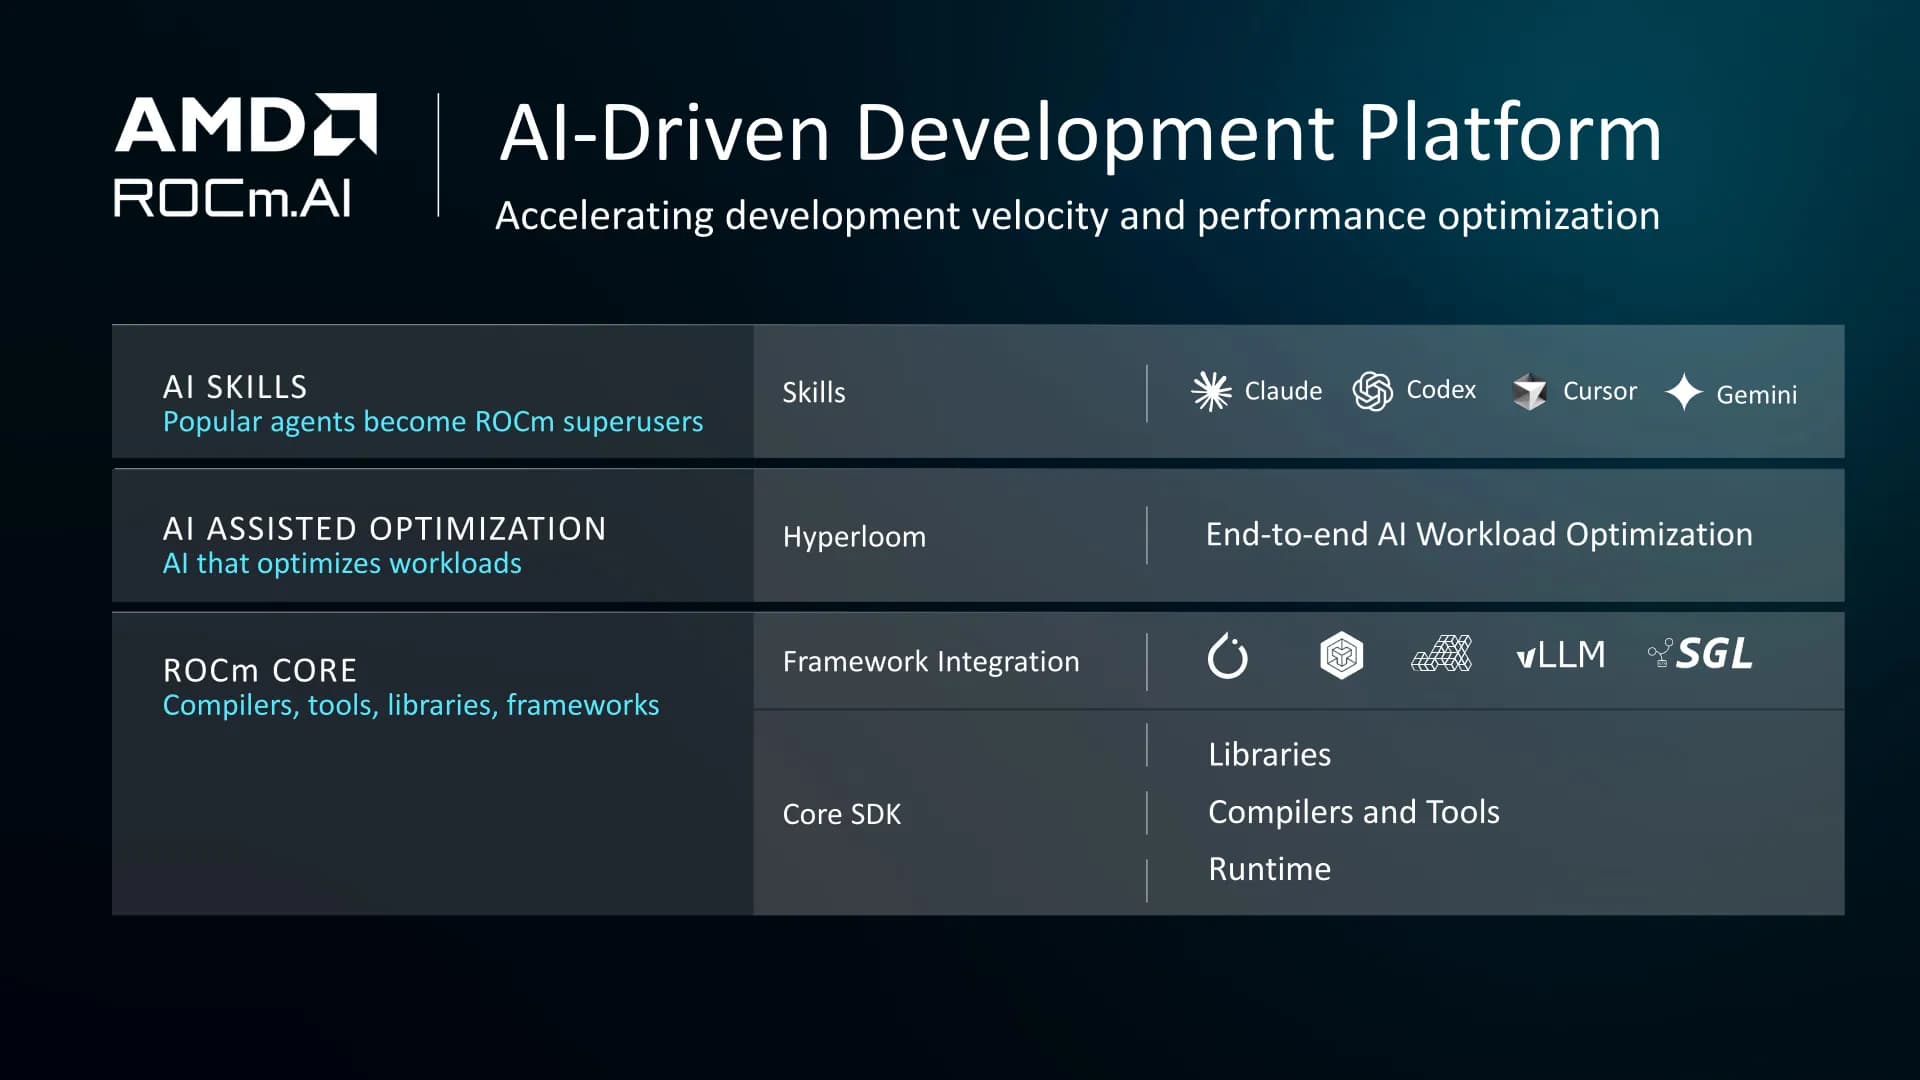
AMD salta de ROCm 7.14 a ROCm 10.0 y estrena ROCm.AI
Open Source

AMD salta de ROCm 7.14 a ROCm 10.0 y estrena ROCm.AI

El salto de versión ordena un esquema de numeración que se había vuelto confuso y llega con la primera entrega bajo el nuevo ciclo de lanzamientos cada seis semanas.

Phoronix Tests
Dynamo restaura la inferencia de un LLM en 7,3 segundos
IA

Dynamo restaura la inferencia de un LLM en 7,3 segundos

El motor sombra de NVIDIA mantiene una réplica ya inicializada en la misma GPU y comparte los pesos en memoria, con lo que el reinicio en frío de 283 segundos se vuelve innecesario.

NVIDIA Developer
CUDA Python 1.0 estabiliza el acceso completo a la GPU
IA

CUDA Python 1.0 estabiliza el acceso completo a la GPU

NVIDIA libera junto a CUDA 13.3 un conjunto oficial de bibliotecas con versionado semántico, y declara a Python un ciudadano de primera clase de su plataforma, a la par de C++.

NVIDIA Developer
NVIDIA ALCHEMI: 45 simulaciones atómicas escritas por agentes
IA

NVIDIA ALCHEMI: 45 simulaciones atómicas escritas por agentes

Un experimento con 45 flujos generados por un agente de programación muestra que el detalle del prompt cambia el código y su costo, pero no la física del resultado.

NVIDIA Developer
Vulkan 1.4.359: Nueva mejora en Cooperative Matrix
Open Source

Vulkan 1.4.359: Nueva mejora en Cooperative Matrix

La nueva actualización de la API Vulkan introduce la extensión VK_EXT_cooperative_matrix_maintenance1, optimizando el rendimiento en machine learning e inferencia.

Phoronix Tests
SpaceX apunta a dos millones de GPUs Rubin de Nvidia
IA

SpaceX apunta a dos millones de GPUs Rubin de Nvidia

Elon Musk anunció que la capacidad de cómputo de la compañía pasará de 1,4 gigavatios a cerca de diez antes de que termine 2027, con silicio de un solo proveedor.

The Decoder
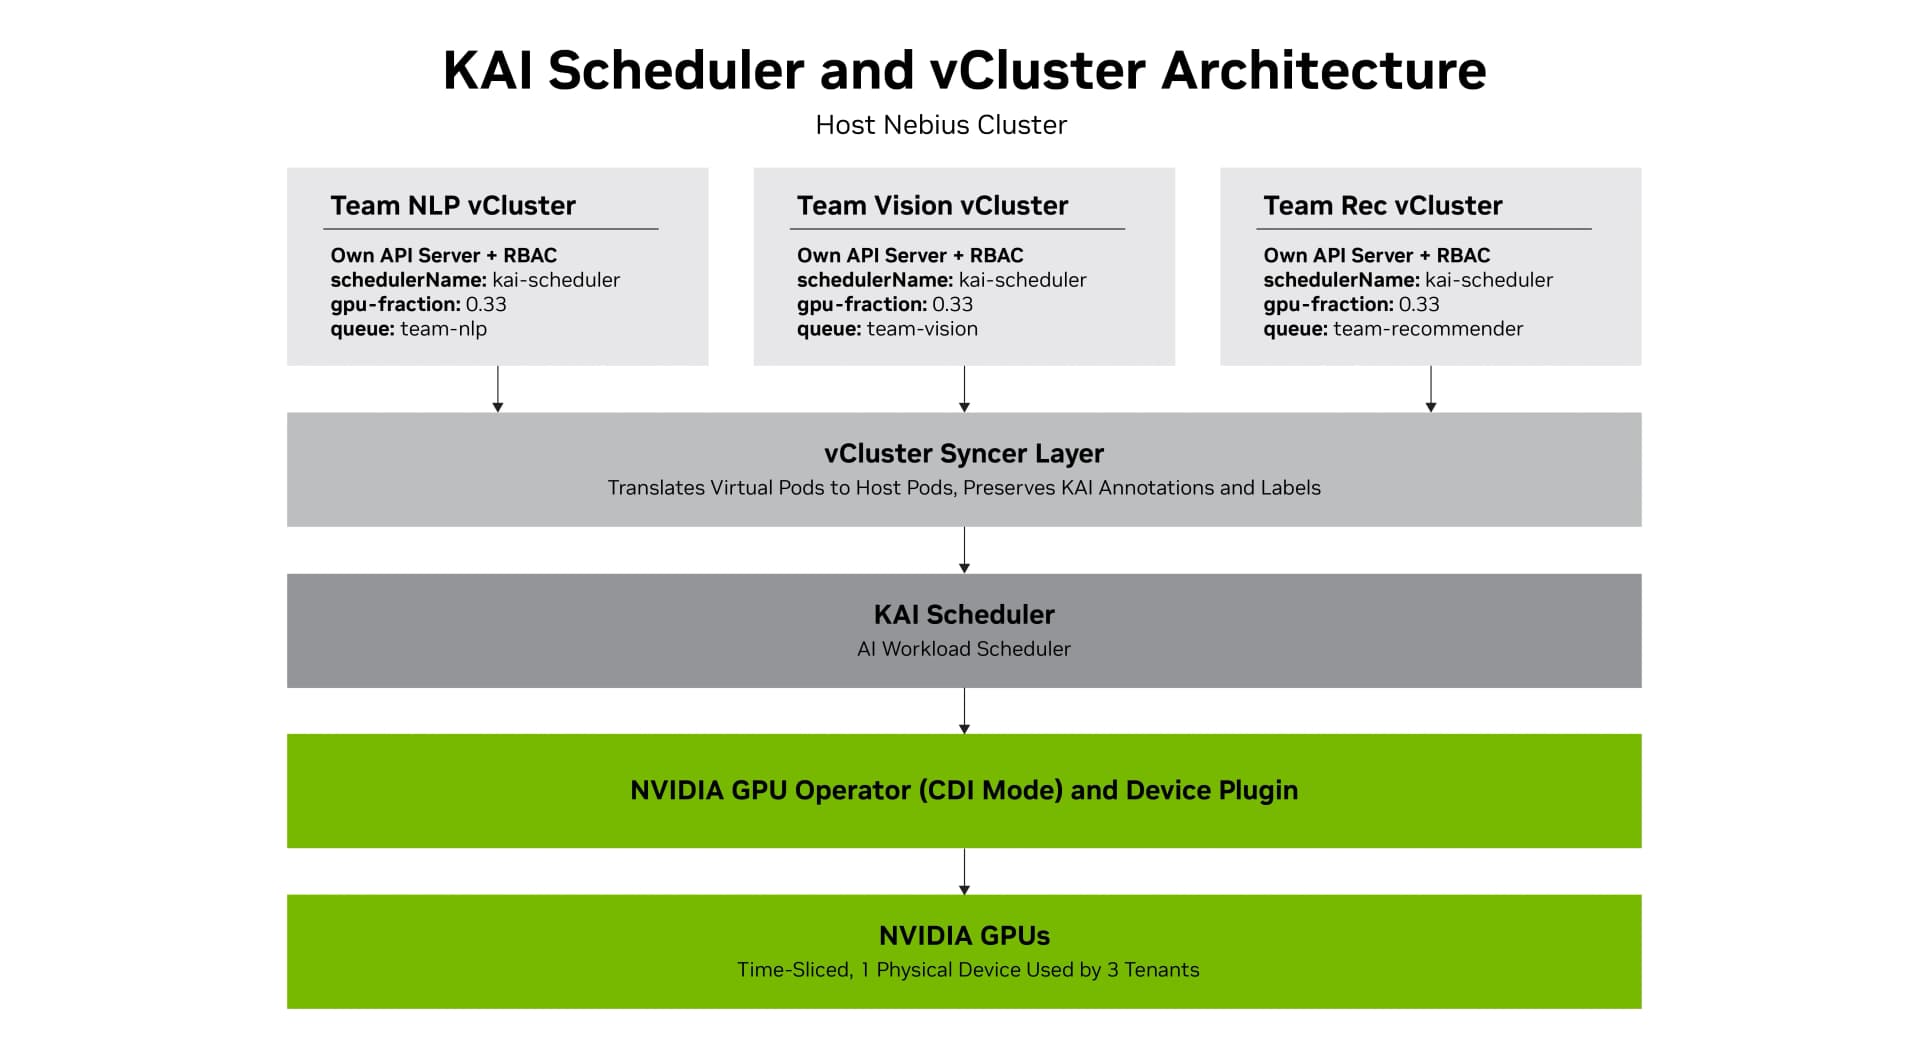
Clusters Kubernetes aislados por equipo sobre una misma GPU
IA

Clusters Kubernetes aislados por equipo sobre una misma GPU

NVIDIA documenta una arquitectura que combina KAI Scheduler y vCluster para dar a cada equipo su propio plano de control, con cuotas de GPU independientes y sin dividir el hardware físico.

NVIDIA Developer
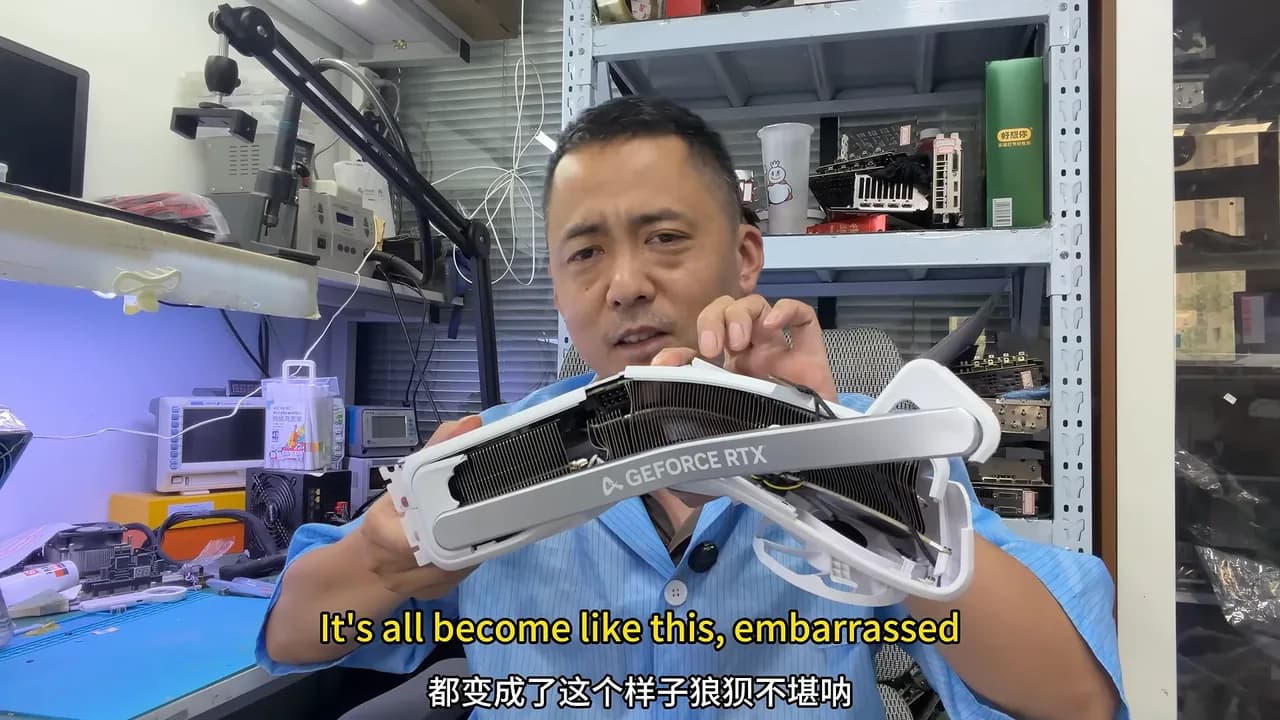
Una RTX 5060 Ti doblada en un choque volvió a funcionar
Electrónica

Una RTX 5060 Ti doblada en un choque volvió a funcionar

El PCB corto de esta variante apenas alcanzó el punto de curvatura y salvó al núcleo, así que toda la reparación se redujo a resoldar un único módulo de memoria.

Tom's Hardware
AMD libera documentación técnica de la arquitectura CDNA5
Open Source

AMD libera documentación técnica de la arquitectura CDNA5

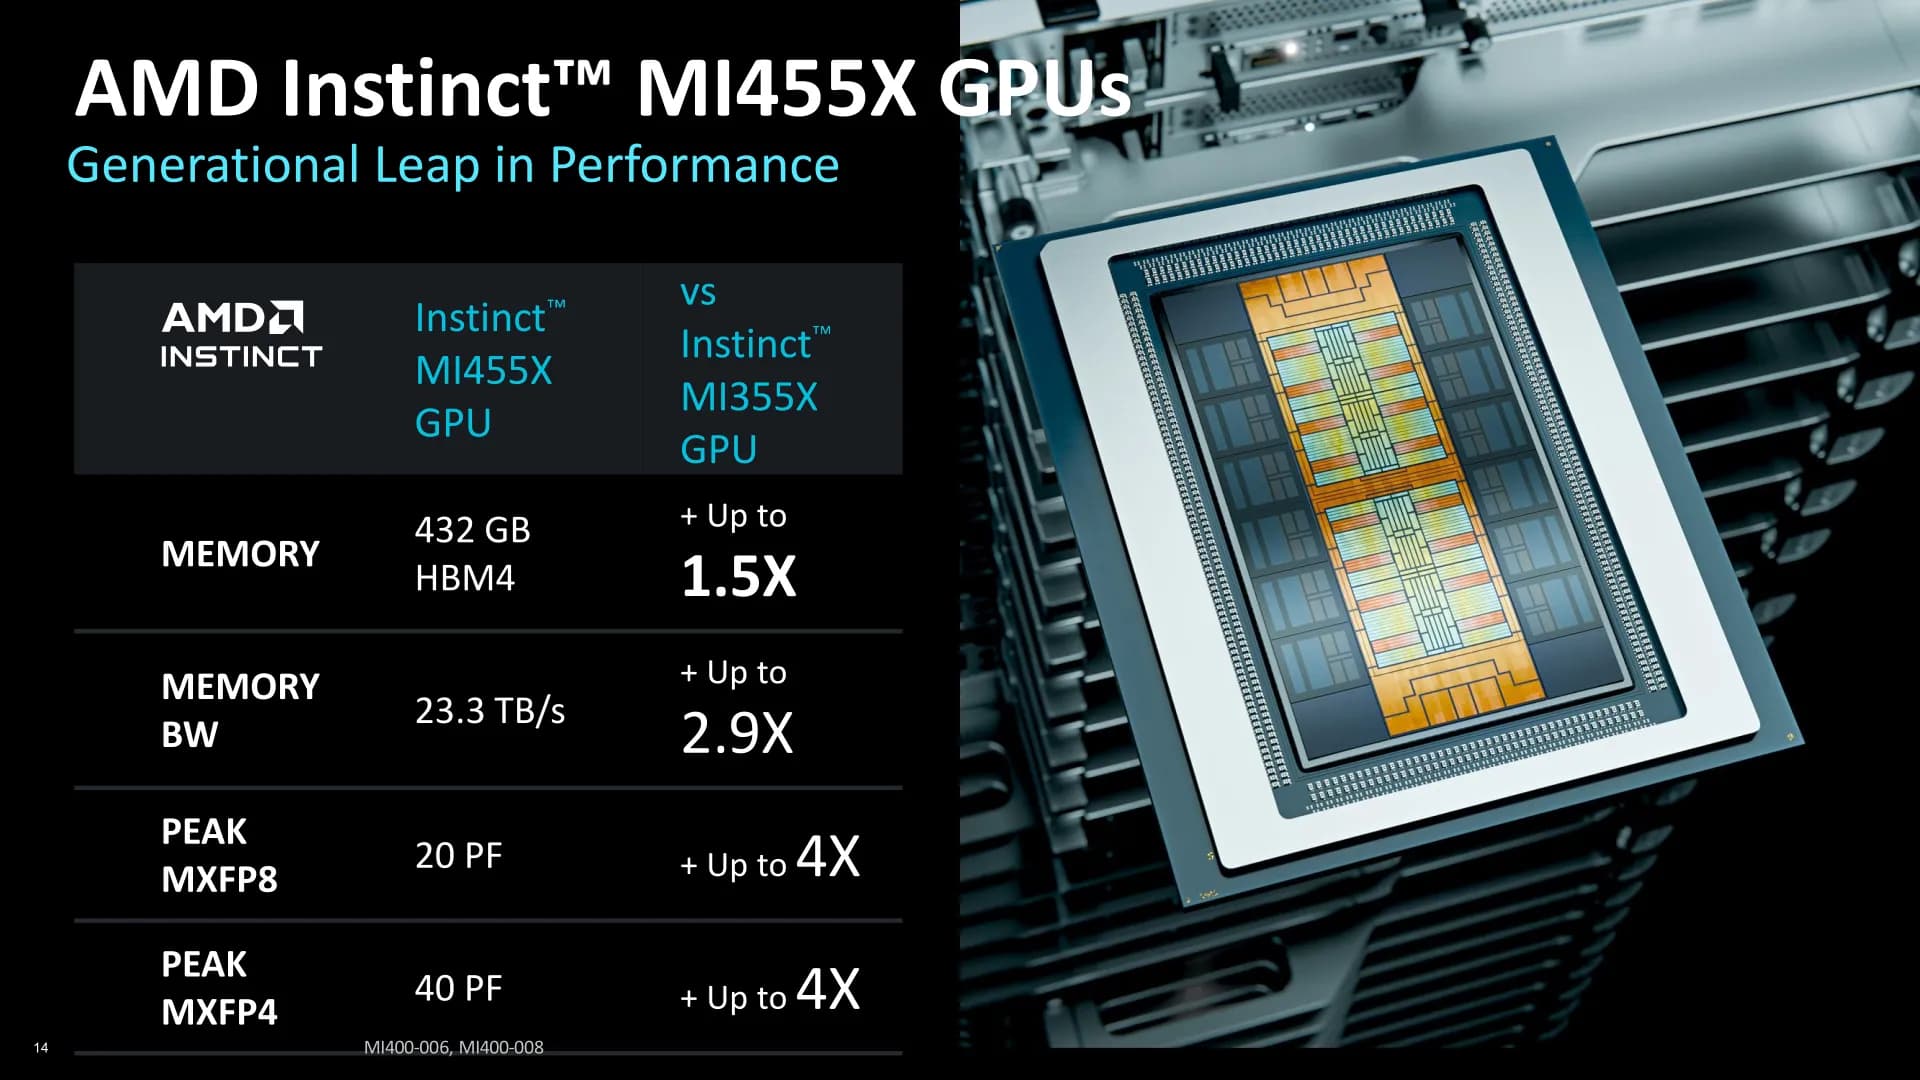
Tras el lanzamiento del MI455X, AMD cumple su tradición de hacer pública la documentación ISA para desarrolladores, fortaleciendo el soporte open source en Linux.

Phoronix Tests
Optimización de atención en modelos AI para inferencia rápida
IA

Optimización de atención en modelos AI para inferencia rápida

Análisis profundo sobre el diseño de arquitecturas de modelos de IA, el rol del group size y cómo maximizar el rendimiento en hardware NVIDIA para inferencia.

NVIDIA Developer
Gestión de GPUs: Por qué las GPUs ociosas son el nuevo problema
IA

Gestión de GPUs: Por qué las GPUs ociosas son el nuevo problema

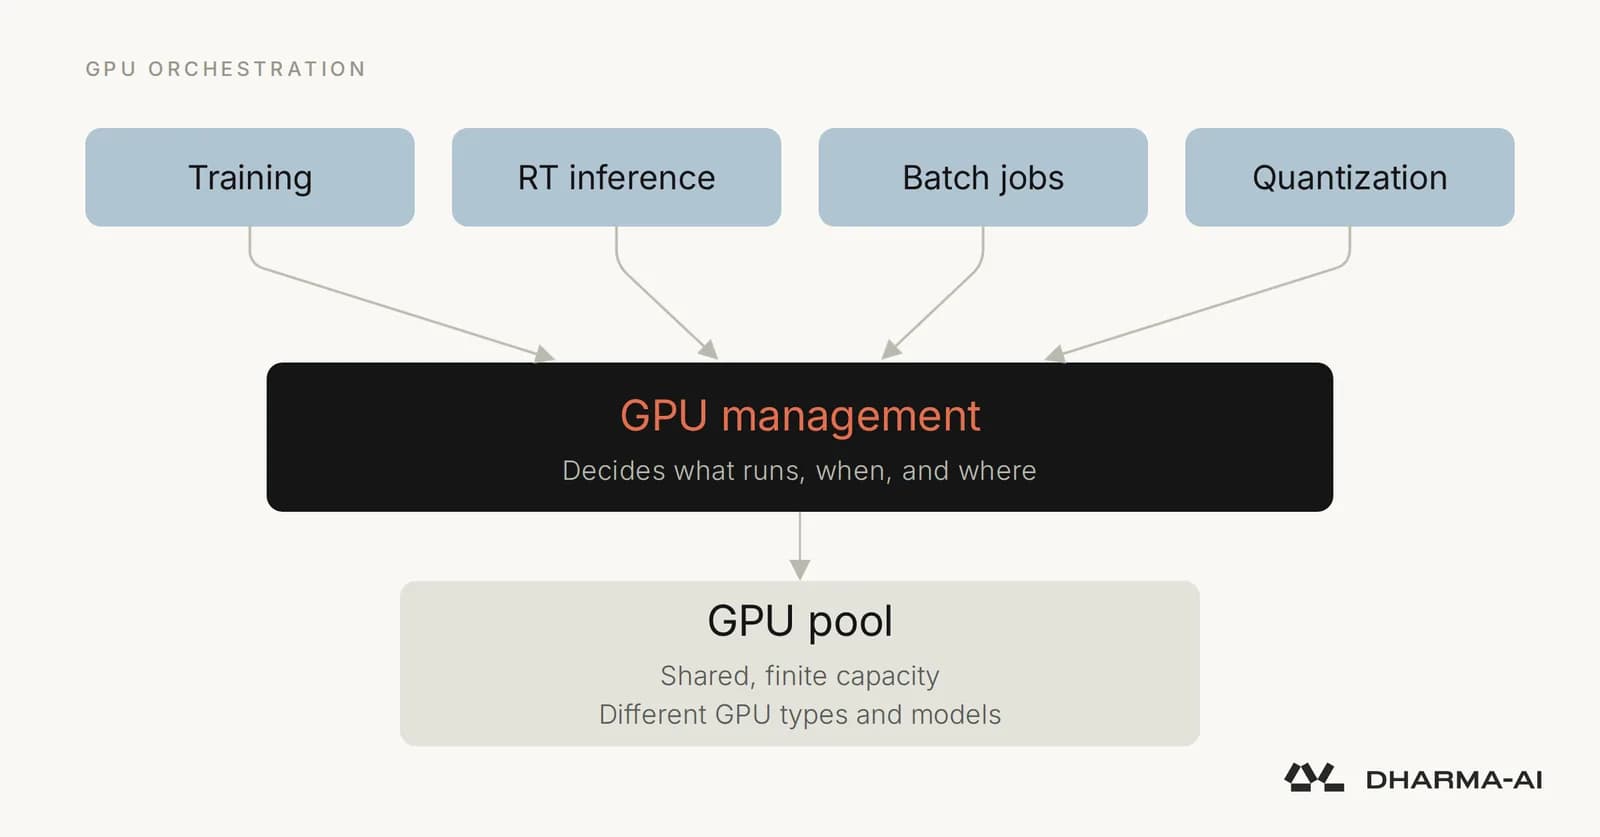
La industria de la IA enfrenta una nueva restricción crítica: la eficiencia operativa. Gestionar las GPUs como activos en tierra es el desafío financiero del momento.

Hugging Face
Huawei considera driver Vulkan para Mesa, pero a medias
Open Source

Huawei considera driver Vulkan para Mesa, pero a medias

La propuesta de Huawei para integrar su driver Vulkan en Mesa enfrenta rechazos técnicos debido a la negativa de liberar el compilador de shaders.

Phoronix Tests
Intel mejora aceleración multimedia en GPUs Alchemist Linux
Open Source

Intel mejora aceleración multimedia en GPUs Alchemist Linux

El desarrollo de código abierto para las tarjetas gráficas DG2 avanza, permitiendo por fin el uso de aceleración por hardware en el driver Xe de Linux.

Phoronix Tests
GPUs Tesla V100 de datacenter reconvertidas para LLM locales
Electrónica

GPUs Tesla V100 de datacenter reconvertidas para LLM locales

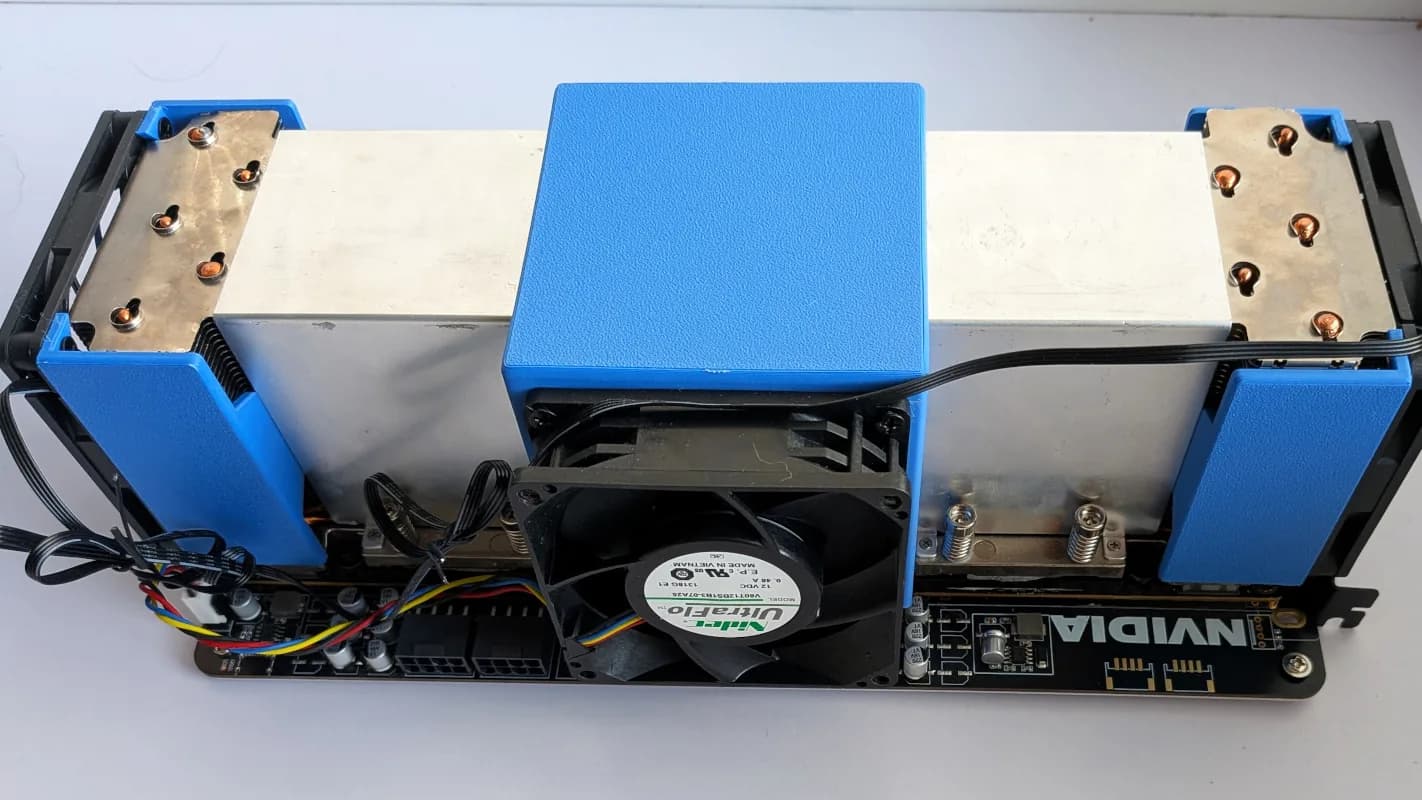
Andrew rescató tarjetas Tesla V100 de 2017 del mercado de segunda mano y armó una placa PCI para dos GPUs, capaz de correr modelos como Gemma 4 26B y Qwen3 35B por completo en memoria.

Hackaday
Depuración de apps de Ray Tracing con NVIDIA OptiX Toolkit
IA

Depuración de apps de Ray Tracing con NVIDIA OptiX Toolkit

Aprende a integrar herramientas de verificación de errores y depuración en tiempo real para optimizar el rendimiento de tus aplicaciones de trazado de rayos en la GPU.

NVIDIA Developer
NVIDIA TensorRT: monitorear y cancelar builds de motores
IA

NVIDIA TensorRT: monitorear y cancelar builds de motores

La API IProgressMonitor, incluida en TensorRT desde hace varias versiones, permite seguir el progreso en tiempo real y abortar una compilación larga antes de malgastar horas de GPU.

NVIDIA Developer
NVIDIA Rubin: 10x más rendimiento agentico por watt
IA

NVIDIA Rubin: 10x más rendimiento agentico por watt

La nueva GPU de la plataforma Vera Rubin apunta a las cargas de IA agentica con 336 mil millones de transistores, 288 GB de HBM4 y 50 petaflops en formato NVFP4.

NVIDIA Developer
AMD invierte USD 5.000 millones en Anthropic para Claude
IA

AMD invierte USD 5.000 millones en Anthropic para Claude

El fabricante de chips financia al laboratorio detras de Claude, que a cambio desplegara hasta 2 gigavatios de GPU AMD Instinct MI450 en sistemas Helios desde 2027.

The Decoder
Vera Rubin: NVIDIA promete 10x más tokens por megavatio
IA

Vera Rubin: NVIDIA promete 10x más tokens por megavatio

La nueva plataforma de centros de datos de NVIDIA ya corre en CoreWeave, Google Cloud, Microsoft Azure y Oracle, con un rediseño integral que va del chip a la red eléctrica.

NVIDIA Blog
Triton 3.7 permite extender el compilador de GPU sin forks
IA

Triton 3.7 permite extender el compilador de GPU sin forks

El nuevo sistema de plugins de PyTorch-Triton carga pases y extensiones en tiempo de ejecución y activa por defecto las TLX de Meta, con hasta 15% más rendimiento que las librerías del fabricante.

PyTorch Blog
NVIDIA duplica el escalado de la dinámica molecular en GPUs
IA

NVIDIA duplica el escalado de la dinámica molecular en GPUs

NVIDIA reemplazó la comunicación por MPI orquestada desde la CPU con acceso directo entre GPUs vía NVSHMEM, y logró hasta el doble de rendimiento en los clústeres Eos y GB200 NVL72.

NVIDIA Developer
NVIDIA: diseñar modelos de IA pensados para la GPU
IA

NVIDIA: diseñar modelos de IA pensados para la GPU

Una guía técnica de NVIDIA explica por qué la forma de un modelo (capas cuadradas, dimensiones múltiplos de 128 y más ancho que profundo) define cuánto rendimiento se saca de una GPU Blackwell.

NVIDIA Developer
Fusión de kernels en CUDA para acelerar la memoria GPU
IA

Fusión de kernels en CUDA para acelerar la memoria GPU

NVIDIA explica cómo combinar operaciones en un solo kernel reduce el tráfico a memoria global y el overhead de lanzamiento, con ejemplos en CUDA C++, torch.compile y cuda.compute.

NVIDIA Developer

Etiquetas relacionadas

Otros temas que aparecen junto a #gpu en nuestra cobertura editorial.