Los agentes de IA que investigan durante horas pueden estancarse aunque reciban más cómputo, según un estudio de Microsoft Research que reportó The Decoder el 12 de octubre de 2026. El contexto de conversación que acumulan limita su búsqueda y los mantiene girando sobre soluciones parecidas en vez de explorar enfoques mejores.
Los investigadores estudiaron lo que llaman Autoresearch agents, sistemas de IA que proponen soluciones, las evalúan y las refinan una y otra vez a partir de la retroalimentación. Ocho corridas independientes del mismo agente sobre la misma tarea se estancaron en niveles de rendimiento muy distintos, con puntajes finales que fueron de 68,3 a 100,0. Según el paper, esas diferencias se mantuvieron incluso con bastante más cómputo.
¿Qué son las "cuencas de ideas"?
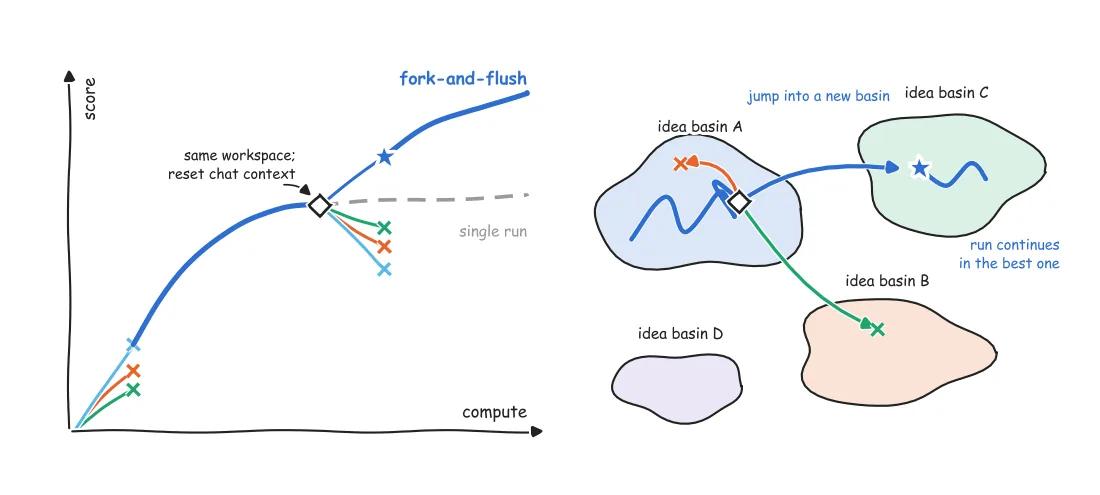
El equipo ubicó las soluciones de todas las corridas en un mapa de dos dimensiones que deja cerca a las soluciones parecidas, y después las comparó. Las soluciones de una misma corrida casi siempre quedaron dentro de una zona pequeña del mapa. Los autores llaman a esas zonas idea basins, cuencas de ideas.
Los agentes gastan buena parte del presupuesto de cómputo que les queda en pulir soluciones dentro de una zona poco productiva, en lugar de llegar a los enfoques mejores que encontraron otras corridas. El patrón se repite aunque los agentes compriman cada cierto tiempo su historial de conversación.
¿Cómo funciona Fork-and-Flush?
El método propuesto, Fork-and-Flush, combina dos mecanismos. En el forking, el agente se divide en K ramas paralelas, y cada una hereda el espacio de trabajo anterior con todos los archivos generados. En el flushing, cada rama pierde por completo su contexto de chat pero conserva el espacio de trabajo, así que arranca una conversación nueva sobre el trabajo previo.
Una rama que mantiene el contexto de chat del proceso padre tiende a volver a la misma cuenca de ideas, porque el razonamiento anterior guía sus próximos pasos. El contexto limpio devuelve la diversidad a la búsqueda. Se pierde el historial de la conversación, y el código, los archivos y los resultados guardados siguen en el espacio de trabajo.
En el gráfico del paper (Cai, Ziakas et al., 2026), una corrida única sigue refinando soluciones dentro de la misma cuenca. Fork-and-Flush abre ramas paralelas con contexto nuevo, se queda con la mejor y descarta el resto, y una de esas ramas salta a otra cuenca y logra un puntaje más alto.
66% más de puntaje con el mismo presupuesto
Los investigadores probaron Fork-and-Flush en 13 tareas de larga duración, entre ellas el empaquetado de poliominós, la planificación de talleres (job-shop scheduling) y el criptoanálisis. También incluyeron comprimir un clasificador de CIFAR y optimizar un kernel VLIW. Cada corrida duró desde varias horas hasta más de 100 horas. Los agentes usaron GPT-5.6-terra y GPT-5.5 a través de la CLI de GitHub Copilot.
Con el mismo presupuesto de cómputo, Fork-and-Flush obtuvo un puntaje promedio normalizado (min-max) de 0,78, contra 0,47 de las corridas únicas y 0,54 de la estrategia best-of-4. El paper informa mejoras relativas de 66,0% y 44,4%, respectivamente. El método logró el mejor puntaje medio en 12 de las 13 tareas.
Los resultados también fueron más parejos. La desviación estándar normalizada bajó de 0,26 en las corridas únicas a 0,16. Borrar el contexto de chat sin dividir en ramas mejoró los resultados en 22%.
| Evaluación | Método | Puntaje promedio normalizado | Desviación estándar normalizada | Mejora frente a la corrida única |
|---|---|---|---|---|
| 13 tareas | Corrida única | 0,47 | 0,26 | Base |
| 13 tareas | Best-of-4 | 0,54 | 0,21 | cerca de +14,9% |
| 13 tareas | Fork-and-Flush | 0,78 | 0,16 | +66,0% |
| 11 tareas | Corrida única | 0,45 | sin dato | Base |
| 11 tareas | Solo flushing | 0,55 | sin dato | cerca de +22% |
¿Los modelos más capaces también lo necesitan?
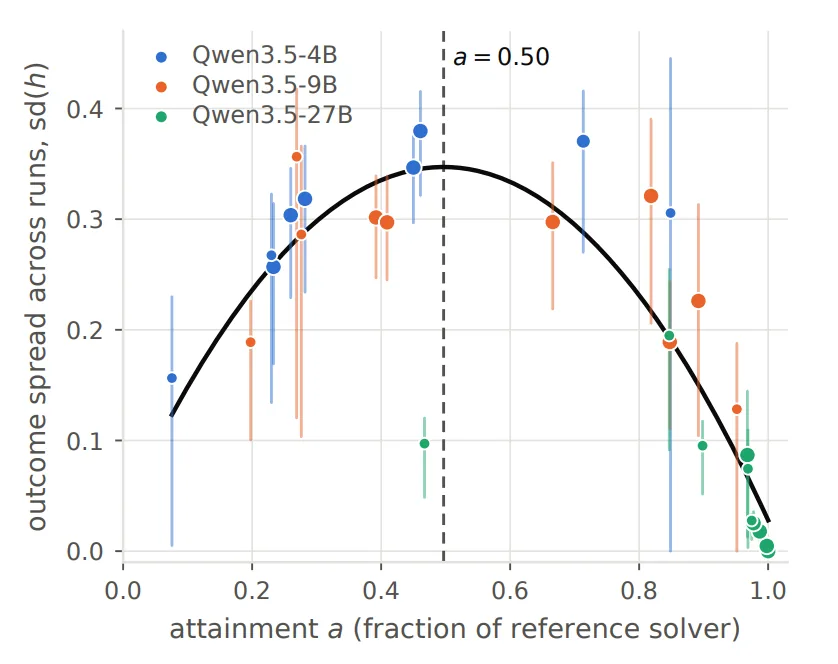
El equipo revisó además si los modelos más capaces evitan las cuencas de ideas. Usó problemas MAX-3-SAT con tres tamaños de modelo, Qwen3.5-4B, 9B y 27B. La variación entre corridas siguió una curva en U invertida y llegó a su punto más alto en las tareas que están en el límite de lo que puede hacer el modelo, más o menos a medio camino entre el rendimiento de adivinar al azar y el del solver de referencia.
En esas tareas límite algunas corridas aciertan y otras quedan muy lejos. Con tareas muy fáciles los modelos casi siempre aciertan, y con las muy difíciles casi siempre fallan. El patrón se repitió en los tres tamaños probados.
Los autores sostienen que los problemas de investigación abiertos están, por definición, en el límite de las capacidades de los modelos. Por eso esperan que la variación que aprovecha Fork-and-Flush se mantenga a medida que los modelos mejoren, con la frontera corrida hacia problemas más difíciles. Según los resultados, reiniciar el contexto de forma periódica podría seguir sirviendo incluso en los agentes de investigación más avanzados.