
IA
DeepSeek libera DeepInfer, el motor que sirve a su modelo V4.1 Flash
El código sale bajo licencia Apache 2.0 y se apoya en vLLM, aunque la gestión de caché y el balanceo de carga de producción quedaron fuera.
The Decoder
32 notas publicadas
En septiembre procesaron más de siete de cada diez tokens del AI Gateway de Vercel, y su parte del gasto se cuadruplicó desde junio.
El nuevo modelo de razonamiento chino empata con GLM-5.3-Flash, queda detrás de Deepseek V4.1 Flash y libera sus pesos el 23 de octubre.
El informe de septiembre nombra a DeepSeek, Moonshot AI y Alibaba, entre otras, y una alerta conjunta de la NSA, el FBI y CISA respalda la acusación.
Una consultora de call centers probó DeepSeek V4.1 Flash en su propio servidor para reemplazar a Opus 5.5 y terminó volviendo a Claude por costo y por seguridad.
El lenguaje, creado en la Universidad de Pekín, promete un modelo de programación más simple que CUDA y ya es la herramienta principal de DeepSeek.
Gambit reconstruyó la campaña desde el servidor del operador. Robó más de 600.000 tarjetas de crédito con Hermes, Strix y Cairn y gastó entre 12.000 y 18.000 dólares en modelos.
La medición corrió sobre DeepSeek-R1 en ocho GPU B200, con el cifrado encendido y apagado, y dejó el sobrecosto de latencia por token bajo el 5%.
El informe que Interconnects preparó para legisladores estadounidenses pone la ventaja china en 1.600 millones de descargas y en más del 80% del uso de OpenRouter.
Los kernels de Transformer Engine para JAX atacan los tensores irregulares del enrutamiento sin descartes, en una línea base donde la comunicación entre GPU se comía el 84% del tiempo de kernel.
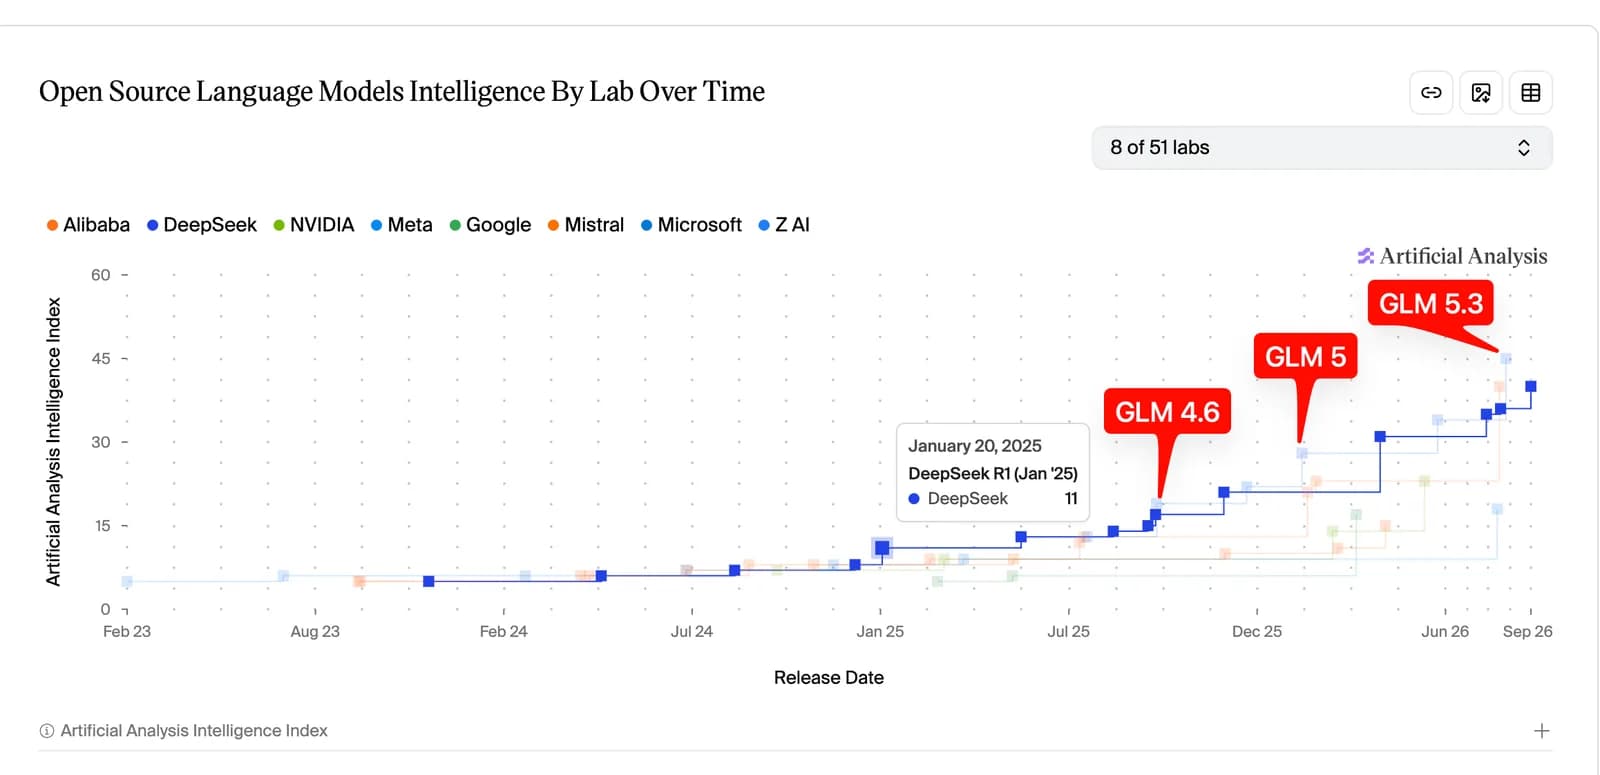
El modelo suma 763.000 millones de parámetros, activa 8.000 millones en la entrada y 16.000 millones en la salida, y con eso baja la caché de claves y valores hasta un octavo de la del V4 Flash.
Los 196.000 millones de parámetros N-gram del modelo se pueden mover a la RAM del sistema, y eso baja de 763 GB a 567 GB la memoria de GPU que pide para arrancar.
El nuevo modelo multimodal de 552.000 millones de parámetros achica el caché KV para abaratar los agentes que trabajan con contextos largos, y se libera bajo licencia MIT.
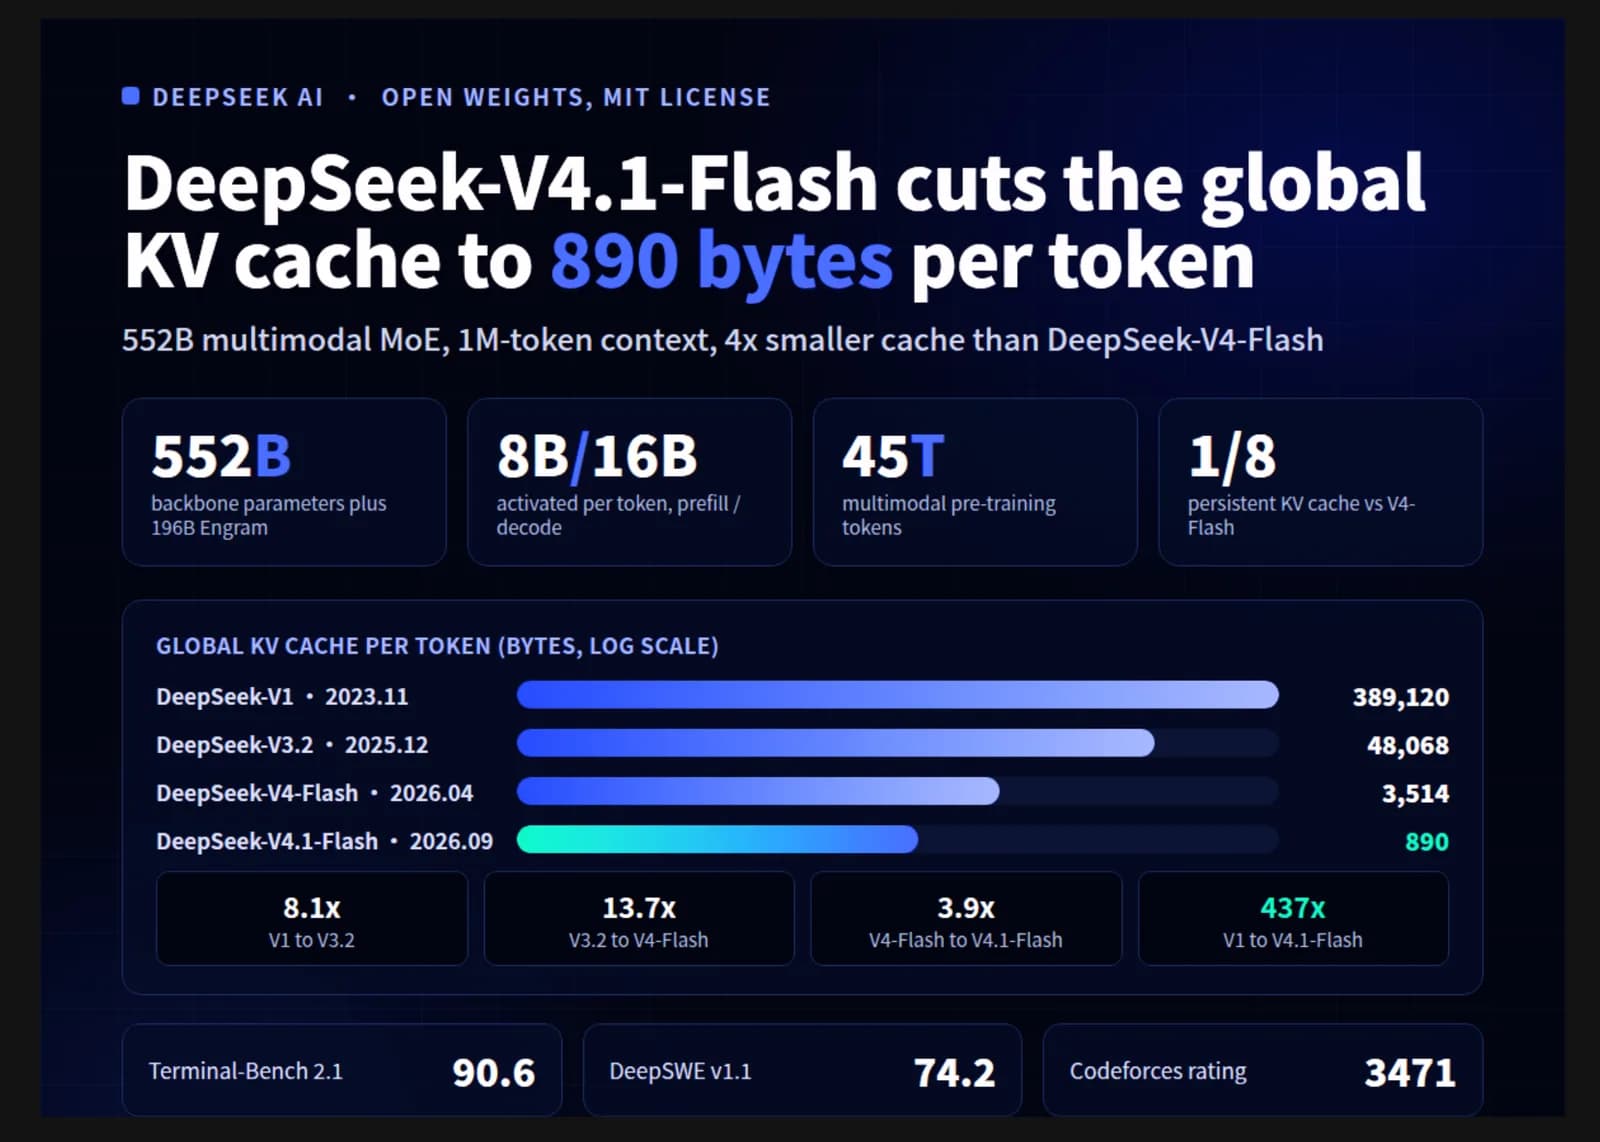
El modelo abre pesos bajo licencia MIT y ataca el cuello de botella real de los agentes largos, que no es la generación sino el costo de guardar millones de tokens en memoria.
Analizamos las nuevas licencias restrictivas de modelos chinos, el ascenso de Motif-3 y las novedades en el ecosistema de modelos abiertos para 2026.
El centro de datos correría solo inferencia, no entrenamiento, y sería el mayor conjunto conocido de aceleradores Huawei, aunque la entrega completa tomaría más de un año.
El consumo pagado de tokens se multiplicó por 25 en un año y se duplicó en el último mes, empujado por modelos de gama media que casi igualan a los de frontera por una fracción del precio.
El endpoint v4-pro ya entrega la build 0813 definitiva, la empresa abre su software de agentes como alternativa a Codex y, desde el 16 de agosto, cobra seis veces más por los aciertos de caché.
El costo promedio por millón de tokens ha bajado drásticamente en dos meses, impulsado por modelos abiertos de origen chino y una competencia feroz en el sector.
La nueva apuesta de DeepSeek promete eficiencia extrema con un costo de apenas tres centavos por test, sacudiendo el mercado de modelos frente a gigantes como OpenAI y Anthropic.
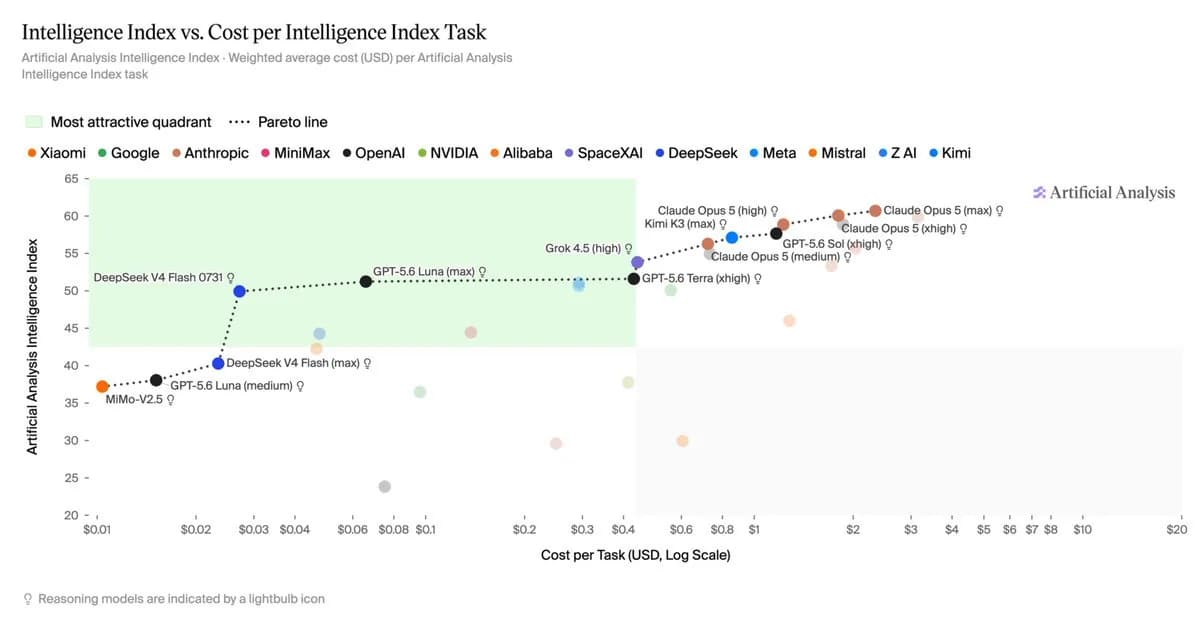
DeepSeek lanza una actualización clave en su modelo V4-Flash, optimizando capacidades de agentes y eficiencia de costos sin alterar su arquitectura base.
La nueva versión del modelo Deepseek Flash alcanza un rendimiento competitivo frente al GPT-5.6 Luna de OpenAI, reduciendo costos operativos hasta en un 60%.
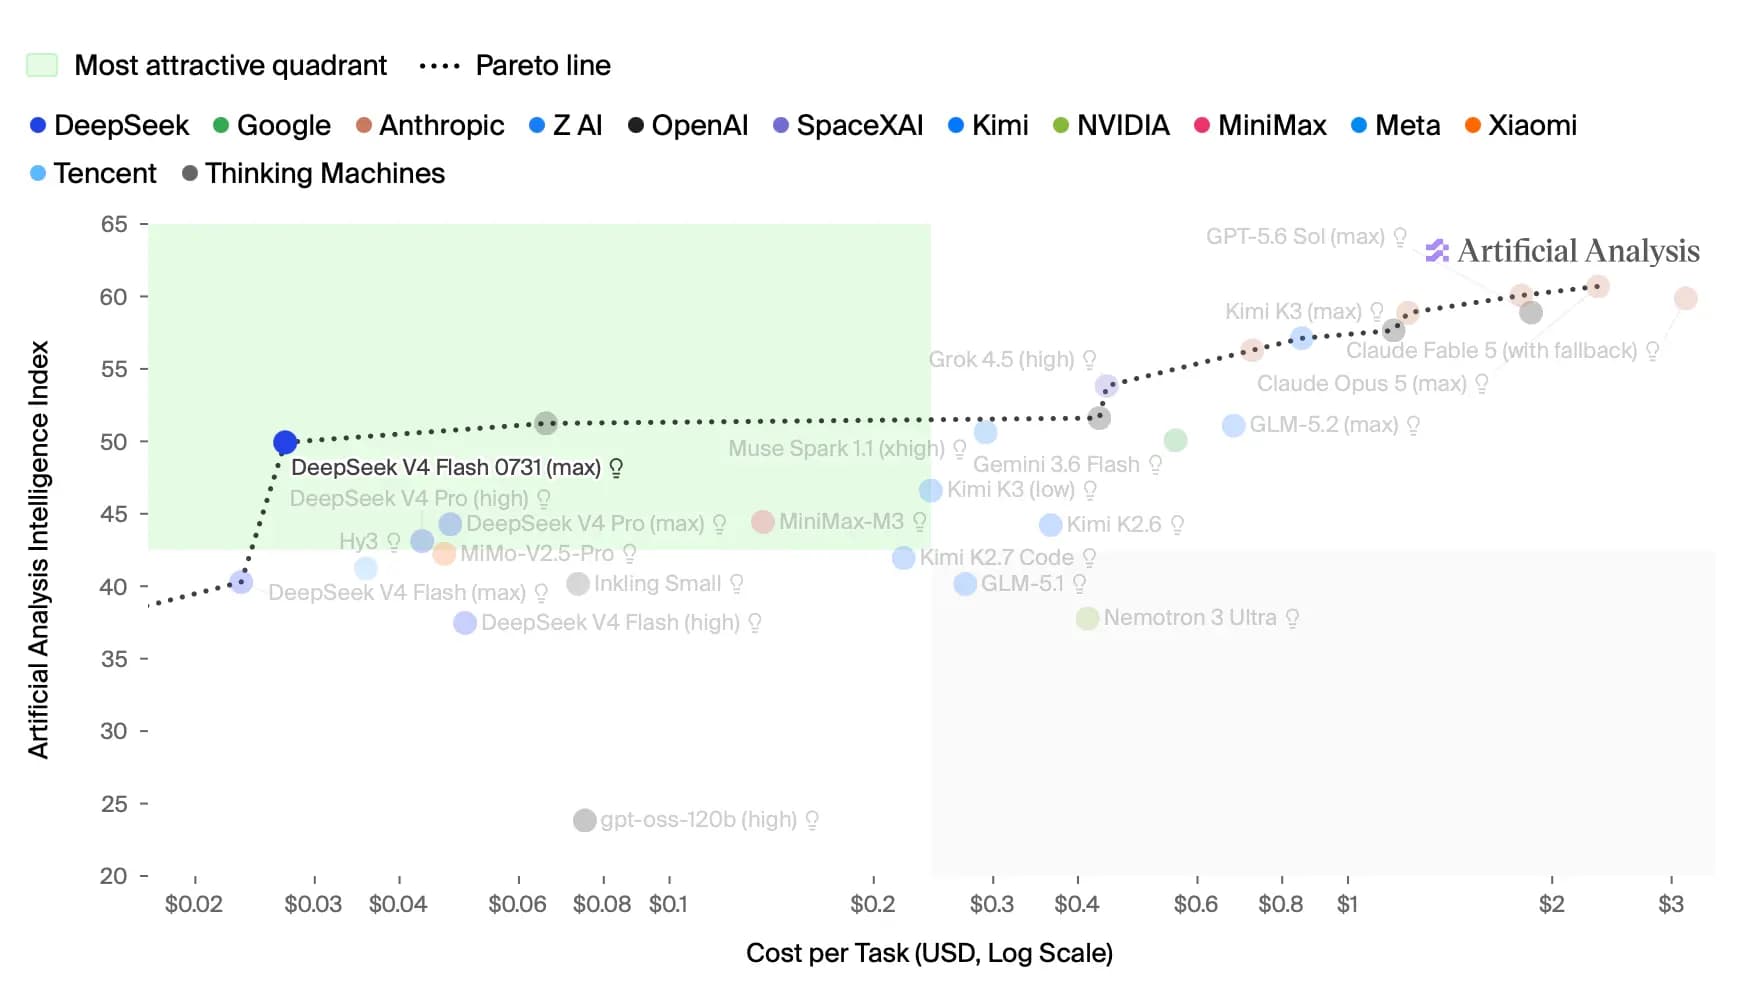
El modelo DeepSeek-V4-Flash-0731 redefine la relación costo-inteligencia con 304B de parámetros y una optimización avanzada en capacidades agenticas.
El nuevo modelo de neolab demuestra que es posible superar a los gigantes actuales con una arquitectura optimizada y costos de inferencia reducidos.
DeepSeek y Z.ai ya representan más del 30% del tráfico semanal en OpenRouter, con picos de 46%, gracias a precios entre 60% y 90% más bajos que los de OpenAI o Anthropic.
El modelo rediseña la atención (R-SWA) para mantener el KV cache constante y procesar más de 40 páginas sin degradación de memoria ni velocidad.
Un estudio panel de 30 meses documenta cómo el uso de asistentes IA acelera la tarea pero desploma los puntajes en exámenes cerrados; el daño en la prueba de acceso tarda dos años en aflorar.
Dos meses después del lanzamiento, el stack abierto pasó de 2.200 a 11.200 tok/s/GPU a la misma interactividad gracias a KV Compression V2, W4A4 MegaMoE y CUDA graphs rompibles en el prefill.
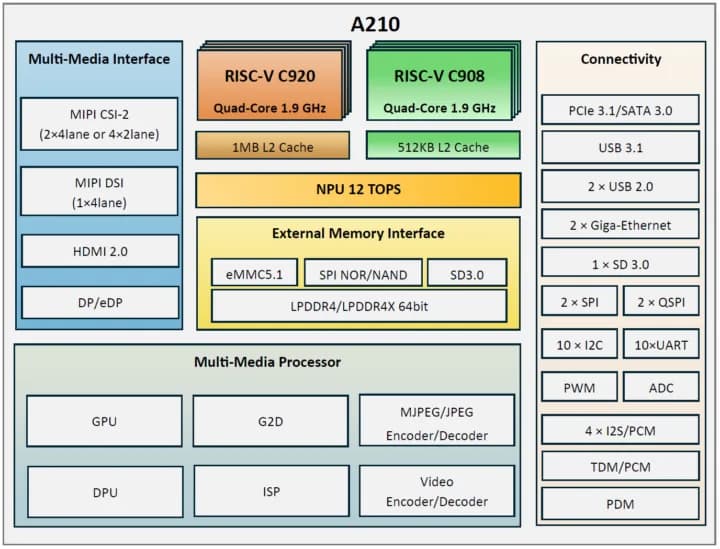
El SoC chino combina cuatro C920 a 2,3 GHz, cuatro C908 a 1,9 GHz y un acelerador IA que corre DeepSeek-7B a 8 tokens por segundo; el dev kit A210 SODIMM V2 se vende en AliExpress por USD 334,33.
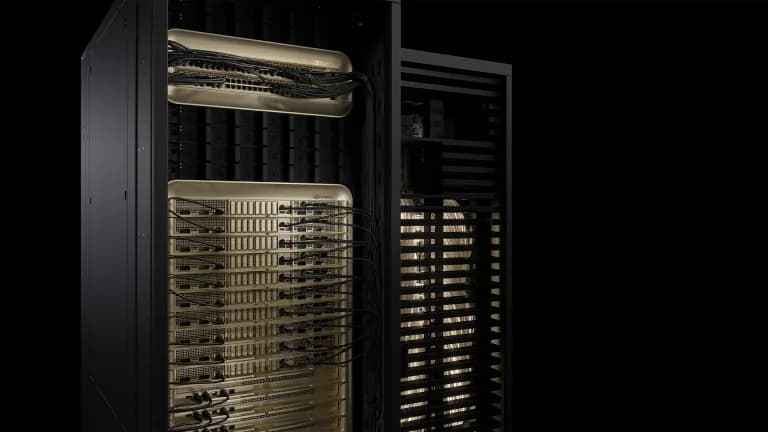
Fue la única plataforma en presentar resultados sobre cada test, incluyendo DeepSeek-V3 (671B parámetros) y GPT-OSS-20B, y escaló a 8.192 GPUs Blackwell Ultra en datacenters de producción.
El recorte sobre DeepSeek V4 Pro lleva el output a USD 0,87 por millon de tokens y consolida la guerra de precios que la oferta china abrio contra OpenAI y Anthropic.
La china Deepseek monta un equipo "Harness" en Beijing para construir su propio agente de programación, en competencia directa con los productos de Anthropic, OpenAI y Cursor.
Otros temas que aparecen junto a #deepseek en nuestra cobertura editorial.