Trabajar con equipos de agentes de IA casi no mejora los resultados frente a un agente solo, y cuesta bastante más. Lo midió la empresa de evaluaciones Vals AI, que puso a prueba a GPT-6 Sol y a Claude Opus 5.5 en el banco de pruebas Vibe Code Bench, informó The Decoder el 11 de octubre.
Cada modelo corrió solo y en equipo, con dos niveles de razonamiento, medio y máximo. Los equipos costaron entre 1,8 y 5,1 veces más que los agentes individuales.
¿Cuándo sirvió el equipo?
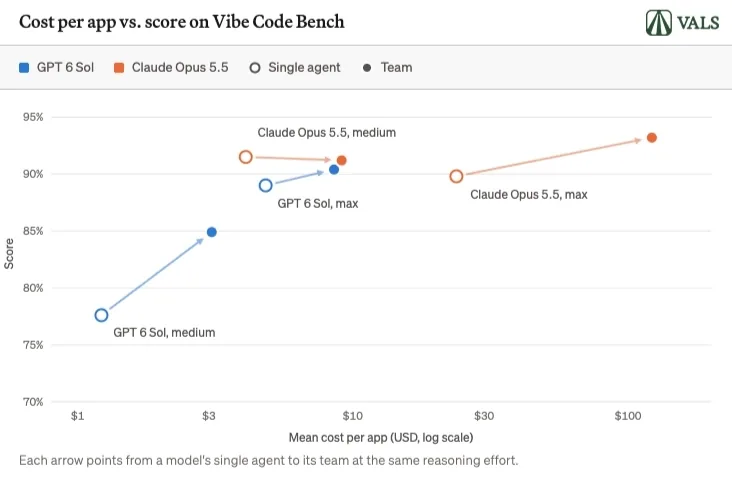
De las cuatro comparaciones entre equipo y agente solo, apenas una mostró una mejora estadísticamente significativa. Fue GPT-6 Sol con razonamiento medio, donde el equipo sacó 7,3 puntos más. Con razonamiento máximo, trabajar en equipo no le dio ventaja real ni a Sol ni a Opus 5.5.
Según los resultados, el costo extra de un equipo de agentes no se justifica en la mayoría de los casos, sobre todo cuando los modelos ya corren con todo el cómputo disponible.
El gráfico de Vals AI cruza el costo por aplicación con el puntaje en Vibe Code Bench. Cada flecha va del agente individual de un modelo a su equipo con el mismo nivel de razonamiento. Los equipos cuestan mucho más y casi no suben el puntaje.
Lo que midió Anthropic con Opus 5.5
Anthropic también vio que las mejoras de calidad se achicaban a medida que sumaba agentes, en dos pruebas propias con Opus 5.5. Los equipos más grandes llegaban antes a cierto nivel de rendimiento, pero pasar de 10 a 100 agentes apenas subió los puntajes después de 24 horas. En otras pruebas, con ProgramBench, la ganancia de velocidad vino acompañada de más consumo de tokens.
| Tarea con Opus 5.5 | 1 agente | 10 agentes | 30 agentes | 100 agentes |
|---|---|---|---|---|
| Base de conocimiento | 0,53 | 0,70 | 0,71 | 0,74 |
| Demostración de teoremas en Lean | 0,39 | 0,66 | 0,66 | 0,68 |
Fable 5.1 mostró mejoras de calidad más marcadas en la tarea de teoremas en Lean por encima de los diez agentes, pero aun así quedó bajo Opus 5.5 en todas las pruebas. En la tarea de base de conocimiento, el puntaje de Fable bajó un poco al pasar de 30 a 100 agentes.
Más agentes compran velocidad
Noam Brown, investigador de OpenAI, confirmó en el pódcast de Dwarkesh Patel que los sistemas de varios agentes compran sobre todo velocidad. Cuatro agentes resolvieron tareas el doble de rápido, pero también costaron el doble. Con 16 agentes el patrón se mantuvo, con una eficiencia un poco menor.
El efecto depende mucho de la tarea. La investigación web y las matemáticas se reparten bien entre agentes, dijo Brown, y escribir una novela no. Ponerle 10.000 agentes a una novela sería tan inútil como ponerle 10.000 personas. Brown reconoció que escalar a cantidades muy grandes de agentes sigue casi sin explorarse porque los costos son demasiado altos.
Eric Provencher, desarrollador de OpenAI, advirtió hace poco contra el uso de enjambres de agentes justamente por eso. A su juicio lo más probable es que sean dinero perdido, porque la coordinación entre agentes se rompe. Lo llamó el impuesto de coordinación.