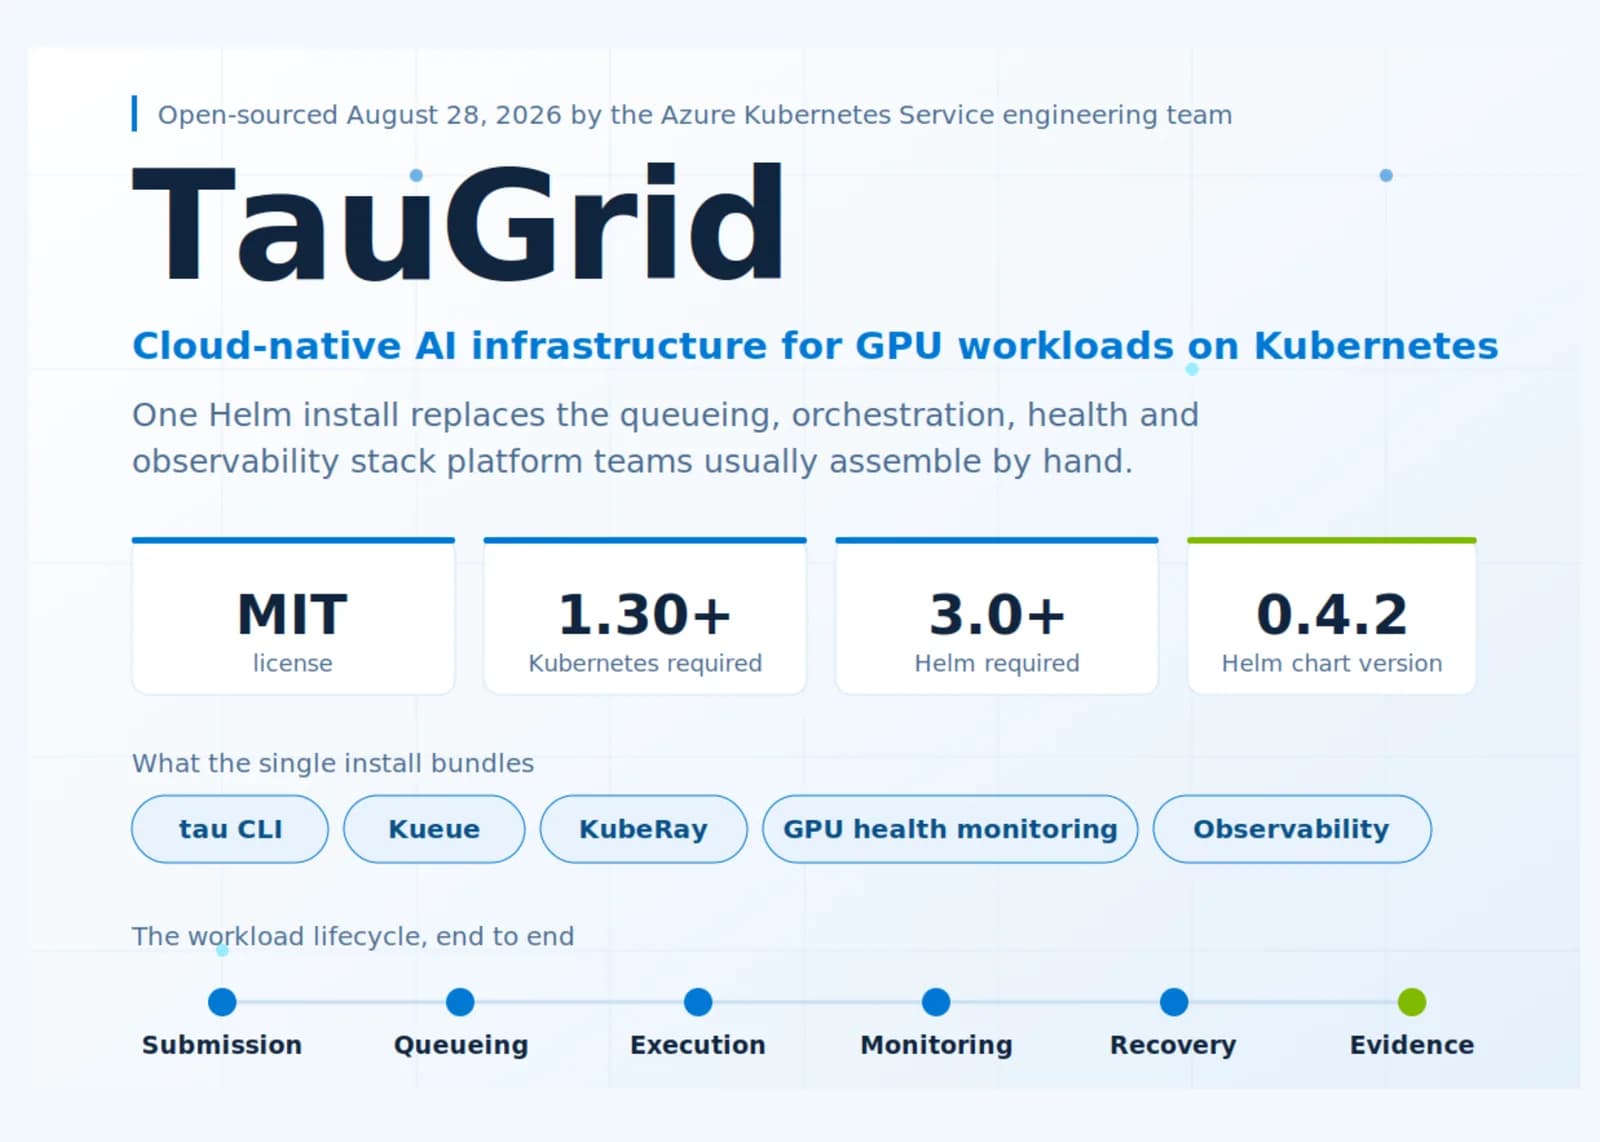
Un equipo de plataforma que corre IA sobre Kubernetes rara vez corre una sola cosa. Corre un sistema de colas, un runtime distribuido, chequeos de salud de los nodos con GPU, tableros y una capa de scripts de envío que sostiene todo lo anterior. El equipo de ingeniería de Azure Kubernetes Service liberó TauGrid, que reduce ese trabajo de ensamblaje a una sola instalación de Helm.
¿Se puede desplegar hoy? Sí. TauGrid está bajo licencia MIT, con imágenes de contenedor y charts de Helm publicados como artefactos OCI públicos en el Microsoft Container Registry. Los requisitos previos son un clúster de Kubernetes 1.30 o superior con nodos GPU, kubectl y Helm 3.0 o posterior.
¿Qué es TauGrid exactamente?
TauGrid es una plataforma autoalojada para correr cargas de IA sobre Kubernetes. Combina cinco cosas que los equipos de plataforma suelen integrar a mano. La CLI tau, el encolado y la admisión de trabajos vía Kueue, la orquestación de clústeres Ray vía KubeRay, el monitoreo de salud de las GPU a nivel de nodo y la observabilidad del clúster y de las cargas.
El reparto de responsabilidades es el punto de diseño. El equipo de plataforma es dueño de los espacios de trabajo, las colas, los perfiles de cómputo, el almacenamiento, la identidad y la observabilidad. Los investigadores trabajan desde un repositorio y la CLI, y envían cargas sin configurar Kubernetes de forma directa. El código está escrito principalmente en Go.
Cómo se mueve un trabajo por dentro
Una carga se describe en un archivo tau.yaml. El ejemplo de entrenamiento con GPU que publicó Microsoft corre un trabajo de PyTorch sobre una sola A100.
schema_version: 1
name: aks-gpu-quickstart
run:
  entrypoint: train.py
  workload_kind: rayjob
compute:
  gpus: 1
  workers: 1
  cpus: 16
  memory: 64Gi
runtime:
  image: mcr.microsoft.com/aks/ai-runtime/ray:py3.12-ray2.56.0-cuda13.0
  pip:
    - torch>=2.4.0
Al ejecutar tau run, TauGrid resuelve la política de la plataforma, genera un Job de Kubernetes o un RayJob de KubeRay y lo envía a través de Kueue. Las seis etapas que documenta Microsoft son envío, encolado, ejecución, monitoreo, recuperación y evidencia. La recuperación cubre reintento, reanudación desde un punto de control y diagnóstico de fallas. Los registros de evidencia guardan los metadatos de la carga, la configuración, los logs, las métricas, los puntos de control y el historial de ejecución, que es lo que permite reproducir y auditar una corrida después.
Cuando varios equipos comparten un clúster, sus trabajos caen en una ClusterQueue común de Kueue. Kueue admite cada uno según cuota y prioridad, y Kubernetes lo coloca sobre GPU sanas.
¿Cuánto pesa la instalación?
La instalación es un chart de Helm que se baja directo desde el registro de Microsoft.
helm install taugrid \
  oci://mcr.microsoft.com/aks/ai-runtime/helm/taugrid \
  --version 0.4.2 \
  --namespace tau-system \
  --create-namespace
Las imágenes propias se publican bajo mcr.microsoft.com/aks/ai-runtime/ para Tau, para el portal de TauGrid y para el controlador central de tau. Microsoft recomienda fijar etiquetas versionadas o digests inmutables en lugar de latest. La CLI se instala desde GitHub Releases en Linux y macOS, con un instalador de PowerShell para Windows amd64. El instalador verifica la suma de comprobación de la entrega y no modifica el PATH.
Hay dos detalles operativos que importan a cualquiera que evalúe esto fuera de Azure. El primero, TauGrid no envía telemetría a Microsoft por omisión, y la exportación remota queda apagada salvo que un operador configure un destino. El segundo, algunas integraciones siguen siendo específicas de Azure, en particular la observabilidad a través de Azure Data Explorer. La intención declarada es soportar Kubernetes en la nube y en instalaciones propias sin depender de Azure, y las contribuciones en esa dirección están abiertas.
Lo que hay que retener
- Microsoft liberó TauGrid el 28 de agosto de 2026, bajo licencia MIT, en Azure/taugrid.
- Una sola instalación de Helm agrupa la CLI
tau, el encolado de Kueue, la orquestación de KubeRay, el monitoreo de salud de las GPU y la observabilidad. - Se despliega ya sobre cualquier clúster Kubernetes 1.30 o superior con nodos GPU,
kubectly Helm 3.0 o posterior. - Los registros de evidencia guardan configuración, logs, métricas y puntos de control, así que una corrida se puede reproducir.
- No hay telemetría por omisión, aunque la observabilidad con Azure Data Explorer sigue atada a Azure por ahora.
El anuncio está en el blog de ingeniería de AKS y el código en Azure/taugrid en GitHub.