Saltar al contenido
Etiqueta

#pytorch

11 notas publicadas

Helion entra al backend lineal de vLLM y supera a CUTLASS en Hopper
IA

Helion entra al backend lineal de vLLM y supera a CUTLASS en Hopper

Un solo kernel GEMM escrito en Helion cubre las variantes estándar, Split-K y Swap-AB, y el autoajuste elige la mejor para cada forma de entrada.

PyTorch Blog
Meta supera a FlashAttention-4 en Blackwell con un kernel escrito en Tri
IA

Meta supera a FlashAttention-4 en Blackwell con un kernel escrito en Tri

El kernel de atención irregular de su modelo de anuncios GEM, escrito con las extensiones TLX, mide 3.200 líneas y gana 13% en la pasada hacia adelante y 50% en la de retropropagación.

PyTorch Blog
vLLM agrega capas portables a 3,4% del rendimiento nativo
IA

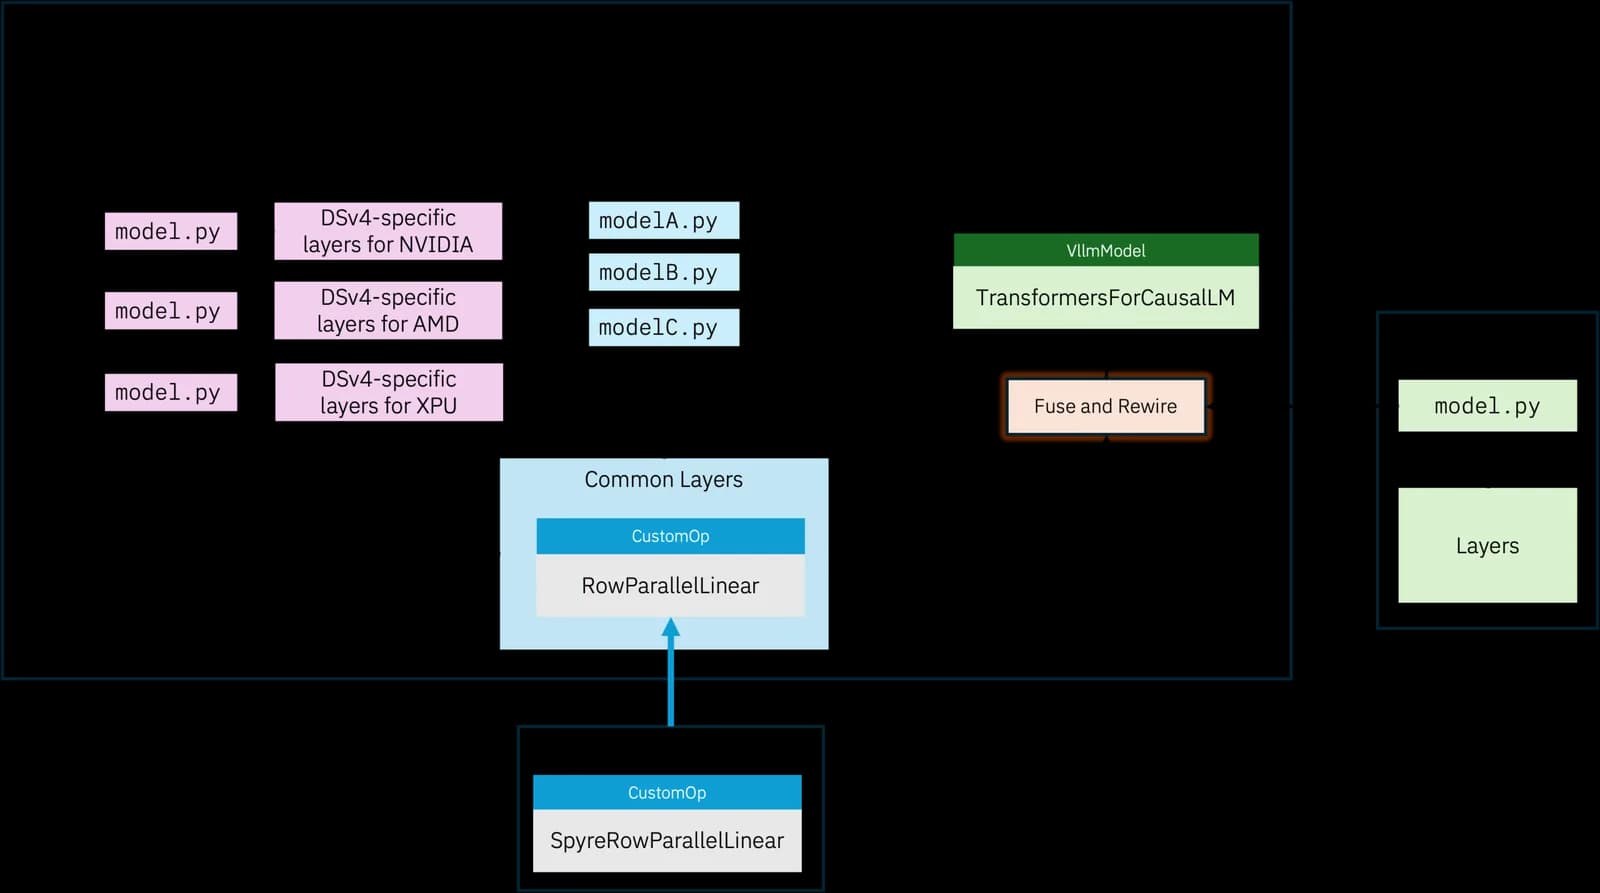
vLLM agrega capas portables a 3,4% del rendimiento nativo

El motor de inferencia rompió la compatibilidad con torch.compile para correr más rápido en las GPU nuevas, y ahora construye un camino aparte para las viejas.

PyTorch Blog
Shopify recorta en 96% el costo de su agente GraphQL
IA

Shopify recorta en 96% el costo de su agente GraphQL

El circuito convierte a diario las conversaciones que fallan en producción en datos de entrenamiento, y el modelo especializado terminó superando al de frontera.

PyTorch Blog
Transformers ya corre los modelos GGUF de llama.cpp
IA

Transformers ya corre los modelos GGUF de llama.cpp

La integración reutiliza los kernels de ggml, parte por los Mac con Apple Silicon y arranca con la arquitectura Qwen3.5.

Hugging Face
Helion llega al hub de kernels de Hugging Face
IA

Helion llega al hub de kernels de Hugging Face

El lenguaje de dominio específico de PyTorch para escribir kernels de alto rendimiento ya se puede empaquetar, autoajustar y distribuir desde el Hub, con configuraciones preajustadas incluidas.

PyTorch Blog
Alibaba Cloud, Ant Group y Cambricon entran a PyTorch
IA

Alibaba Cloud, Ant Group y Cambricon entran a PyTorch

La conferencia en Shanghái sumó tres miembros a la fundación y dejó una cifra que ordena el panorama: los modelos de pesos abiertos chinos pasaron del 2 al 45 por ciento del tráfico en OpenRouter.

PyTorch Blog
Muse Glimmer en ExecuTorch: 33 tok/s en un Mac M5 Pro
IA

Muse Glimmer en ExecuTorch: 33 tok/s en un Mac M5 Pro

PyTorch habilita el modelo abierto de 30 mil millones de parámetros de Meta en GPU NVIDIA y Mac con silicio de Apple, con decodificación especulativa DFlash y contexto de 128K tokens.

PyTorch Blog
torch.profiler explicado: cómo leer trazas en PyTorch desde cero
IA

torch.profiler explicado: cómo leer trazas en PyTorch desde cero

Hugging Face abre una serie de tres partes sobre profiling con PyTorch, empezando por matmul más bias en bf16 sobre una NVIDIA A100 80GB.

Hugging Face
PyTorch 2.11 arregla pip install torch para GB200 y GH200
IA

PyTorch 2.11 arregla pip install torch para GB200 y GH200

El nuevo wheel CUDA para aarch64 ya viaja en el índice por defecto de PyPI, cerrando dos años de --index-url y reinstalaciones silenciosas que rompían vLLM en Grace Hopper.

PyTorch Blog

Etiquetas relacionadas

Otros temas que aparecen junto a #pytorch en nuestra cobertura editorial.