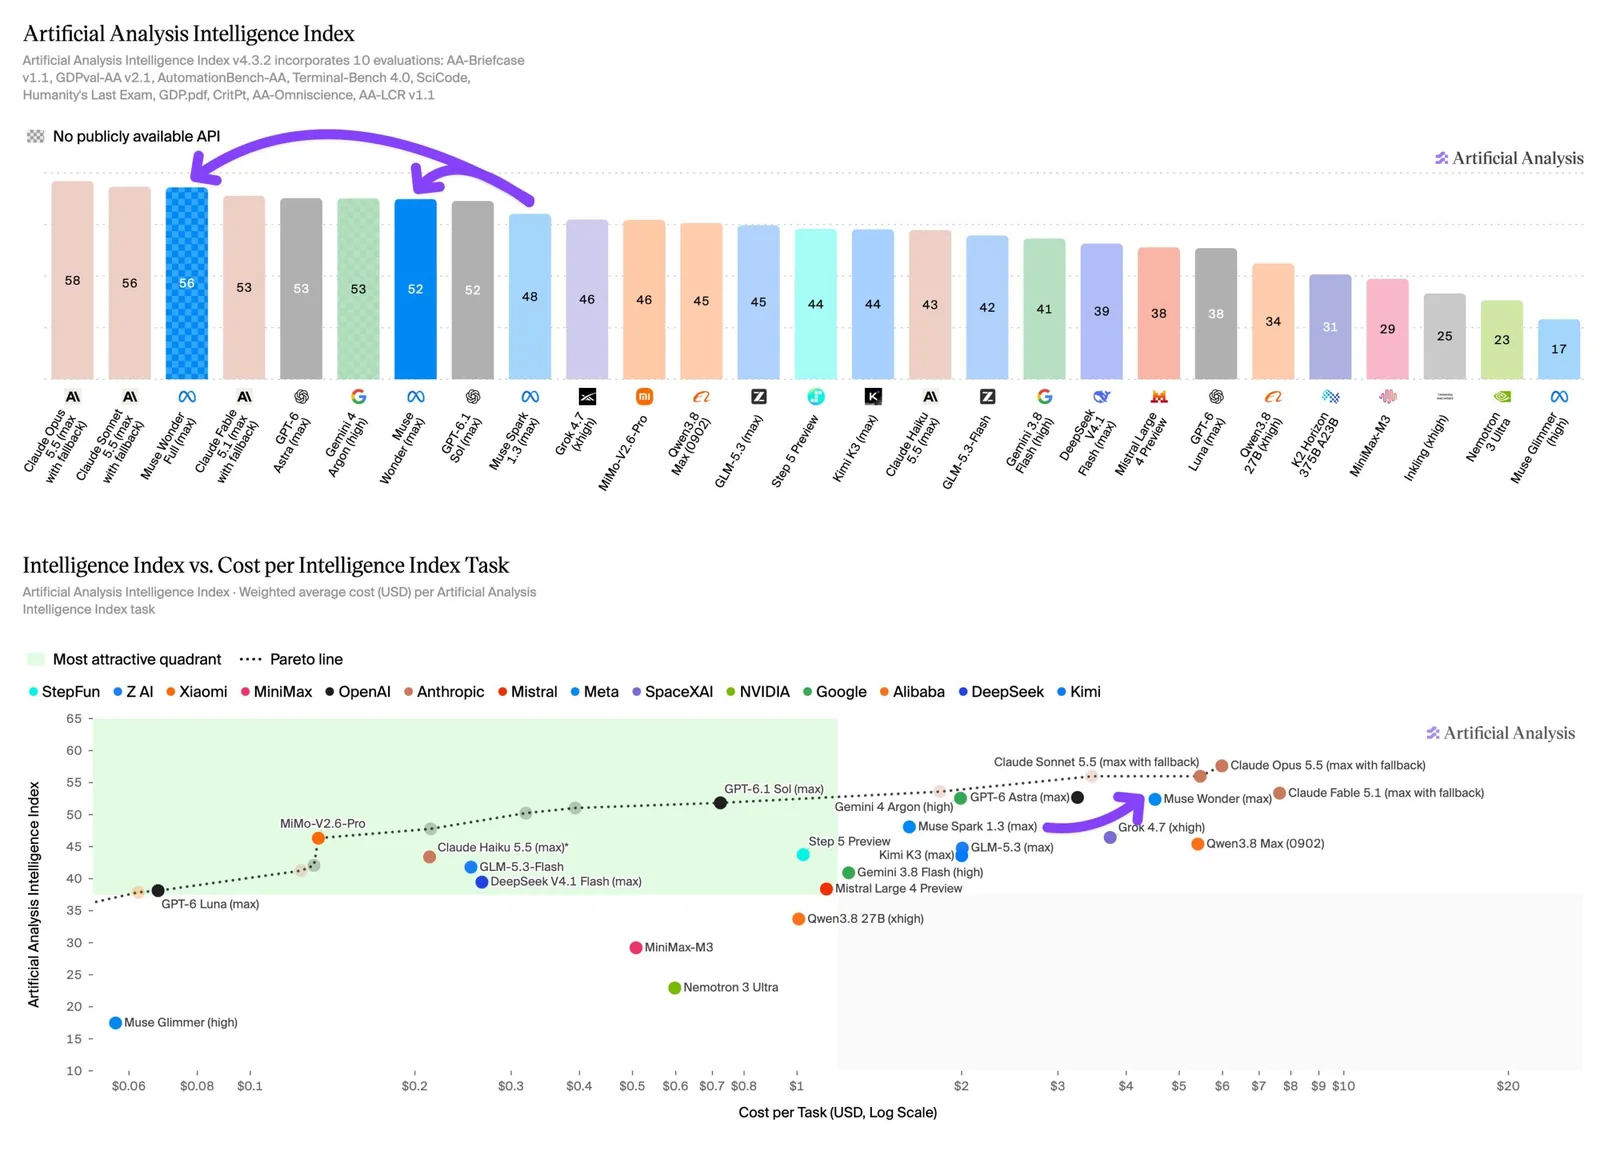
Muse Wonder Full marca 56 puntos en el Intelligence Index v4.3 de Artificial Analysis y Muse Wonder, la variante menor, llega a 52. Meta lanzó las dos versiones de su modelo de frontera el 12 de octubre, según The Decoder, y ambas quedan entre los mejores modelos de IA disponibles. Su antecesor, Muse Spark 1.3, estaba en 48 puntos, o sea en la zona media de la tabla.
El salto más grande aparece en las evaluaciones agénticas, las pruebas que miden cuán bien resuelve un modelo tareas complejas por su cuenta. En Terminal-Bench 4.0 el resultado pasó de 33% a 57%. Muse Wonder Full queda entre los tres primeros en seis de diez benchmarks. Para Meta es un buen resultado tras una etapa floja con sus modelos abiertos Llama.
Memoria activa y foco activo
Meta destaca dos funciones nuevas. Active Memory permite que el modelo recuerde información importante entre conversaciones y la recupere cuando la necesita. Active Focus es su capacidad de insistir con tareas difíciles, probar caminos alternativos y hacer preguntas cuando algo no está claro. Las dos son el centro de la propuesta de Meta para un agente personal con acceso al calendario, los mensajes y los documentos del usuario.
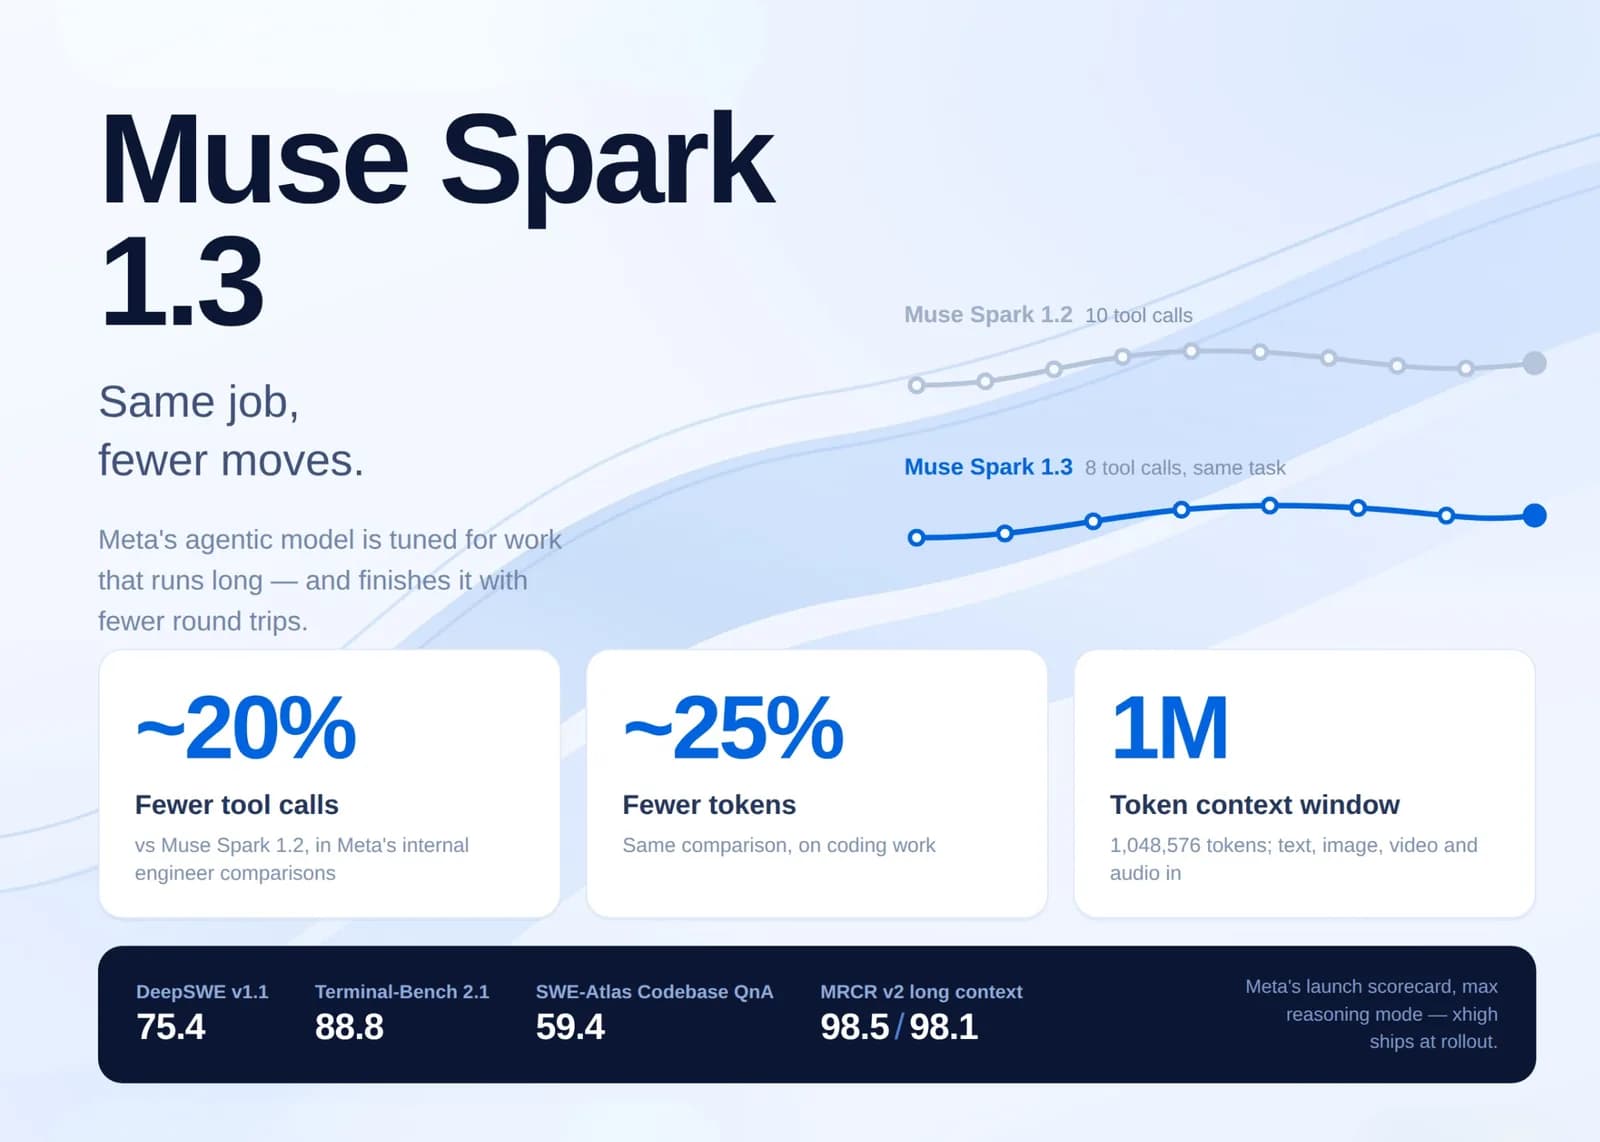
Ambos modelos tienen una ventana de contexto de un millón de tokens y aceptan texto, imágenes, video y audio como entrada. Muse Wonder está disponible por la API de Meta y en Muse Code. Muse Wonder Full, por ahora, solo en Muse Code. Muse Wonder llegará pronto a la aplicación Muse, primero para los suscriptores de pago, y Meta planea derivar de él modelos especializados para todos los usuarios.
¿Dónde mejora y dónde se queda atrás?
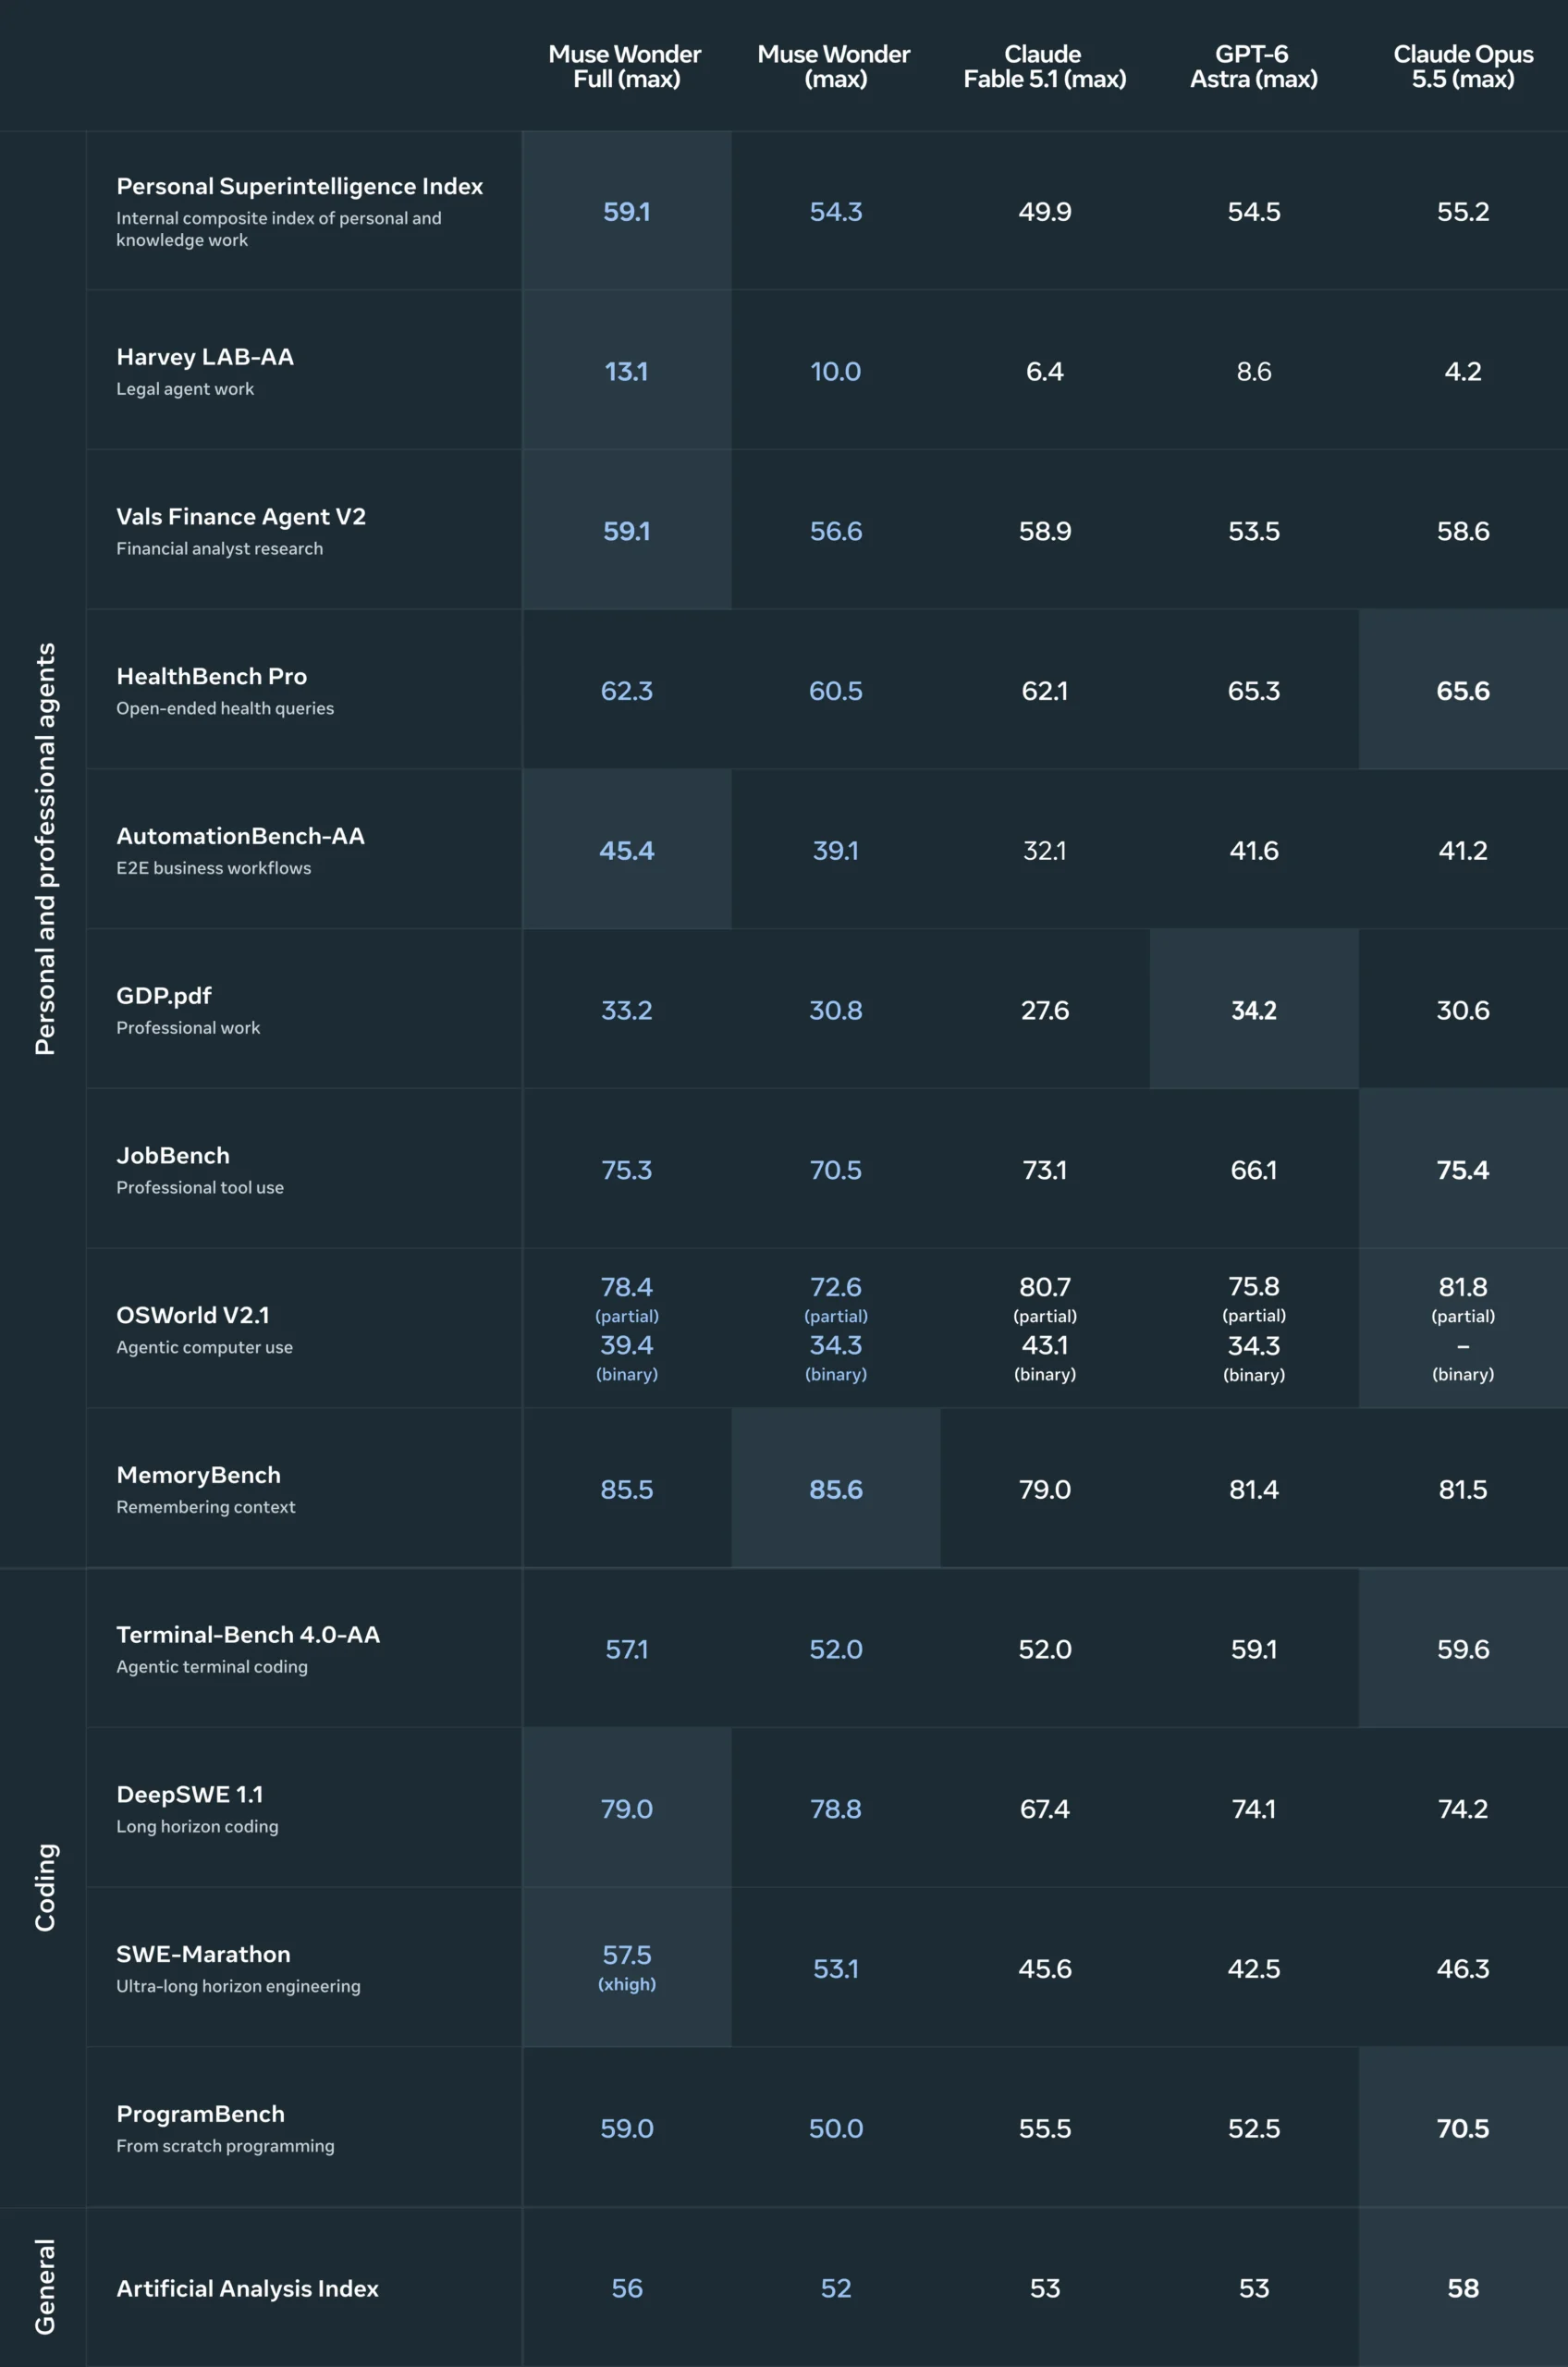
Los dos modelos dan un salto en programación. Muse Wonder Full llega a 68 puntos en el Coding Agents Index, el mismo puntaje de Claude Code con Sonnet 5.5. Muse Wonder saca 63, contra 54 de su antecesor.
El conocimiento factual sigue siendo el punto débil. En la prueba AA-Omniscience, Muse Wonder Full consigue 30 puntos y Muse Wonder 25.
| Modelo | AA-Omniscience |
|---|---|
| Claude Opus 5.5 | 46 |
| GPT-6 Astra | 43 |
| Gemini 4 Argon | 42 |
| Muse Wonder Full | 30 |
| Muse Wonder | 25 |
Según The Decoder, esa distancia sugiere que la serie Wonder se apoya en un modelo base más pequeño que el de sus competidores. La tasa de alucinación compensa en parte. Muse Wonder Full la baja de 33% a 23% frente a su antecesor, la segunda más baja entre los modelos que superan los 45 puntos del índice. Solo Gemini 4 Argon, con 15%, alucina menos.
Meta responde en su blog a una crítica frecuente, la de que los modelos Muse están afinados para los benchmarks y fallan en el uso real. La empresa asegura que Muse Wonder Full rinde mejor de lo esperado en tareas desconocidas que no formaron parte de la optimización del entrenamiento, y lo atribuye a un modelo base más sólido.
En el Vals AI Index, Muse Wonder Full (en modo Max) debuta en el quinto lugar y supera a todos los modelos de OpenAI, según Vals AI. Solo los modelos actuales de Anthropic puntúan más alto. Muse Wonder queda décimo.
Las mejoras más grandes están en programación y matemáticas. En ProofBench, una prueba privada de demostraciones matemáticas, Muse Wonder Full resuelve 94 de 100 problemas, contra 58 de su antecesor, y queda a cinco o seis puntos de los mejores modelos (entre 99 y 100). En Terminal-Bench 4 duplicó su puntaje usando 30% menos tokens de salida. En tareas de finanzas y derecho se mantuvo en el nivel anterior, con caídas de hasta dos puntos.
¿Cuánto cuesta usarlo?
Según Artificial Analysis, Muse Wonder cuesta 4,52 dólares por tarea en el Intelligence Index, casi el triple que Muse Spark 1.3 (1,60 dólares). El precio por token también subió, a 4 dólares por millón de tokens de entrada y 20 de salida, contra 1,25 y 4,25 del antecesor. Muse Wonder además usa 28% más tokens de entrada por tarea, y esos tokens explican el 76% del costo total.
| Modelo | Costo por tarea en el índice |
|---|---|
| Claude Fable 5.1 | 7,63 dólares |
| Claude Opus 5.5 | 5,98 dólares |
| Muse Wonder | 4,52 dólares |
| GPT-6 Astra | 3,26 dólares |
| Gemini 4 Argon | 1,99 dólares |
| Muse Spark 1.3 | 1,60 dólares |
| GPT-6.1 Sol | 0,72 dólares |
Muse Wonder Full todavía no tiene precio por token publicado. Las dos versiones usan cerca de 10% menos tokens de salida que su antecesor.
Meta dice que entrenó los modelos en Prometheus, su centro de datos propio de escala de gigavatios. Los detalles técnicos están en la ficha del modelo que publicó la empresa.