Meta presentó Muse Wonder y Muse Wonder Full, la familia de modelos con que Meta Superintelligence Labs (MSL) dice haber llegado a la frontera de la IA. Latent Space, que venía siguiendo los 14 meses de MSL para convertirse en un laboratorio de primera línea, lo resumió así en su boletín AINews. Wonder completa la línea que abrieron Spark y Glimmer, igual que OpenAI tiene Sol, Terra y Luna, y Anthropic tiene Opus, Sonnet y Haiku.
Meta no declara el tamaño del modelo. Wonder Full le gana a Fable y a Astra en algunos benchmarks, y con distintos grados de postentrenamiento no queda claro si Wonder pertenece a esa misma clase o no. El detalle técnico está en el blog de investigación de Meta.
La previa y los dos modelos
Horas antes del lanzamiento, varias personas de la empresa publicaron adelantos con sandías. Entre ellas estaban @rpnickson ("It is a BIG watermelon..."), @alexandr_wang y @finkd, la cuenta de Mark Zuckerberg ("Muse ordered me"). La cuenta @kimmonismus difundió precios filtrados por @synthwavedd. Hablaba de 4 dólares por millón de tokens de entrada y 20 de salida, ventana de un millón de tokens y el nivel de razonamiento máximo, Wonder Full, reservado a los planes Power y Maximum Usage de MuseCode.
Zuckerberg anunció la familia y explicó que Muse Spark fue la primera familia de MSL y que Wonder es "a much larger and more advanced class of models that brings us to the frontier". Son dos lanzamientos. Muse Wonder es el modelo rápido de frontera y Muse Wonder Full es el modelo completo.
¿Dónde se puede usar cada uno?
La disponibilidad está dividida, según @AIatMeta y la cuenta de prensa de Meta.
- Wonder está disponible en la Meta Model API y en Muse Code.
- Wonder Full está disponible solo para suscriptores de Muse Code.
- Wonder moverá el producto de agente personal Muse, primero para suscriptores, según Zuckerberg.
- Muse Code se instala con
curl dev.meta.ai/install.sh | bash, según Wang.
Meta presenta los modelos como el estado del arte para "trabajo agéntico personal y profesional". Alexandr Wang nombró tres funciones principales.
- Active Memory, memoria que se mantiene durante días, semanas y meses.
- Active Focus, que trabaja a través de los bloqueos para terminar las tareas.
- Conocimiento de dominio, con estado del arte en finanzas y derecho, y "strong in health".
Entrenamiento, seguridad y una falla del primer día
Wang dice que Meta siguió escalando tanto el preentrenamiento como el aprendizaje por refuerzo desde que salió Muse Spark en abril (publicación). @AIatMeta lo describió como pasar "from rebuilding our foundation to pushing the frontier in 14 months".
En seguridad, @AIatMeta afirma que la familia se entrenó para resistir instrucciones adversarias y para manejar con cuidado la información privada. Meta no publicó una ficha de sistema detallada.
El día del lanzamiento, Wonder y Wonder Full consumían las cuotas de Muse Code a una velocidad anormal (Wang). Se corrigió el mismo día y Meta reinició la cuota de todos los usuarios (corrección). Wang reconoció que "there's definitely still issues we're trying to iron out" (publicación).
Zuckerberg y Wang fueron además al pódcast Cheeky Pint de Stripe (@collision). Los capítulos tocan la apuesta de 100.000 millones de dólares, el comercio agéntico, OpenRouter, por qué la IA no será un mercado donde el ganador se lleva todo y la estructura interna de MSL.
Lo que dicen las evaluaciones independientes
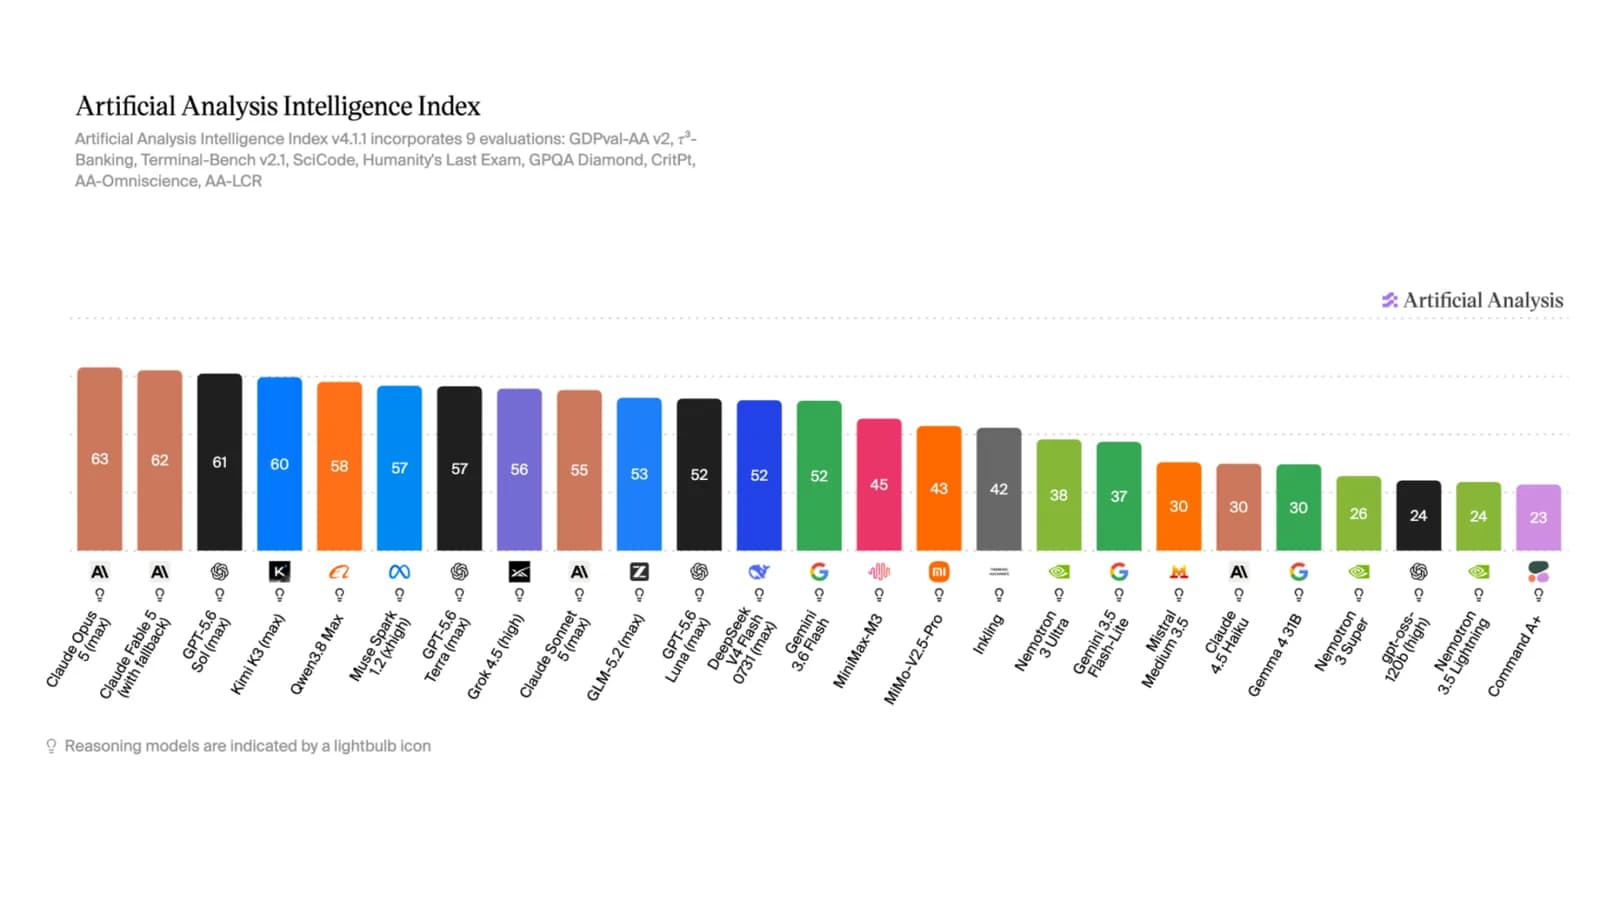
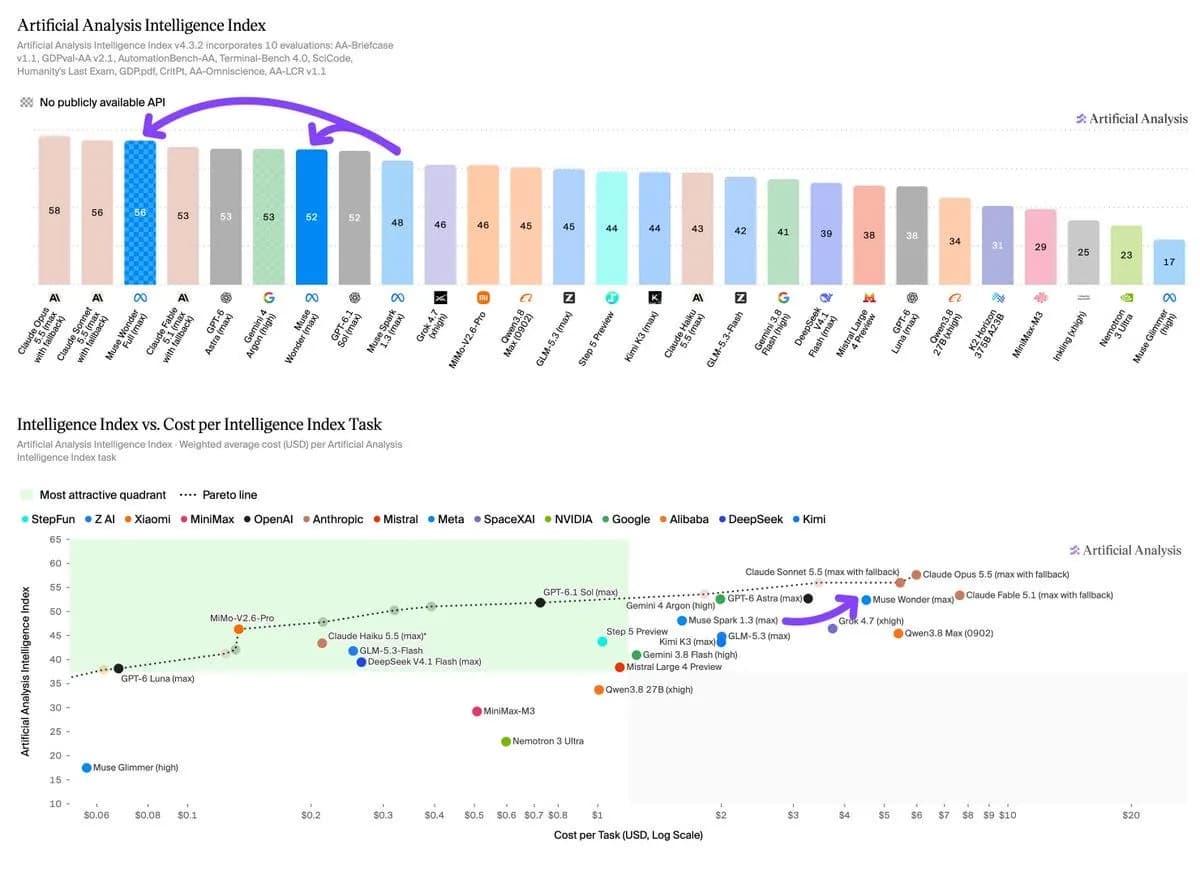
En el Intelligence Index v4.3, Wonder Full en modo máximo marca 56 puntos y Wonder marca 52. Muse Spark 1.3 en modo máximo marcaba 48, y entre Spark 1.3 y los Wonder pasaron solo seis semanas. Claude Opus 5.5 lidera con 58, según @TheRundownAI.
Wonder Full mejoró en las diez evaluaciones del índice. Las mayores alzas fueron en tareas agénticas:
- Terminal-Bench 4.0, de 33% a 57%.
- GDPval-AA v2.1, de 1.681 a 1.857 Elo.
- AA-Briefcase, de 1.581 a 1.729 Elo.
Wonder Full queda entre los tres primeros en 6 de las 10 evaluaciones. Es primero en GDP.pdf (33%) y en CritPt (33%), segundo en GDPval y tercero en AA-Briefcase, AutomationBench-AA (71%) y SciCode (63%). El Wonder normal sube en Terminal-Bench de 33% a 52% y en AutomationBench de 58% a 68%.
Los dos modelos usan cerca de 54.000 tokens de salida por tarea del índice, alrededor de 10% menos que los 60.000 de Spark 1.3. Gemini 4 Argon usa 62.000, Fable 5.1 usa 78.000, GPT-6.1 Sol usa 38.000 y GPT-6 Astra 27.000. En entrada, Full usa 6,44 millones de tokens y Wonder 7,69 millones.
¿Cuánto cuesta cada tarea?
Wonder cuesta 4,52 dólares por tarea del índice, empujado por su alto consumo de entrada. Wonder Full no tiene precio publicado por token, así que su costo no se puede calcular. La misma comparación lista estos valores.
| Modelo | Costo por tarea |
|---|---|
| Fable 5.1 | 7,63 dólares |
| Opus 5.5 | 5,98 dólares |
| Sonnet 5.5 | 5,46 dólares |
| Muse Wonder | 4,52 dólares |
| Astra | 3,26 dólares |
| Argon | 1,99 dólares |
| Muse Spark 1.3 | 1,60 dólares |
| Sol | 0,72 dólares |
En el Coding Agents Index, Wonder Full dentro de Muse Code marca 68 puntos. Empata con Claude Code y Sonnet 5.5 (68) y supera a Opus 5.5 (66). Wonder marca 63 y Spark 1.3 había marcado 54.
Las especificaciones son contexto de un millón de tokens, entrada de texto, imagen, video y audio, y salida solo de texto. El precio es de 4 dólares por millón de tokens de entrada, 0,20 por entrada en caché y 20 por salida.
Vals AI y otras mediciones externas
En el índice de Vals AI, Wonder Full en modo máximo queda quinto, 6,4 puntos sobre su antecesor y por delante de todos los modelos de OpenAI. En ProofBench, una prueba privada, saca 94 de 100 contra 58 de Spark 1.3, y los mejores modelos sacan entre 99 y 100 (publicación). En Terminal-Bench 4 más que duplicó su resultado y empató con Fable 5.1 en el cuarto lugar (publicación).
Wonder Full usó cerca de 30% menos tokens de salida en Terminal-Bench, 40% menos en ProofBench y la mitad de los pasos en Vibe Code Bench para el mismo resultado (publicación). Wonder quedó décimo, con 7,9 puntos de alza (publicación). Tarda unos 37 minutos por tarea contra 57 de Full, marca 62,6% en Code Migration (sexto lugar) y sube 38,9 puntos en Terminal-Bench 4 con cerca de 20% menos tokens.
| Benchmark | Wonder Full | Comparación |
|---|---|---|
| SWE-Marathon | 57,5% | Opus 5.5 46,3%, GPT-6 Astra 42,5% |
| DeepSWE v1.1 | 79,0% | Opus 74,2%, Astra 74,1% |
| Harvey LAB | 13,1 | Astra 8,6 |
| MemoryBench | 85,5 | Opus 81,5 |
Hubo más señales de terceros.
- Cline confirma que Wonder lidera DeepSWE.
- Ofir Press destacó sus resultados en ProgramBench.
- @iScienceLuvr indica que en HealthBench Pro queda a la par de Fable 5.1.
- Aravind Srinivas, de Perplexity, dice que se compara bien con Fable 5.1 en las evaluaciones WANDR de su empresa.
- Arena lo sumó a Agent Arena y Code Arena, con puntajes todavía pendientes.
Lo que cuentan desde adentro de MSL
Meta subrayó varios puntos. La eficiencia en tokens es el mayor avance, Wonder tuvo cero rechazos en sus benchmarks de ciberseguridad y superó ahí a Full, y MSL dice haber hecho "serious progress on alignment". Los modelos ejecutan bien, pero tienen menos intuición para el descubrimiento científico, y sus resultados en el índice RSI siguen pendientes. La acción de Meta subió 3% ese día.
Meta también mostró su rendimiento en tareas sin postentrenamiento contra tareas postentrenadas, como prueba de que no se optimizó para los benchmarks. @giffmana lo destacó a favor, y @scaling01 confirmó que el gráfico es de Meta. @ren_hongyu y @jack_w_rae resaltaron las mejoras fuera de distribución sobre Spark 1.3.
El relato interno más detallado fue el de Shuchao Bi.
- El objetivo de optimización es el "empoderamiento personal" y no la automatización de empleos.
- Hubo mucho trabajo en seguir instrucciones durante horizontes muy largos.
- El modelo se entrenó explícitamente contra la "flojera", para que insista antes de rendirse.
- MSL definió y calificó comportamientos, e invirtió en alineamiento para contrarrestar el reward hacking bajo alta presión de optimización.
- Según Bi, el modelo resuelve al primer intento la mayoría de los problemas de la Olimpiada Internacional de Matemática y algunos problemas de investigación abiertos con andamiaje.
Bi contó por separado que lo usa para trámites de inmigración, comprar una casa y planificar una herencia (publicación).
Wang, por su parte, dice que la investigación "starts with evals". MSL construyó un índice interno, el Personal Superintelligence Index (PSI), en vez de perseguir benchmarks externos, y afirma tener cuantificado el "big model smell" (publicación).