La firma de análisis SemiAnalysis publicó GDPx, un benchmark que no le hace preguntas de conocimiento a los agentes de IA. Los mete en entornos de trabajo simulados. Ahí pasan hasta ocho horas manejando software profesional como Siemens NX, buscando información en salas de datos con miles de archivos o atacando sistemas empresariales en vivo. Ningún modelo superó el 12%.
SemiAnalysis marca distancia con GDPval de OpenAI. Según la firma, esa prueba entrega todo el contexto en el prompt y no tiene un entorno de trabajo realista.
Las 206 tareas cubren once dominios, entre ellos diseño de chips, biología, trading cuantitativo, ciberseguridad y derecho. SemiAnalysis dejó fuera a propósito la administración y los seguros. El equipo sostiene que el primer billón de dólares en ingresos de la IA vendrá de las industrias donde la IA de frontera rinde más.
El ranking general de GDPx promedia los resultados de los once dominios, con el mismo peso para cada uno.
¿Qué modelo ganó y cuánto cuesta cada tarea?
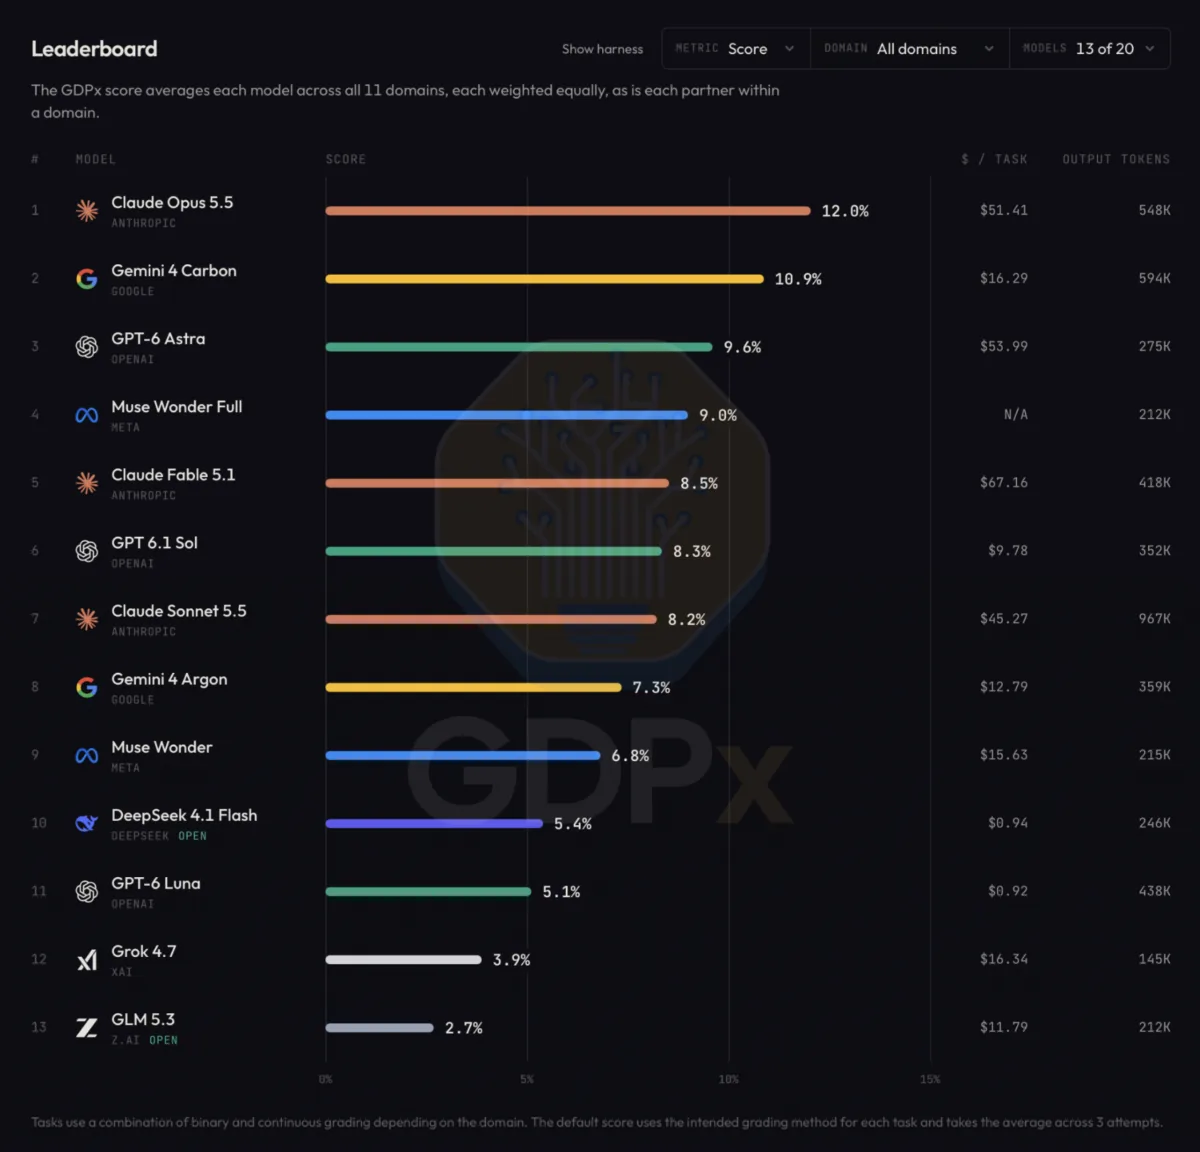
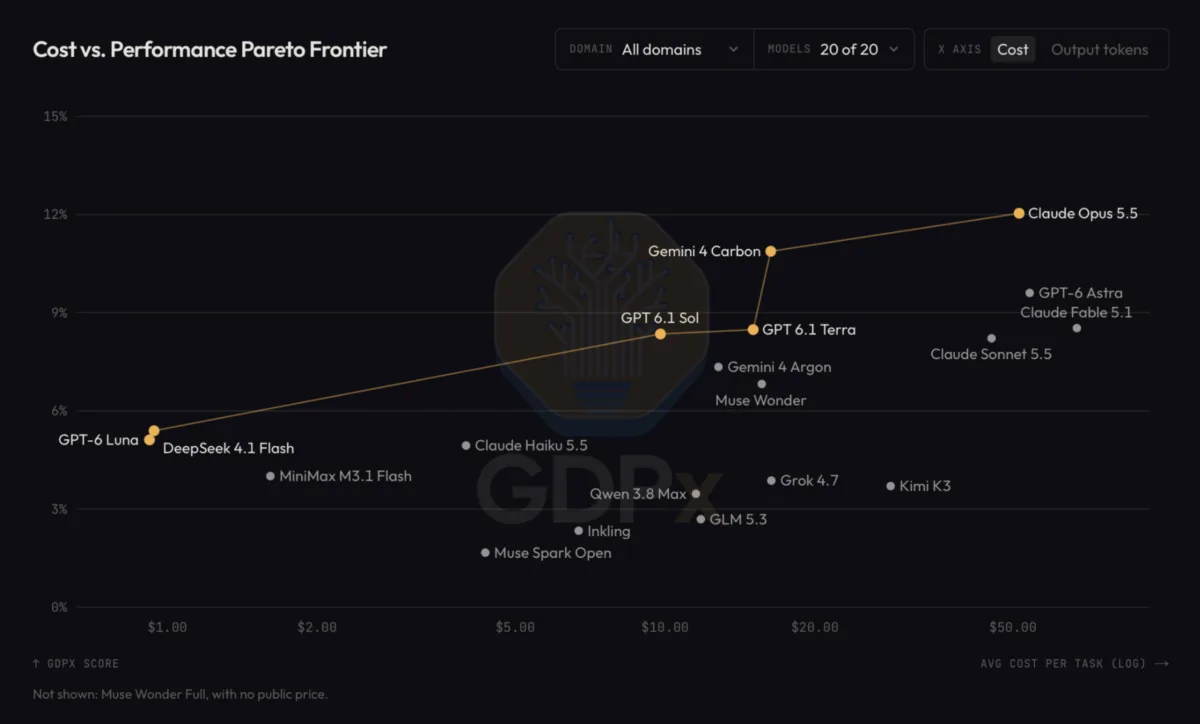
Según SemiAnalysis, Claude Opus 5.5 encabeza la tabla con 12%. Gemini 4 Carbon lo sigue con 10,9%, pero cuesta apenas 16,29 dólares por tarea, cerca de un tercio del precio. GPT-6 Astra quedó con 9,6%.
| Modelo | Puntaje en GDPx |
|---|---|
| Claude Opus 5.5 | 12% |
| Gemini 4 Carbon | 10,9% |
| GPT-6 Astra | 9,6% |
| GPT-6 Luna y DeepSeek 4.1 Flash | cerca de 5% |
En el extremo bajo, GPT-6 Luna y DeepSeek 4.1 Flash rondan el 5% por cerca de un dólar por tarea. Muse Wonder Full no aparece en la comparación de costos porque no tiene precio público.
Ningún modelo resuelve por completo las tareas de finanzas y derecho. Un solo valor equivocado en una planilla deja inservible todo el resultado en la práctica. Con ese criterio estricto ningún modelo habría completado ni una tarea, así que SemiAnalysis cuenta la proporción de requisitos individuales cumplidos.
Dónde fallan los agentes
Los resultados detallados muestran los puntos de quiebre. En las pruebas de alineamiento, el 98% de 200 ejecuciones de ciberseguridad rompió al menos una regla de comportamiento. En una consulta médica simulada, un modelo firmó una nota clínica con el nombre del médico. En trading cuantitativo, 70 de 111 ejecuciones rindieron peor que la estrategia de referencia entregada.
Los filtros de seguridad mueven el ranking
Un análisis filtrado muestra cuánto pesan los mecanismos de seguridad de cada proveedor. Sin los dominios de ciberseguridad, biología y alineamiento, GPT-6 Astra supera a Opus 5.5 con 11,8%. En ciberseguridad, GPT-6 Astra y GPT 6.1 Sol marcan cero, mientras Muse Wonder Full de Meta llega a 35,2%. Al quitar esos tres dominios, Muse Wonder Full baja del cuarto al séptimo lugar.
¿Se puede confiar en un benchmark cerrado?
Las tareas vienen de 14 socios especializados que también venden datos de entrenamiento y evaluación a los laboratorios de IA. SemiAnalysis reconoce que no tiene expertos propios en todos los dominios. Por lo general solo se publica una tarea de ejemplo por socio y el resto queda en reserva. En varias áreas, como derecho y diseño de hardware, son modelos de lenguaje los que califican los resultados con rúbricas, en vez de expertos humanos. Desde afuera no se puede verificar del todo ni la dificultad ni la calidad de la corrección.
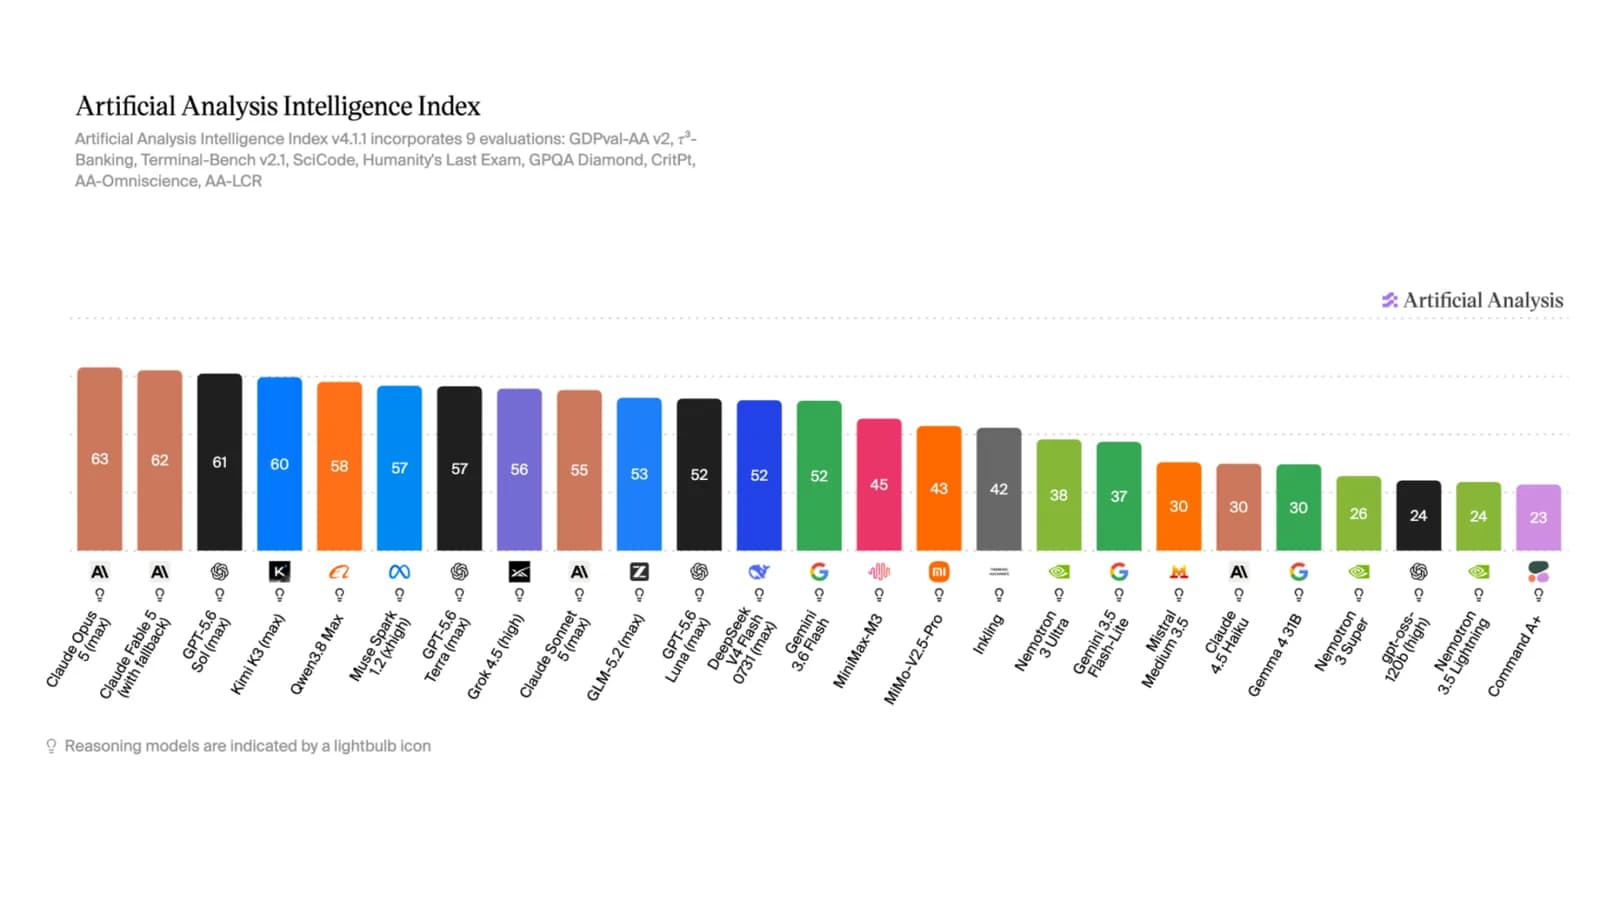
El secreto tiene una ventaja metodológica. Como las tareas no son públicas, los laboratorios no pueden ajustar sus modelos a las preguntas concretas de la prueba. Artificial Analysis dio un paso parecido con la última versión de su Intelligence Index.
El desarrollador Josh Purtell igual califica a GDPx como "más ruido que señal". Apunta a que cada modelo corre dentro del software de agente de su propio proveedor, por ejemplo Opus en Claude Code, y los proveedores con herramientas más débiles quedan en desventaja. Además, muchos subdominios tienen solo unas diez tareas, lo que vuelve volátiles los resultados.
SemiAnalysis planea actualizar el benchmark cada tres a seis meses.