Google lanzó Gemini 4 Hydrogen el 12 de noviembre, un modelo de uso general pensado para desarrolladores y usuarios comunes. A diferencia de Gemini 4 Carbon y Gemini 4 Argon, que la empresa diseñó para razonamiento profundo sobre problemas difíciles, Hydrogen apunta a resolver tareas cotidianas rápido y barato. Ocupa el lugar que antes tenía la serie Flash, informó The Decoder.
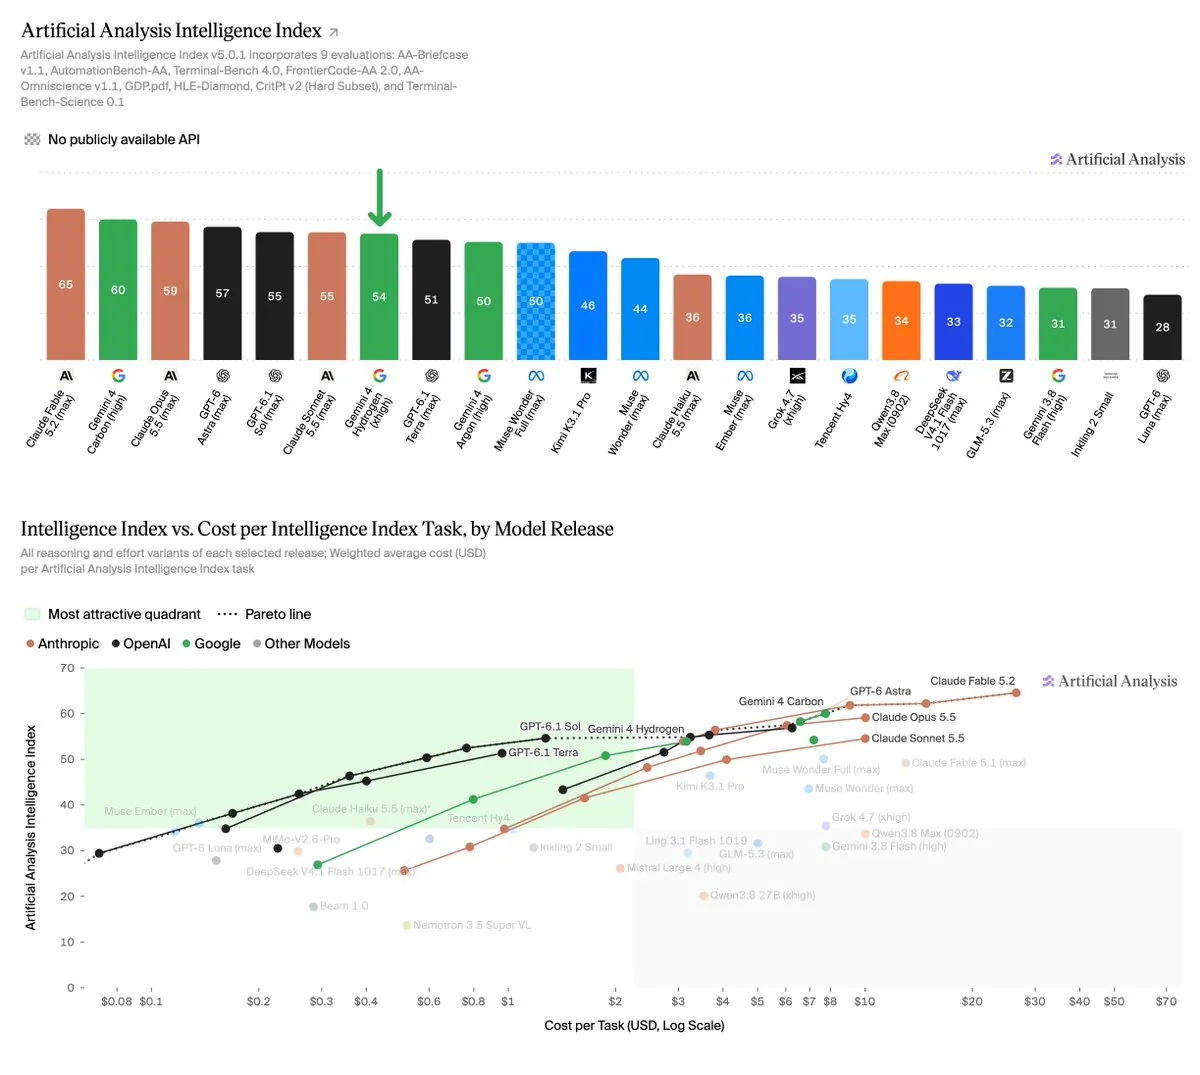
La comparación con Flash le queda corta. Según Google, Hydrogen le gana al Argon, un modelo más grande, en el Artificial Analysis Intelligence Index con su nivel de razonamiento por defecto, "high" (51 contra 50 puntos), y llega a 54 con el nivel más alto, "xhigh".
¿Qué ofrece Gemini 4 Hydrogen?
Hydrogen trae cuatro niveles de razonamiento: low, medium, high (el predeterminado) y uno nuevo, xhigh. Argon ofrece solo medium y high. La ventana de contexto es de un millón de tokens de entrada, y el modelo también puede generar un millón de tokens de salida.
El precio es de 1,50 dólares por millón de tokens de entrada y 7,50 dólares por millón de tokens de salida. Los aciertos de caché cuestan 0,075 dólares.
Con xhigh, Hydrogen marca 54 en el índice de Artificial Analysis, apenas detrás de Claude Sonnet 5.5 y GPT-6.1 Sol, que llegan a 55 cada uno en su nivel máximo de razonamiento. Gemini 4 Argon queda atrás con 50.
El resultado deja a Hydrogen más capaz y más barato que Argon. Y suma confusión. Cuando Google anunció Carbon, su nuevo modelo de frontera, dos días antes, recomendó seguir usando Argon para programar en el día a día. Con Hydrogen esa recomendación pierde sentido, y Argon queda obsoleto a menos de cuatro semanas de su lanzamiento.
El salto frente a Gemini 3.8 Flash
Google presenta a Hydrogen como un modelo independiente y una mejora grande sobre Gemini 3.8 Flash. Con el nivel de razonamiento por defecto termina las tareas 2,5 veces más rápido, según la empresa. En Terminal-Bench 4.1 el puntaje sube de 18,2% (Flash) a 57% (Hydrogen). Las alucinaciones bajaron a la quinta parte, y el modelo se recupera mejor cuando falla una llamada a una herramienta o una búsqueda no devuelve nada, dice Google.
En tareas abiertas de agentes, como investigación, análisis de datos y navegación de código, Hydrogen ocupa el quinto lugar del ranking Agent Arena. Google afirma que queda primero en Vals Tax Agent Bench con 52,3% y empata el primer lugar en Vals Legal Research Bench con 55,8%.
Los benchmarks que publicó Google
La tabla de Google compara a Hydrogen con Carbon y Argon. Donde un modelo no tiene dato, la celda queda vacía.
| Benchmark | Gemini 4 Hydrogen | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|---|
| AA Index v5.0 | 54 (xhigh) | 59 | 50 |
| SWE-sweep | 13,5% | 9,6% | 4,3% |
| Terminal-Bench 4.1 (ajustado por trampas) | 57,0% | ||
| Agents' Last Exam v1.1 | 71,6% | 77,4% | 69,0% |
| AutomationBench | 76,1% | ||
| Vending-Bench 2 (saldo en dólares) | 14.549 | 16.484 | 13.718 |
| OSWorld-2.1 (subconjunto offline) | 77,6% | 81,5% | 74,7% |
| Chartography | 66,6% | 72,5% | 71,6% |
| Terminal-Bench-Science 0.1 | 51,4% | ||
| HLE-Diamond | 58,8% |
Para trabajo multimodal, como resumir PDF grandes, planillas o videos, Hydrogen admite hasta un millón de tokens de salida sobre su ventana de un millón de tokens de entrada. Marca 53,4% en el nuevo Multimodal Knowledge Agent Benchmark de Google y 71,6% en Agents' Last Exam v1.1.
En la comparación de Google, Hydrogen supera a Claude Sonnet 5.5 y a GPT-6.1 Terra en las pruebas de trabajo de conocimiento y de comprensión multimodal. Sonnet, en cambio, saca el mejor puntaje en tareas de terminal y en uso del computador.
¿Dónde se puede usar?
Google está desplegando Hydrogen en todo el mundo y en todas sus plataformas. Los desarrolladores acceden por la API de Gemini en AI Studio y Android Studio, y los suscriptores pagados de Pro y Ultra lo usan en Google Antigravity. Las empresas lo reciben con Gemini for Business, y está abierto a todos en la app de Gemini y en Google Search.
En la app de Gemini, según Google, el modelo respeta mejor el tono, el formato y las instrucciones en conversaciones largas, así que los borradores, resúmenes y documentos salen utilizables al primer intento con más frecuencia. Hydrogen también puede tomar contexto de apps de Google como Gmail y Drive, y de apps de terceros como Airtable y Dropbox.
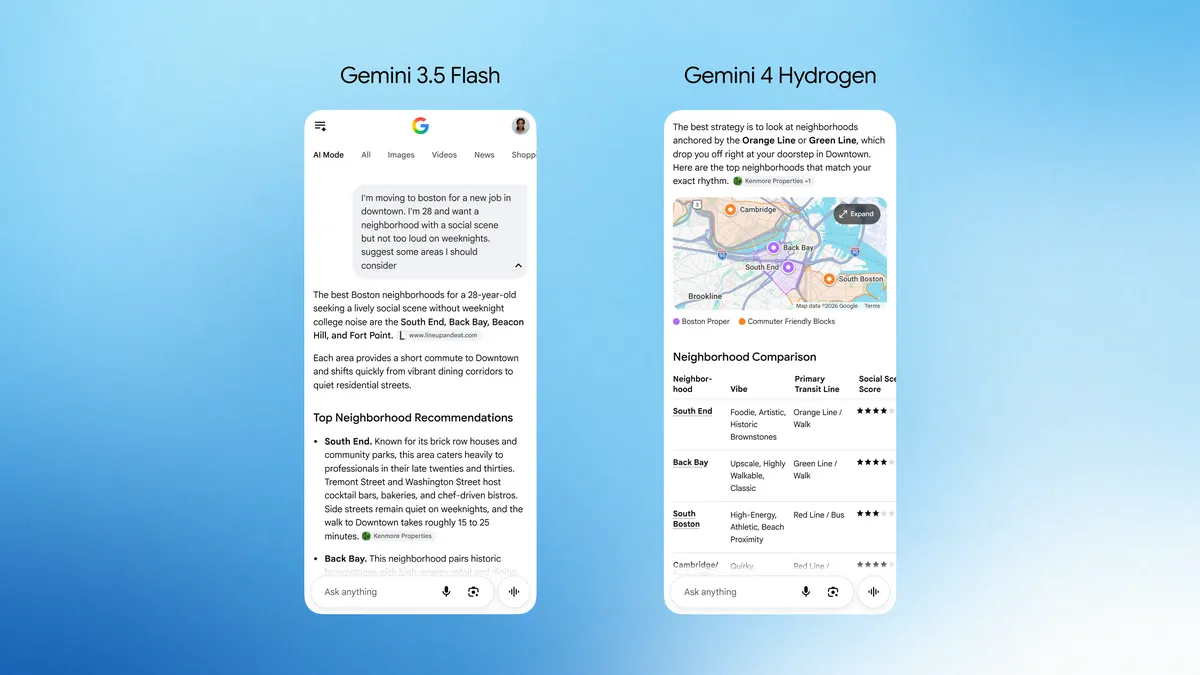
Google dice que Hydrogen es una "mejora significativa" para Search. El modelo maneja mejor las consultas con errores de tipeo, las preguntas de varias partes y los pedidos muy específicos, según la empresa. Los resultados se ven más visuales y fáciles de recorrer, y una técnica mejorada de expansión de la consulta trae una gama más amplia de enlaces.
En Antigravity, la herramienta de programación de Google, un orquestador nuevo alterna entre Carbon y Hydrogen dentro de una misma sesión en vez de quedarse con un solo modelo. En Terminal-Bench 4.0, Google afirma que el orquestador casi iguala las tasas de éxito de Carbon con 24% menos de recursos y 19% menos de tiempo de procesamiento.
La prueba independiente de Artificial Analysis
Una evaluación independiente de Artificial Analysis pone a Hydrogen más o menos a la par de Claude Sonnet 5.5 en su nivel máximo de razonamiento. Con el nivel por defecto, high, el puntaje cae a 51, un poco detrás de GPT-6.1 Sol (xhigh, 52) y de Claude Opus 5.5 (high, 52).
En el benchmark AA-Omniscience, Hydrogen inventa respuestas solo el 8% de las veces, según Artificial Analysis. También supera a los demás modelos Gemini, Carbon incluido, en calidad de presentaciones en AA-Briefcase, que mide trabajo de conocimiento hecho por agentes.
El punto débil es el trabajo de agente en terminal. Hydrogen marca 54% en Terminal-Bench 4.0 y apenas 50% en Terminal-Bench-Science 0.1. Claude Sonnet 5.5 (máximo) llega a 64% y 53%, y GPT-6.1 Sol (máximo) a 56% y 58%.
¿Cuánto cuesta cada tarea?
En la relación precio y rendimiento, Artificial Analysis calcula unos 3,16 dólares por tarea con xhigh. Es cerca de un tercio de lo que cuesta Claude Sonnet 5.5 (máximo) con un nivel de inteligencia casi igual, y unas 2,5 veces lo que cuesta GPT-6.1 Sol (máximo).
El nivel xhigh sube a Hydrogen de 51 a 54 puntos, pero gasta casi el doble de tokens de salida que high. El costo promedio por tarea pasa de 1,87 a 3,16 dólares.
| Nivel de razonamiento | Costo por tarea | Puntaje en el índice |
|---|---|---|
| xhigh | 3,16 dólares | 54 |
| high | 1,87 dólares | 51 |
| medium | 0,80 dólares | 41 |
| low | 0,29 dólares | 27 |
En los niveles bajos la inteligencia cae fuerte. Con high, medium y low el modelo queda sobre la frontera de Pareto, lo que significa que a esos precios ningún otro modelo es a la vez más barato y más inteligente.