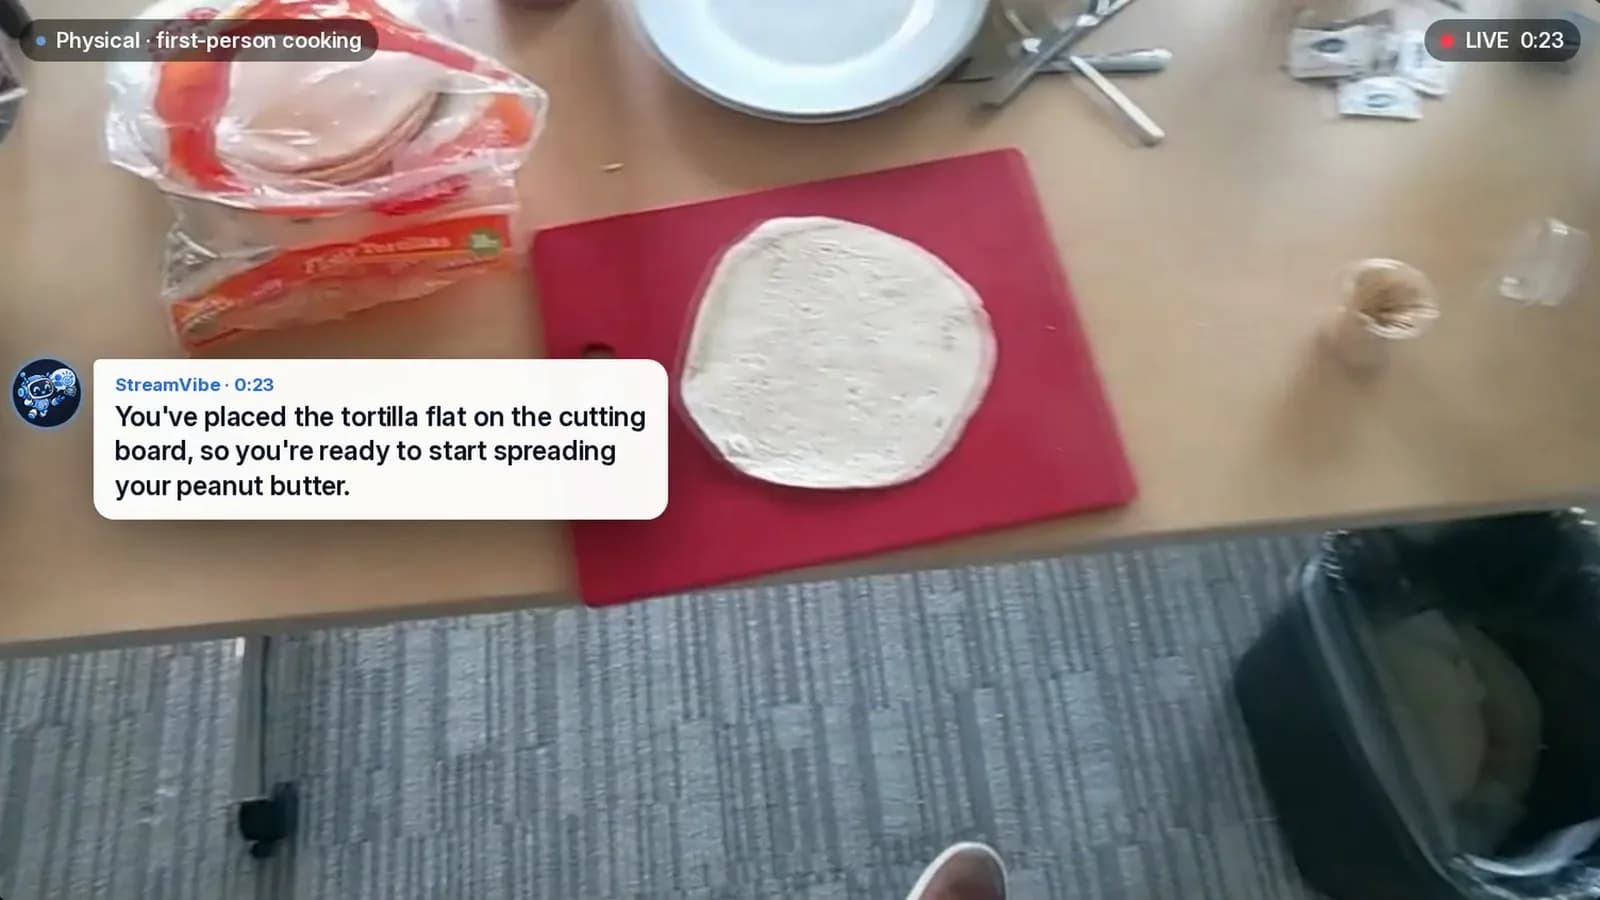
Un equipo de investigación liderado por Google presentó StreamVibe, un agente de video diseñado para decidir por sí mismo cuándo hablar. Las pruebas del propio trabajo dejan ver, sobre todo, lo difícil que sigue siendo eso para los modelos de IA actuales, informó The Decoder el 1 de noviembre de 2026.
Investigadores de Google, Stanford, Oxford y varias universidades de Estados Unidos trabajan en un asistente que te mira mientras cocinas o armas un mueble, y que interviene solo cuando hace falta. Con StreamVibe construyeron un agente pensado para entender incluso pedidos vagos, del tipo "Por favor ayúdame si me topo con alguna dificultad".
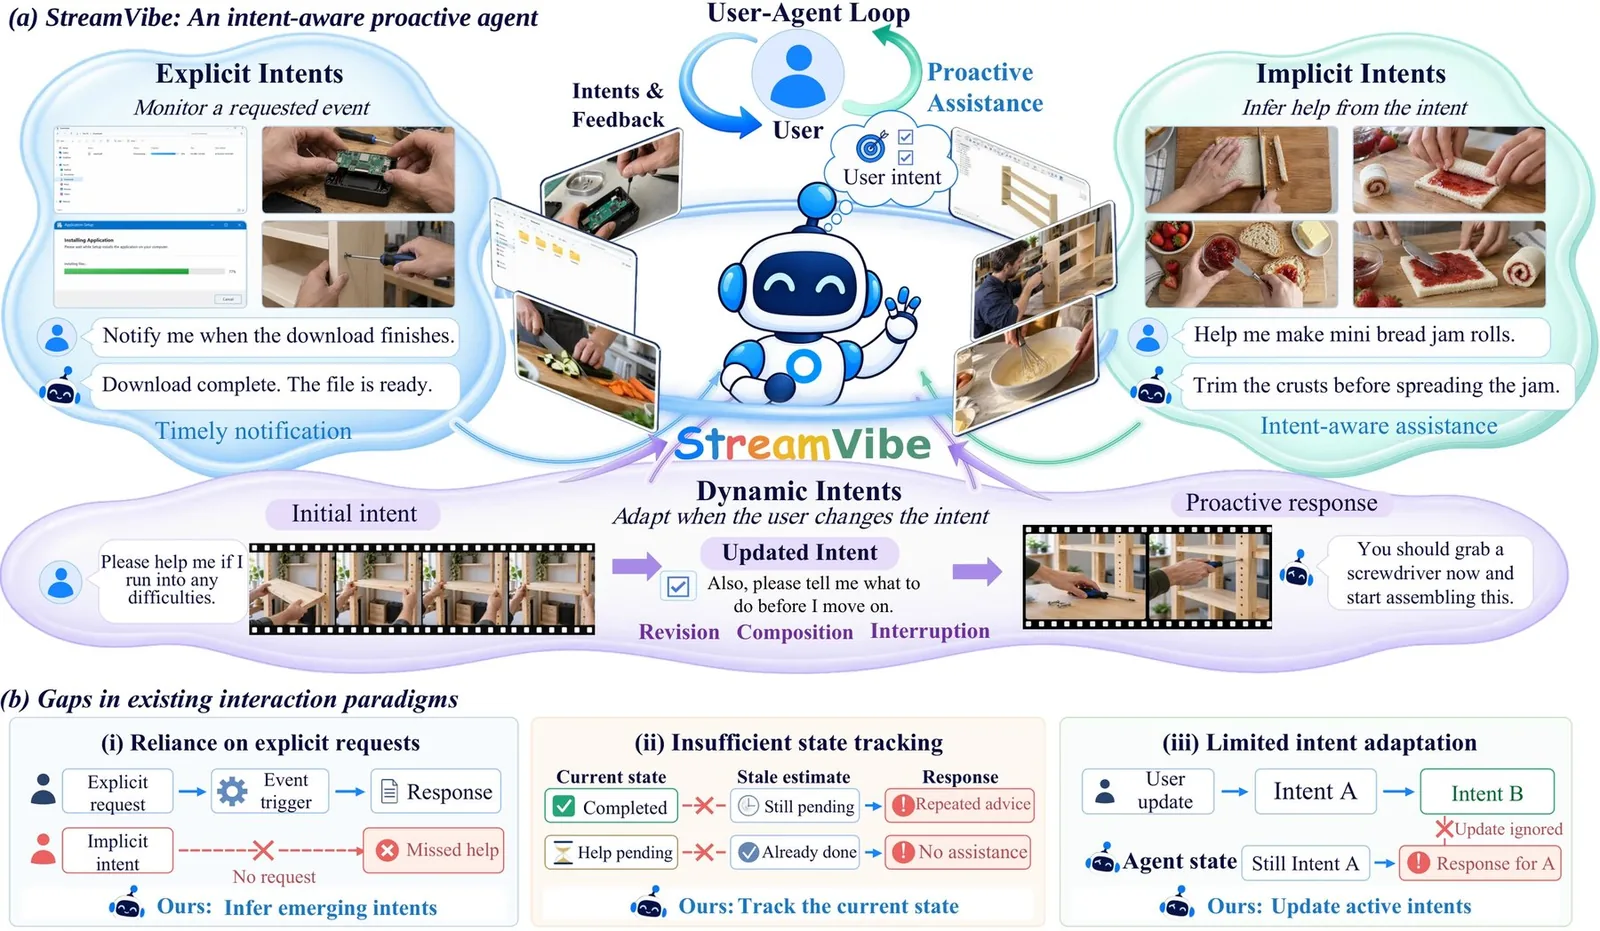
Según el paper, los asistentes de video existentes están hechos para órdenes claras, como "Avísame cuando el agua empiece a hervir", así que rara vez captan intenciones que el usuario no dice en voz alta. También les cuesta seguir lo que ya se hizo. Por eso repiten consejos o responden tarde, y cuando el usuario cambia su pedido a mitad de camino, suelen quedarse pegados en la instrucción original.
StreamVibe distingue entre tres tipos de intención durante una tarea. Las que el usuario dice de forma explícita, las que no dice y las que cambian con el tiempo.
Tres piezas para un asistente más atento
Para medir el problema, el equipo armó un benchmark de unos 4.100 ejemplos sacados de más de 183 horas de grabaciones de la vida cotidiana y de uso de software. Gemini 2.5 Flash propuso en qué momento ofrecer ayuda y qué decir, y cuatro evaluadores humanos tuvieron que aprobar cada ejemplo por unanimidad.
La prueba cubre tres etapas. Instrucciones claras, objetivos vagos y pedidos que cambian con el tiempo. En uno de los ejemplos, un usuario que desarma una excavadora de juguete pide informes de avance y, a los tres minutos, cambia a pedir un control de calidad.
A partir de ahí, los investigadores entrenaron StreamVibe-VL, un modelo que al parecer se basa en el Qwen3.5-9B de Alibaba y que decide cada segundo si se queda callado o si habla. Una segunda etapa de entrenamiento usa aprendizaje por refuerzo para hacerlo más reservado, de modo que no interrumpa a cada rato. Un sistema de memoria aparte registra qué pedidos siguen pendientes y qué pasos ya se completaron, aunque es el modelo el que decide por sí solo si habla y qué dice.
¿Qué tan bien funciona StreamVibe?
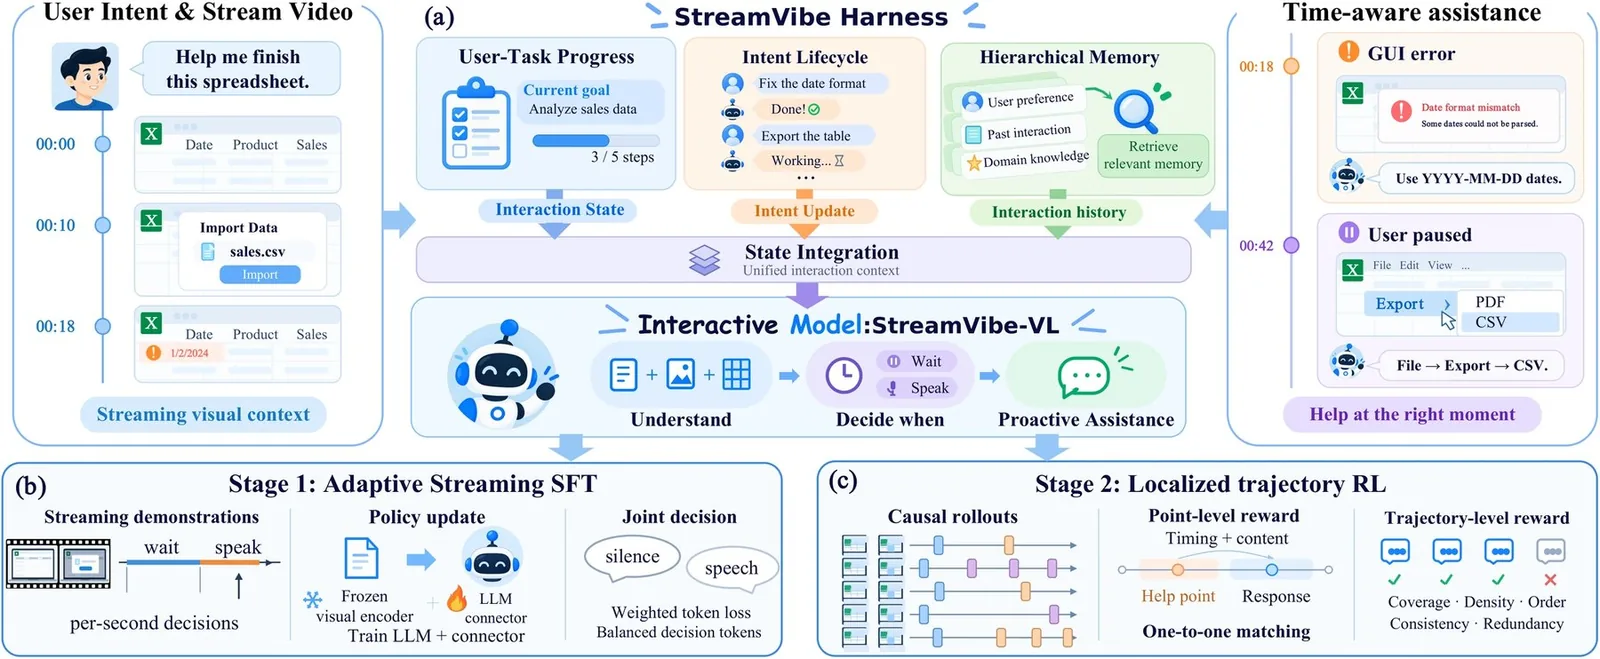
Según los investigadores, StreamVibe-VL mejora en 10,7% el momento y la calidad de sus respuestas frente a otros modelos. El sistema de memoria, por su parte, está pensado para subir en otro 12,3% la interacción proactiva y para reducir las interrupciones innecesarias, entre otras cosas.
StreamVibe-VL suele superar por amplio margen a su modelo base y a otros modelos de código abierto, aunque Gemini 3.8 Flash, el modelo propietario de Google, obtiene mejores resultados en varias pruebas. Según el paper, el entrenamiento especializado no empeora la comprensión general de video.
A medida que el video se alarga, los modelos aciertan mucho menos con el momento de responder. El sistema de memoria sirve, sobre todo, para reducir las interrupciones innecesarias.
Todos los modelos se pierden en operación continua
Los modelos suelen acertar cuando solo tienen que decidir, en momentos puntuales, si corresponde intervenir. Pero cuando procesan un video completo y tienen que construir sobre sus propias respuestas anteriores, el rendimiento de todos los sistemas probados se desploma porque los errores se acumulan. Una métrica central del contenido de las respuestas cae hasta 61,5% según el historial del propio sistema. En videos de más de cinco minutos, los modelos casi nunca eligen el momento correcto y les cuesta en especial seguir una instrucción que cambió hace rato.
En un tutorial de GIMP para pasar una foto a blanco y negro, documentado en el paper y en la página del proyecto, el modelo de comparación JoyAI dice que la imagen terminada ya se guardó, aunque el usuario todavía no la ha abierto. StreamVibe-VL, en cambio, da el paso siguiente en el momento justo, como "Colors" y después "Desaturate". En una guía paso a paso para preparar pan enrollado con mermelada, otros modelos solo describen lo que pasa en pantalla, por ejemplo que se aplana el pan. StreamVibe-VL aconseja cortar primero la corteza.
Los investigadores reconocen que las situaciones reales probablemente son más complejas que su montaje de prueba. El trabajo futuro va a estudiar cómo se influyen entre sí, con el tiempo, las preferencias del usuario y el entorno.
Google lleva tiempo con el video activo
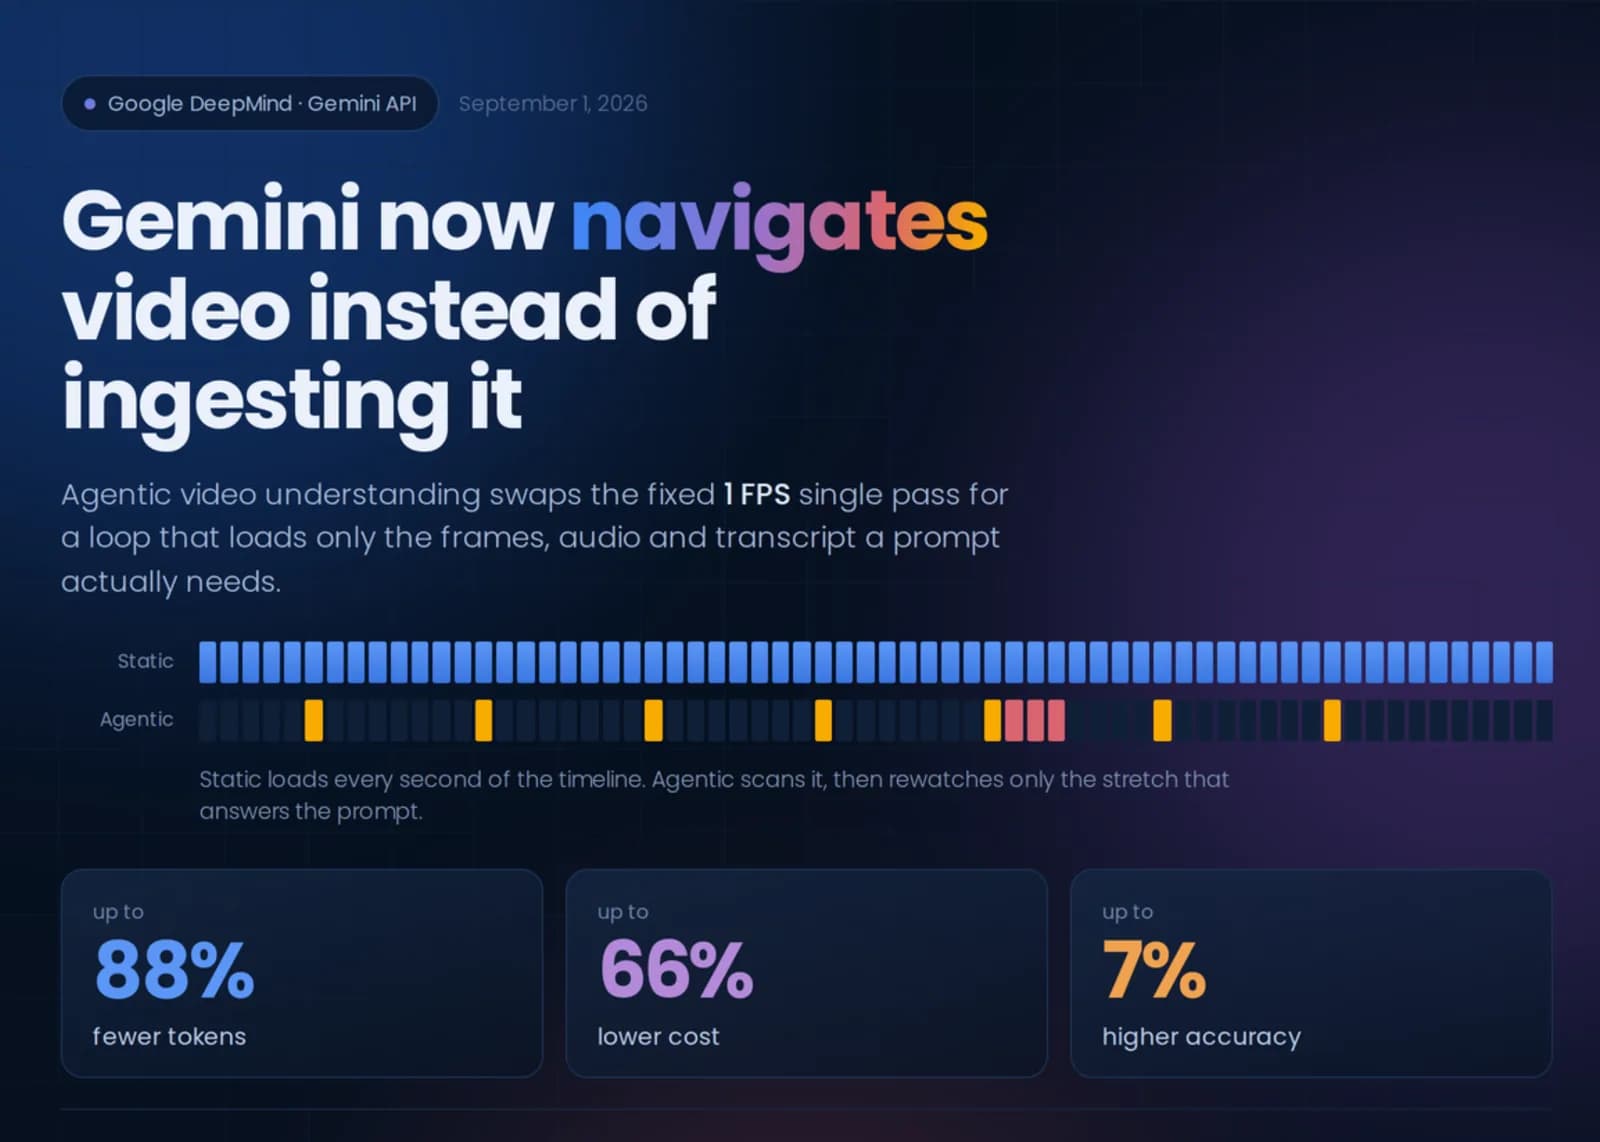
Google trabaja hace un tiempo en sistemas de IA que analizan video de forma activa. En septiembre presentó un análisis de video basado en agentes para Gemini, en el que el modelo decide por sí mismo qué escenas mirar con más detalle. Con Gemini 4 Argon, Google también mostró hace poco cómo la IA puede seguir secuencias de acciones más largas en videos de robots y detectar errores. El asistente de StreamVibe está diseñado para entender qué pasa en cada momento y reconocer cuándo su ayuda hace falta de verdad.
Otros trabajos recientes apuntan a límites parecidos. En el benchmark ProactiveBench, los modelos de IA suelen adivinar o negarse a responder en lugar de hacer preguntas concretas cuando falta información visual. Otro benchmark de comprensión de video dejó ver debilidades importantes en el razonamiento espacial y temporal. Y en el caso de los agentes autónomos, la propia conversación puede empeorar su rendimiento, como mostraron investigadores de Microsoft.