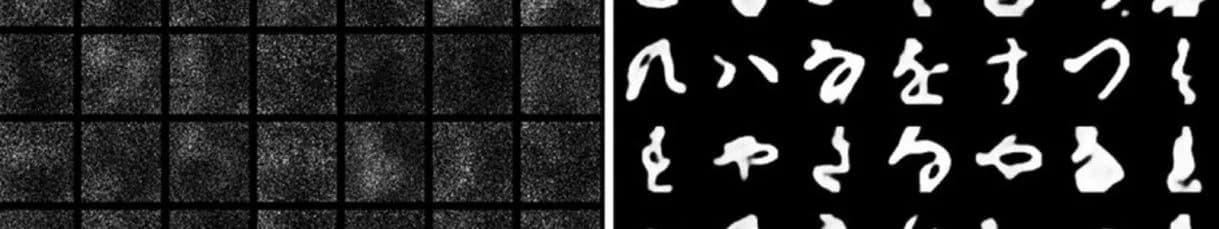
La niebla, el agua con barro y otros medios turbios pueden dejar prácticamente inútil a la mejor cámara. La luz que refleja un objeto se dispersa antes de llegar al sensor y lo que queda es poco más que una mancha borrosa. Investigadores de la Universidad Brown desarrollaron ahora un sistema de imagen inspirado en el cerebro que atraviesa esa interferencia y logra reconstruir y seguir objetos en movimiento que una cámara convencional no ve.
Una cámara que solo mira lo que cambia
El sistema copia la forma en que los ojos y el cerebro procesan la información visual. En vez de una cámara convencional que captura cuadros completos uno tras otro, el equipo usó un sensor de visión dinámica (DVS, por su sigla en inglés). Cada píxel de esta cámara de eventos responde solo cuando detecta un cambio de brillo suficiente, y lo que entrega es un flujo de eventos y no una secuencia de imágenes.
Esa diferencia sirve mucho en la niebla o en el agua turbia. El fondo que dispersa la luz cambia, en general, bastante más lento que un objeto en movimiento, así que el DVS casi lo ignora y reacciona a los cambios que provoca el blanco. El resultado, eso sí, no se parece a nada reconocible, y esa nube de impulsos asíncronos todavía hay que decodificarla.
¿Cómo se decodifican los impulsos?
Para eso el equipo desarrolló una red neuronal profunda de impulsos (SNN), pensada para funcionar como una corteza visual simplificada. Una rama de la red calcula la posición del objeto y otra reconstruye su forma. Las neuronas de tipo leaky integrate-and-fire le dan a la red una especie de memoria de corto plazo. Así acumula información mientras el objeto se mueve, en vez de intentar identificarlo a partir de un solo instante.
Los investigadores probaron el método con todo tipo de blancos, desde dígitos escritos a mano hasta siluetas de aves en vuelo. Los proyectaron a través de un material sólido que dispersa la luz, de un estanque de 30 centímetros con agua turbia y de niebla que se desplazaba de forma dinámica.
En una de las pruebas, dígitos escritos a mano que se movían al azar detrás de un material dispersor se reconstruyeron con un índice de similitud estructural de 0,9577. Siluetas de aves más complejas, que se movían por agua turbia siguiendo trayectorias naturales, alcanzaron un promedio de 0,9593.
¿Cuánta energía consume?
La etapa de entrada, el DVS, consume cerca de 28 milivatios. Los investigadores estiman que la red de impulsos necesita 18 veces menos energía de cómputo que una red neuronal artificial convencional equivalente. La red procesó secuencias completas de 18 pasos en menos de 15 milisegundos.
Los autores apuntan a vehículos autónomos en niebla densa, drones de búsqueda y rescate que operen entre el humo y robots submarinos en agua turbia. El enfoque de Brown no busca capturar una imagen más nítida. Cambia aquello a lo que la cámara le presta atención.
Lo que todavía no resuelve
Los resultados son alentadores, pero el sistema tiene limitaciones importantes. El blanco tiene que moverse, o cambiar ópticamente de alguna forma, para que la cámara lo detecte. Un objeto muy lento puede no generar eventos suficientes, y el sistema actual reconstruye siluetas, no imágenes detalladas. Con poca luz, además, baja la sensibilidad del DVS.
El equipo ya estudia intensificadores de imagen, técnicas de tiempo de vuelo y cámaras de eventos binoculares para atacar algunas de esas carencias.