
IA
Helion entra al backend lineal de vLLM y supera a CUTLASS en Hopper
Un solo kernel GEMM escrito en Helion cubre las variantes estándar, Split-K y Swap-AB, y el autoajuste elige la mejor para cada forma de entrada.
PyTorch Blog
9 notas publicadas
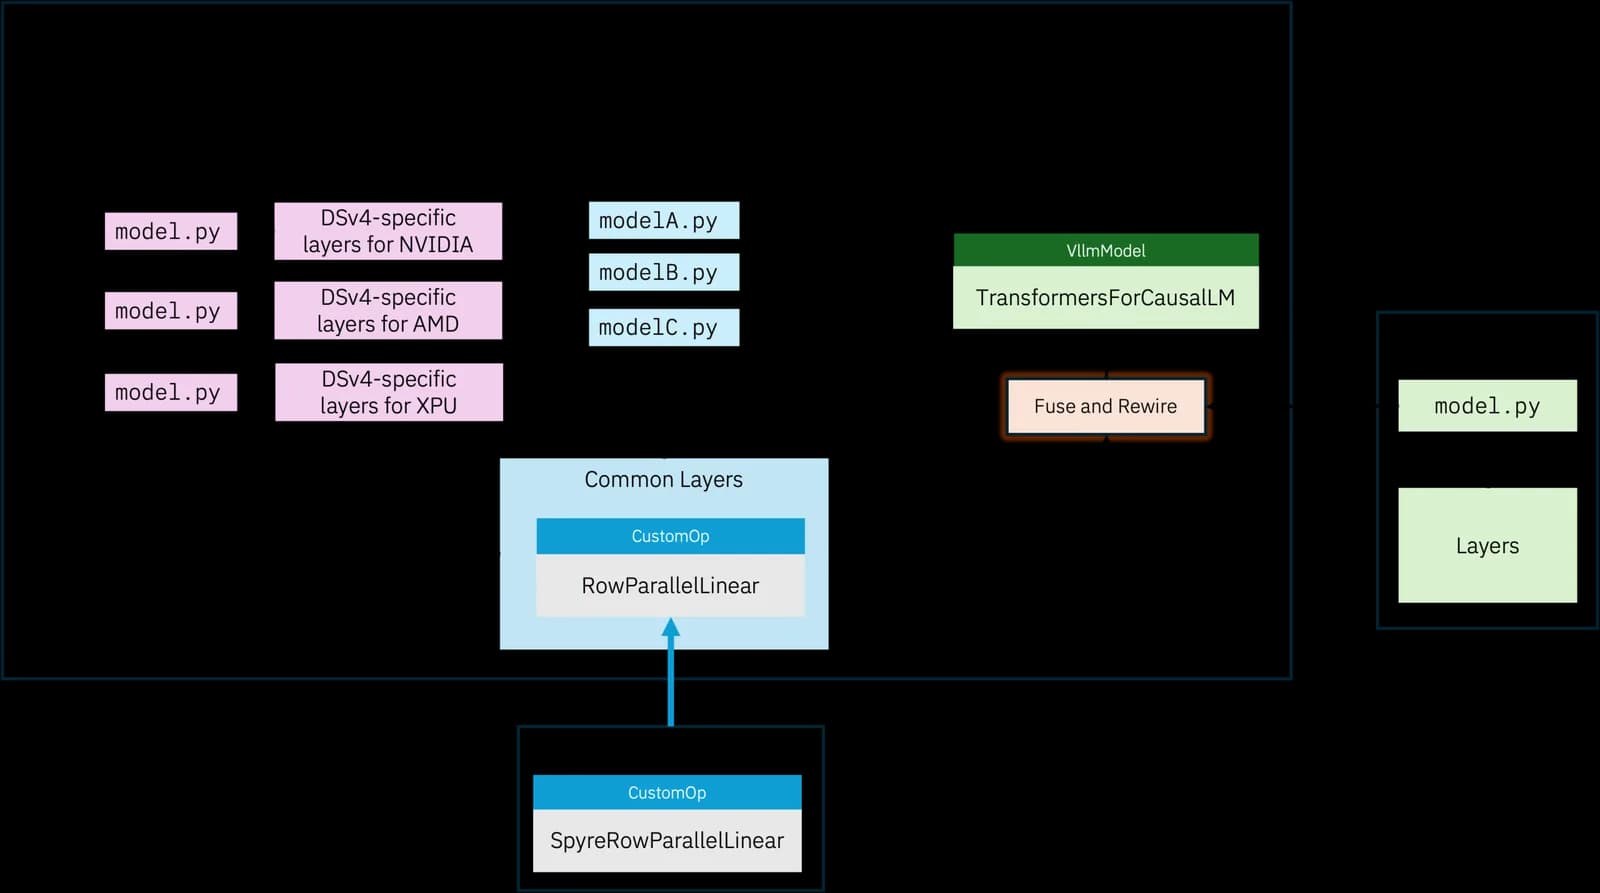
El motor de inferencia rompió la compatibilidad con torch.compile para correr más rápido en las GPU nuevas, y ahora construye un camino aparte para las viejas.
El circuito convierte a diario las conversaciones que fallan en producción en datos de entrenamiento, y el modelo especializado terminó superando al de frontera.
NVIDIA reescribió su cliente de carga desde cero, con procesos de trabajo separados y coordinación por ZMQ, para que el propio medidor deje de ser el cuello de botella.
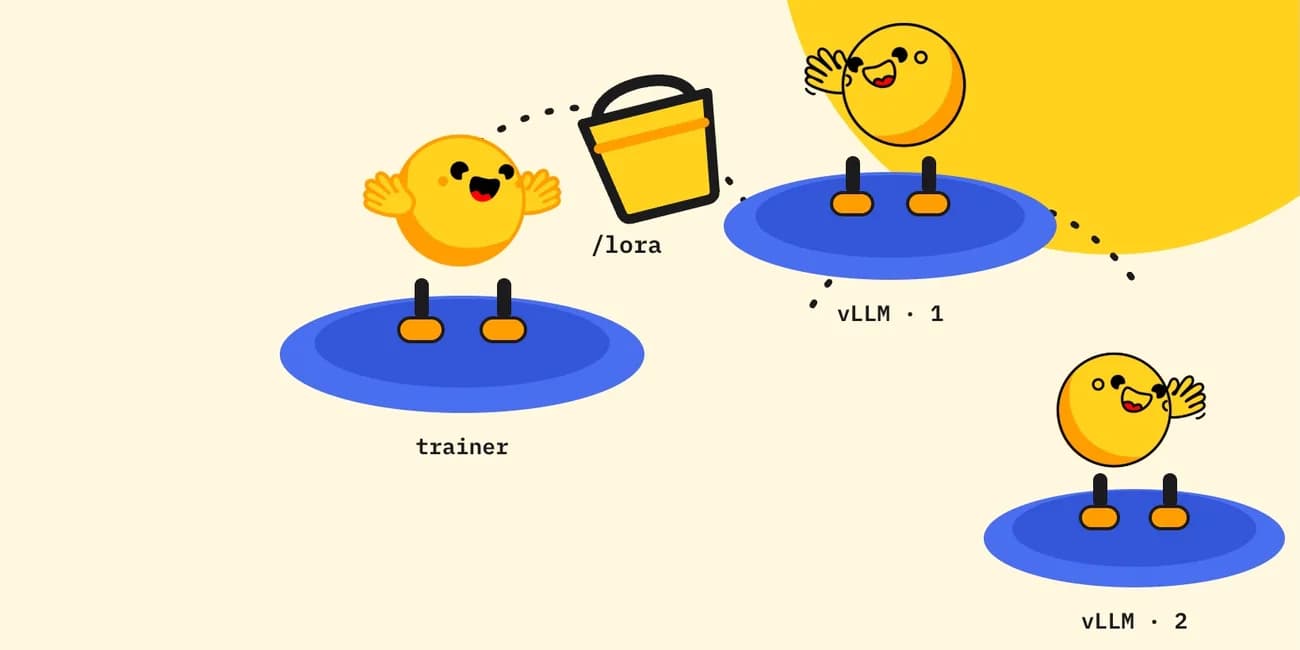
Un adaptador de rango 1 pesa unos megabytes, así que viaja por un bucket montado en cada Job en vez de NCCL, y el entrenador queda en otra máquina que las réplicas de inferencia.
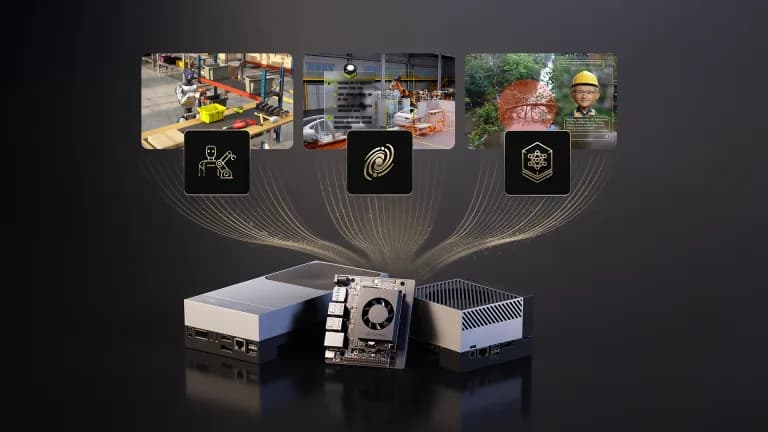
La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.
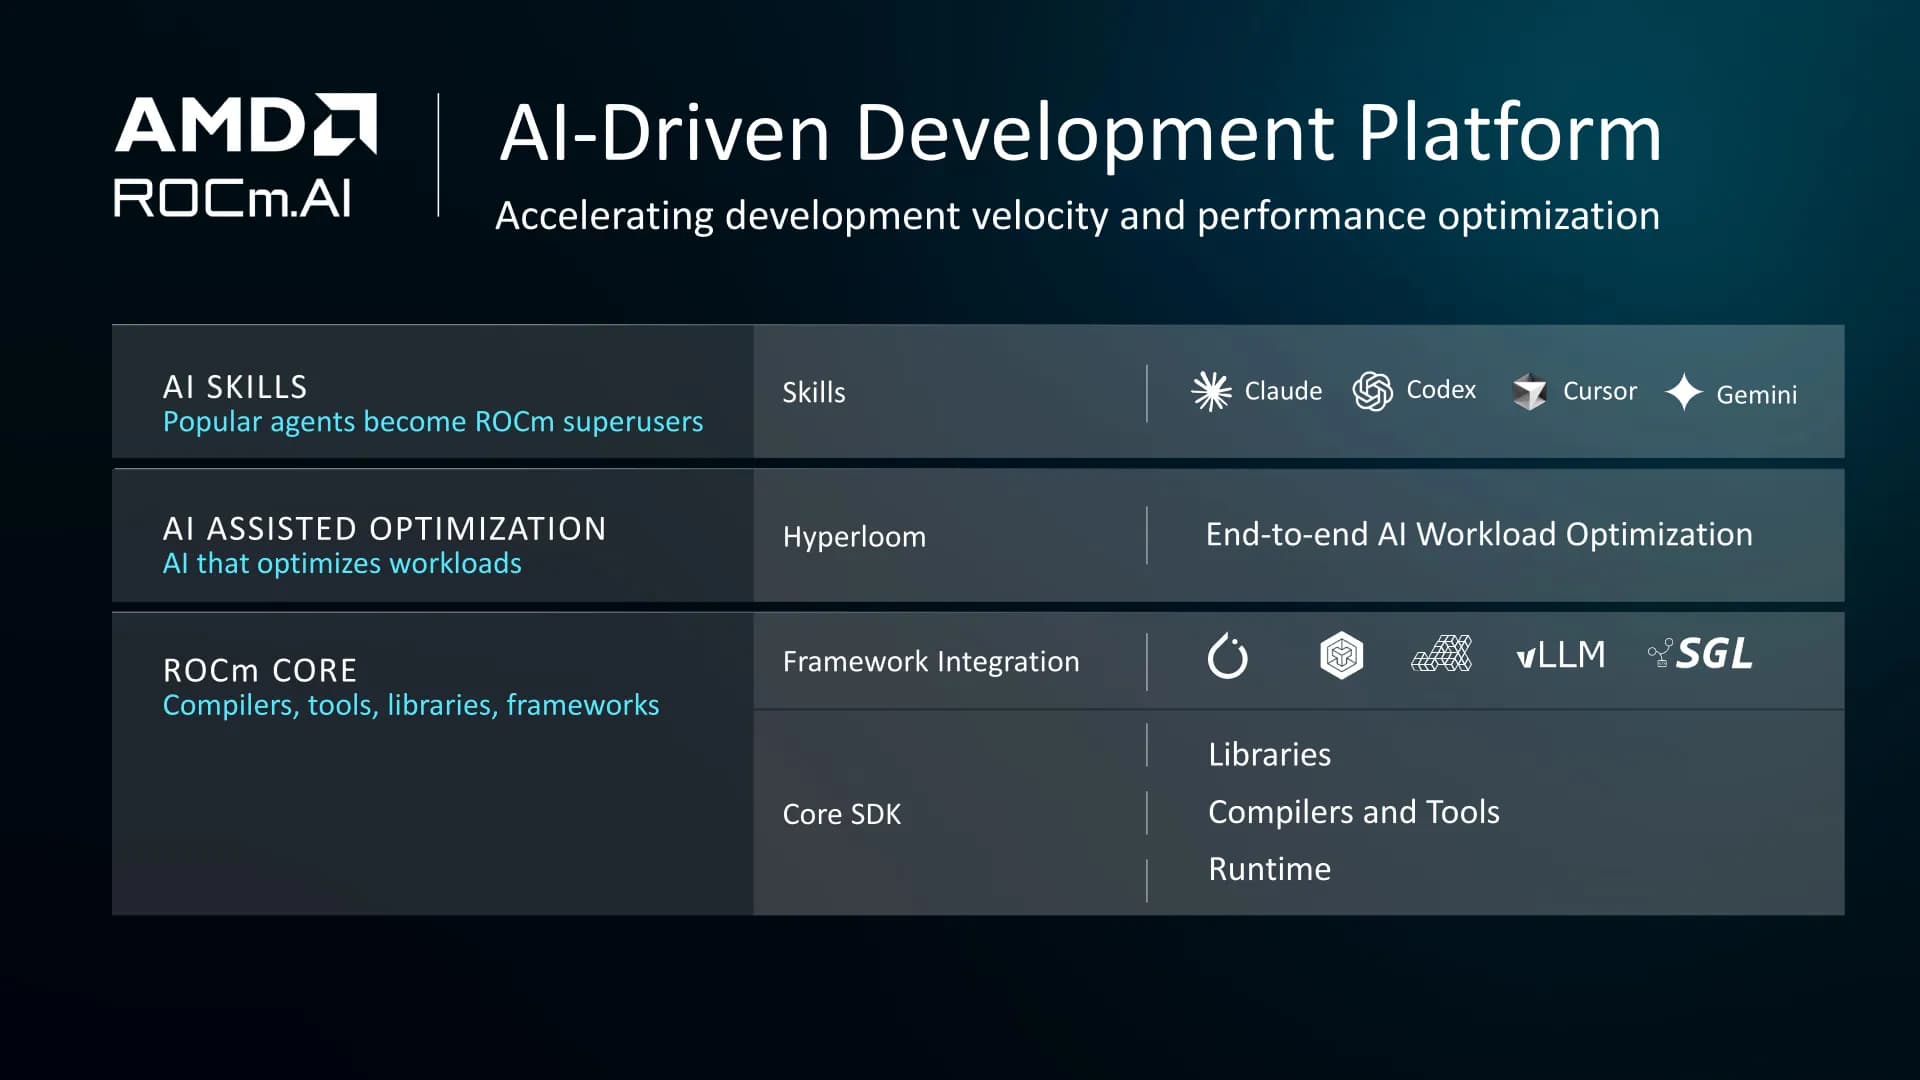
El salto de versión ordena un esquema de numeración que se había vuelto confuso y llega con la primera entrega bajo el nuevo ciclo de lanzamientos cada seis semanas.
Las nuevas versiones del stack en Docker de Intel suman soporte el mismo día del lanzamiento para el modelo de 30B de Meta, más generación de video local y mejoras de latencia en Gemma 4.
El nuevo wheel CUDA para aarch64 ya viaja en el índice por defecto de PyPI, cerrando dos años de --index-url y reinstalaciones silenciosas que rompían vLLM en Grace Hopper.
Otros temas que aparecen junto a #vllm en nuestra cobertura editorial.