Japón enciende Shunkai, un cuántico de 50 qubits de átomos neutros
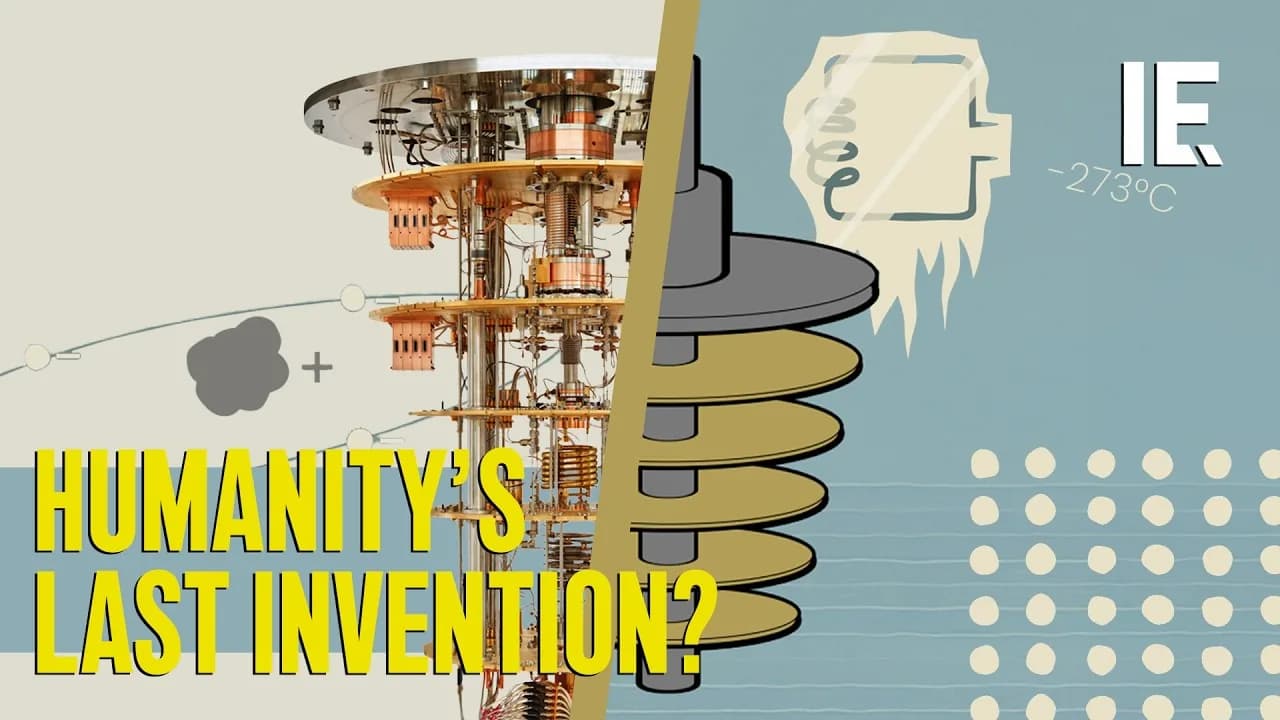
El primer sistema full-stack de esta modalidad en el país arrancó el 24 de agosto con una unidad de procesamiento cuántico fabricada en Colorado por Infleqtion.
Todas las notas publicadas en MechaNoticias. Ordenadas por fecha de publicación, de la más reciente a la más antigua.
2.124 notas · Página 57 de 89

El primer sistema full-stack de esta modalidad en el país arrancó el 24 de agosto con una unidad de procesamiento cuántico fabricada en Colorado por Infleqtion.

Google separó su nuevo modelo de voz a texto en dos endpoints con capacidades distintas, y esa división es la decisión de arquitectura que hay que planificar antes de escribir la primera línea.

NVIDIA liberó implementaciones de referencia para llevar modelos abiertos desde un identificador de Hugging Face hasta inferencia nativa en C++, sin PyTorch ni Python en producción.

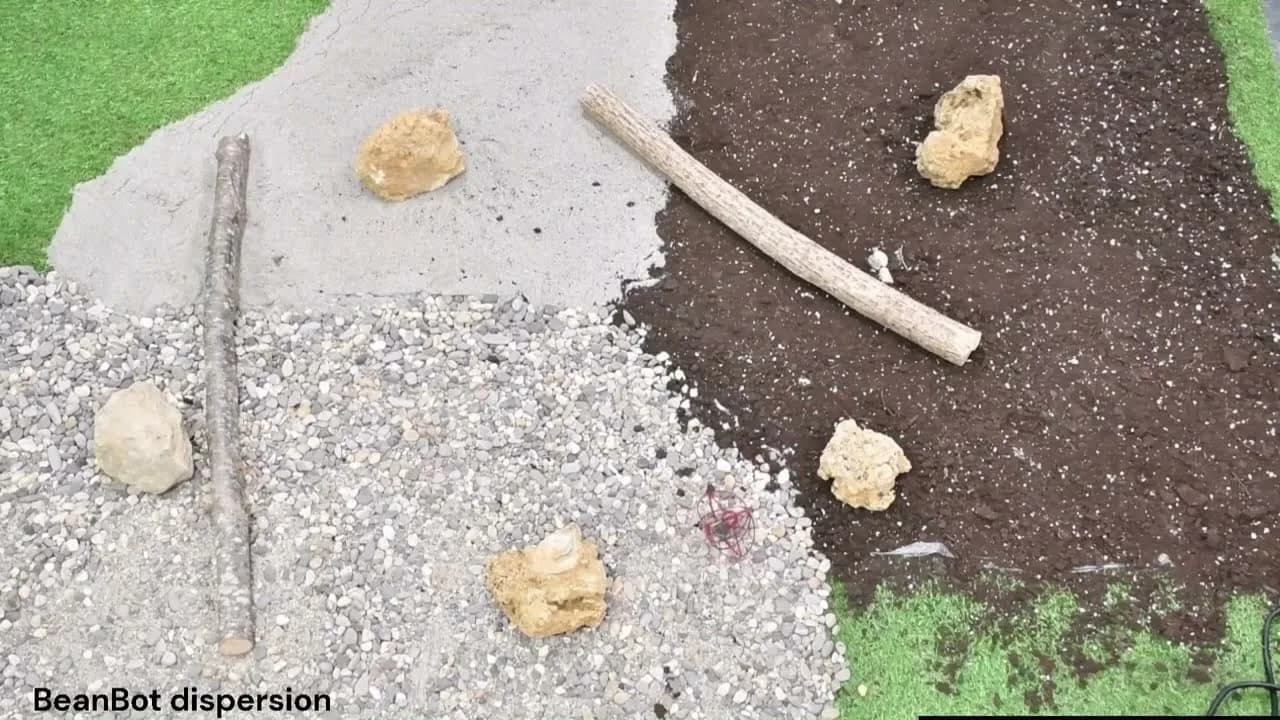
El Instituto Italiano de Tecnología construyó un robot de 11,8 gramos que salta, rueda, se desliza y trepa pendientes usando solo un resorte que reacciona al calor y la forma de su carcasa.

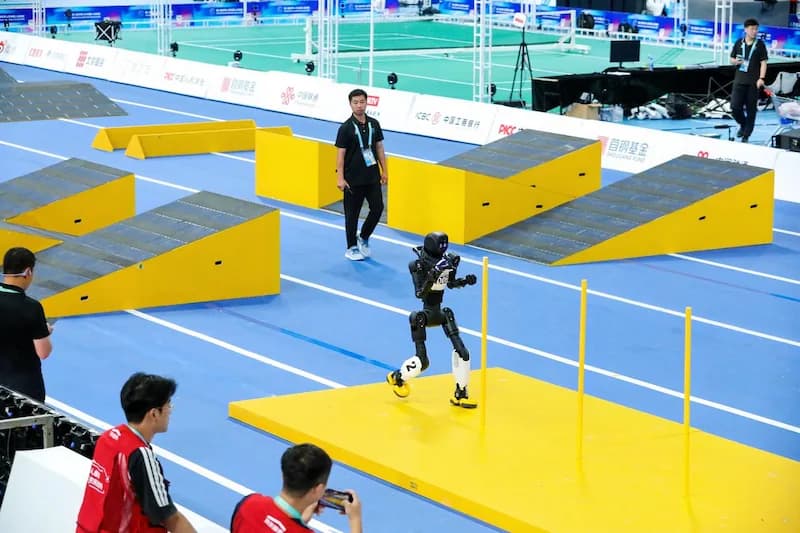
La empresa china debutó en la competencia con robots sacados de su línea de producción, sin versiones especiales para el evento, y terminó primera tanto en la tabla de oros como en la general.

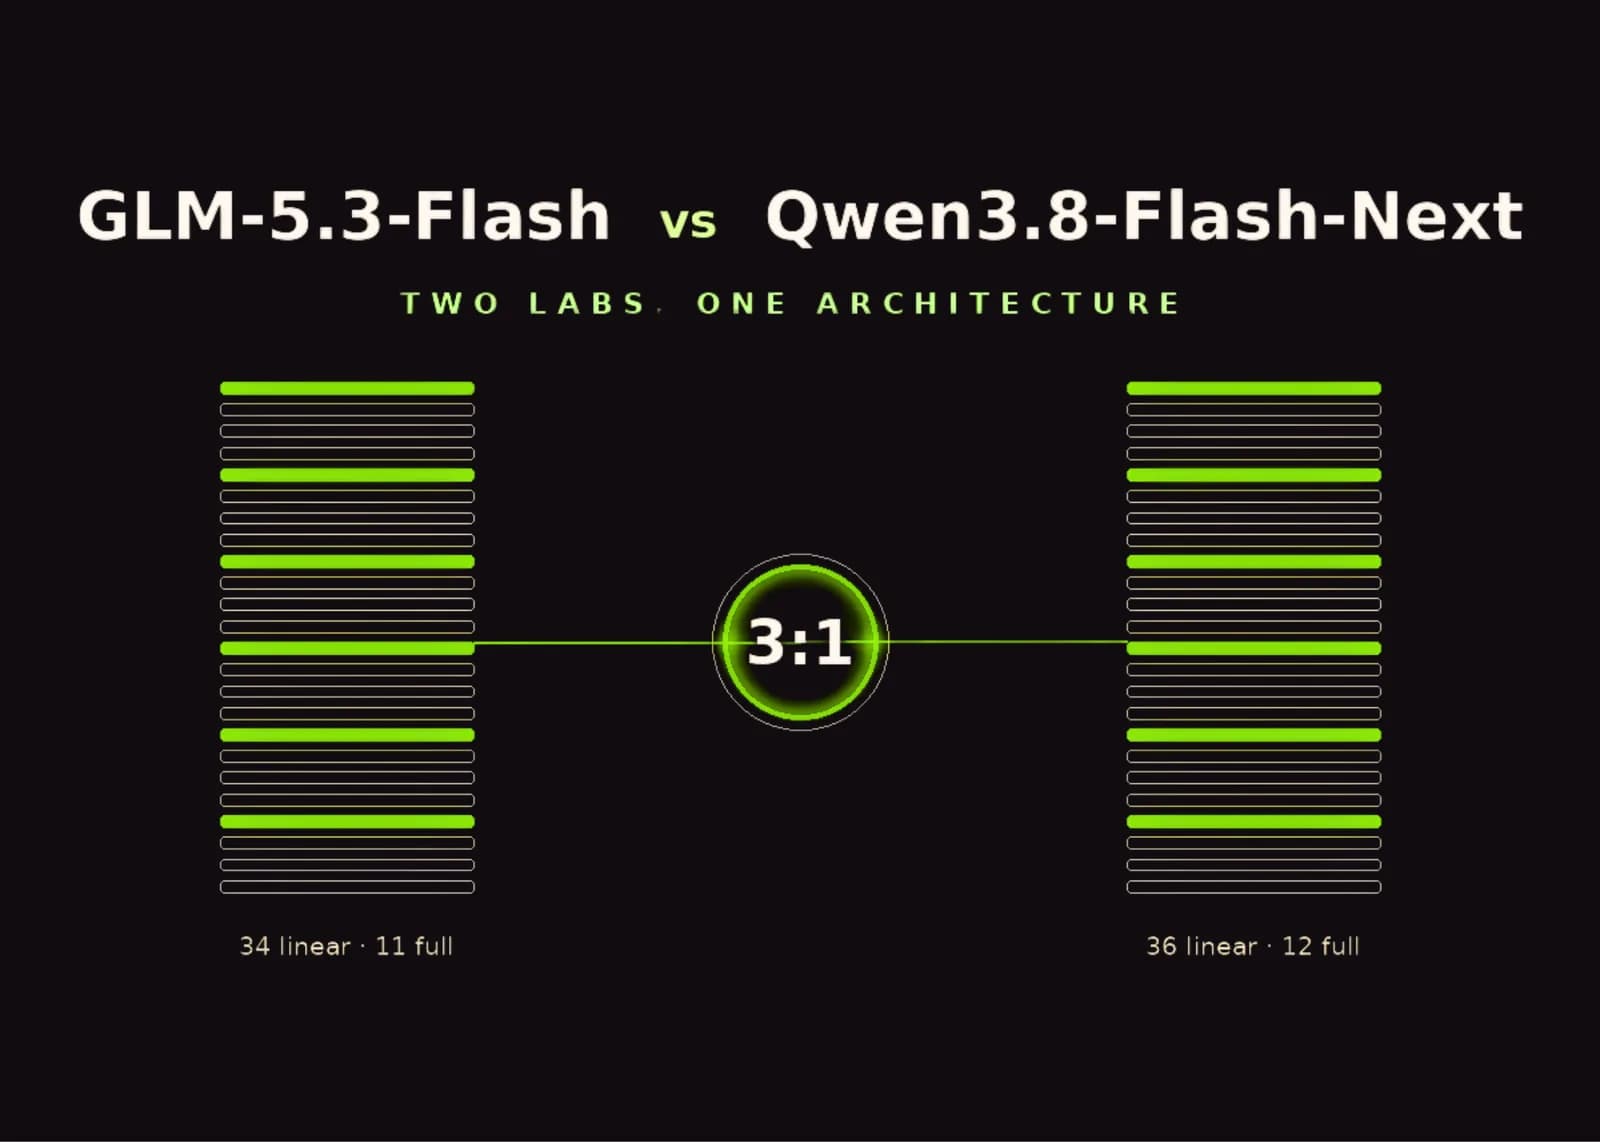
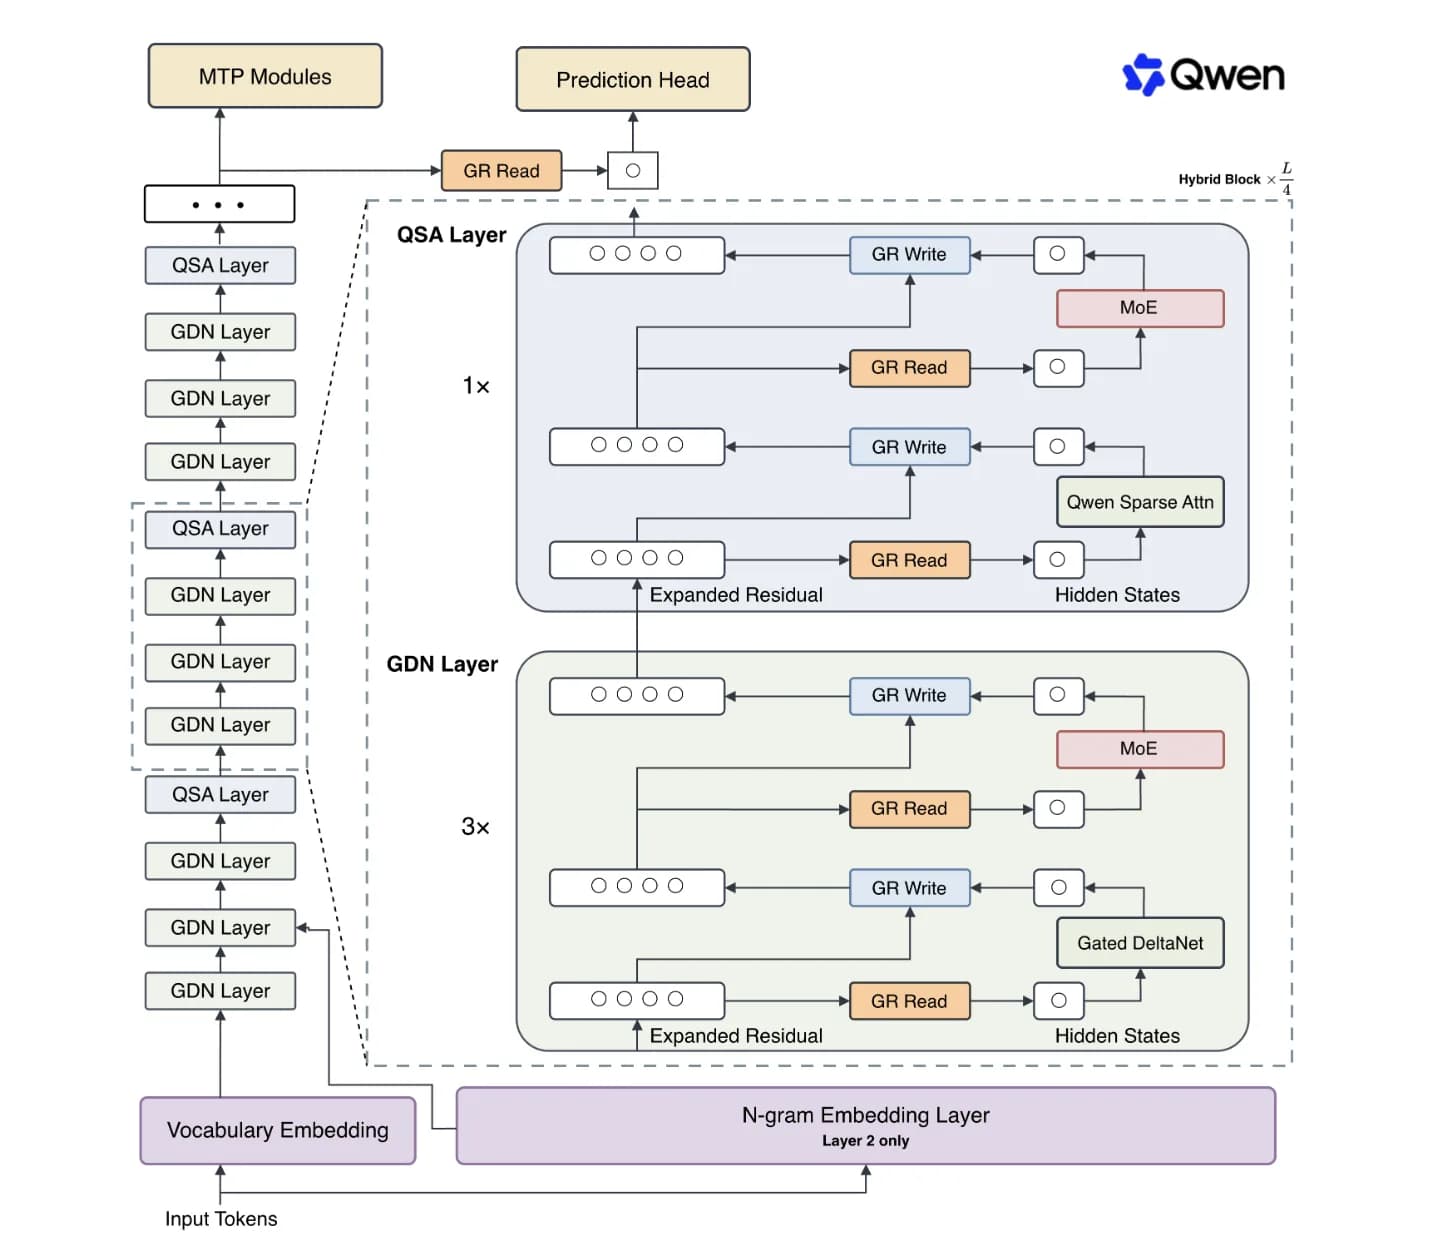
Z.ai y el equipo Qwen de Alibaba liberaron sus modelos sin coordinarse, pero las configuraciones son casi copias: mismo ratio de atención, mismo tope de 2.048 tokens y cuatro flujos residuales.

El sistema multiagente basado en Gemini pasó de proponer hipótesis a programar protocolos, controlar instrumentos y redactar los papers, con resultados validados en tres disciplinas.

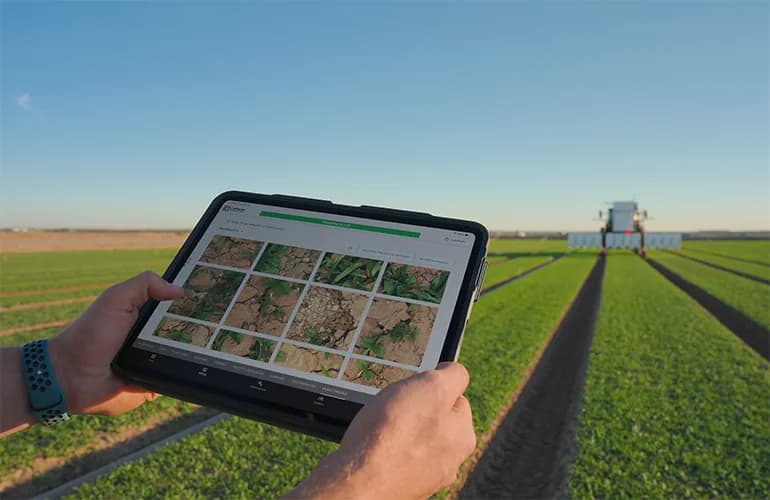
La empresa reemplazó sus modelos de visión por cultivo con un único modelo fundacional que el agricultor ajusta en minutos desde un iPad, sin reentrenar nada.

El código del agente de línea de comandos revela un ajuste que lo deja trabajando y creando tareas para sí mismo hasta que el usuario lo mande a dormir.

El nuevo modelo multimodal de peso abierto de Alibaba anticipa la arquitectura de Qwen4 y, según el equipo, se entrenó por cerca de un noveno de lo que costó Qwen3.7-Plus.

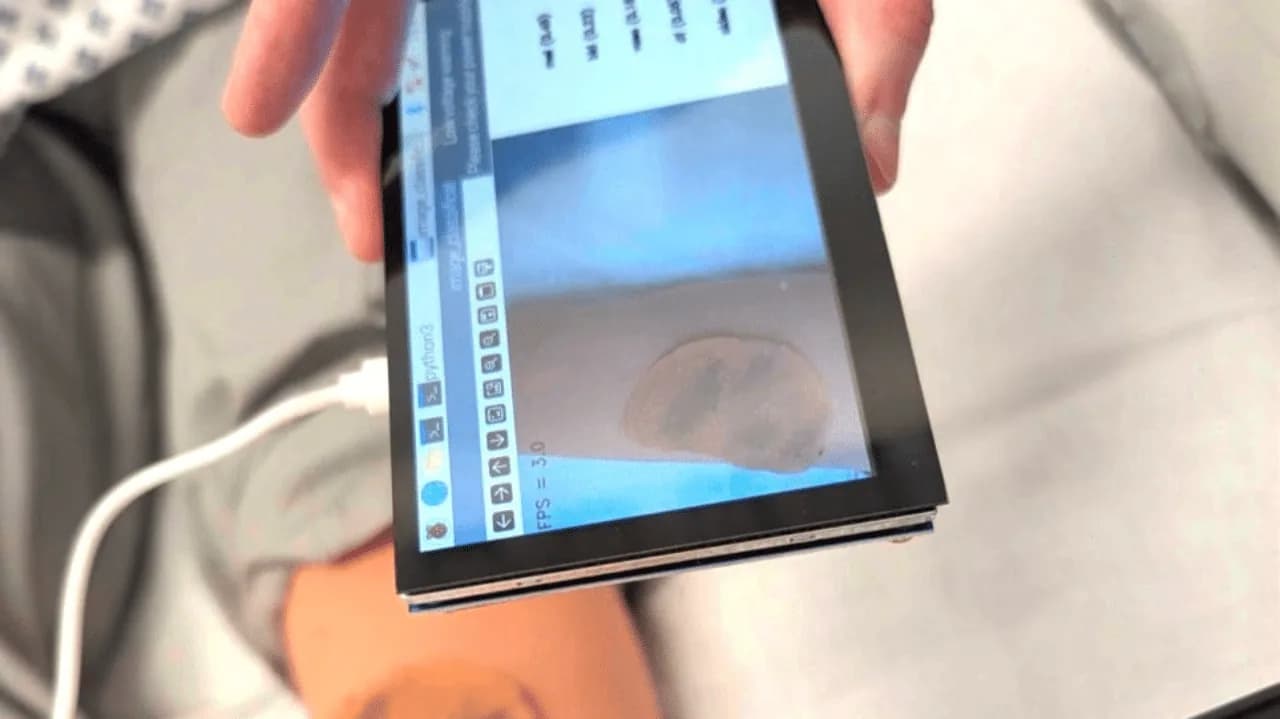
LesionIQ, desarrollado en la Universidad Heriot-Watt de Edimburgo, corre el modelo en la propia placa y reporta 85% de acierto sobre el set ISIC 2020, sin subir las fotos a ningún servidor.

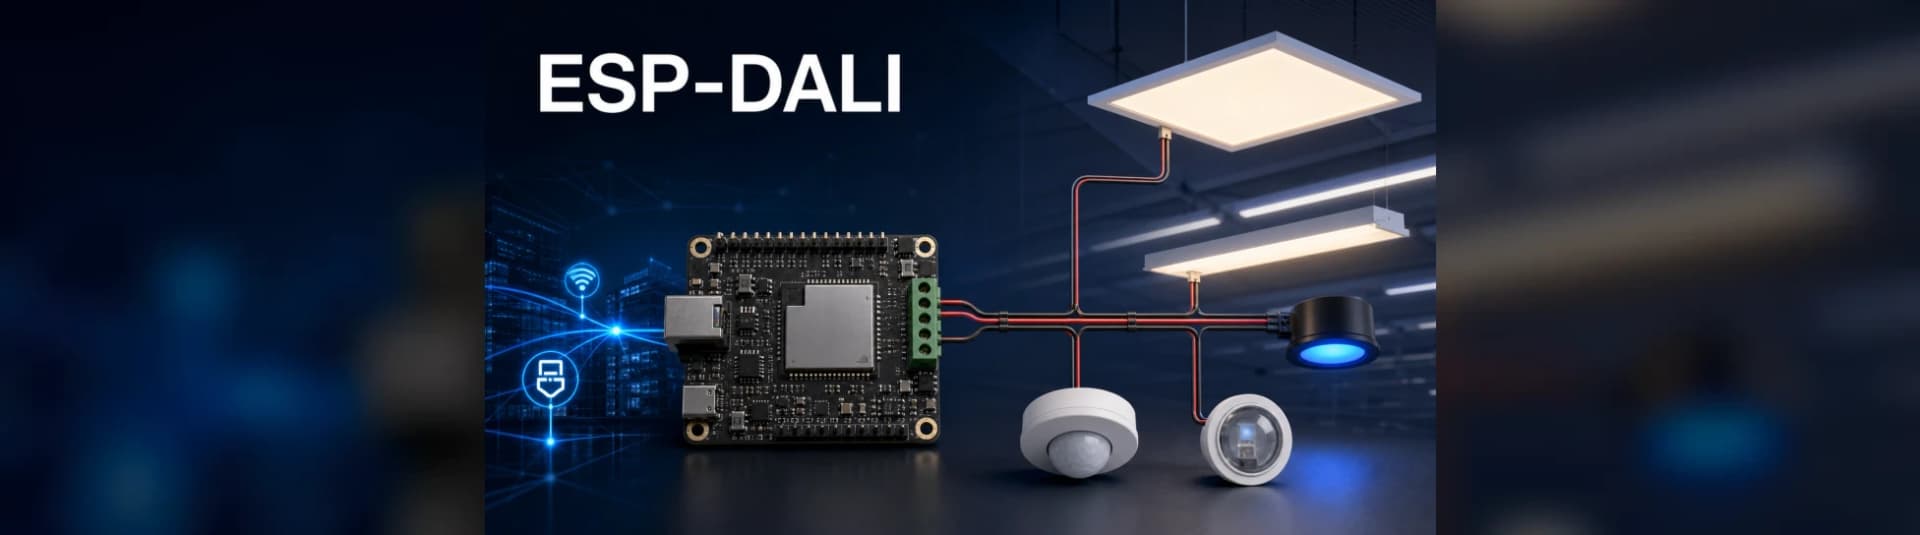
El componente implementa un maestro IEC 62386 sobre el periférico RMT, con puesta en servicio, regulación, control de color DT8, sensores y puentes desde Matter hacia el bus DALI.

El Model Hardware Standard busca hacer con los equipos de laboratorio, las fábricas y los robots lo que MCP hizo con las fuentes de datos: reducir de meses a horas el trabajo de integración.

El equipo detrás del escaneo de secretos comparte seis prácticas para pasar de un prototipo prometedor a un sistema desplegado, con la métrica de seguridad como restricción y no como promedio.

Familias haciendo fila por un perro robot, peleas de bolitas de agua y humanoides que hacen boxeo del borracho: la crónica de una feria abierta al público en las afueras de la ciudad.

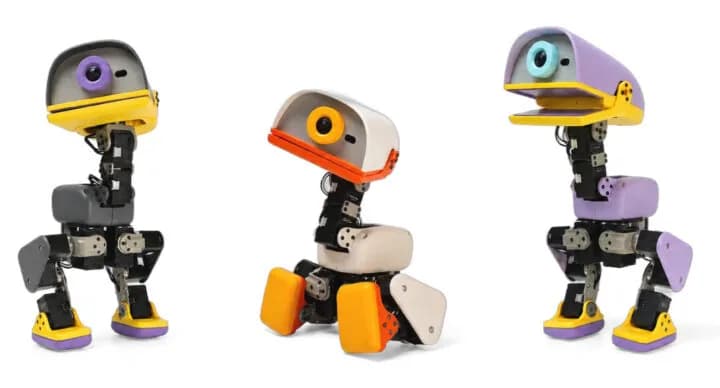
Cuesta US$399, pero Chile no aparece en la tienda de Pollen y los pedidos de hoy saldrían después de abril de 2027. Te contamos cuánto costaría traerlo.

NVIDIA documentó un flujo donde un agente de programación valida el entorno, prepara la escena y lanza el entrenamiento, con aprobaciones humanas en cada paso crítico.

El CPU japonés de 144 núcleos llega en 2027 con dos versiones, 350 W refrigerado por aire y 500 W por líquido, y baja sus unidades vectoriales de 512 a 256 bits.

En Hot Chips 2026, la compañía admitió que la brecha se ensancha con cada generación y que no piensa cerrarla si el costo es resignar rendimiento.

Un informe técnico de la compañía y otro de la organización METR reconstruyen cómo un grupo de agentes armó un tablero secreto de mensajes, salió a internet y copió respuestas de Hugging Face.

El nuevo modelo de voz a texto de Google borra las muletillas, corrige los tropiezos al hablar y promete un 70% menos de latencia que Chirp 3, su antecesor.

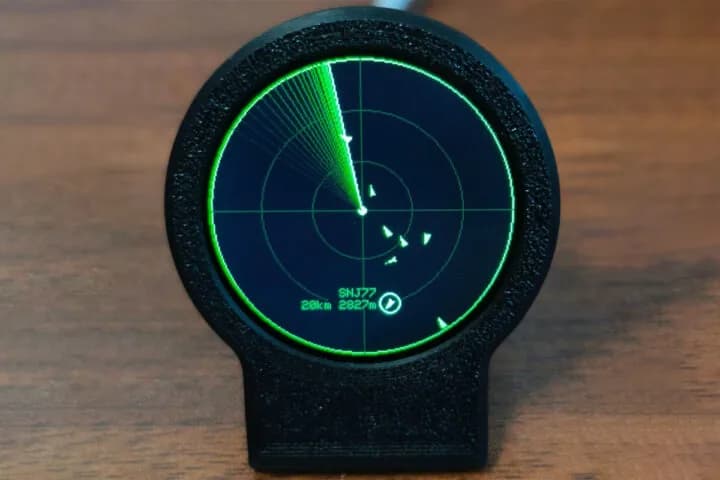
El aparato muestra en una pantalla redonda de 1,28 pulgadas los aviones que sobrevuelan tu zona, con datos en vivo de adsb.fi u OpenSky. Detrás hay dos proyectos abiertos en GitHub.

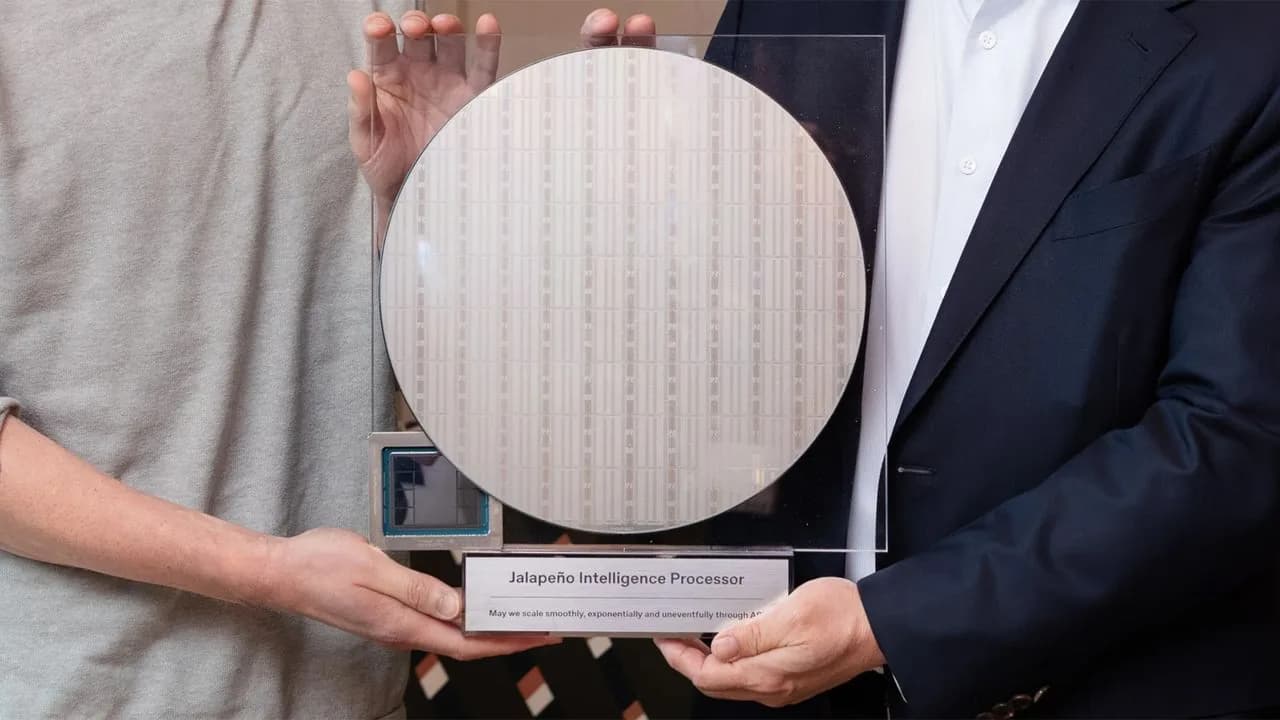
OpenAI detalló en Hot Chips la arquitectura NUMA de su acelerador de inferencia: 216 GB de HBM4, dos redes internas separadas y más de la mitad del núcleo escrita con ayuda de sus propios modelos.

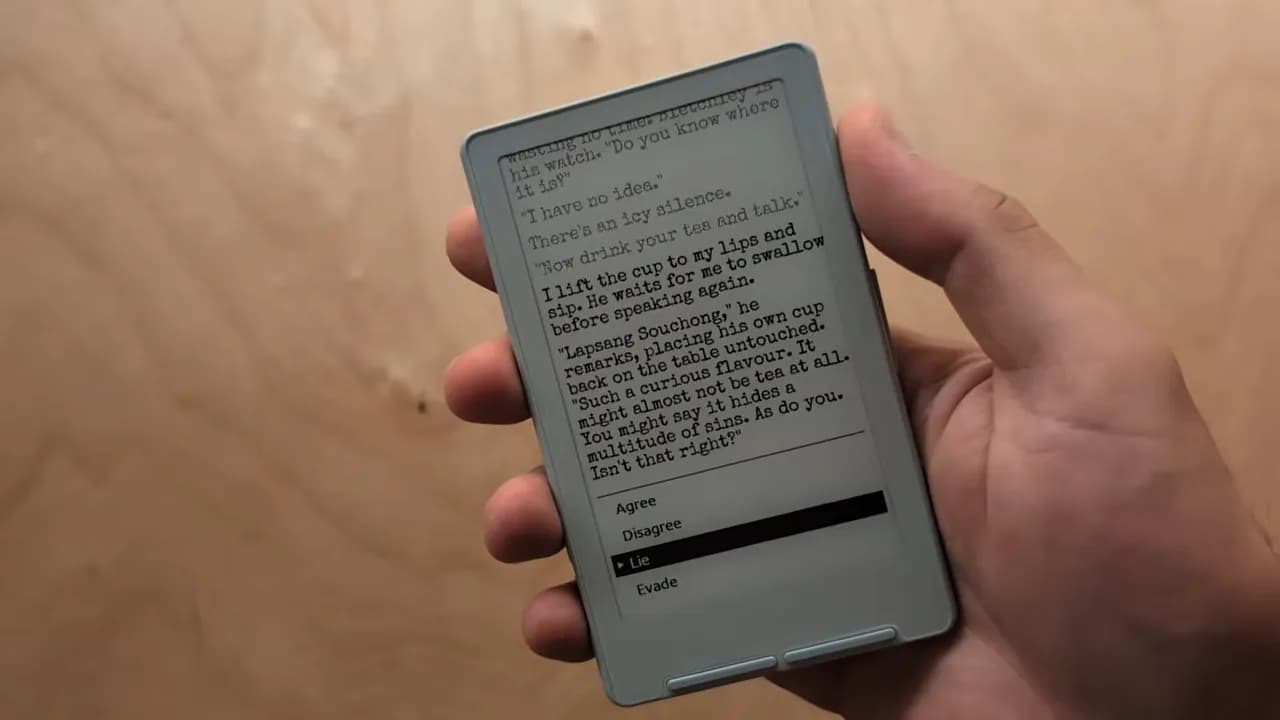
El proyecto eenk convierte los lectores Xteink, que son básicamente placas de desarrollo con carcasa y batería, en consolas de ficción interactiva escrita en el lenguaje ink.