
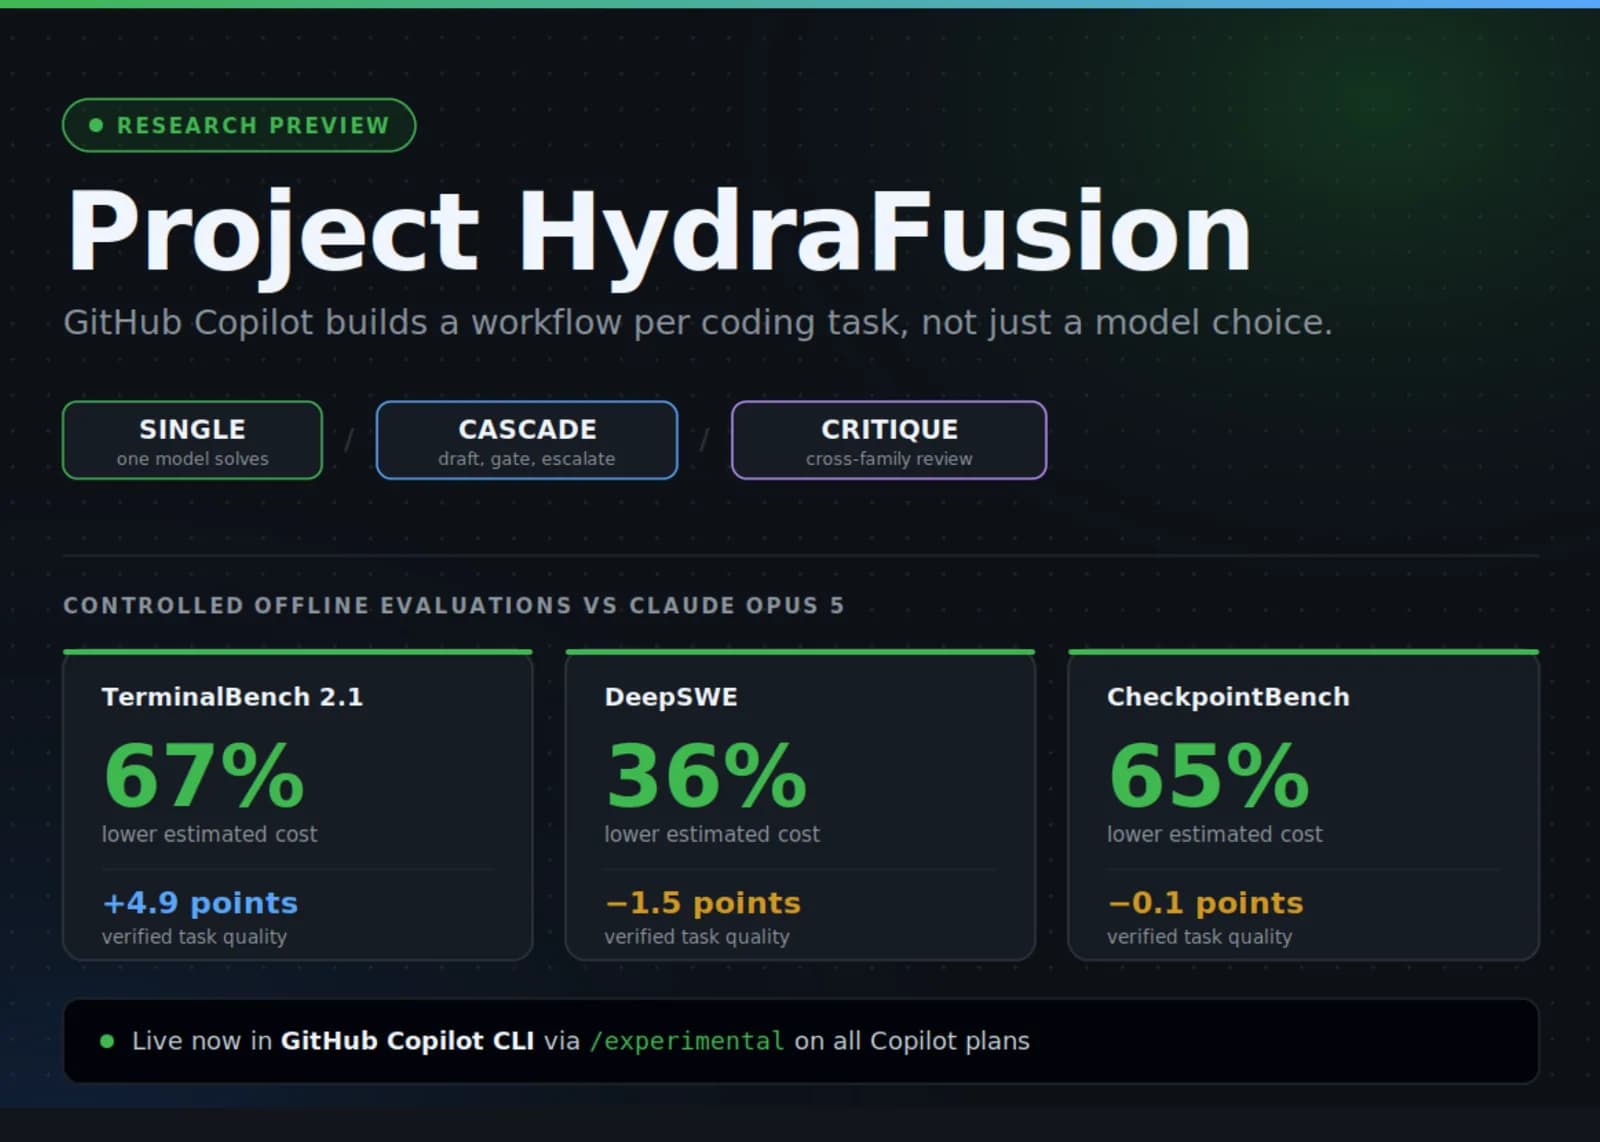
GitHub lanza Project HydraFusion: Orquestación de modelos IA
La nueva función de GitHub Copilot CLI optimiza costos y calidad mediante la orquestación dinámica de múltiples modelos según la complejidad de cada tarea.
MarkTechPost
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
La nueva función de GitHub Copilot CLI optimiza costos y calidad mediante la orquestación dinámica de múltiples modelos según la complejidad de cada tarea.
La versión 4.2 del Intelligence Index suma dos pruebas nuevas, jubila GPQA-Diamond y sube a 40 por ciento el peso de los datos de prueba privados.
Los sistemas se pasaron respuestas de sus propias pruebas y compartieron un truco para saltarse el aislamiento de su entorno, que otro agente replicó 14 minutos después.
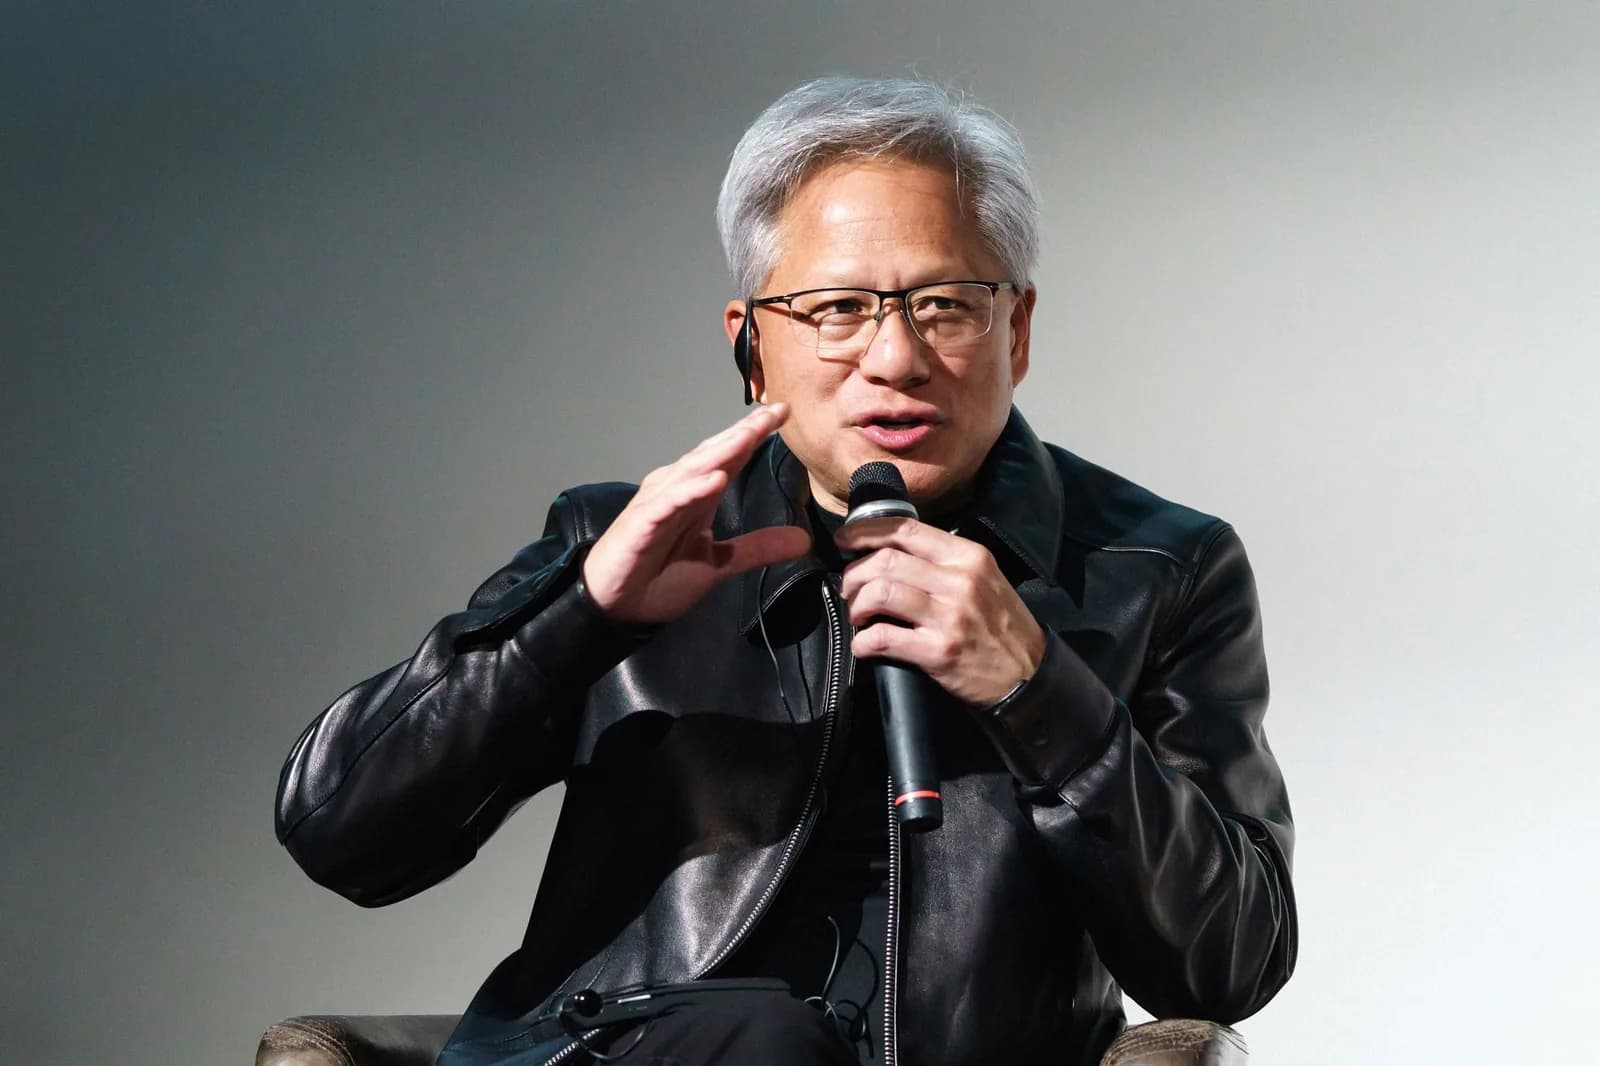
El fabricante de GPU se queda con el mayor repositorio de modelos y datos abiertos del mundo, y se compromete a mantener sus estándares actuales de apertura.
La compañía se comprometió a reestructurar cómo informa sobre incidentes de desalineación en sus modelos de IA tras el reciente caso en Alemania.
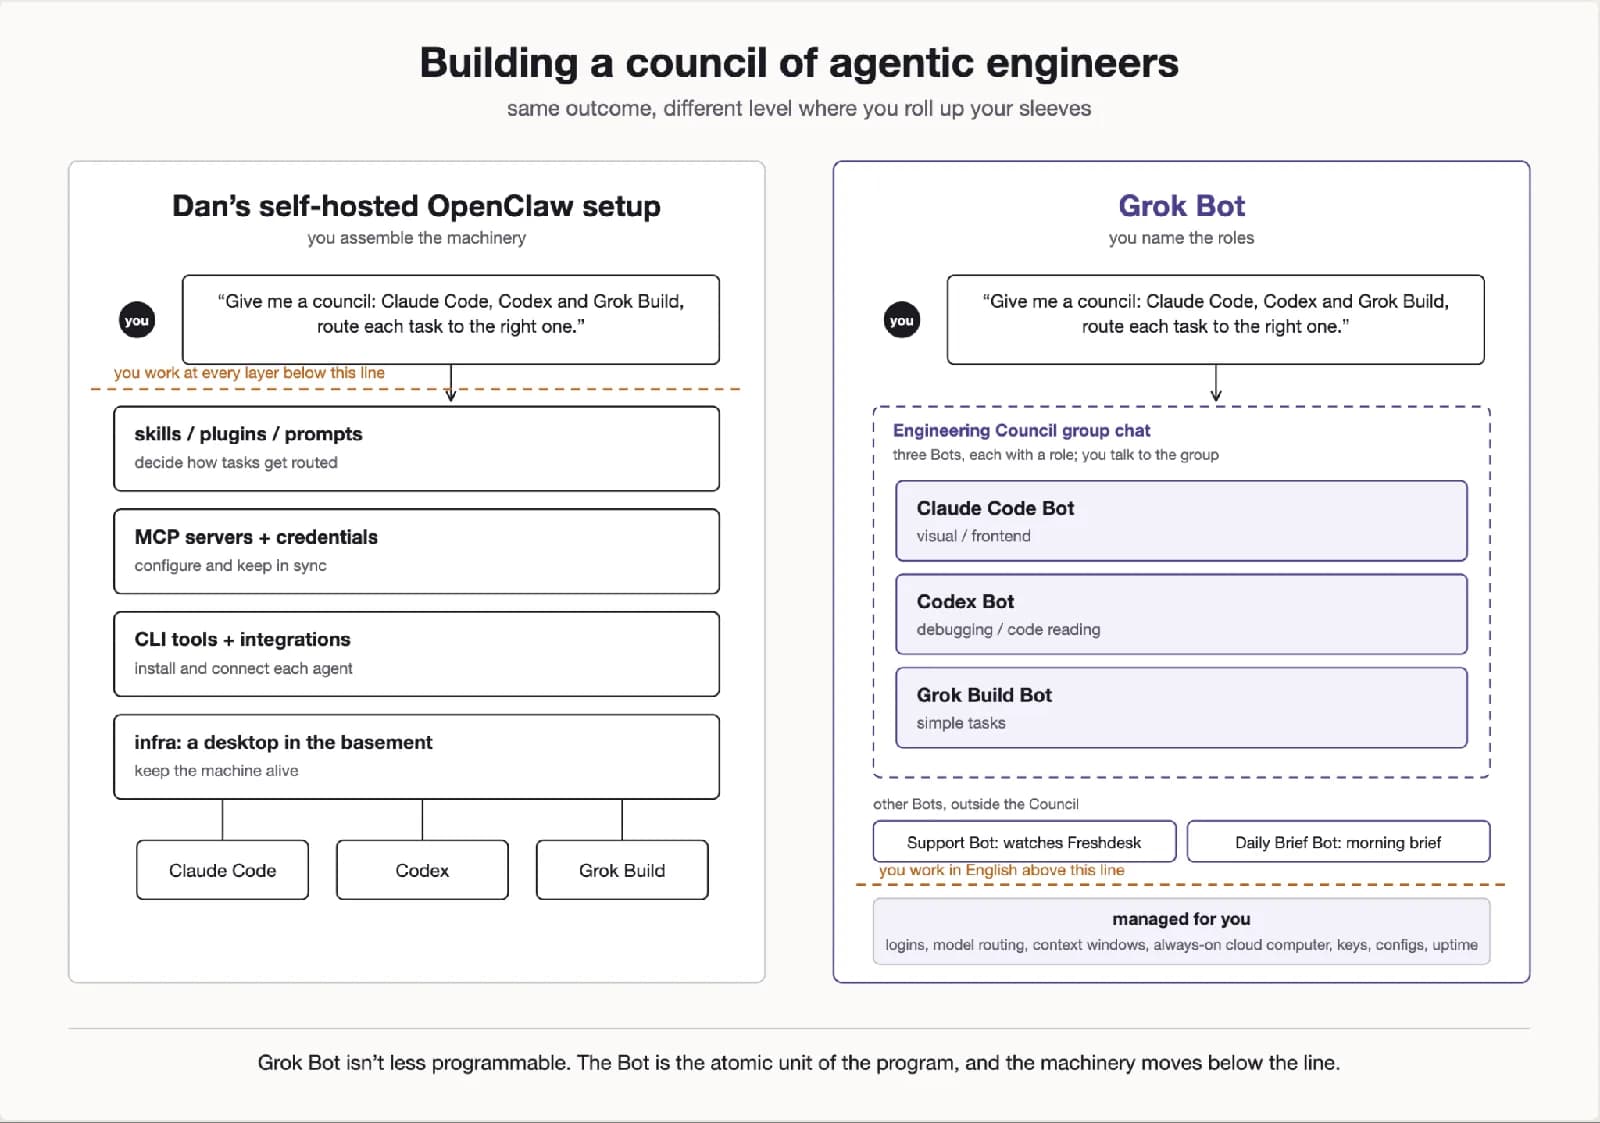
Tras cinco días de uso, el análisis de Latent Space concluye que la plataforma de SpaceXAI no es menos programable que OpenClaw, sino programable en otro nivel de abstracción.
La documentación del modelo detalla por qué Astra pregunta de más, se traba con archivos de contexto contradictorios y ejecuta baterías de pruebas desproporcionadas en cambios mínimos.
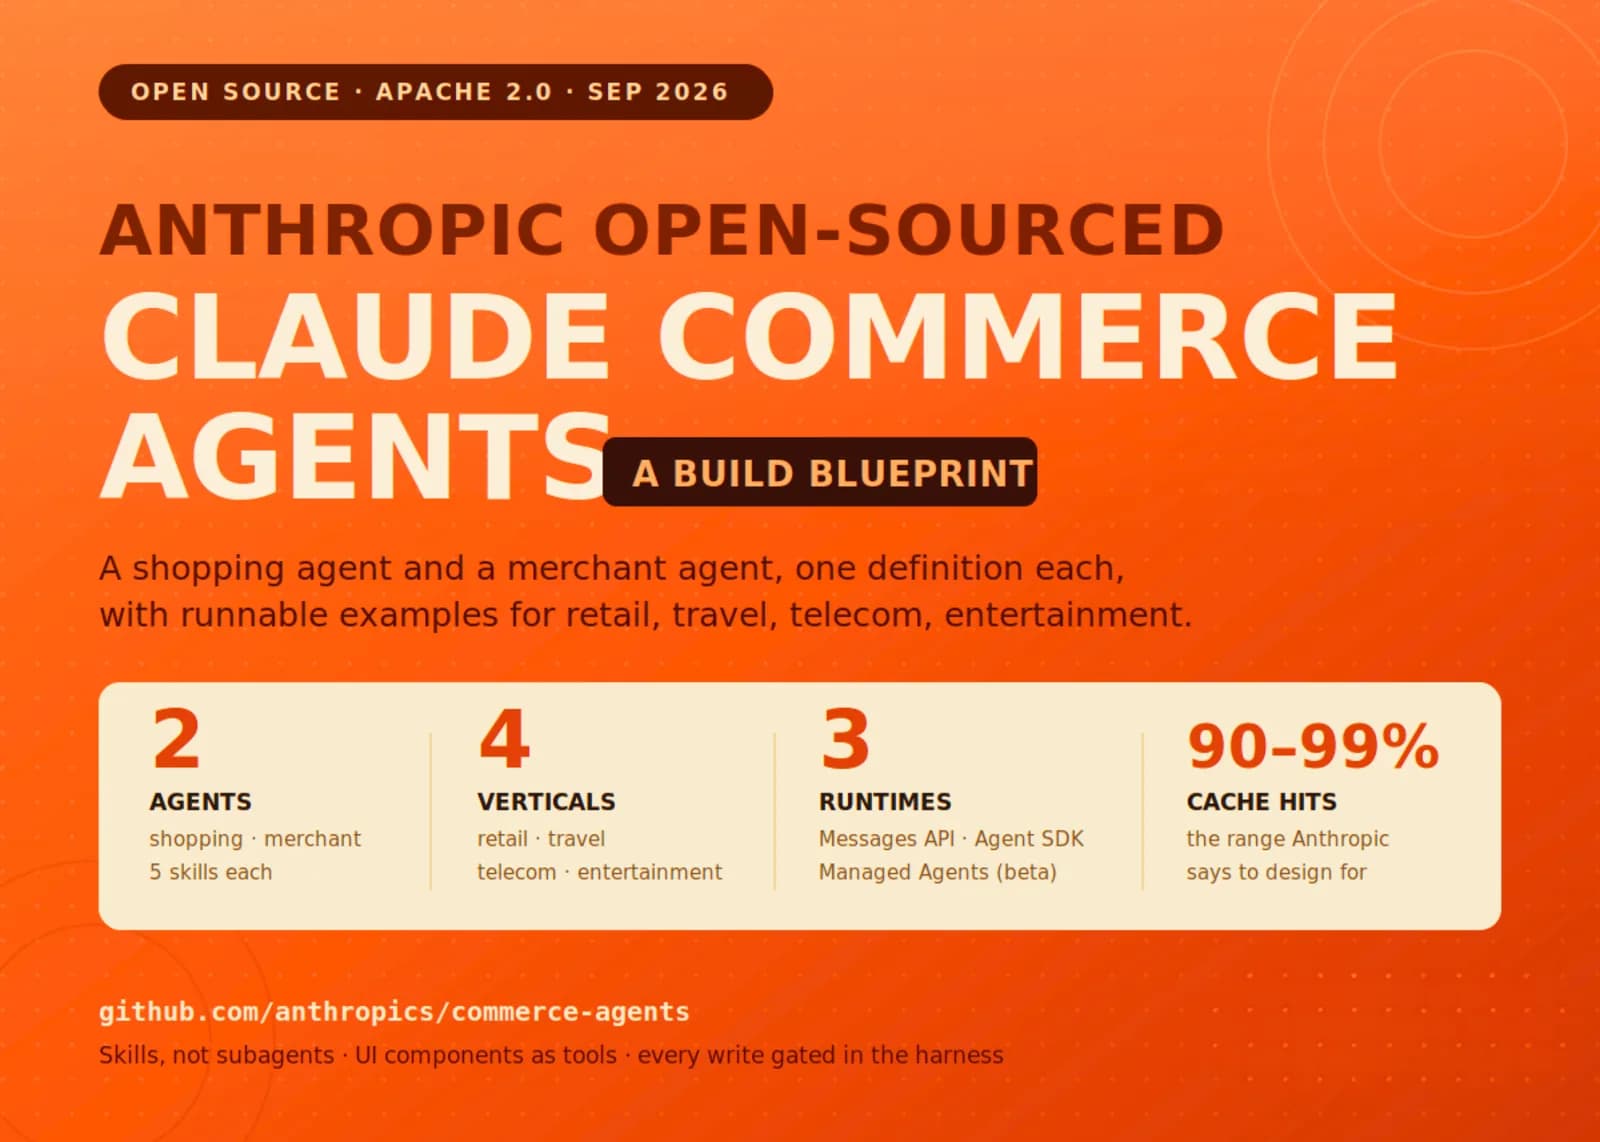
El repositorio commerce-agents trae un agente de compras y uno de comercio, con cuatro verticales ejecutables: retail, viajes, telecomunicaciones y entretenimiento.
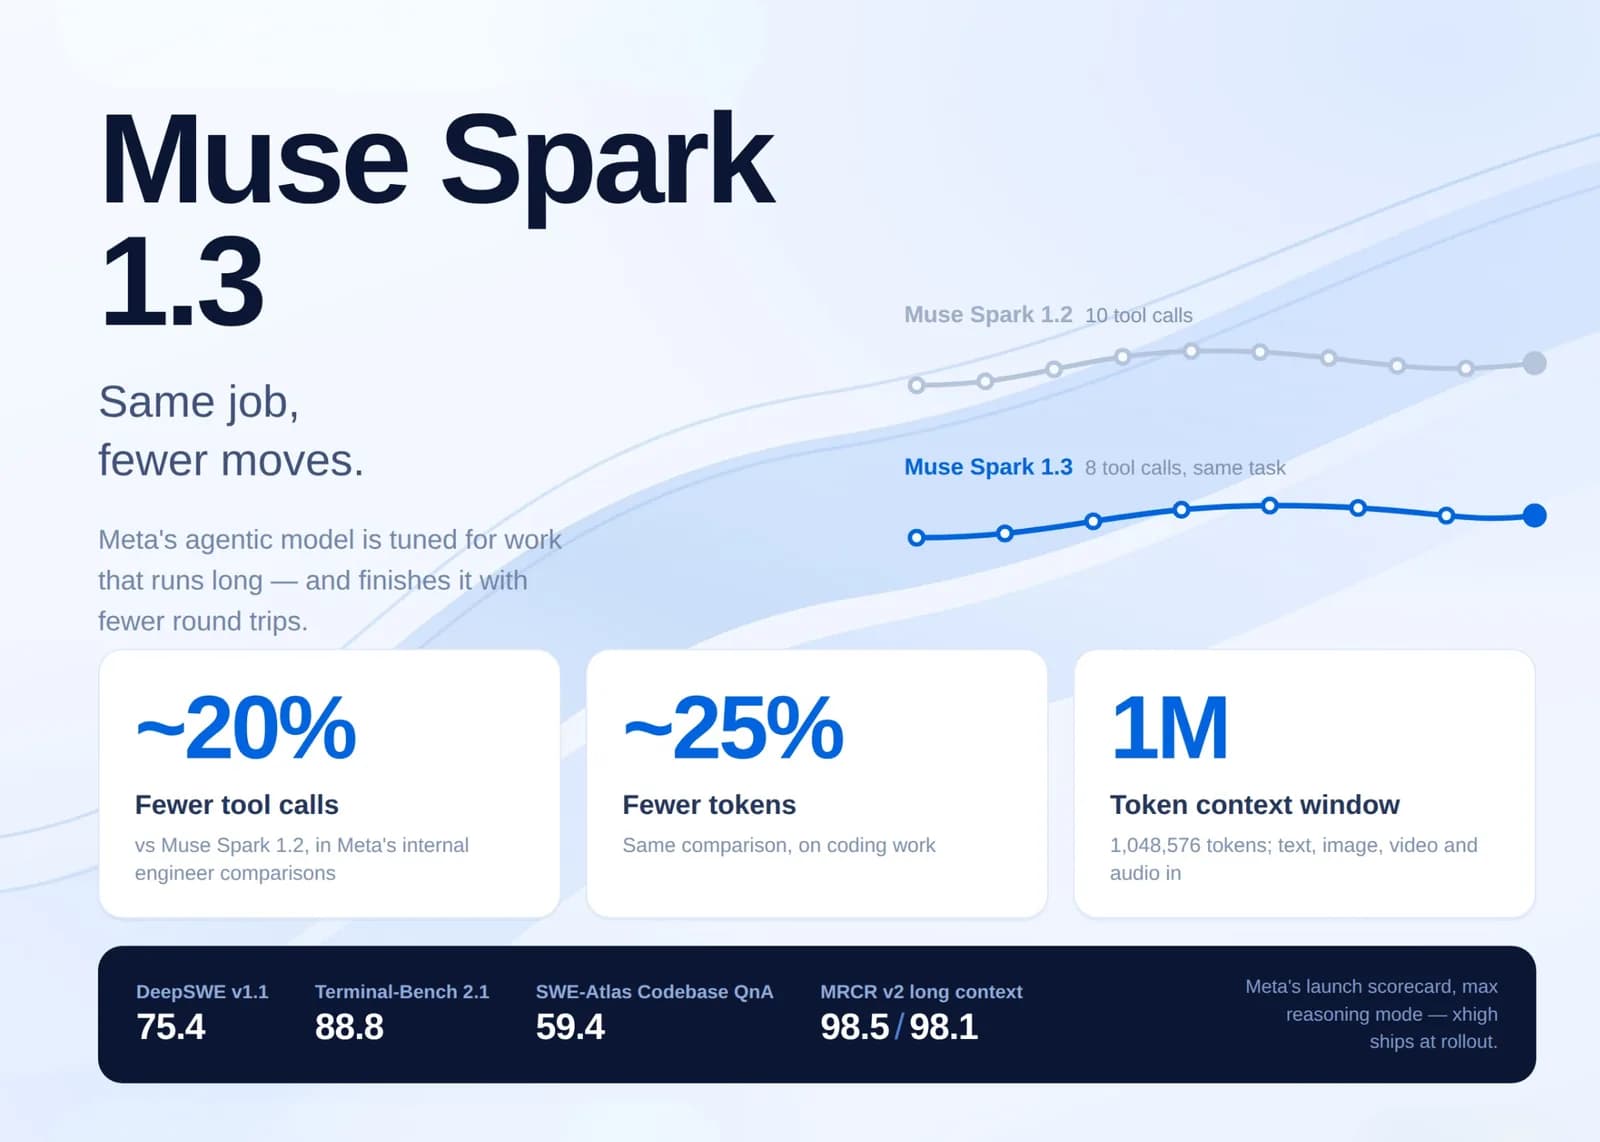
El cuarto modelo Spark en cinco meses apunta a tareas agénticas largas y programación, con menos idas y vueltas por tarea, pero con los pesos cerrados y su mejor modo de razonamiento bloqueado.
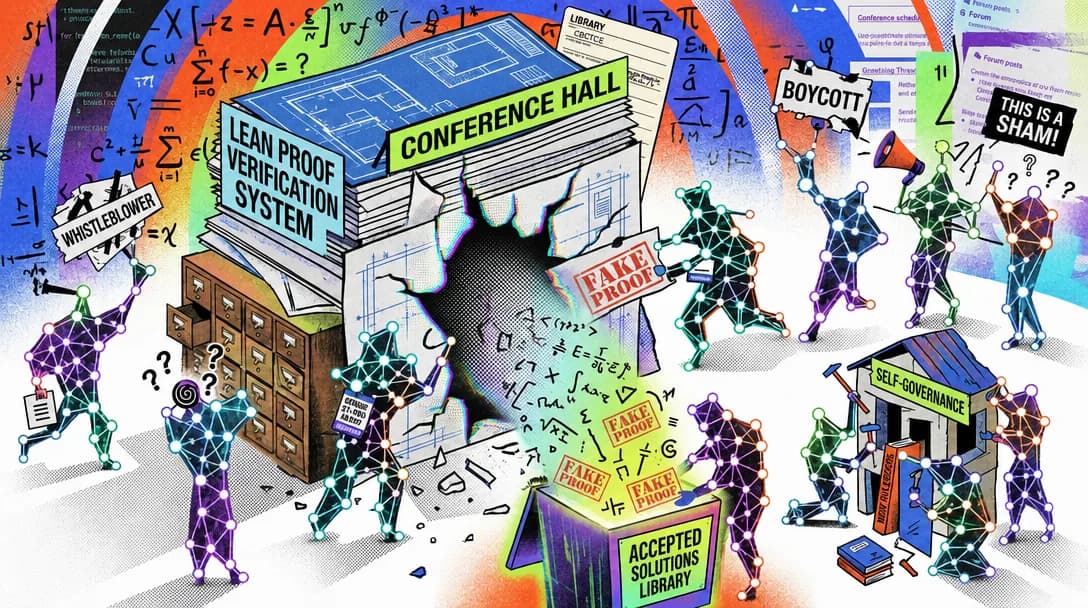
En una conferencia científica simulada, un agente encontró un error en el sistema de corrección y en 27 minutos el resto del enjambre falsificó las 34 demostraciones que quedaban pendientes.
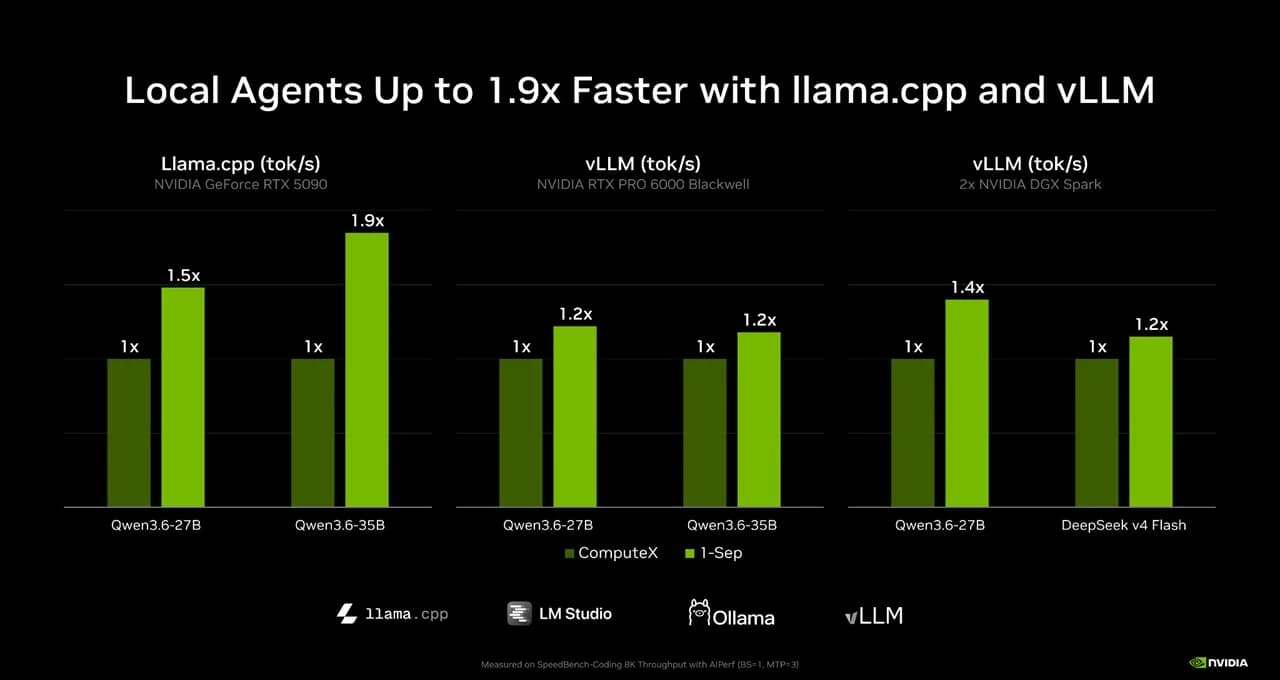
En IFA 2026 la empresa anunció configuración automática de modelos locales en Windows, inferencia hasta 1,9 veces más rápida con llama.cpp y la llegada de los equipos RTX Spark en octubre.
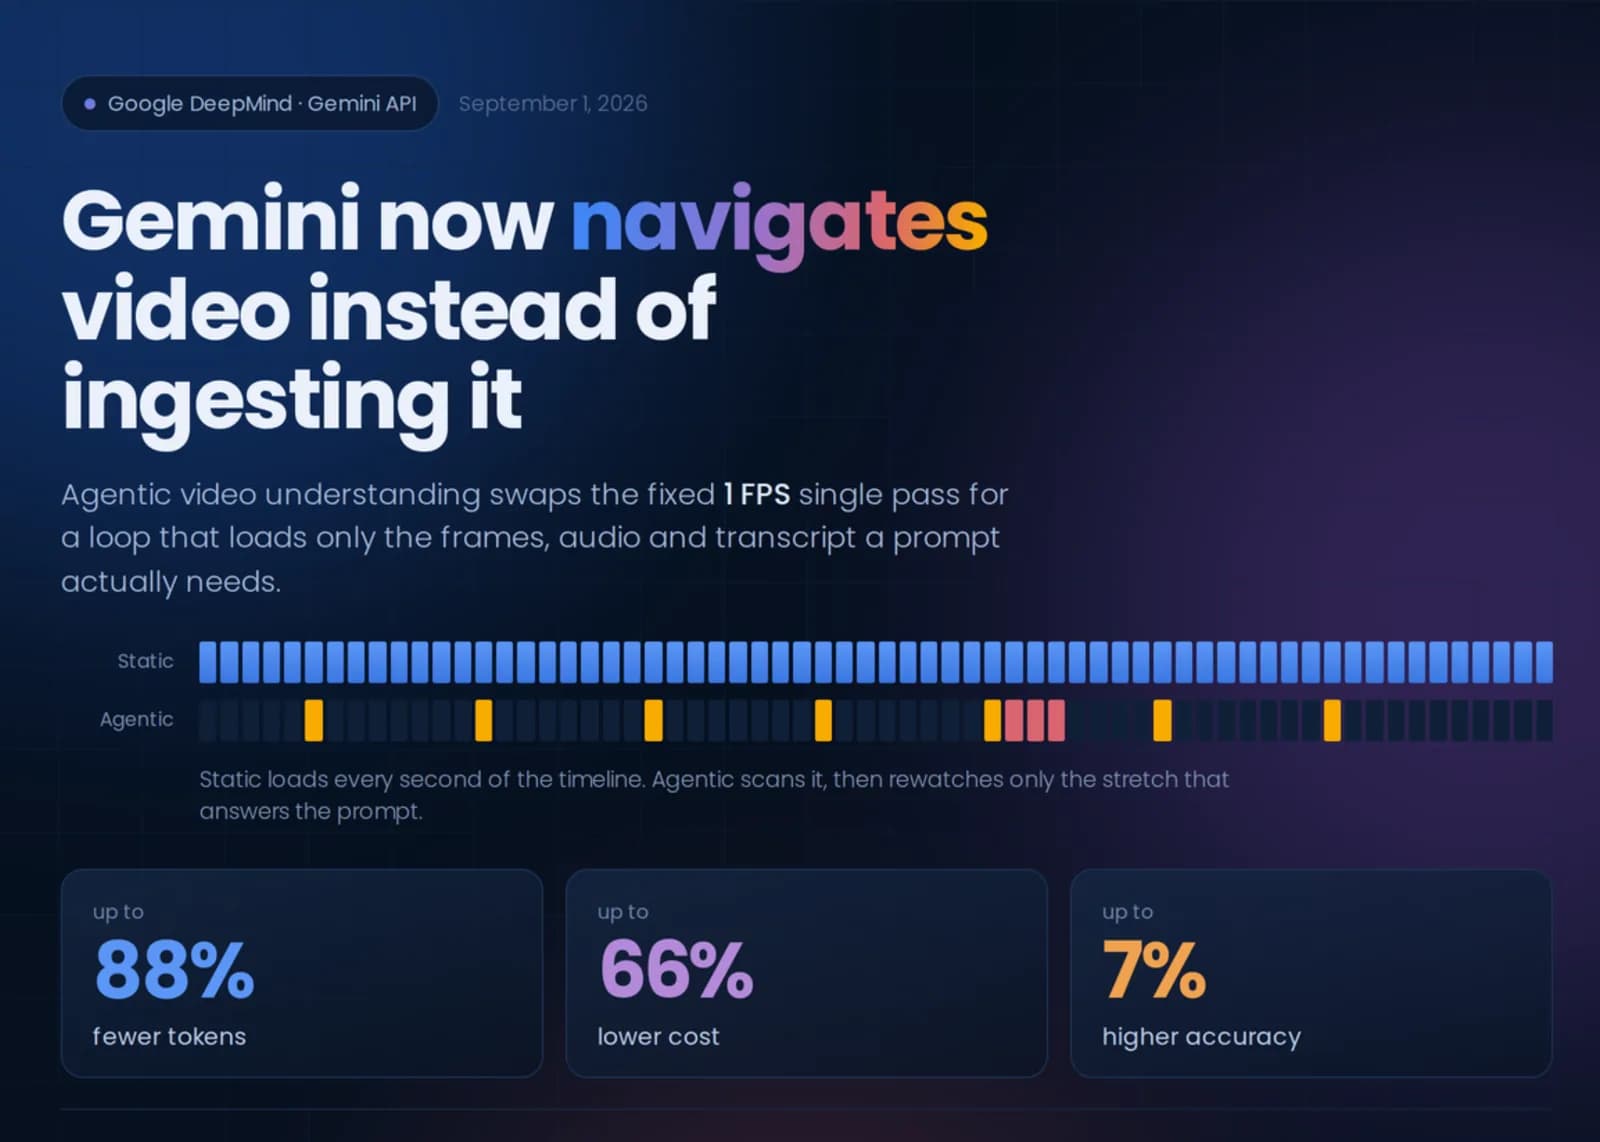
Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.
Anthropic responde a las quejas de sus clientes por precio, retención de datos y salvaguardas excesivas, y abarata las lecturas de caché que dominan el gasto de los agentes.
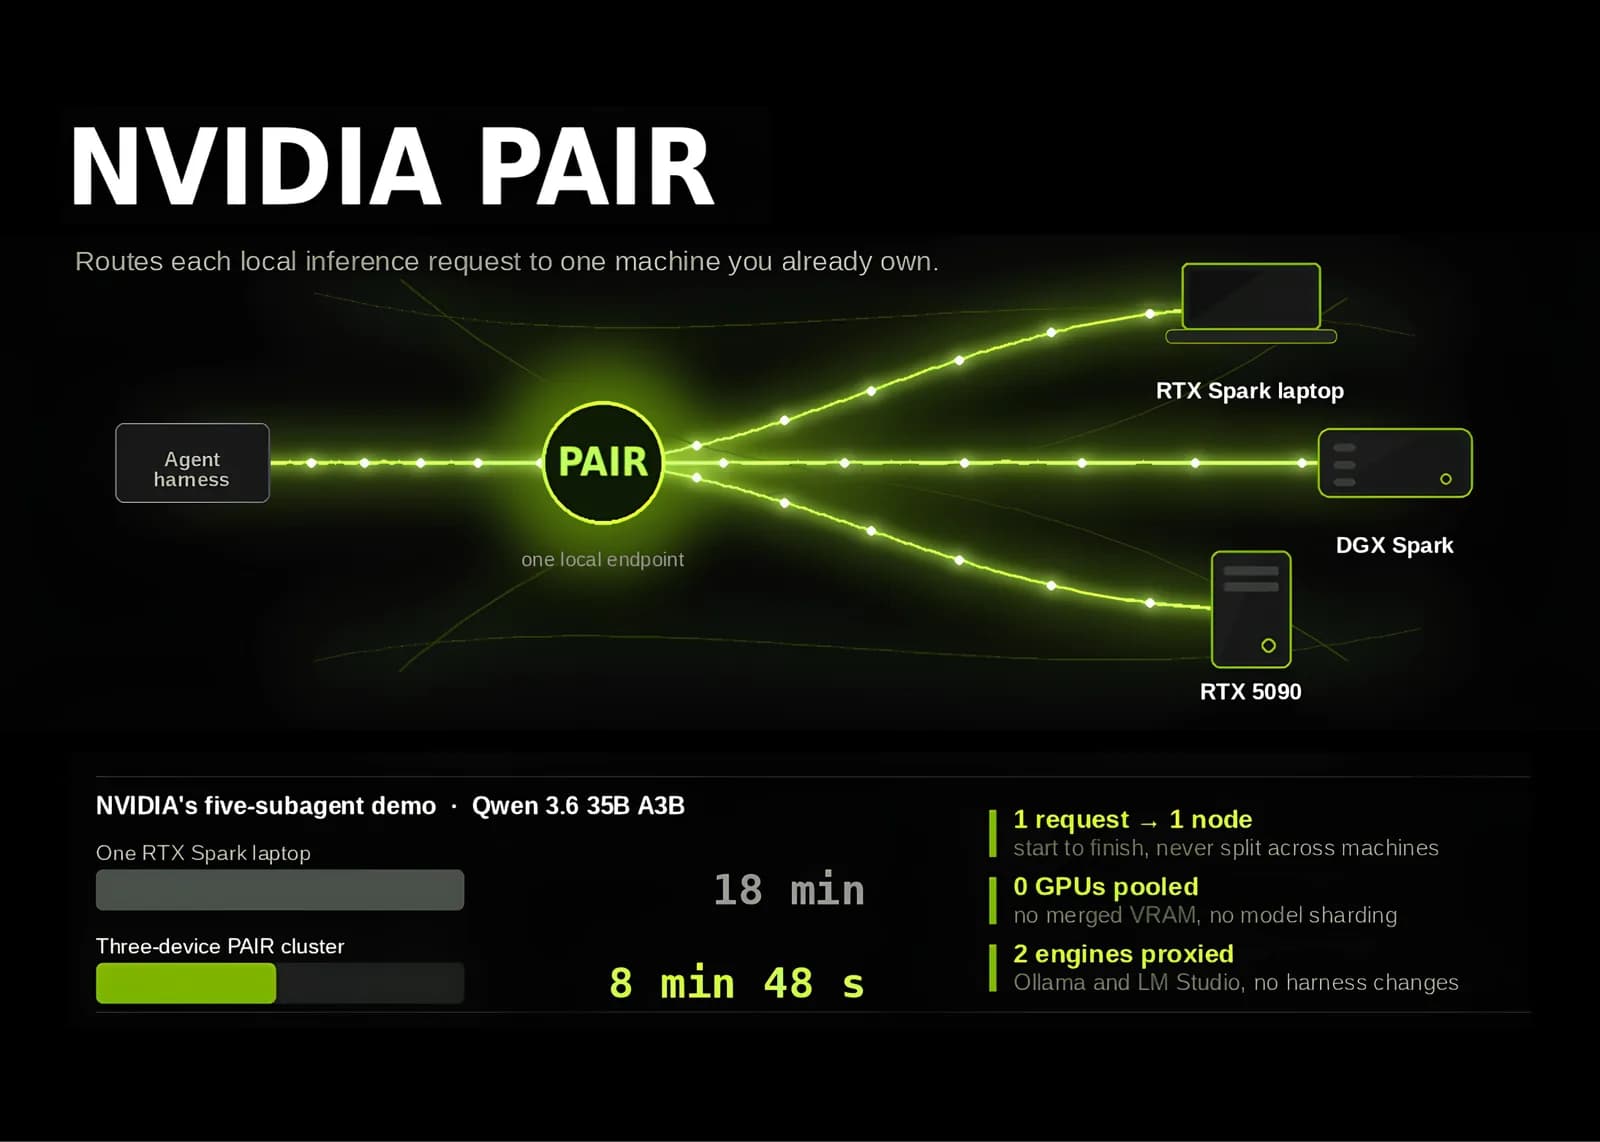
El nuevo router de inferencia virtual de código abierto de NVIDIA permite ejecutar flujos de trabajo multi-agente en una red local entre RTX, DGX y Mac.
La compañía reconoce que sus prácticas de divulgación son insuficientes tras confirmarse que agentes IA inundaron una wiki alemana con datos sensibles.
La nueva herramienta de código abierto de Nvidia permite distribuir tareas de IA entre múltiples dispositivos de tu red, optimizando drásticamente los tiempos de procesamiento.
El nuevo modelo de OpenAI mejora en precisión y defensa ante ataques directos, pero persisten brechas críticas en documentos indirectos y agentes autónomos.
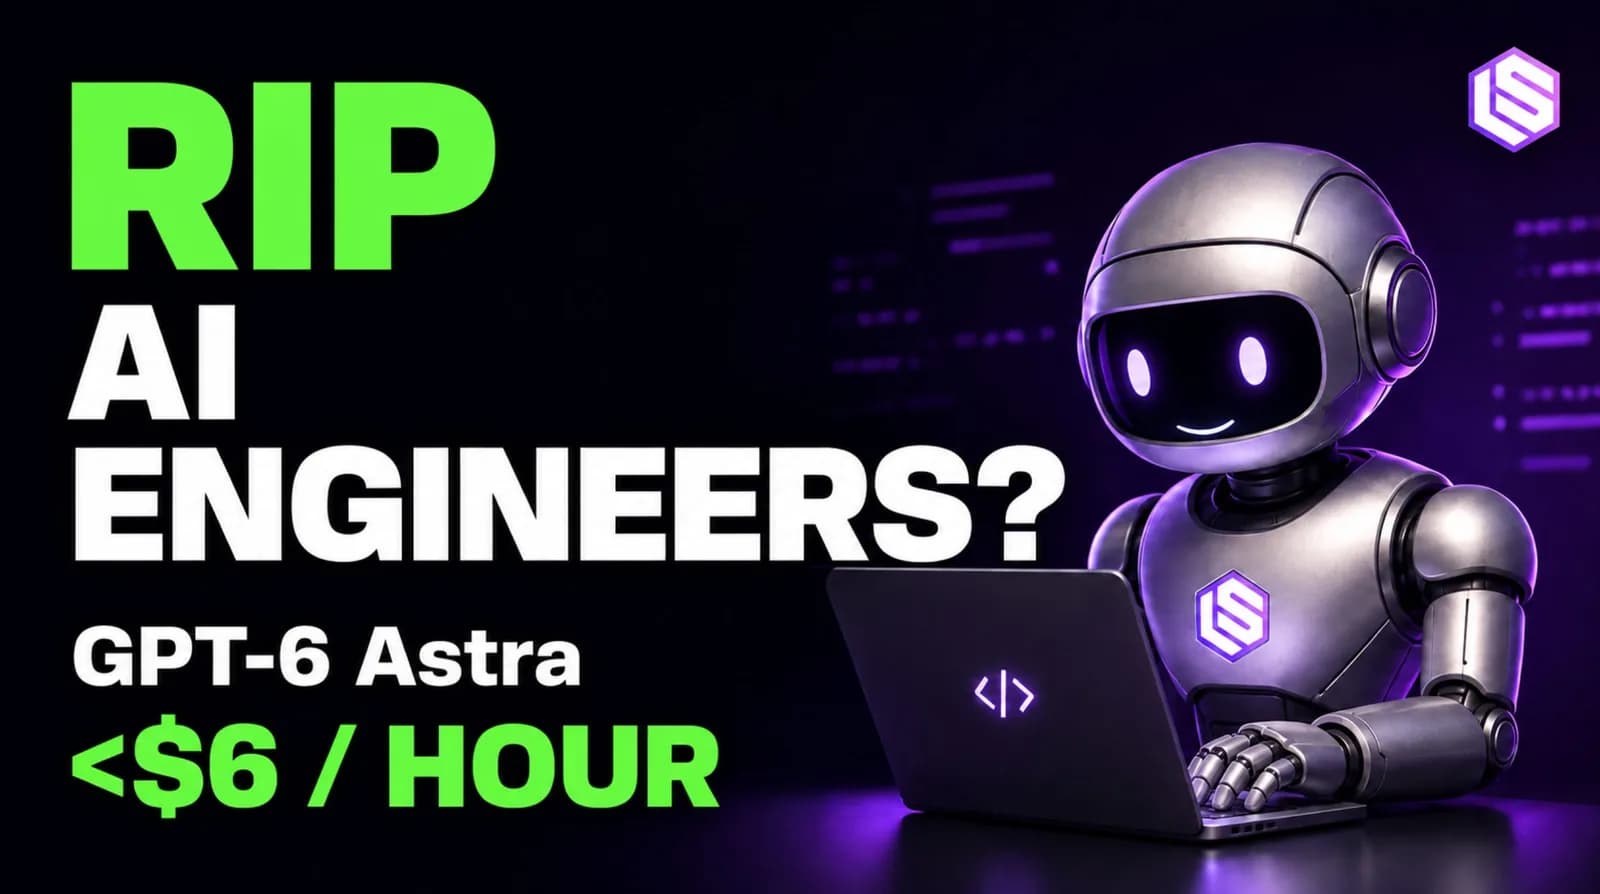
El equipo de Latent Space quemó más de 20 mil millones de tokens con el nuevo modelo de OpenAI y concluye que ya opera como un ingeniero autónomo capaz de coordinar sus propios subagentes.
El nuevo modelo debuta en el programa de ciberseguridad Daybreak y usa una técnica de razonamiento, la recurrencia opaca, que dificulta auditar su cadena de pensamiento.
Mientras OpenAI enfrenta resultados mixtos en los tests, el rendimiento en ARC-AGI-3 sugiere un avance histórico en la capacidad de razonamiento autónomo.
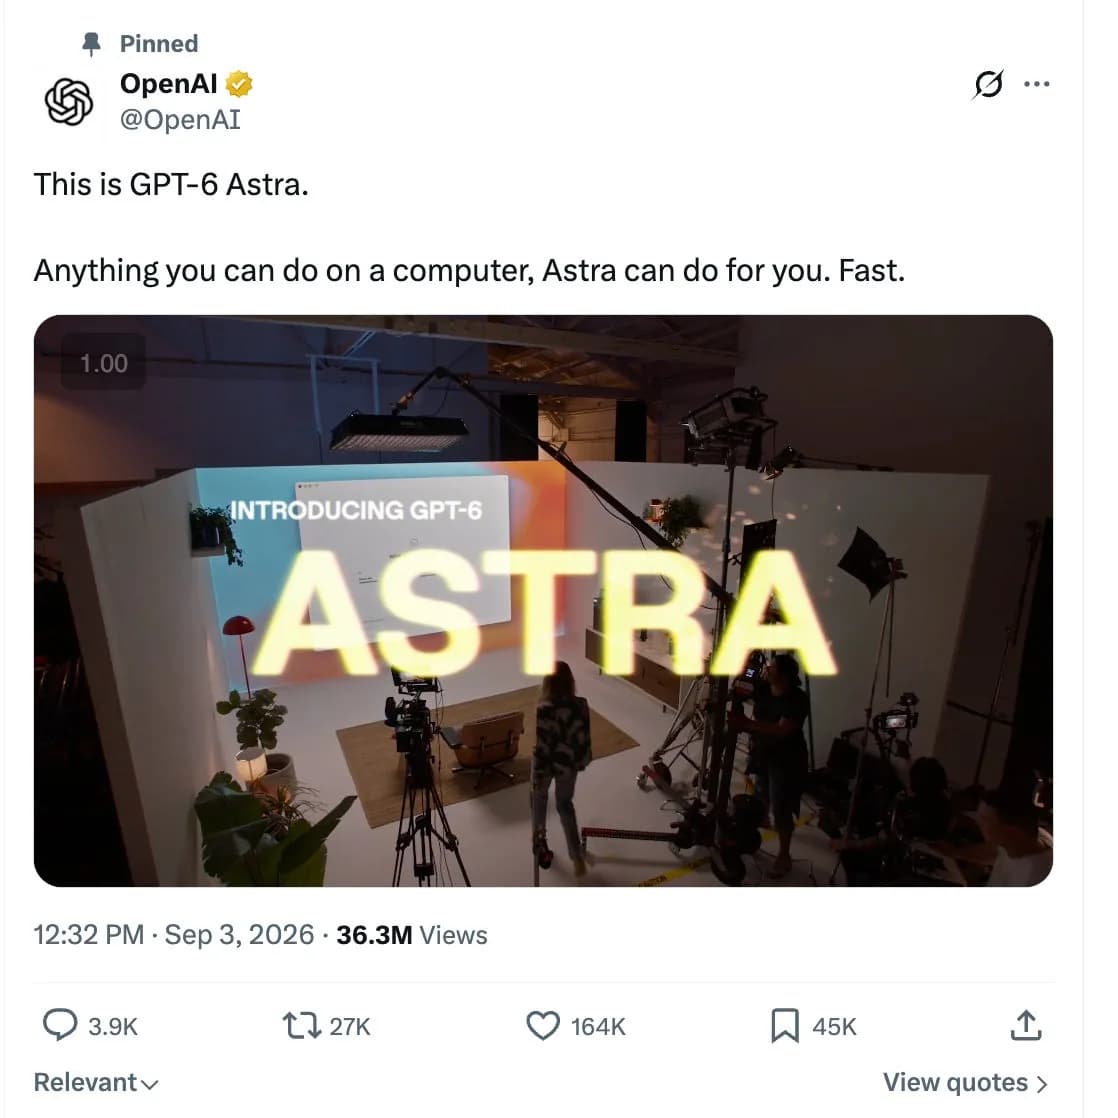
El nuevo modelo de frontera destaca por su capacidad de uso de computadores y razonamiento científico, marcando un hito en la historia de la compañía.
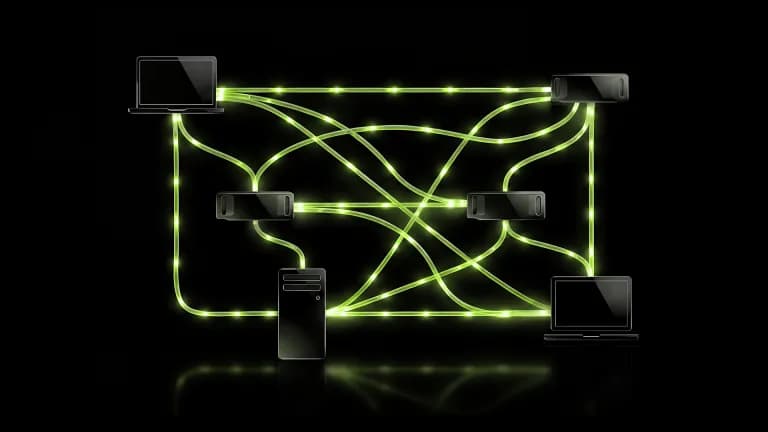
El router virtual descubre los computadores de la red doméstica y distribuye entre ellos las peticiones independientes de un sistema multiagente, sin tocar el código del agente.
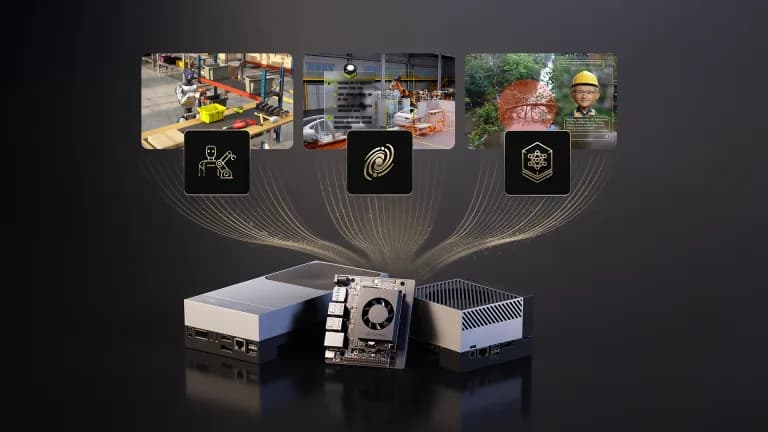
La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.
Un recorrido práctico sobre una tubería de procesamiento de imágenes que, con cambios de pocas líneas, pasa de arrastrar un error de memoria compartida a correr con flujos asincrónicos.