La empresa china de robótica AGIBOT presentó GO-3 Preview, un modelo de IA corporizada pensado para que los robots aprendan de forma continua y mejoren sus capacidades.
El modelo usa una arquitectura llamada World Reasoning Action Model (WRAM), que une el razonamiento sobre la tarea, la predicción del resultado y la generación de la acción.
Según AGIBOT, GO-3 Preview quedó en primer lugar en tres benchmarks de IA corporizada, RoboDojo, RoboTwin y RoboColiseum. La compañía planea liberar el modelo completo como código abierto antes de fines de 2026.
Un modelo para que el robot aprenda
GO-3 Preview está diseñado para que los robots adquieran habilidades nuevas, se adapten a tareas desconocidas y mejoren con la experiencia en el mundo real. La arquitectura WRAM conecta razonamiento, predicción y acción física, de modo que el robot interpreta instrucciones, anticipa resultados y traduce sus decisiones en movimientos.
El modelo se lanzó el 29 de octubre y apoya el aprendizaje continuo en tres etapas, que son el preentrenamiento, el postentrenamiento y el despliegue.
El enfoque combina dos tipos de datos de entrenamiento. Los videos de personas grabados en primera persona muestran cómo la gente manipula objetos y hace actividades cotidianas. Las trayectorias de robots, por su parte, conectan observaciones visuales con acciones físicas y sus resultados. Al aumentar la capacidad de aprendizaje del modelo, AGIBOT busca convertir esas fuentes de experiencia en habilidades transferibles, que el robot pueda aplicar a tareas que nunca vio.
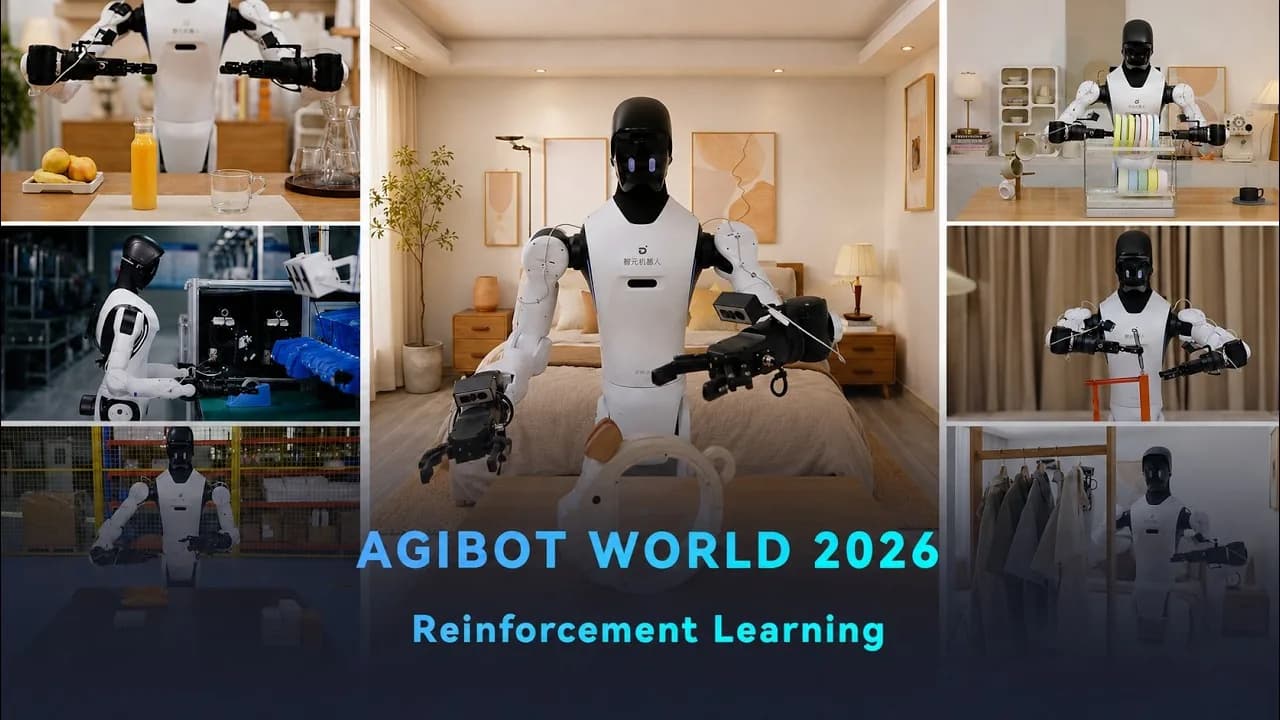
En el preentrenamiento, GO-3 Preview está pensado para hacer tareas desconocidas en entornos distintos, como casas, cocinas y espacios con varios robots. Según AGIBOT, el modelo también maneja manipulación diestra sin necesitar un ajuste fino adicional para cada actividad nueva.
Con pocas demostraciones, el sistema aprende actividades complejas de varios pasos. Un ejemplo es preparar jianbing, una crepa salada tradicional china, que obliga al robot a coordinar varios movimientos delicados. Tras un ajuste fino, el modelo también arma piezas de Lego, con un agente de IA que coordina cada paso.
La idea es reducir el entrenamiento específico que hace falta cada vez que un robot llega a un entorno nuevo. En vez de construir un modelo distinto para cada actividad, el sistema recurre a lo que ya aprendió y lo adapta a otra situación.
Para el postentrenamiento, AGIBOT desarrolló Genie Evolver, un sistema de entrenamiento distribuido que combina datos de unos 100 robots físicos con simulaciones físicas y modelos del mundo. Con él, los robots practican tareas, evalúan su desempeño y mejoran con intentos repetidos.
¿Cuánto mejora el robot con GO-3?
En una demostración de curling sobre una mesa, un robot superó el desempeño promedio de las personas evaluadas después de cuatro horas de práctica en línea. En otro experimento, sacó cinco bloques seguidos de una torre sin derribarla.
Las demostraciones muestran cómo el método usa interacción repetida y retroalimentación para mejorar la manipulación física. Combinar la experiencia de robots reales con simulación también da más oportunidades de practicar sin depender solo de pruebas físicas.
GO-3 Preview incorpora además Genie Master, el marco de agentes de AGIBOT que conecta la toma de decisiones, la ejecución de tareas y la retroalimentación. Está pensado para que el robot detecte sus errores mientras opera, ajuste su comportamiento y guarde la experiencia útil para los intentos siguientes.
La prueba en una tienda real
AGIBOT mostró esa capacidad con un robot G2 instalado en una tienda de conveniencia real. El robot identificó las causas de sus propias fallas, cambió su forma de abordar la tarea y guardó lo aprendido, sin demostraciones humanas ni ajustes manuales.
Su tasa de éxito en el flujo completo de la tarea subió de 28,6% el primer día a un 85,7% estable después de cinco días. En otra tarea, colgar ganchos pequeños, la empresa informó una mejora de 17,7 puntos porcentuales en el éxito de la tarea individual frente al ajuste fino supervisado convencional.
A diferencia de los métodos que dependen sobre todo de preparar conjuntos de datos y actualizar el modelo antes del despliegue, este marco deja que el robot siga aprendiendo mientras hace un trabajo real.
GO-3 Preview se apoya en tres capas. Un preentrenamiento a gran escala, un postentrenamiento distribuido y un aprendizaje guiado por retroalimentación después del despliegue. La liberación como código abierto que planea AGIBOT daría a investigadores y desarrolladores acceso a la arquitectura.