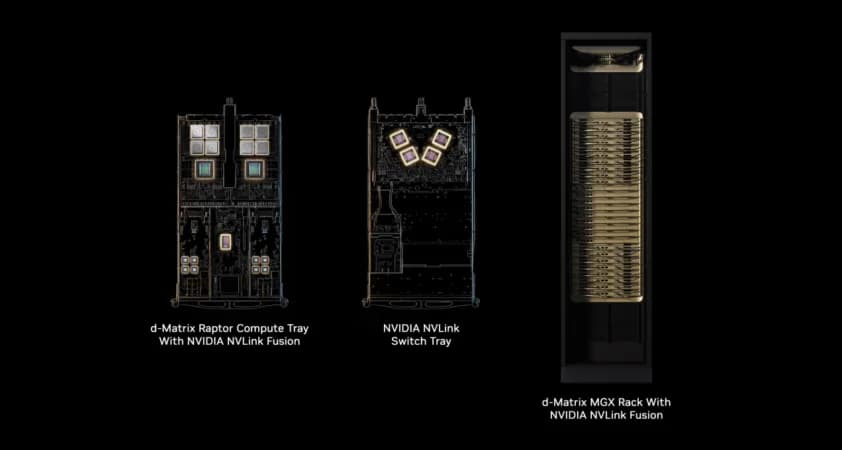
La startup de infraestructura de inteligencia artificial d-Matrix se sumó el jueves a la lista creciente de fabricantes de chips que licencian la tecnología de interconexión NVLink Fusion de Nvidia y sus diseños de referencia a escala de rack, con el objetivo de volver su plataforma de inferencia de alto rendimiento más accesible para los clientes.
Bajo el acuerdo, d-Matrix integrará soporte para NVLink Fusion, una interconexión de alta velocidad entre chips que Nvidia empezó a licenciar el año pasado, en sus futuros diseños de silicio, incluidos los próximos aceleradores Raptor.
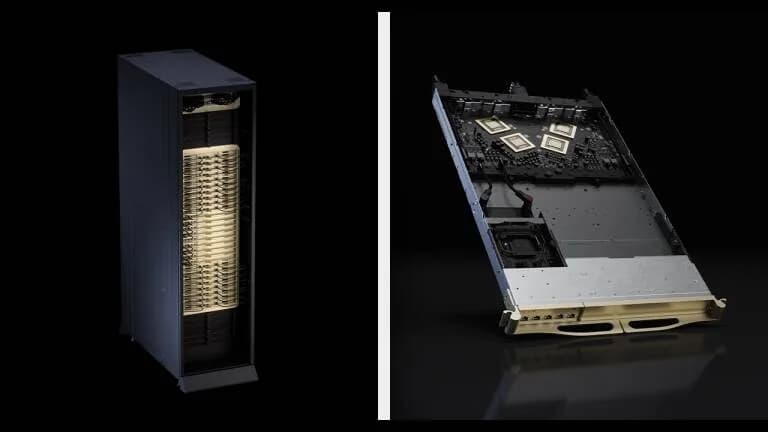
Al adoptar la tecnología, d-Matrix esquiva muchos de los desafíos asociados a escalar su arquitectura de chip a través de grandes clústeres de cómputo. Al usar NVLink en lugar de interconexiones alternativas y diseñar sus placas de cómputo en torno a los diseños de referencia MGX del gigante de las GPU, sus clientes pueden desplegar esos chips usando los mismos racks y las mismas mallas NVSwitch que Nvidia.
¿Qué promete el acelerador Raptor?
Para fines del próximo año, d-Matrix espera ofrecer sistemas con hasta 144 aceleradores Raptor conectados por una única malla NVLink de todos contra todos. Aunque todavía hay mucho que no se sabe sobre Raptor, en la conferencia Hot Chips del mes pasado la compañía reveló que cada "tarjeta" Raptor tendría 32 GB de DRAM apilada en 3D a bordo, capaz de entregar 100 TB/s de ancho de banda de memoria, cerca de 4,5 veces el ancho de banda de memoria de la GPU Rubin de Nvidia.
Por lo que se ve, las XPU que alimentarán los racks NVL144 de d-Matrix tienen alrededor de la mitad del tamaño de las tarjetas Raptor mostradas en Hot Chips e incluyen unos 16 GB de DRAM 3D y cerca de 50 TB/s de ancho de banda, cifras de todos modos respetables por cualquier medida. Con 144 de estas por rack, d-Matrix apunta a unos 2,3 TB de capacidad de memoria, suficiente para modelos que superen los cuatro billones de parámetros con precisión de 4 bits, y a unos 7,2 petabytes por segundo de ancho de banda agregado máximo.
Las cuentas cierran: cuatro billones de parámetros a medio byte cada uno consumen exactamente 2 TB, así que el margen que queda para caché de contexto y activaciones es estrecho pero real.
Esto se logra uniendo la lógica de cómputo sobre una pila de DRAM. El resultado es una plataforma de cómputo en memoria que ofrece una capacidad modesta manteniendo un ancho de banda más cercano al de la SRAM que al alcanzable con HBM.
¿Por qué el ancho de banda de memoria decide todo?
El ancho de banda de memoria es el mayor cuello de botella para la inferencia de inteligencia artificial. Cuanto más rápida sea la memoria, más rápido puede el sistema escupir tokens. Esa es exactamente la razón por la que Nvidia desembolsó 20.000 millones de dólares el año pasado para licenciar la propiedad intelectual de Groq y contratar a su talento de ingeniería. La arquitectura de flujo de datos del chip, cargada de SRAM, era capaz de alcanzar 150 TB/s por unidad, pero la contrapartida es que la SRAM no resulta eficiente en términos de espacio y el fabricante solo lograba meter 500 MB de ella en un único troquel.
El Raptor de d-Matrix promete entregar una fracción decente de ese ancho de banda con 64 veces más capacidad, lo que significa que la compañía puede arreglárselas usando muchos menos chips por modelo. Donde un modelo de un billón de parámetros podría necesitar más de 2.000 LPU Groq 3 con precisión de 8 bits, un único sistema d-Matrix requeriría cerca de 64 (32 con precisión de 4 bits).
Igual que las LPU de Groq, los chips de d-Matrix pueden desplegarse de forma independiente o como parte de una configuración de cómputo heterogéneo, usando GPU para la fase de procesamiento del prompt, intensiva en cómputo, y sus aceleradores Raptor para la fase de generación de tokens, limitada por ancho de banda de memoria.
Y para las empresas interesadas en las capacidades de inferencia de latencia ultrabaja de Groq, los chips de d-Matrix podrían ofrecer un punto de entrada más económico, ya que se requieren menos XPU.
El jardín cerrado de Nvidia
Nvidia gana bastante más que ingresos por licenciamiento con quienes adoptan NVLink Fusion.
Además de licenciar la tecnología de interconexión, d-Matrix planea emparejar sus aceleradores con las CPU Vera del gigante de las GPU, sus equipos NVSwitch, sus tarjetas de red BlueField y ConnectX, y sus productos Ethernet SpectrumX. En otras palabras, Nvidia se queda con una buena cantidad de dinero incluso cuando no está vendiendo GPU.
Parece que un número considerable de diseñadores de chips está dispuesto a cerrar ese tipo de acuerdo para evitar tener que diseñar sus redes de escalado vertical o sus sistemas de rack. La semana pasada, MediaTek se sumó a Marvell, Qualcomm, Arm, Fujitsu y Amazon Web Services en la adopción de las interconexiones NVLink Fusion.
Nvidia está tan comprometida con meter gente en su jardín cerrado que gasta miles de millones en incentivos para que cruce la puerta. Como parte del acuerdo con MediaTek de la semana pasada, invirtió 3.500 millones de dólares en el diseñador de SoC, mientras que gastó 2.000 millones para que Marvell entrara. No hay palabra sobre si el último acuerdo incluyó términos de ese tipo.