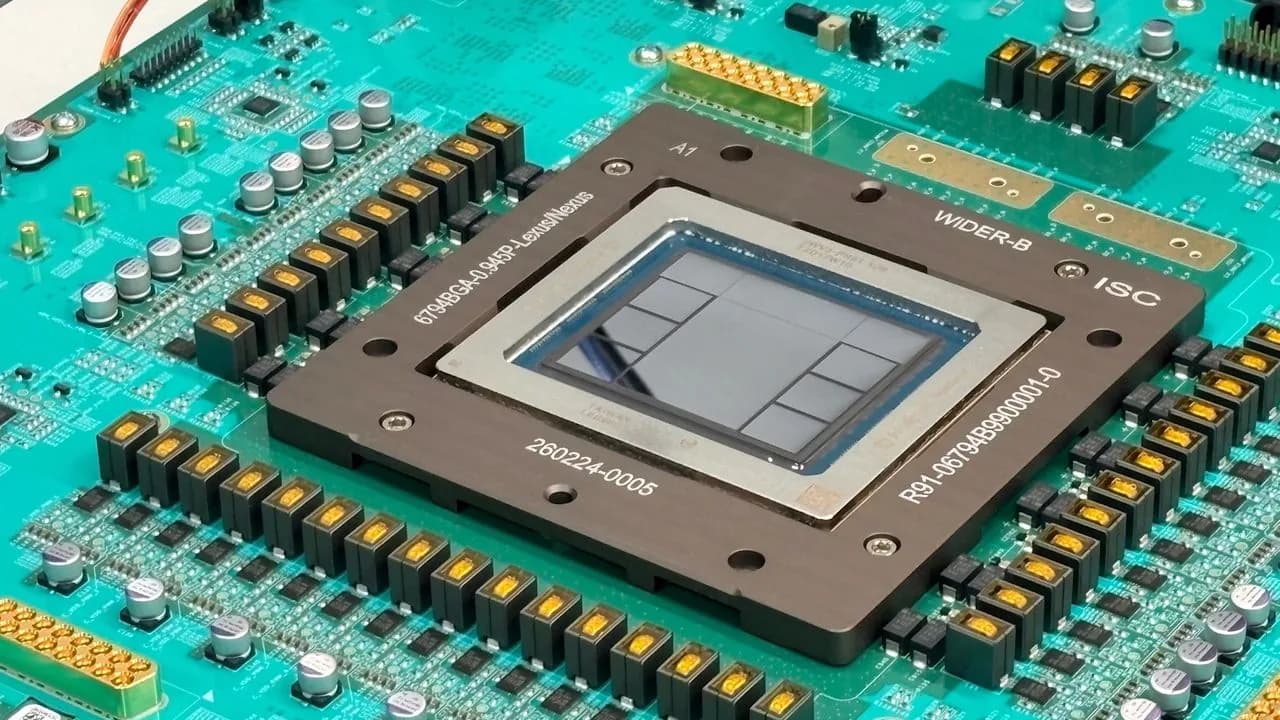
d-Matrix adopta NVLink Fusion y armará racks de 144 Raptor
La startup de inferencia se suma a Qualcomm, Arm, Marvell, Amazon, Fujitsu y MediaTek en licenciar la interconexión de Nvidia, y renuncia a diseñar su propia red de escalado vertical.
6 notas publicadas

El gerente general de OpenAI Korea confirmó trabajo conjunto en chips de próxima generación, lo que apunta a un doble abastecimiento con TSMC y a volúmenes enormes.

La taiwanesa adoptará NVLink Fusion para sus aceleradores de IA a medida, sus sistemas locales y sus plataformas automotrices, mientras Nvidia se asegura un lugar en el mercado de chips que no diseña.

El primer acelerador generativo propio de Meta rinde 12 petaFLOPS en MXFP4 y carga con dos trabajos que casi nunca conviven en el mismo silicio.

El nuevo backend compila el lenguaje de kernels de PyTorch a Pallas y alcanza 838 TFLOPs en atención flash sobre una TPU v7, cerca del 79% de utilización de un tensor core.

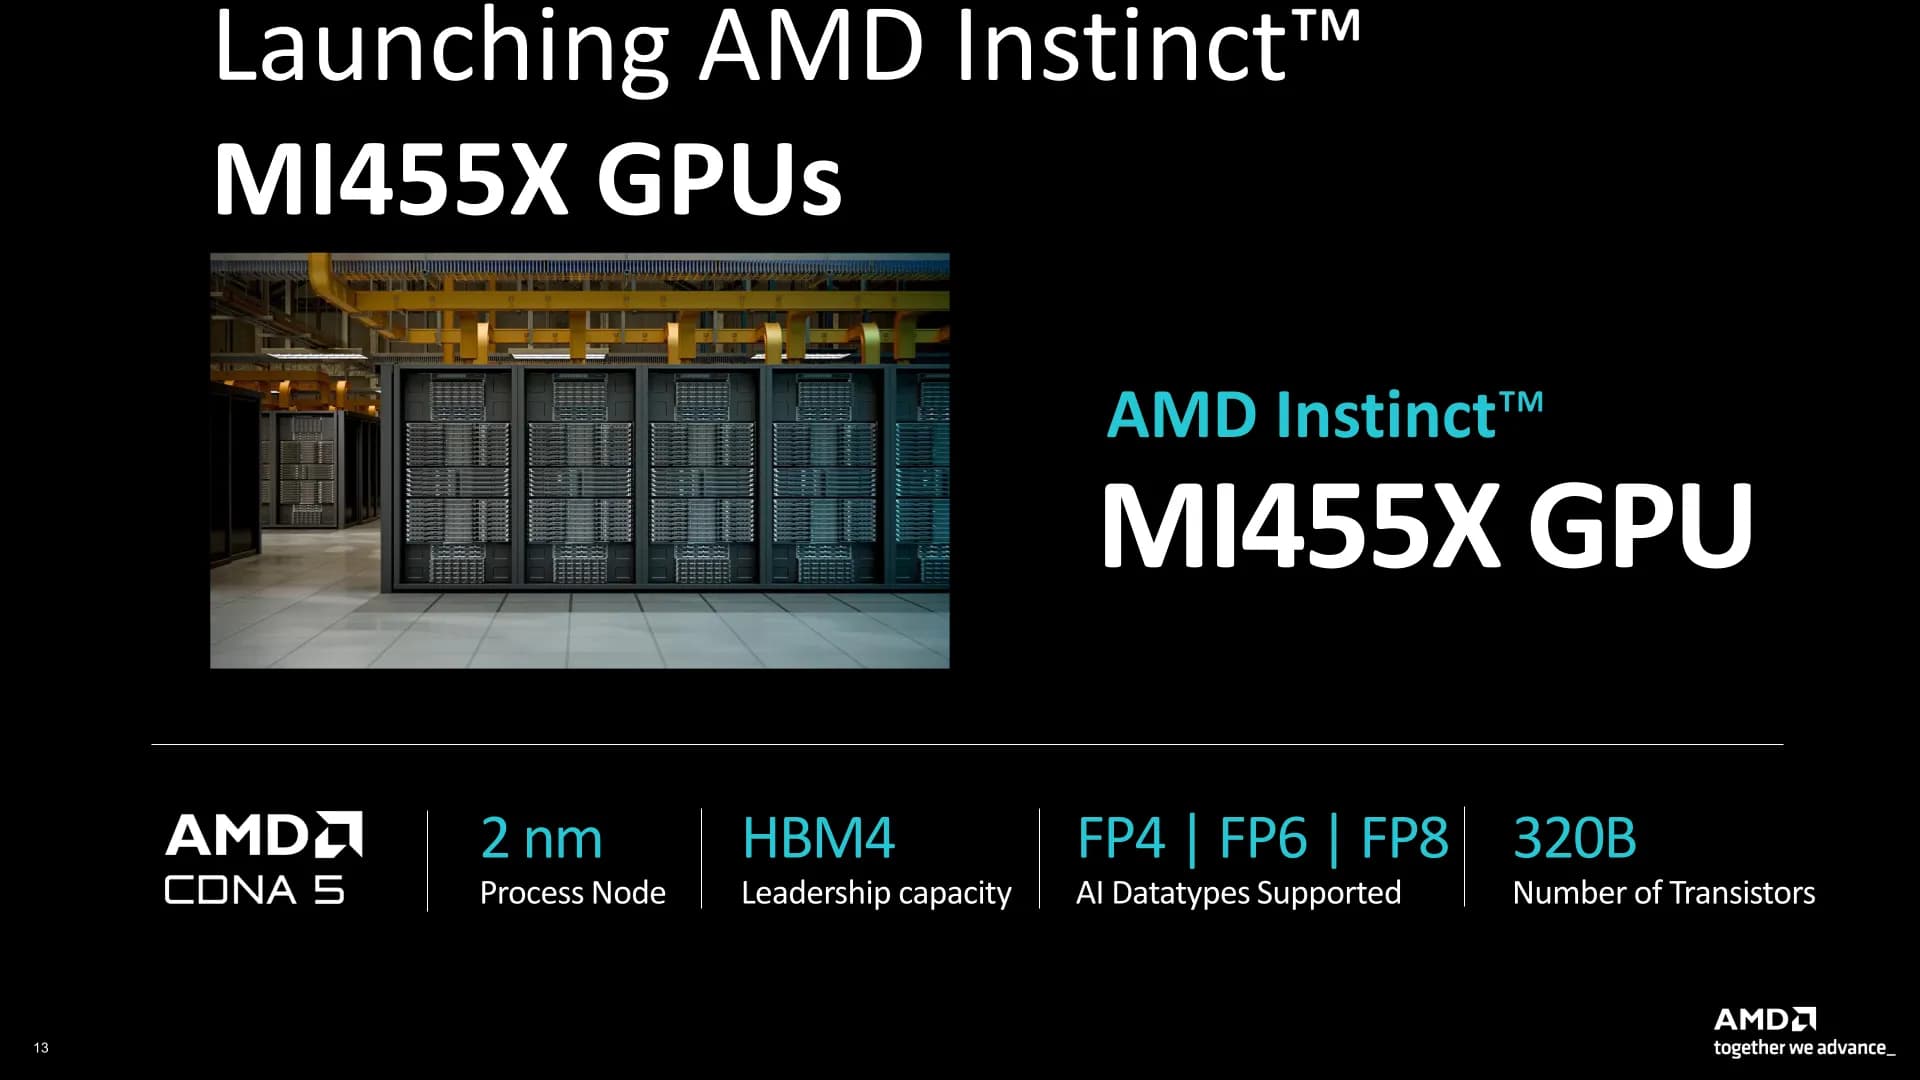
El chip de 2 nanómetros cuadruplica el rendimiento MXFP4 frente al MI355X y llega junto a Helios, el rack de IA de AMD que ya está en plena producción.
Otros temas que aparecen junto a #aceleradores ia en nuestra cobertura editorial.