
IA
Jetson AGX Thor cierra el test agéntico de MLPerf en 24 minutos
TensorRT Edge-LLM corrió Qwen3.6-27B en un solo kit de desarrollo y completó las 1.007 vueltas 6,4 veces más rápido que la referencia de llama.cpp.
NVIDIA Developer
36 notas publicadas
NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
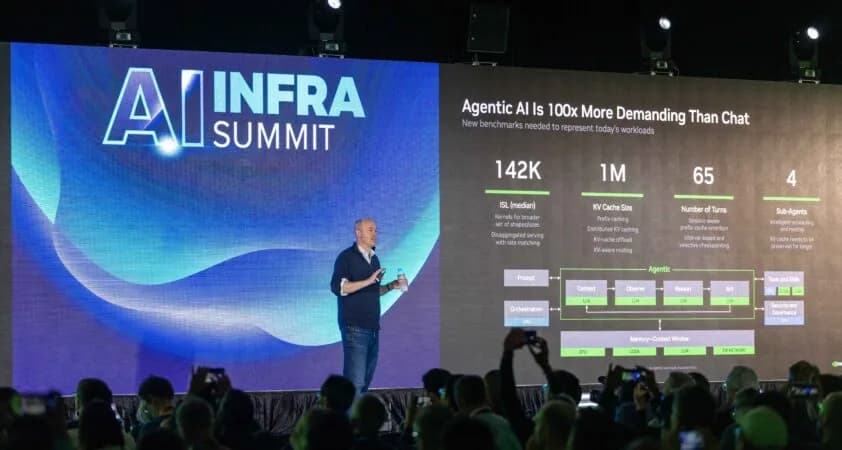
La medición de SemiAnalysis AgentX sobre el modelo DeepSeek V4 Pro compara el NVL72 de Vera Rubin contra el GB300 NVL72, y NVIDIA presentó el resultado en el AI Infra Summit.
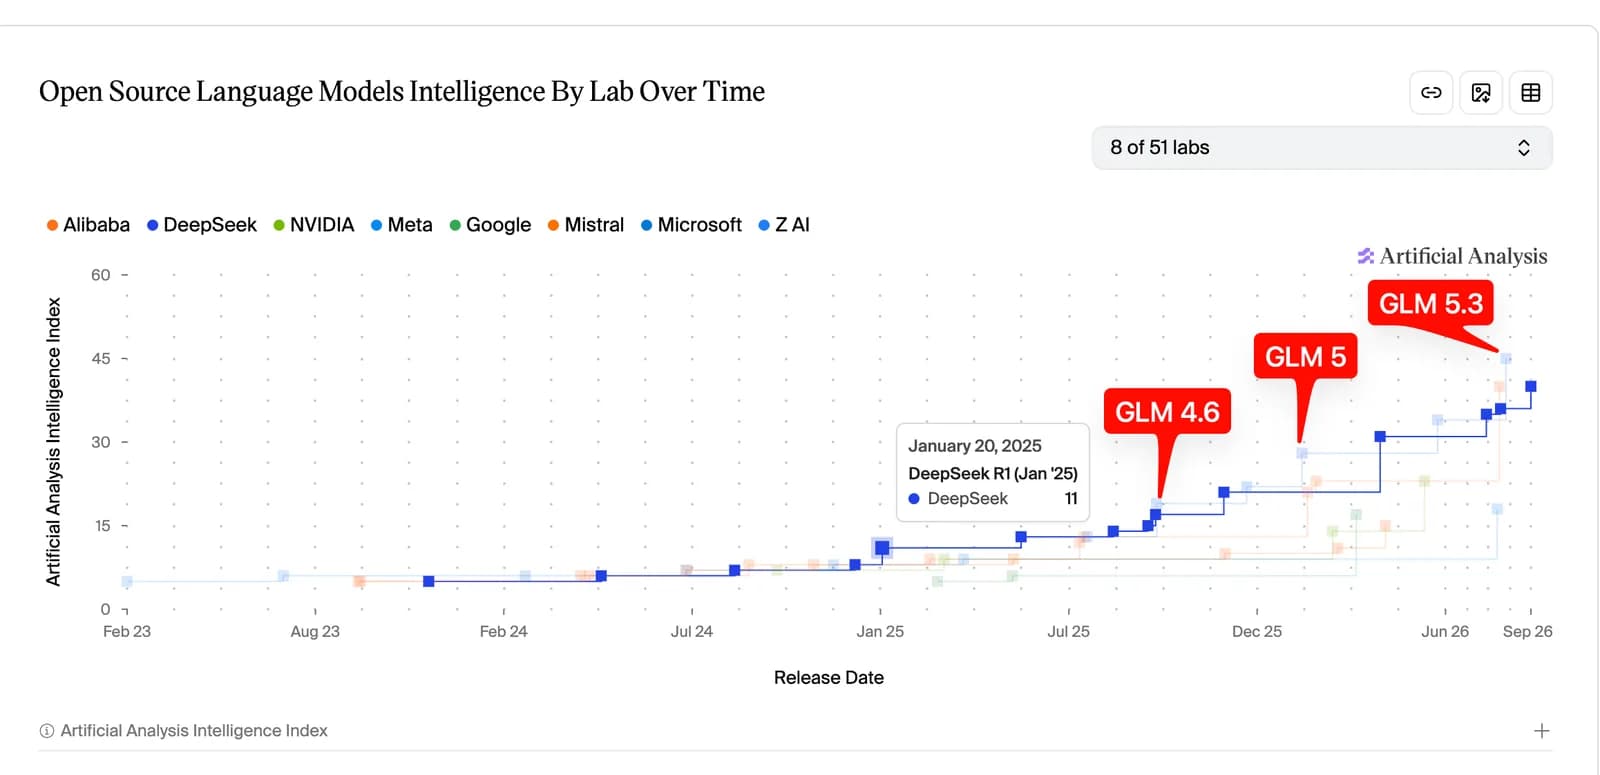
El modelo suma 763.000 millones de parámetros, activa 8.000 millones en la entrada y 16.000 millones en la salida, y con eso baja la caché de claves y valores hasta un octavo de la del V4 Flash.
Los 196.000 millones de parámetros N-gram del modelo se pueden mover a la RAM del sistema, y eso baja de 763 GB a 567 GB la memoria de GPU que pide para arrancar.
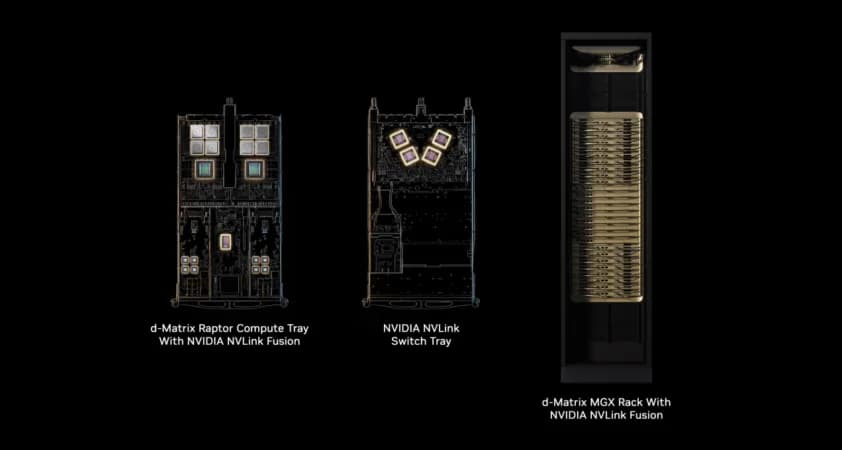
El fabricante de aceleradores de inferencia adopta la arquitectura de rack MGX en vez de construir su propia infraestructura de escala completa.
La startup de inferencia se suma a Qualcomm, Arm, Marvell, Amazon, Fujitsu y MediaTek en licenciar la interconexión de Nvidia, y renuncia a diseñar su propia red de escalado vertical.
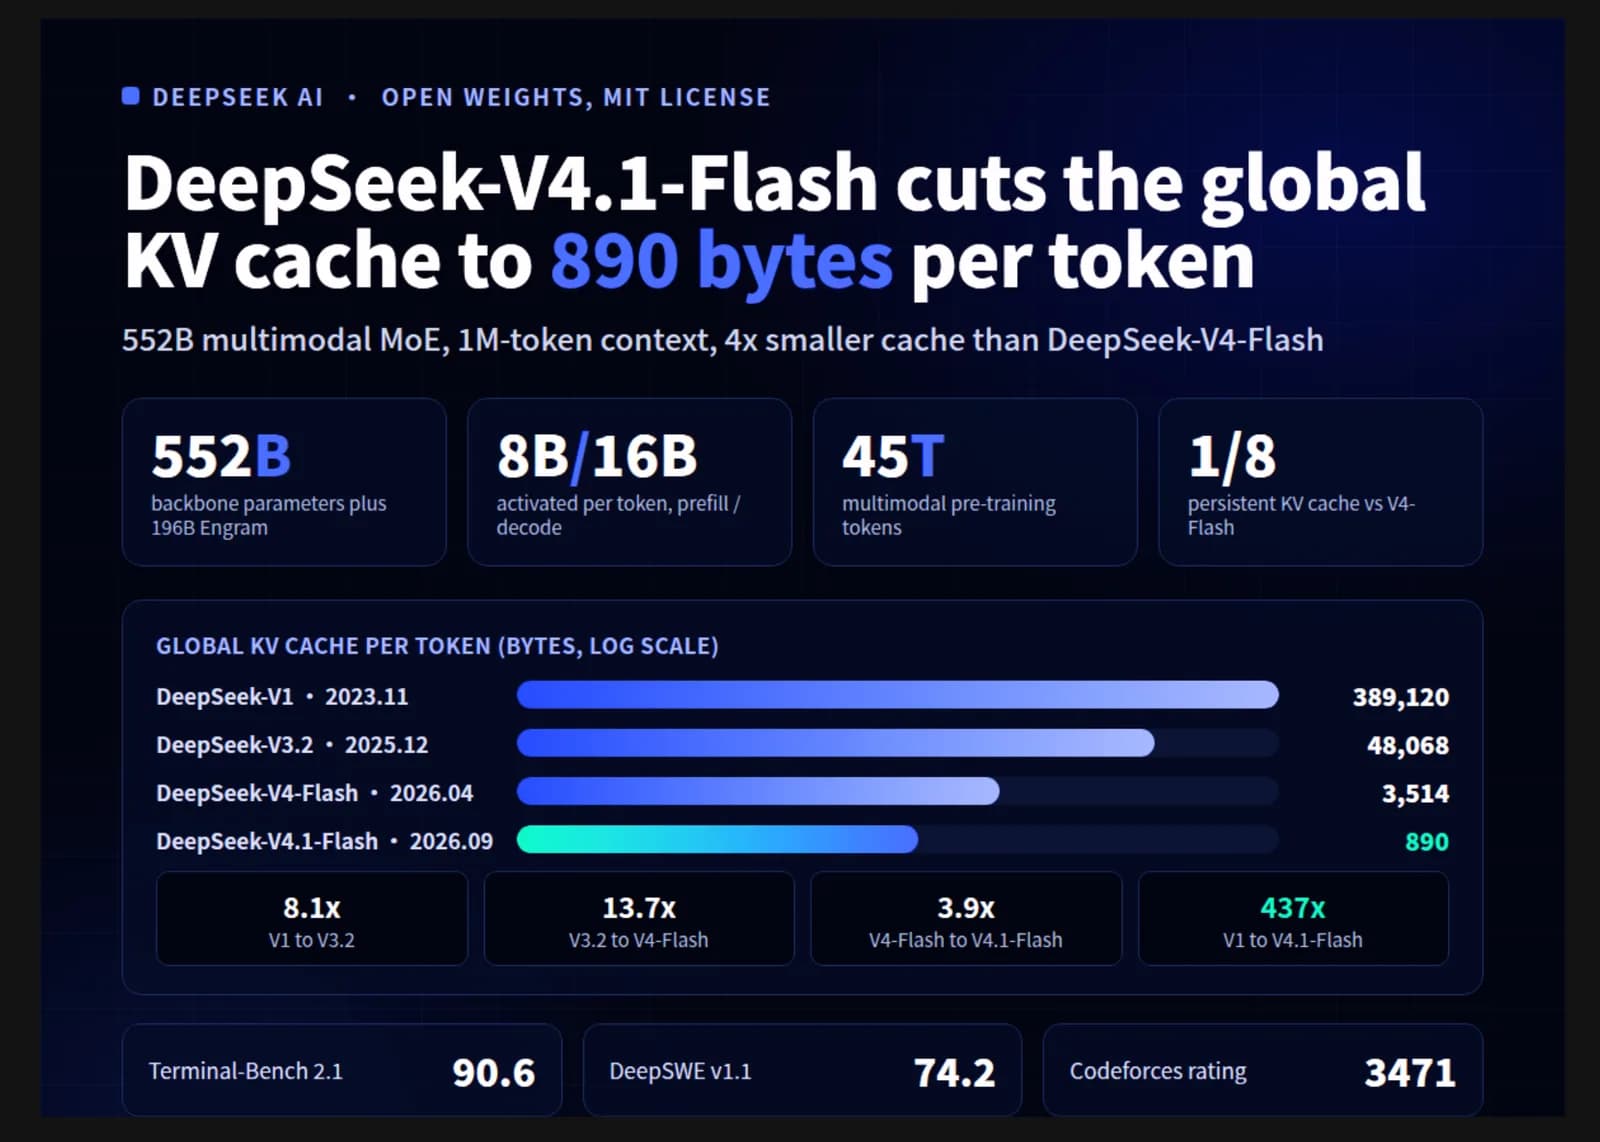
El modelo abre pesos bajo licencia MIT y ataca el cuello de botella real de los agentes largos, que no es la generación sino el costo de guardar millones de tokens en memoria.
La desagregación encode-prefill-decode separa el encoder de visión del resto de la inferencia y rinde en cargas con muchas imágenes, pero se vuelve contraproducente con salidas largas.
El acuerdo cubre silicio personalizado para inferencia y óptica de 1,6 Tbps, aunque ninguna de las dos compañías entregó detalles concretos sobre los chips involucrados.
El centro de datos correría solo inferencia, no entrenamiento, y sería el mayor conjunto conocido de aceleradores Huawei, aunque la entrega completa tomaría más de un año.
NVIDIA publica las reglas prácticas para decidir cuántos tokens adelantar y con qué mecanismo generarlos, sin perder precisión en la inferencia.
La compañía publicó un marco de trabajo que ordena el cálculo alrededor del uso real de la carga, con cuatro escenarios de empresa y sus requisitos de memoria.
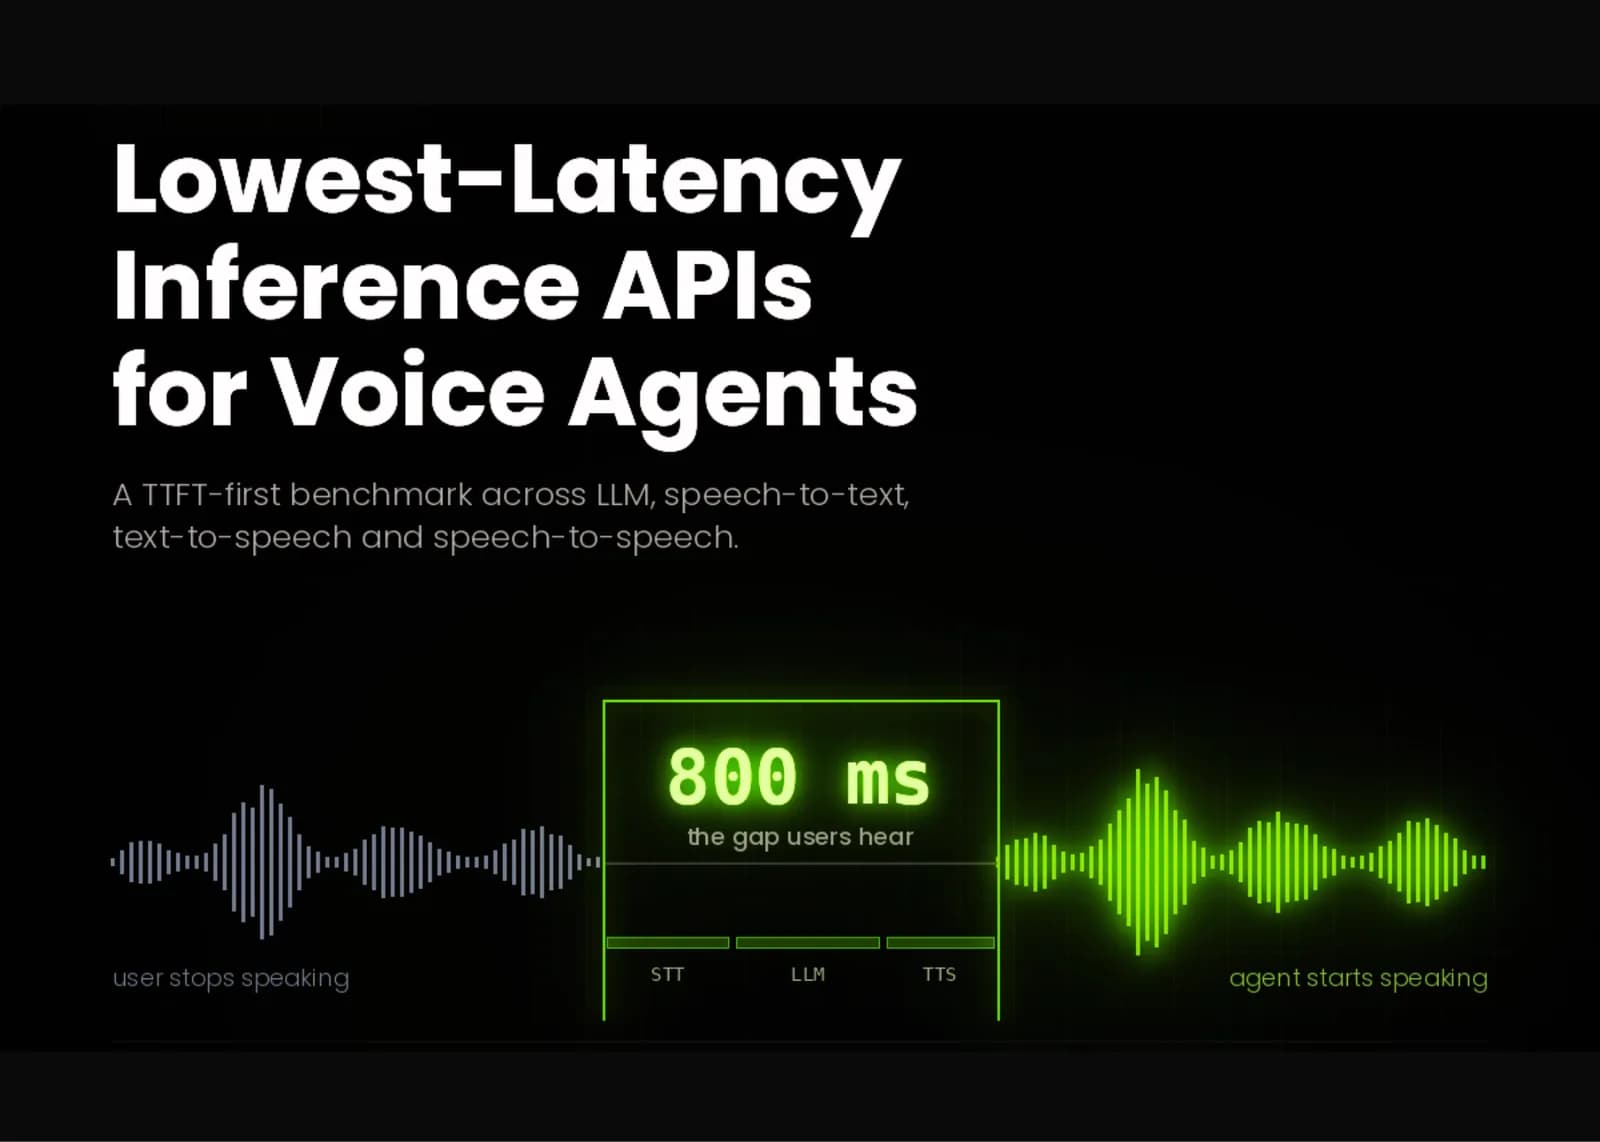
El tiempo hasta el primer token es la métrica con la que los equipos eligen su API de inferencia, y también la que más los confunde: la síntesis no habla hasta recibir una cláusula completa.
OpenAI publicó en Hot Chips 37 los primeros números de su chip de inferencia propio: entre 1,5 y 1,9 veces más trabajo por watt que los sistemas GB200 y GB300 de NVIDIA.
Alibaba liberó los pesos del modelo como anticipo de la arquitectura Qwen4, y NVIDIA publicó su validación sobre el rack GB300 NVL72 con soporte desde el día cero.
OXMIQ Labs mostró en Hot Chips 2026 que la nueva memoria entrega 14 veces más capacidad que la HBM a costo similar, con apenas 0,6 veces su ancho de banda agregado.
Las cifras que ambas compañías mostraron en Hot Chips corresponden a servir una sola petición a la vez, un escenario que ningún operador de inferencia sostiene si quiere ganar dinero.
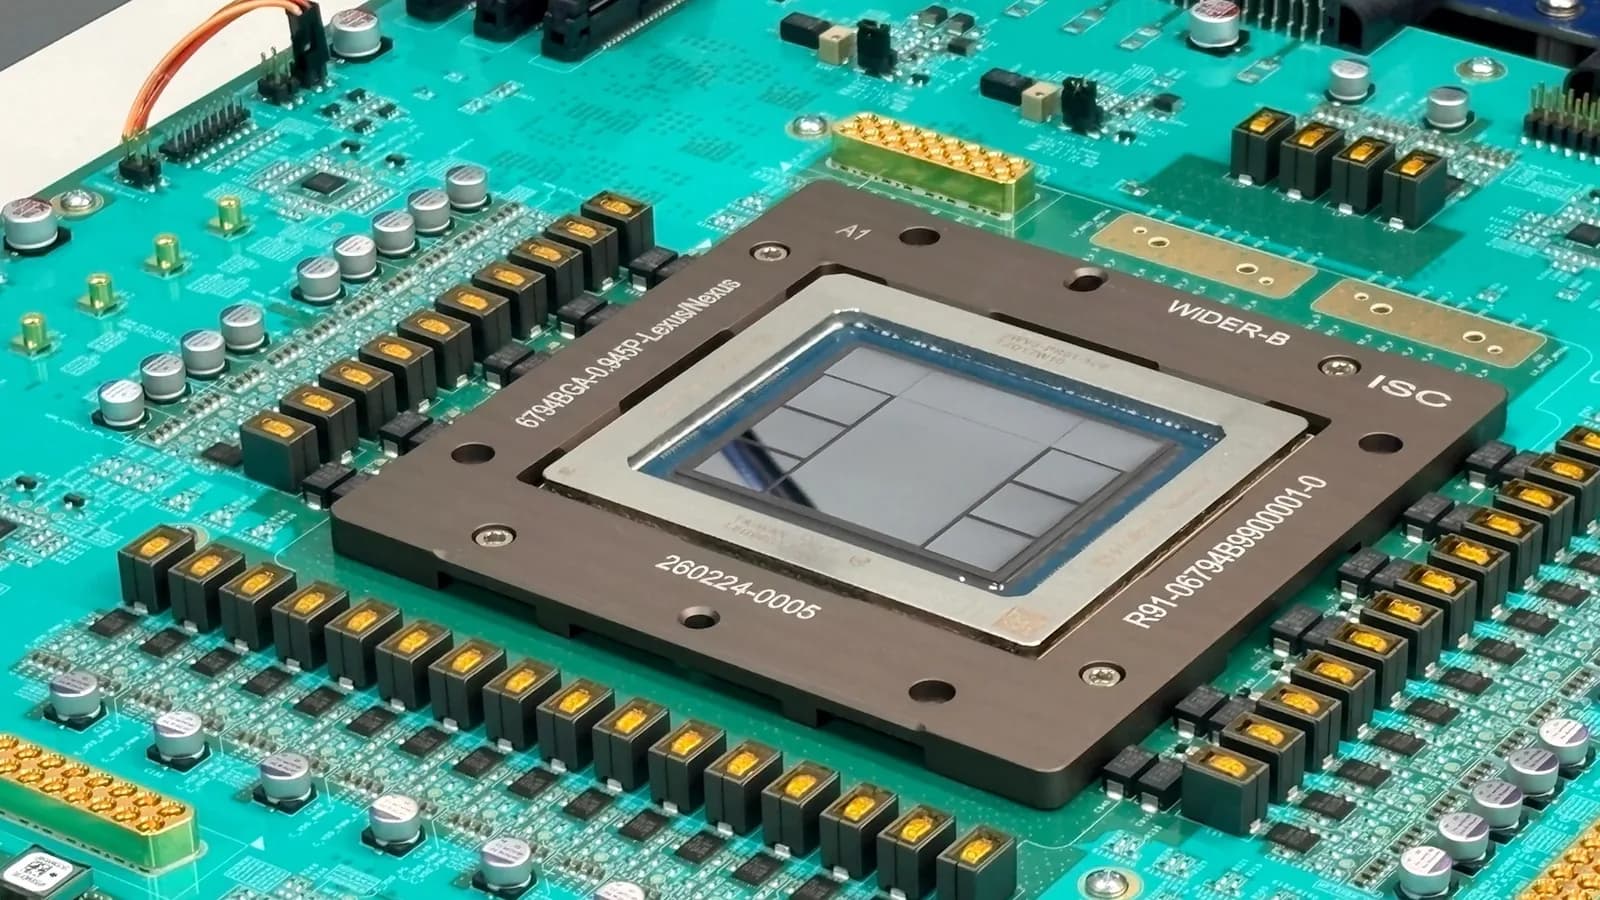
La compañía midió su acelerador de inferencia contra sistemas comerciales en tres modelos de pesos abiertos y reporta hasta 4,1 veces más rendimiento en las cargas más interactivas.
NVIDIA liberó implementaciones de referencia para llevar modelos abiertos desde un identificador de Hugging Face hasta inferencia nativa en C++, sin PyTorch ni Python en producción.
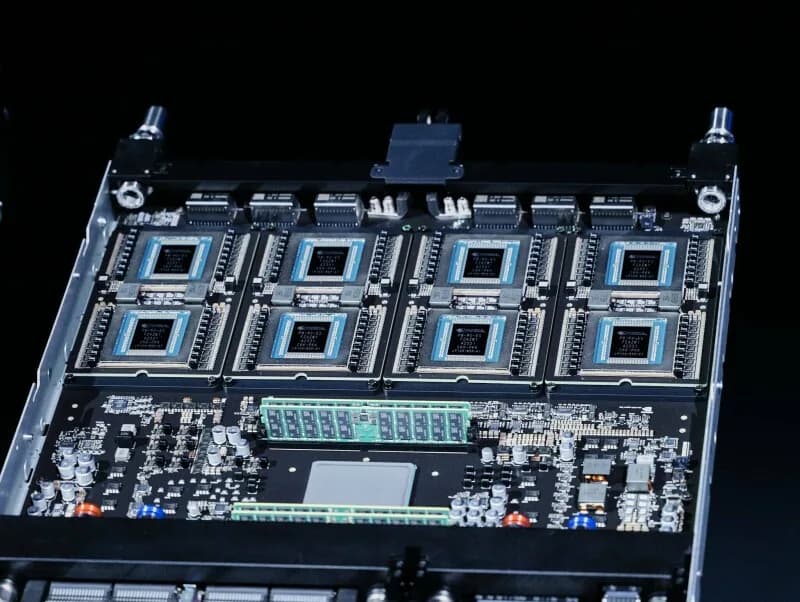
Los primeros números independientes de los racks LPX llegan con una letra chica importante: la prueba corre sobre Gemma 4 31B, el mejor escenario posible para esta arquitectura.
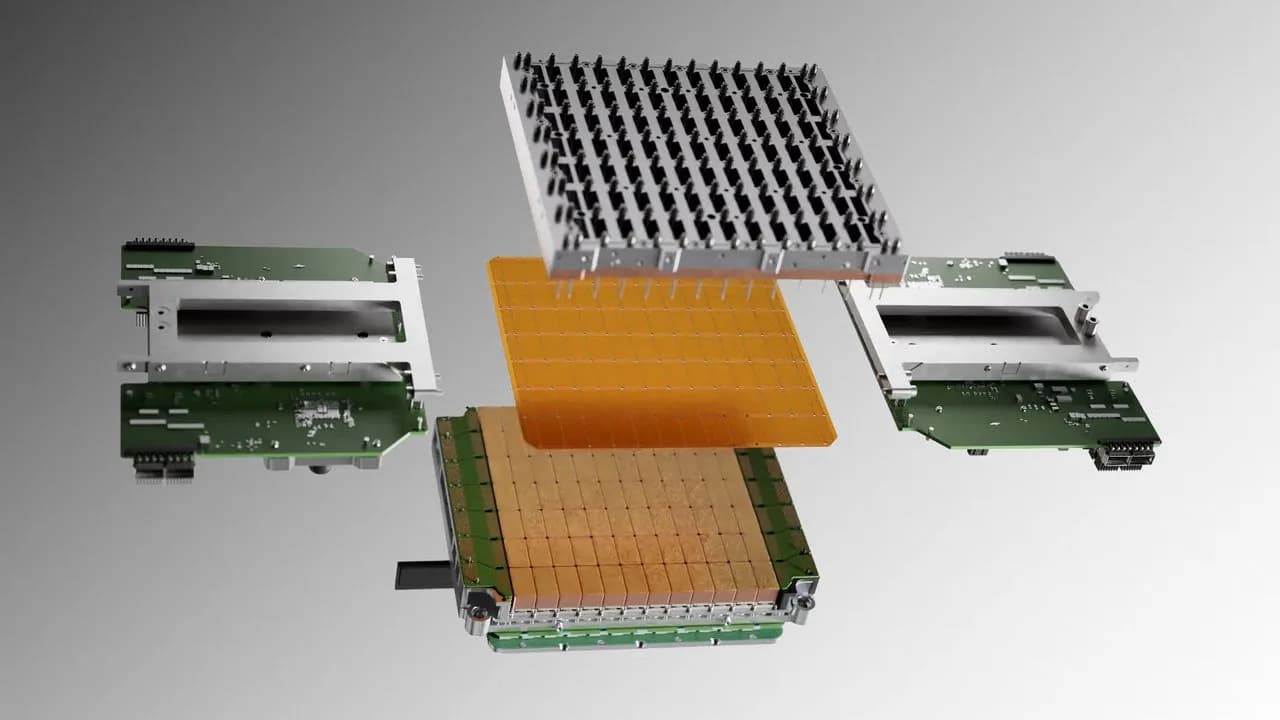
En Hot Chips 2026 la compañía mostró el rack Nexus del CS-4, que duplica la potencia entregada a cada oblea, y adelantó dos generaciones completas de su hoja de ruta.
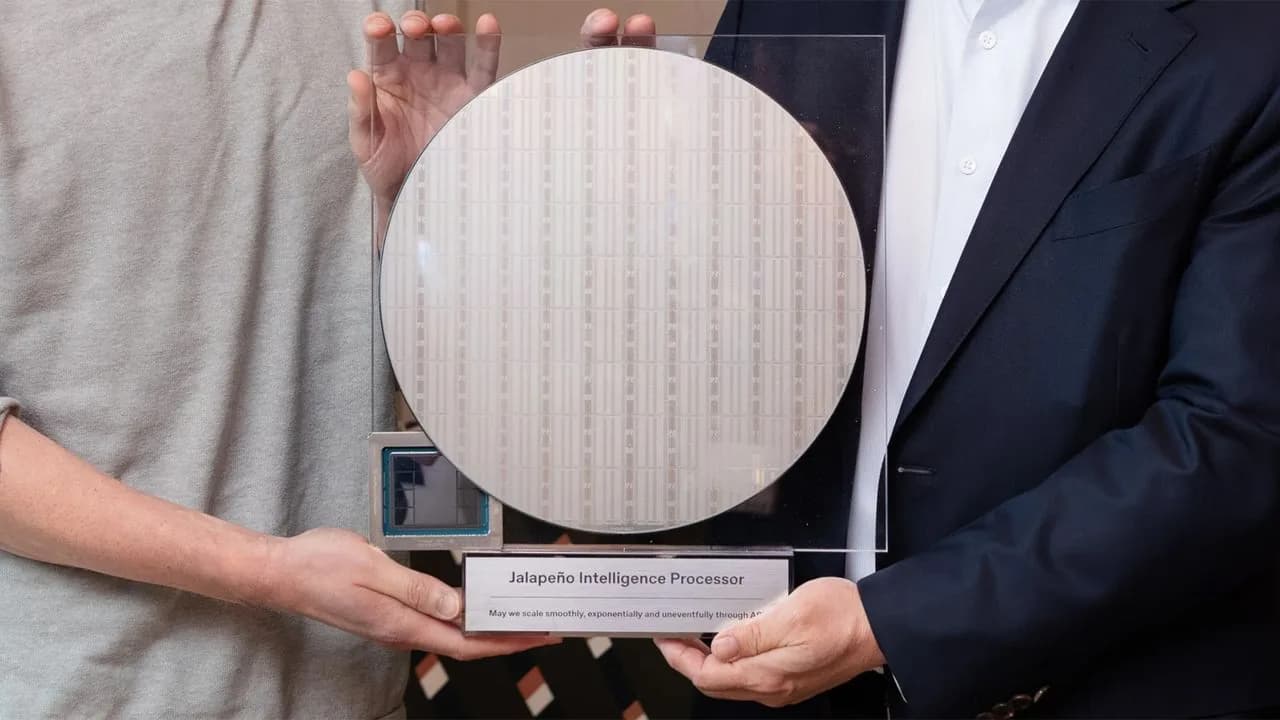
OpenAI detalló en Hot Chips la arquitectura NUMA de su acelerador de inferencia: 216 GB de HBM4, dos redes internas separadas y más de la mitad del núcleo escrita con ayuda de sus propios modelos.
Nvidia midió sus nuevos sistemas contra el GB300 NVL72 usando trayectorias reales de sesiones de programación con agentes, aunque los resultados todavía esperan revisión de SemiAnalysis.
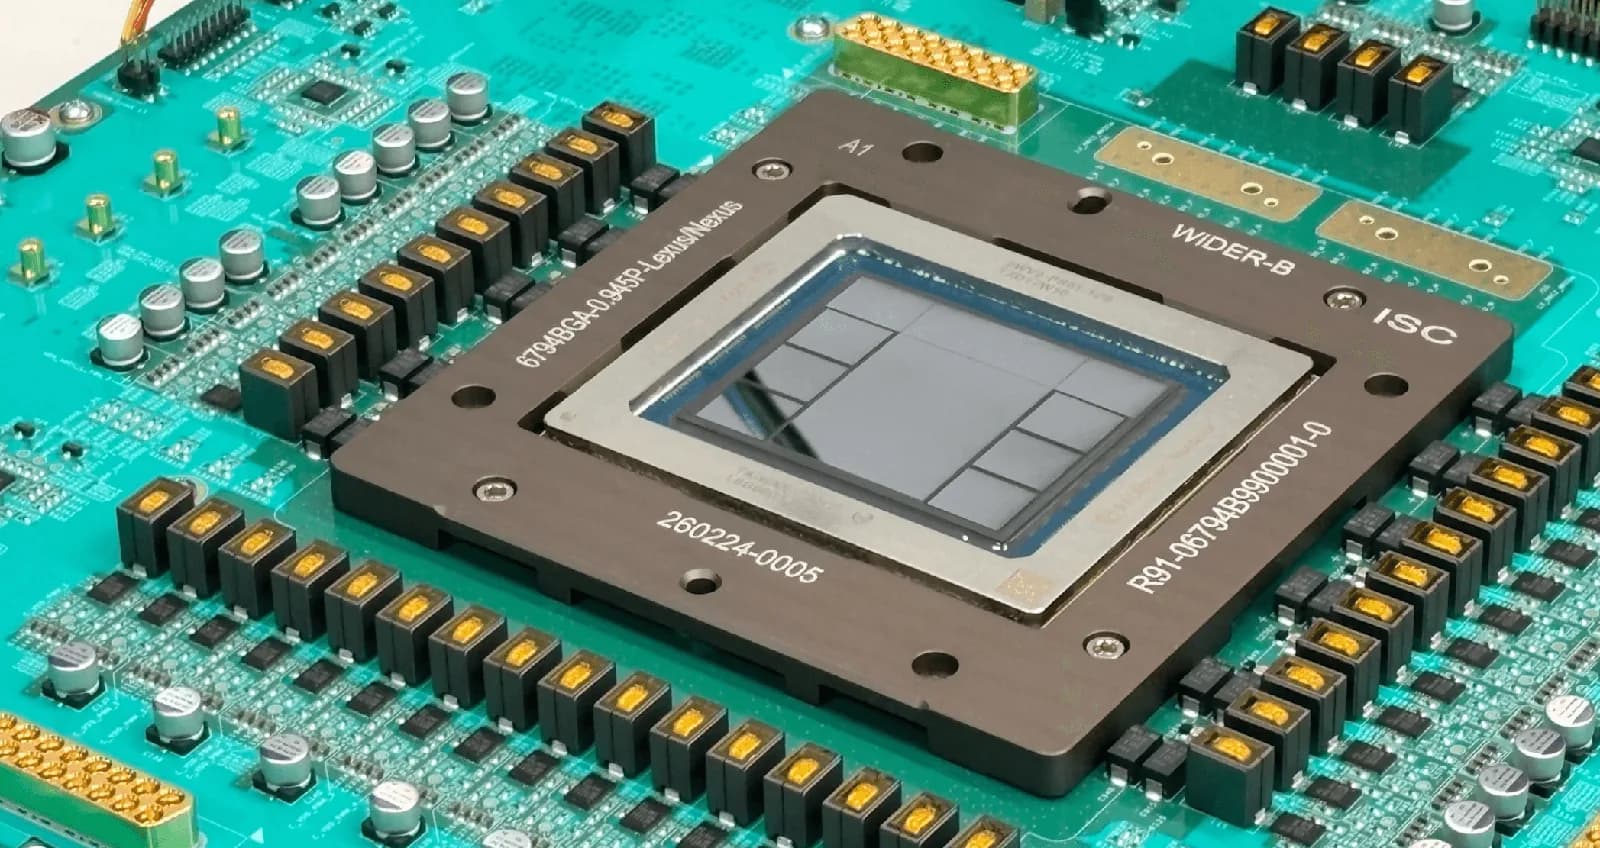
El primer acelerador propio de OpenAI, hecho con Broadcom, se llevó los mejores números de rendimiento por watt en el banco de pruebas InferenceX, aunque no pasa de muestras de ingeniería.
Nvidia presentó en Hot Chips 2026 la arquitectura del rack que heredó de Groq y publicó su primer benchmark de terceros, medido por Artificial Analysis sobre Gemma 4 31B.
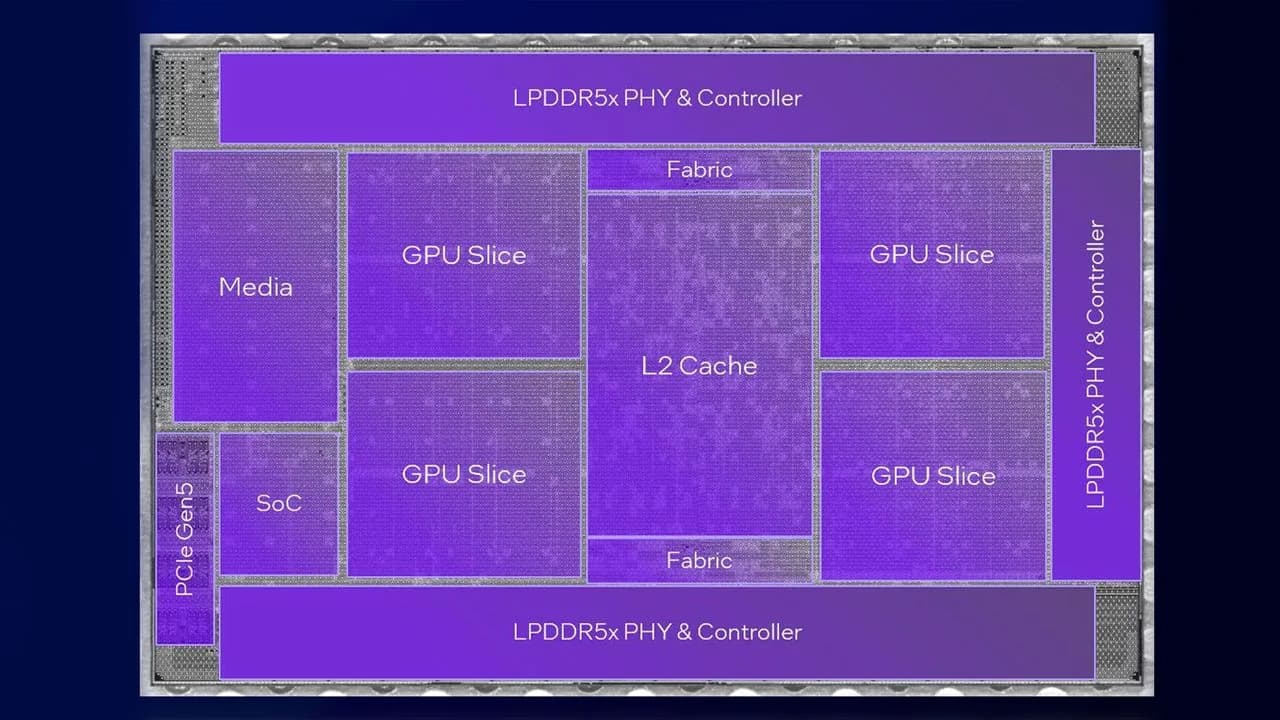
La tarjeta PCIe refrigerada por aire monta hasta 480 GB de LPDDR5X y apuesta por cachés más grandes y motores XMX más profundos en lugar de perseguir el récord de potencia bruta.
Raptor invierte el orden habitual del apilamiento 3D y deja el dado de cómputo arriba, pero la empresa aún no dice quién le fabrica la memoria a medida.
El motor sombra de NVIDIA mantiene una réplica ya inicializada en la misma GPU y comparte los pesos en memoria, con lo que el reinicio en frío de 283 segundos se vuelve innecesario.
La primera memoria de bajo consumo con lógica integrada multiplica por ocho el ancho de banda y rinde 3,01 veces más tokens por segundo en inferencia.
NVIDIA presentó su nuevo computador de entrada para IA de borde, que duplica el rendimiento del Orin Nano Super y consume 40% menos en modo de 15 watts.
OpenAI mostró en Hot Chips su acelerador desarrollado con Broadcom, pensado solo para inferencia, con producción en volumen prevista para 2027.

La destilación consciente de cuantización (QAD) permite llevar los pesos a 4 bits y triplicar el rendimiento sin perder la precisión del modelo original en BF16.
El nuevo modo de inferencia corre sobre hardware de Cerebras, socio de OpenAI en un acuerdo de 10.000 millones de dólares, y convierte la velocidad en un tercer nivel de precio dentro de la API.
La nueva GPU de la plataforma Vera Rubin apunta a las cargas de IA agentica con 336 mil millones de transistores, 288 GB de HBM4 y 50 petaflops en formato NVFP4.
El chip, atribuido a Jeff Dean, grabaría el plano de Gemini en el hardware para ser 6 a 10 veces más eficiente que los TPU actuales. Google lo desplegaría desde 2028 para abaratar la inferencia.
Otros temas que aparecen junto a #inferencia en nuestra cobertura editorial.