Tom's Hardware pasó varias semanas probando dos procesadores EPYC "Venice", los primeros con la arquitectura Zen 6 de AMD. El medio publicó el 10 de noviembre sus resultados, que comparan los chips contra la CPU Vera de Nvidia y contra la generación anterior, antes de que Zen 6 llegue al escritorio con Olympic Ridge el próximo año.
El resultado más llamativo viene del modelo tope. Un servidor con dos EPYC 9996 de 256 núcleos suma 1.024 hilos y quedó 93% por delante de un servidor con dos EPYC 9965 de 768 hilos en la prueba de rendimiento intrate de SPEC CPU 2026. El EPYC 9686F, optimizado para frecuencia, se destaca en cómputo científico y cargas HPC, y es el competidor de AMD frente a Vera, al menos hasta que llegue la plataforma Verano con LPDDR el próximo año.
AMD sostiene que Venice está una generación por delante de la competencia. Según Tom's Hardware, esa frase no valdría nada si los datos no la respaldaran, y en sus pruebas Granite Rapids-AP de Intel rara vez entra en la conversación. Vera mantiene algunas posiciones competitivas, pero Venice suele ir adelante, a veces por órdenes de magnitud. Diamond Rapids de Intel, que se lanza el próximo año, debería equilibrar algo la balanza, aunque AMD planea subir más la vara en algunas cargas con Venice-X y Verano.
La evaluación del medio incluye más de 100 pruebas, desde rendimiento en Python hasta HPC, además de un análisis completo de la microarquitectura y de las plataformas.
Un núcleo que sube todos los parámetros
Zen 6 se fabrica en el nodo N2P de TSMC y trae cambios importantes de arquitectura. Dentro del núcleo, un motor vectorial rediseñado empuja todavía más el rendimiento SIMD y ahora soporta de forma nativa instrucciones de media precisión FP16, junto a las de 32 bits. También separa los planificadores de enteros del motor de ejecución, lo que deja más instrucciones en vuelo dentro del núcleo.
En el resto del chip también hubo cambios. El único die de entrada y salida (IOD) de las generaciones anteriores ahora se reparte en dos IOD, lo que le da a la plataforma SP7 acceso a 16 canales de memoria. El costo es tener menos líneas PCIe 6.0 que la plataforma SP8.
Los chiplets de cómputo (CCD) también se renovaron, por primera vez desde Zen 3. Un CCD estándar de Zen 6 llega ahora a 12 núcleos y uno Zen 6c a 32. Con Zen 5 y Zen 5c el tope era de 8 y 16 núcleos. En el CCD de Zen 6c, AMD además duplicó la caché L3 compartida por núcleo, lo que en la práctica cuadruplica la L3 frente a Zen 5c, porque el chiplet lleva el doble de núcleos.
Para Tom's Hardware, Zen 6 no es una optimización marginal de Zen 5 ni un rediseño completo. Mirado desde lejos, AMD llevó al máximo cada perilla que tenía a mano, y eso se nota en el rendimiento.
¿De dónde sale el 27% más de IPC?
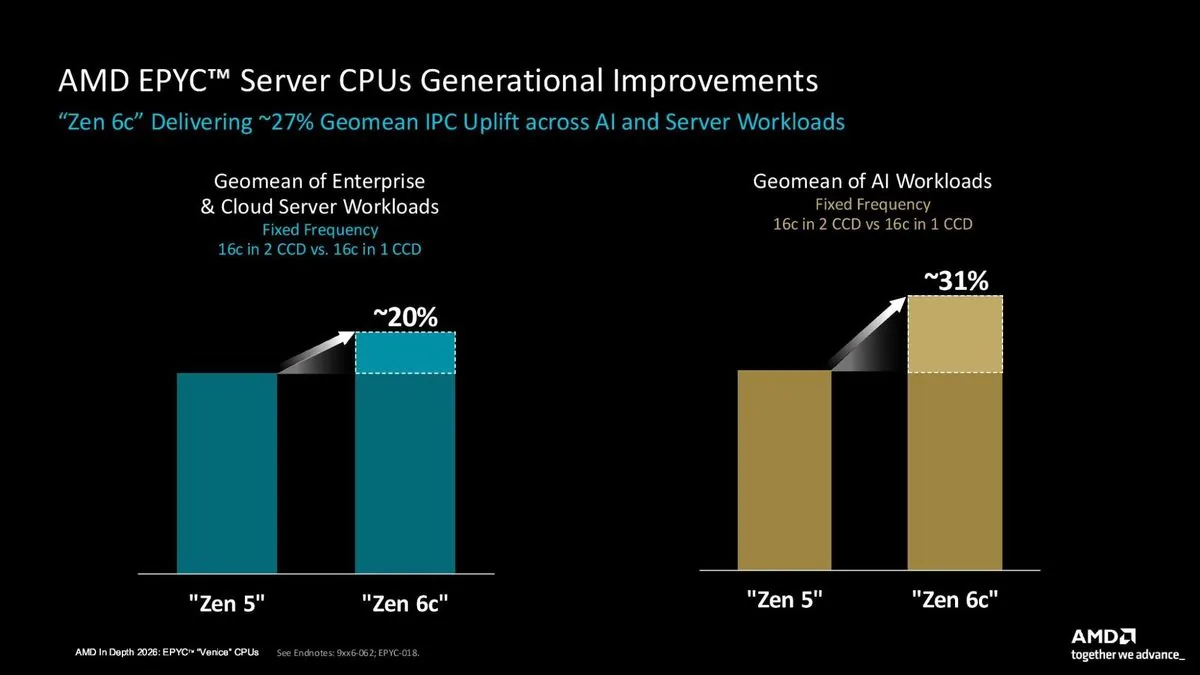
El titular de AMD para Zen 6 es un alza promedio de 27% en instrucciones por ciclo (IPC) sobre Zen 5 en cargas empresariales, de nube e IA. Como la microarquitectura debuta en el centro de datos, Tom's Hardware advierte que esa cifra no se aplica a cualquier carga. AMD llegó a ese número comparando Zen 5 a frecuencia fija contra Zen 6c con 16 núcleos. Un CCD Zen 6c aloja 16 núcleos con espacio de sobra, mientras que 16 núcleos Zen 5 se reparten en dos CCD.
El die de cómputo se fabrica en N2P, una versión ya optimizada de N2 que agrega 5% de rendimiento. Zen 5 usaba N4P, y TSMC compara N2P contra N3E así:
| Nodo TSMC N2P frente a N3E | Mejora |
|---|---|
| Velocidad, a igual potencia | +18% |
| Consumo, a igual velocidad | -36% |
| Densidad | +15% |
Cuando Zen 5 se presentó a mediados de 2024, AMD lo describió como un rediseño desde cero, con un motor de ejecución más ancho capaz de despachar y retirar ocho instrucciones por ciclo, un front end más ancho para alimentarlo, soporte completo de AVX-512 y el doble de ancho de banda entre las cachés L2 y L1. Zen 6 continúa ese rediseño. Conserva muchas de sus características y la misma topología general, con mejoras en varios puntos.
Zen 6 y Zen 6c usan la misma microarquitectura. Zen 6c es un diseño optimizado en espacio que consume menos, funciona a menor reloj y ocupa menos área de silicio que un núcleo Zen 6 completo. Por dentro el núcleo es el mismo, a diferencia de los E-cores de Intel, que usan una microarquitectura distinta a la de los P-cores.
El núcleo por dentro
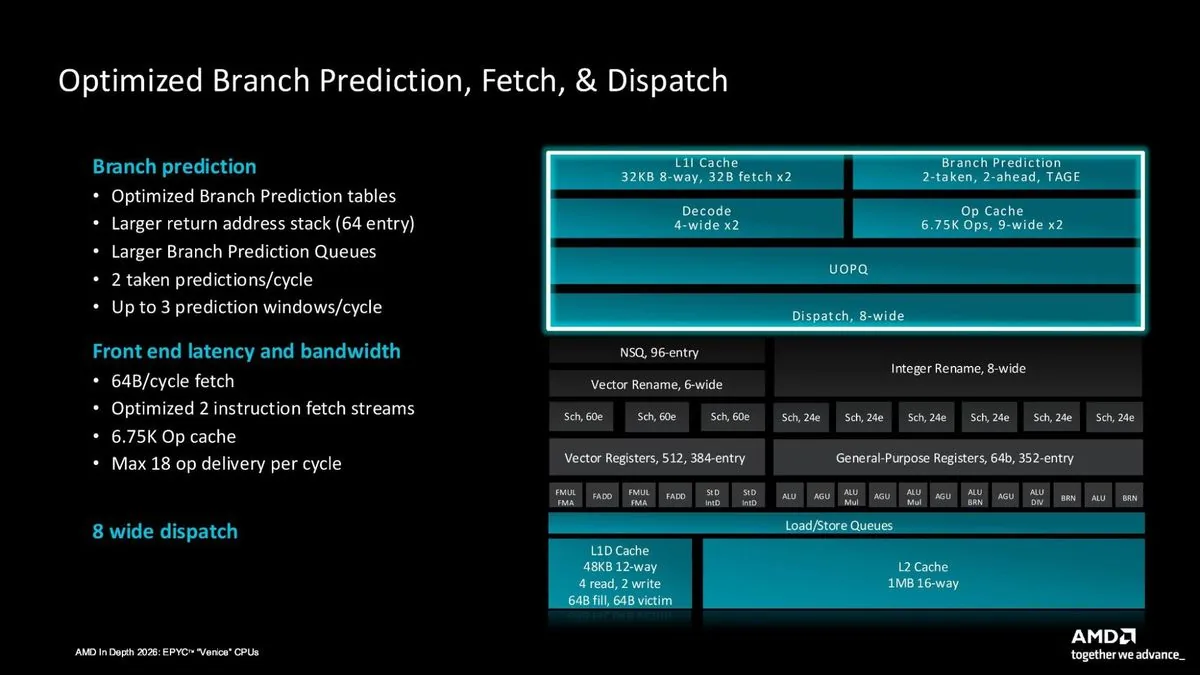
El front end cambia poco frente a Zen 5, salvo algunas mejoras puntuales. Mantiene los dos decodificadores de 4 instrucciones de ancho y el despacho de 8, pero AMD mejoró el predictor de saltos (BPU) y la caché de operaciones:
- La pila de direcciones de retorno del predictor pasa a 64 entradas, desde 52 en Zen 5.
- La caché de operaciones vuelve a 6,75K entradas, desde 6K en Zen 5 (Zen 4 también tenía 6,75K).
- Esa caché entrega hasta 18 microoperaciones por ciclo, contra 12 en Zen 5.
AMD separó los planificadores de enteros, que en Zen 5 eran uno solo unificado. Ahora tienen más capacidad, con 96 entradas compartidas de ALU y AGU y 48 entradas dedicadas de ALU, frente a la división de 88 y 56 de Zen 5. El banco de registros físicos de propósito general crece a 352 entradas, desde 240.
El motor de ejecución vectorial también mejora, después del registro de 512 bits reales que estrenó Zen 5. Zen 6 conserva esa ruta de datos de 512 bits y suma dos cambios. El motor ahora soporta instrucciones AVX-512 FP16 de media precisión, que en Zen 5 había que convertir. Y sube el ancho de banda de carga de punto flotante. Zen 5 admite dos cargas de cualquier tamaño, mientras que Zen 6 admite dos cargas de 512 bits o cuatro de 256 bits. El ancho de banda de almacenamiento no cambia, con un almacenamiento de 512 bits o dos de 256 bits.
Zen 6 mantiene la caché de datos L1 de 48 KB y 12 vías de Zen 5, junto a la L2 privada de 1 MB y 16 vías. La L3 compartida sigue funcionando como caché de víctimas de la L2. AMD sí amplió la ventana de operaciones en vuelo frente a Zen 5, con una cola de cargas de 80 entradas y una cola de almacenamiento de 128 entradas.
Chiplets más densos
Quizás el mayor cambio de Zen 5 a Zen 6 está en la densidad del CCD. Zen 6 ofrece hasta 12 núcleos por chiplet, desde 8 en Zen 5, y Zen 6c llega a 32, el doble que Zen 5c. En lo demás, los CCD nuevos igualan o mejoran a los de Zen 5 y 5c.
| Chiplet | Núcleos por CCD | L3 por núcleo | Reloj máximo |
|---|---|---|---|
| Zen 5 | 8 | 4 MB | 5 GHz |
| Zen 6 | 12 | 4 MB | 5,3 GHz |
| Zen 5c | 16 | 2 MB | 3,7 GHz |
| Zen 6c | 32 | 4 MB | 4,1 GHz |
En Zen 6, AMD mantuvo los 4 MB de L3 por núcleo, lo que sube el total a 48 MB por chiplet para acomodar el nuevo límite de 12 núcleos. El reloj máximo de un CCD Zen 6 estándar sube de 5 GHz a 5,3 GHz. Tom's Hardware aclara que esos relojes son los de Venice y espera topes de boost más altos en los Olympic Ridge de consumo.
Zen 6c trae más novedades. Al duplicar la L3 por núcleo y también la cantidad de núcleos, el CCD Zen 6c suma 128 MB de L3, cuatro veces lo de un CCD Zen 5c.
Para ambos, AMD promete un "gran aumento de IPC por núcleo", además de mejor eficiencia energética y de SMT.
Plataformas SP7 y SP8
En Venice, AMD puede montar hasta ocho CCD por chip. Eso da 256 núcleos en total con Zen 6c y 96 con Zen 6 estándar en las plataformas SP7, que forman la oferta inicial. AMD deja atrás el zócalo SP5 de Genoa y Turin. El SP7 es algo más grande, de 76 por 80 mm, contra unos 72 por 75 mm del SP5.
La topología del chip se mantiene casi igual que en Turin, salvo por los dos IOD que caracterizan a Venice. Los dos dies de entrada y salida van al centro del chip, rodeados de CCD Zen 6. El segundo IOD es el que le da a SP7 sus 16 canales de memoria por zócalo, 8 por cada IOD.
| Plataforma | SP7 | SP8 |
|---|---|---|
| Tamaño del zócalo | 76 × 80 mm | 62,5 × 80 mm |
| Canales de memoria | 16 | 8 |
| Ancho de banda con MRDIMM | hasta 1,6 TB/s | 819 GB/s |
| Ancho de banda con RDIMM | 1 TB/s | 512 GB/s |
| Líneas PCIe 6.0 en 2P | hasta 128 | 192 |
SP7 soporta MRDIMM de hasta 12.800 MT/s en configuración de un módulo por canal, y RDIMM de hasta 8.000 MT/s. La plataforma admite hasta 8 TB de memoria por zócalo.
El IOD también aloja la raíz de confianza por hardware y las extensiones de cómputo confidencial de AMD, entre ellas cifrado de ejecución, integridad de memoria y E/S confiable. Lo nuevo es PCIe 6.0, a velocidades de hasta 64 Gbps por línea. Un SP7 de un zócalo tiene 96 líneas PCIe 6.0 y uno de dos zócalos llega a 128. Cada configuración agrega líneas PCIe 4.0 "de regalo", 8 en un zócalo y 16 en dos.
Dos interfaces SerDes de 64G llevan las líneas PCIe al IOD, y una de ellas sirve para enlazar los chips en configuración de dos zócalos. Esa segunda interfaz puede manejar además 12 líneas PCIe 6.0 opcionales, de ahí el "hasta 128" en dos zócalos. Las líneas de regalo pasan por una interfaz SerDes de 16G más chica.
Las plataformas con zócalo SP8 cambian canales de memoria por líneas PCIe. Tienen la mitad de canales, con el mismo soporte de MRDIMM a 12.800 MT/s, y por eso el ancho de banda cae a la mitad. A cambio, cada IOD entrega 64 líneas PCIe 6.0, para un total de 128 por zócalo, más las 8 líneas PCIe 4.0 adicionales. Igual que en SP7, parte de esas líneas se comparte en dos zócalos, así que un servidor SP8 de dos zócalos queda con 192 líneas PCIe 6.0 y 16 líneas PCIe 4.0 extra. Las dos plataformas soportan CXL 3.1.
AMD también entregó el detalle de la próxima gama Verano, que usa la microarquitectura Zen 6 sobre una plataforma con LPDDR5X y módulos SOCAMM2 reemplazables.
Funciones para administrar el servidor
AMD sumó a Venice algunas funciones pensadas para facilitar la administración una vez desplegados los equipos. Tom's Hardware menciona tres, UPP, UBPS y FAST. La primera, UPP (Unified Power Provisioning), es una función de gestión de energía que considera la potencia total de la plataforma y la reparte entre los distintos componentes según lo que pida la carga.
Las demás secciones del análisis de Tom's Hardware incluyen el soporte preliminar de MEXT, con el que AMD dice lograr 95% del rendimiento con la mitad de la capacidad de DRAM, la configuración de prueba y las mediciones del 9996 y del 9686F en SPEC, Python, memoria, compresión, renderizado, Java, bases de datos, HPC y compilación.