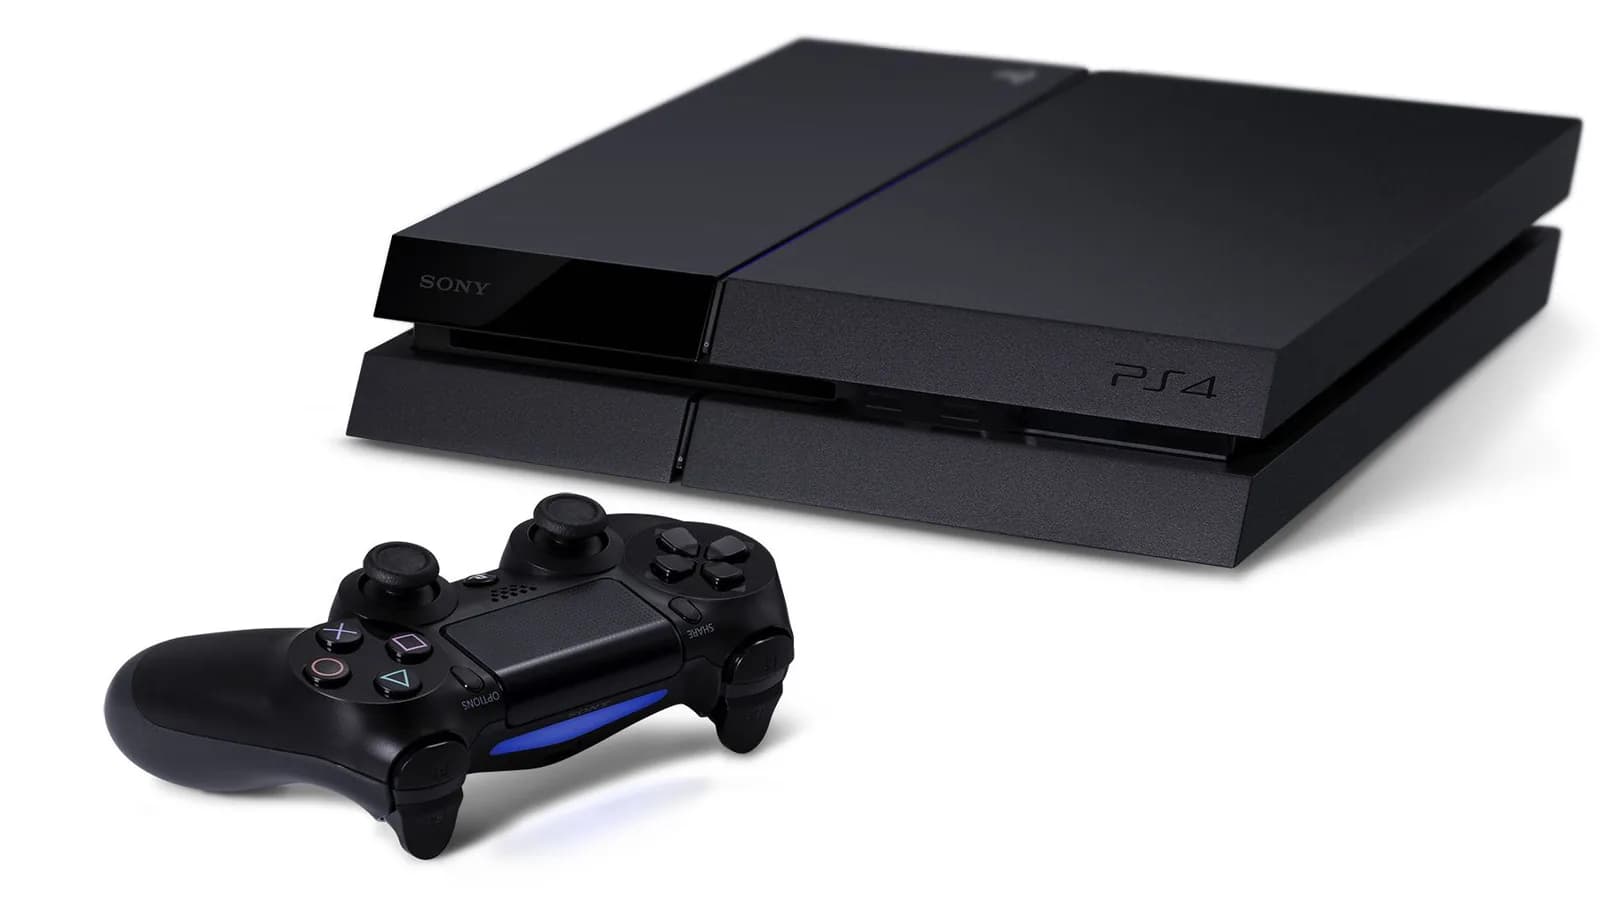
El desarrollador Leonardo Alegría publicó Garlic LLM, un proyecto de código abierto que hace correr el modelo de IA Qwen3.5-9B, de 9.000 millones de parámetros, en una PS4 liberada. Funciona sin conexión, sobre la GPU de 2013 de la consola. La aplicación le habla directo a la GPU y el modelo se comprime a cerca de 4,5 GiB para caber en la memoria, con una velocidad de 31 a 39 tokens por segundo, informó Tom's Hardware el 16 de noviembre de 2026.
El nombre viene del tipo de memoria que la GPU lee directamente, llamada "Garlic" (ajo). Su hermana se llama "Onion" (cebolla).
¿Qué se necesita para instalarlo?
El proyecto exige una PS4 con GoldHEN, un habilitador de software casero para consolas vulneradas. Garlic LLM es gratuito y se descarga como un solo archivo de 5,66 GB desde Hugging Face. Se instala con el Package Installer de la PS4 y pide unos 6 GB libres, o 12 GB si el paquete se copia primero al disco interno. El desarrollador lo probó en una PS4 base y una Slim con el firmware 11.52.
La aplicación conversa por voz. Responde hablando en siete idiomas con el modelo de voz Chatterbox, y en ese modo el chat corre a unos 22 tokens por segundo. Manteniendo apretado un botón del control, también toma dictado con Parakeet TDT 0.6B v3 de Nvidia, un modelo de voz a texto que admite 25 idiomas europeos. Los modelos Parakeet son los mismos que usan aplicaciones locales de transcripción como Meetily y Hex.
El modelo principal es Qwen3.5-9B, de Alibaba, un modelo pequeño de pesos abiertos. A los 31 a 39 tokens por segundo que declara el proyecto en chat de texto es usable en la consola, aunque no se informa con qué instrucción ni con qué método se midió.
¿En qué se diferencia del port para PS5?
La comparación más cercana es PS5LM, una bifurcación que corre llama.cpp como aplicación nativa en la PS5 y llega a la GPU AMD de la consola mediante PS5_Vulkan, un port del driver RADV. llama.cpp es un programa de código abierto muy usado para correr modelos de lenguaje en local, y RADV es el driver abierto que permite a las GPU AMD ejecutar Vulkan, la API de gráficos y cómputo.
En la PS4 no existe esa capa de drivers para el software casero. Según Tom's Hardware, Garlic LLM no parece usar ni llama.cpp ni un port de Vulkan.
Las operaciones del modelo, como las multiplicaciones de matrices sobre pesos de 4 bits, son kernels de cómputo escritos en OpenCL C y compilados con LLVM para la arquitectura Graphics Core Next (GCN) de AMD. Los pesos viven en la memoria "Garlic". El lado de la CPU, escrito en C plano, se encarga del tokenizador, la interfaz, el dibujo del texto y el audio.
El flujo va de la instrucción al tokenizador en la CPU. Luego, por cada token, se arma un búfer de comandos PM4 (los comandos de bajo nivel que normalmente genera un driver gráfico y que aquí construye la propia aplicación) y se ejecutan los kernels GCN, antes de mostrar o pronunciar el token. Todo se compila con OpenOrbis, la cadena de herramientas abierta para PS4.
¿Cómo cabe un modelo de 9.000 millones de parámetros en 8 GB?
La PS4 tiene 8 GB de memoria compartida entre CPU y GPU. Con 8 bits por peso, cada parámetro ocupa un byte, así que harían falta al menos 9 GB y en la práctica más.
Parte de la respuesta son los pesos de 4 bits (Q4), que ocupan la mitad. Para las dos matrices más grandes de cada capa se usan pesos de 3 bits (Q3), que con sus escalas quedan en unos 3,5 bits. La combinación deja el modelo en cerca de 4,5 GiB, contra unos 4,9 GiB si todo fuera de 4 bits.
La caché de atención, o caché KV, también va en 4 bits. Eso permite un contexto de 16.000 tokens, frente a los 256.000 nativos del modelo.
| Componente | Tamaño |
|---|---|
| Qwen3.5-9B (Q4 y Q3) | 4,5 GiB |
| Parakeet (dictado) | 0,33 GiB |
| Chatterbox (voz) | 0,29 GiB y 0,09 GiB |
| Total | 5,23 GiB (5,62 GB) |
El total calza con los 5,66 GB del paquete.
¿De dónde sale la velocidad?
Qwen3.5 trae una cabeza de predicción de múltiples tokens (MTP). Garlic LLM la usa para adelantar un borrador de hasta dos tokens, que después verifica el modelo completo. Es para lo que el modelo fue entrenado, y las instrucciones de vLLM en la ficha de Alibaba usan dos tokens especulativos. El proyecto le atribuye a esto la velocidad de chat en hardware de 2013.
Al generar código la cifra sube a 43 tokens por segundo. La temperatura por defecto, que regula la variabilidad del modelo, es 0,7. Alibaba recomienda 0,7 para tareas generales con el razonamiento apagado y 1,0 con el razonamiento encendido, aunque el video de demostración usa 0 para que el resultado sea predecible.
A 35 tokens por segundo, la mitad del rango informado, una respuesta de 300 tokens tarda menos de nueve segundos. Como referencia, la PS5 corrió Qwen3.8-27B, tres veces más grande, a unos 20 tokens por segundo, y los más pequeños Gemma 4 E4B y Llama 3.2 3B a 61 y 124 tokens por segundo.
Compatibilidad
La PS4 Pro "todavía no está probada", y el desarrollador pide a los usuarios que reporten resultados en GitHub. La PS5 no está soportada, porque la aplicación está escrita para la GPU y el software de sistema de la PS4. La aplicación no contiene ningún exploit, pero GoldHEN se instala bajo el propio riesgo del usuario.