Claude Opus 5.5 iguala a Claude Fable 5.1 "en la mayoría de las tareas" y cuesta cerca de 40% menos de operar que Opus 5. Eso sostiene Anthropic, que lo publicó el 22 de septiembre como el primer modelo de una familia nueva. Claude Sonnet 5.5 y Haiku 5.5 llegan en las próximas semanas con mejoras parecidas en rendimiento, eficiencia y seguridad.
Los números que entregó la empresa ubican al nuevo Opus por delante de Fable 5.1 y también de GPT-6 Astra de OpenAI, bastante más caro, en la mayoría de las pruebas.
| Prueba | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% |
| FrontierCode v1.1 | 54,4% | 50,3% | 48,0% | 53,3% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | sin dato |
| GDPval-AA v2.1 | 1.846 | 1.735 | 1.708 | 1.542 |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% |
| Humanity's Last Exam | 67,7% | 65,6% | 63,6% | 57,2% |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% |
| OSWorld 2.0 | 81,8% | 80,7% | 74,0% | sin dato |
| Chartography | 89,0% | 88,4% | 83,4% | sin dato |
Humanity's Last Exam y Chartography se midieron con herramientas, y OSWorld 2.0 de forma parcial.
Anthropic dice que la serie responde sobre todo a lo que le pidieron sus clientes en costo, eficiencia y calidad de la comunicación, en particular en servicios financieros, derecho y desarrollo de software.
¿Cuánto bajó el precio?
Opus 5.5 queda en 4 dólares por millón de tokens de entrada y 20 dólares por millón de tokens de salida. Opus 5 cobraba 5 y 25. Es una rebaja de 20% en el precio del token. La lectura de caché bajó 60%.
| Precio por millón de tokens | Opus 5.5 | Opus 5 |
|---|---|---|
| Lectura de caché | 0,20 dólares | 0,50 dólares |
| Entrada | 4 dólares | 5 dólares |
| Salida | 20 dólares | 25 dólares |
| Escritura de caché | 5 dólares | 6,25 dólares |
El costo total de operación, que junta el precio del token con cuántos tokens se consumen, queda cerca de 40% por debajo del de Opus 5, según la empresa. El modelo usa menos tokens y genera la salida más de 30% más rápido.
Los límites de uso de cinco horas para los suscriptores suben 20%. Con el costo más bajo, Anthropic calcula que esos límites rinden 25% más en total. El usuario además puede guardar un reinicio de límite para cuando lo necesite.
La comparación de precio contra rendimiento la arma la empresa con pruebas de programación. En FrontierCode dice que Opus 5.5 le gana a GPT-6 Astra con cerca de 20% del costo por tarea. En Terminal-Bench 4.0 declara el mismo rendimiento que Astra al 40% del costo. En CursorBench afirma que supera a GPT-5.6 Sol por 11 puntos a un tercio del costo.
La rebaja responde a la presión de OpenAI y sobre todo de los modelos chinos, que rinden menos y cuestan una fracción.
¿Qué promete Anthropic sobre la escritura?
Opus 5.5 también debería comunicarse de forma más natural que los modelos anteriores. Anthropic dice que pone primero la información importante y que sigue las instrucciones de escritura con más apego. También usa menos jerga.
Quienes lo probaron antes del lanzamiento describieron su redacción como más clara y fácil de entender, lo que según la empresa lo vuelve mejor compañero en sesiones de trabajo largas. Los modelos Claude actuales vienen recibiendo críticas por una escritura formulaica y enredada, que en inglés se apoda "Claudish".
Barreras nuevas y ruteo a los modelos viejos
Opus 5.5 es el primer Opus con salvaguardas de ciberseguridad, biología y desarrollo de modelos de frontera al nivel de las de Fable 5.1. Cuando esas salvaguardas se activan, Anthropic dice que la solicitud se deriva de forma transparente a otro modelo.
El usuario todavía puede encontrar y corregir errores en su código, pero la mayoría de las tareas de ciberseguridad se van al Opus 4.8, más antiguo. Las solicitudes que los clasificadores marcan como biología o desarrollo de modelos de frontera se van a Opus 5.
Las organizaciones verificadas pueden postular a usar el modelo para investigación biológica a través del Life Sciences Verification Program. Anthropic planea extender su Cyber Verification Program a Opus 5.5 en las próximas semanas.
El modelo está disponible en todas las plataformas, incluidas Amazon Web Services, Google Cloud y Microsoft Azure. Quienes desarrollan sobre la Claude Platform lo llaman con el identificador claude-opus-5-5.
Estándares de seguridad y distilación
Anthropic planea revisar con más rigor los entornos de aprendizaje por refuerzo. La empresa dice que los entornos de entrenamiento defectuosos son una fuente importante de comportamiento desalineado. También trabaja en mejores recompensas de alineamiento, en formas automáticas de crear escenarios de entrenamiento de seguridad y en más medidas de monitoreo.
Los laboratorios discuten a qué velocidad liberar modelos más capaces. OpenAI pidió hace poco estándares internacionales para sistemas de IA capaces de mejorarse a sí mismos, y varios investigadores llamaron en público a frenar los lanzamientos hasta que los métodos de alineamiento alcancen. Anthropic toma una posición parecida y pide un estándar de seguridad más alto para los modelos que puedan automatizar del todo la investigación en IA. La empresa sostiene que la política pública debería tener un papel mayor en fijar ese estándar. Las organizaciones externas Frontier Design y METR probaron Opus 5.5 antes del lanzamiento.
La empresa suma además medidas contra lo que llama ataques de distilación. Según Anthropic, los atacantes usan miles de cuentas falsas para extraer las capacidades de un modelo a escala industrial y construir modelos muy capaces sin sus salvaguardas. Cita un reporte de amenazas de septiembre de 2026 que documenta la actividad ilegal de distilación que detectó y frenó hasta ahora.
Opus 5.5 sale con "Preserved Thinking", una medida contra la distilación que se estrenó con Fable 5.1. Impide que quienes usan la API editen el contexto previo de Claude para extraer su razonamiento. Aplica a Fable 5.1 y Opus 5.5 en cuentas de API creadas desde el 31 de agosto de 2026.
El modelo trae también marcas de agua para cumplir con la Ley de IA de la Unión Europea. Ya no puede correr con el modo "Thinking" desactivado y está disponible con retención cero de datos.
Qué midió Artificial Analysis
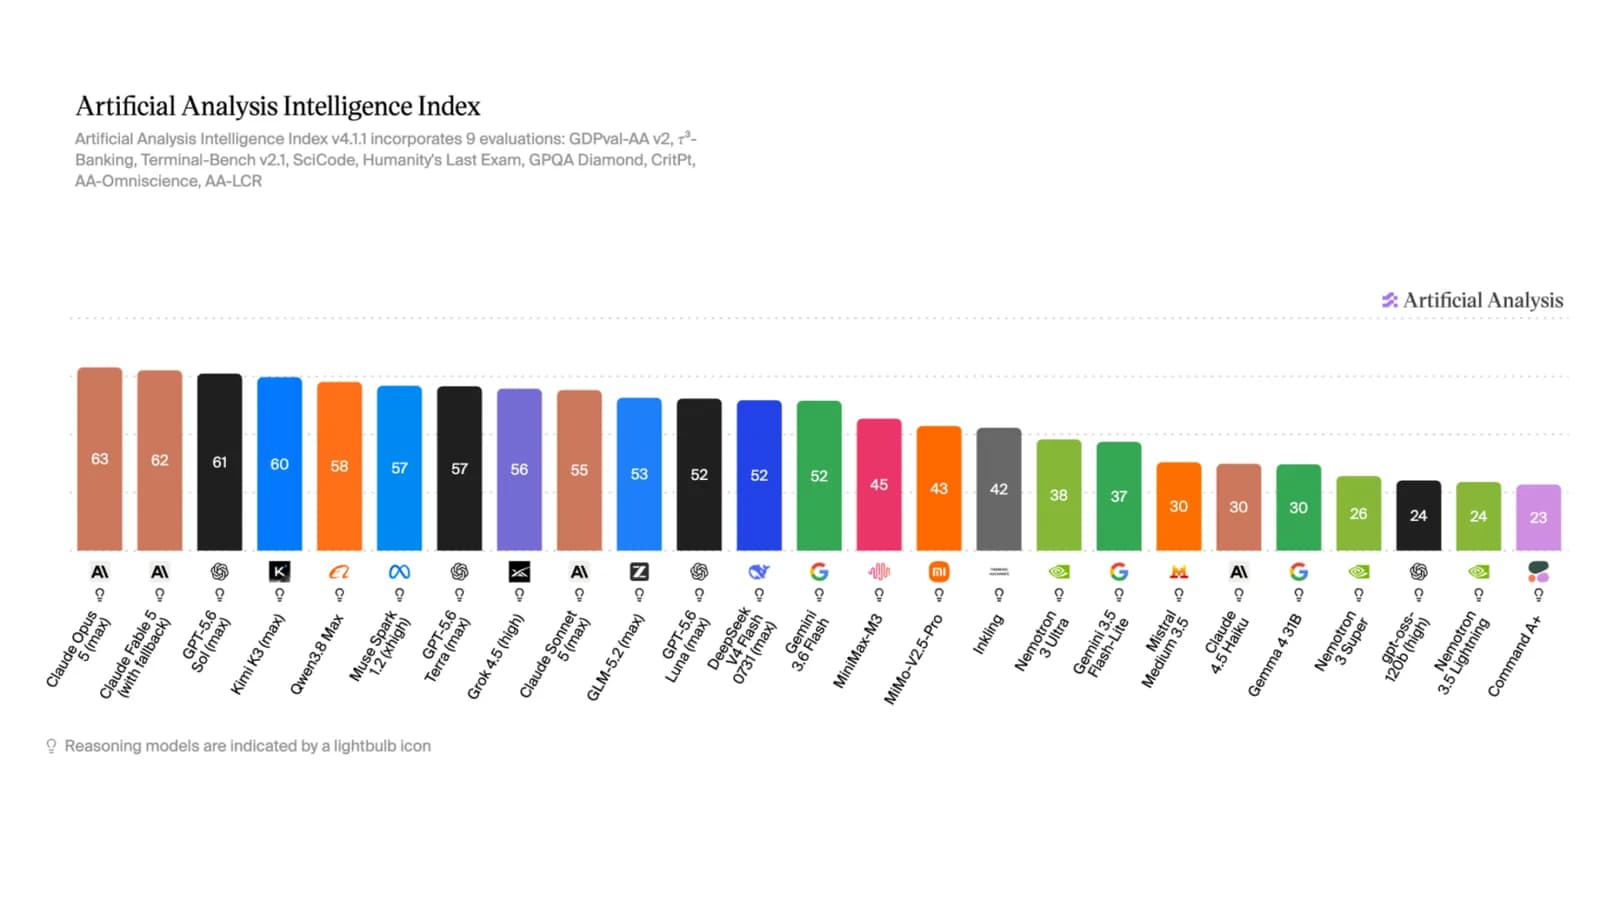
La plataforma independiente Artificial Analysis confirma el resultado. A esfuerzo máximo el modelo anota 58 puntos en su Artificial Analysis Intelligence Index, el más alto que la plataforma ha registrado y varios puntos sobre el líder anterior. Encabeza seis de diez evaluaciones, entre ellas Humanity's Last Exam con 61,4% (el mejor previo era 59,1%, de Fable 5.1) y SciCode con 66,9% (63,1%, también de Fable 5.1). En Terminal-Bench 4.0 llega a 59,6%, empata con GPT-6 Astra y supera a Opus 5 por 11 puntos.
En ese índice, detrás de los 58 puntos de Opus 5.5 quedan Claude Fable 5.1 y GPT-6 Astra con 53 cada uno.
Artificial Analysis señala que Opus 5.5 empareja a Anthropic con GPT-6 Astra en Terminal-Bench 4.0 y en AutomationBench-AA, y que amplía su ventaja en trabajo de conocimiento agéntico. En AA-Briefcase, un benchmark privado, el modelo llega a un Elo de 1.822, 143 puntos más que Fable 5.1. Es la primera vez que un modelo de Anthropic le gana a GPT-5.6 Sol en calidad de presentación. En GDPval-AA, un benchmark de OpenAI sobre trabajo de oficina del mundo real, Opus 5.5 supera a Astra en todos los modos de razonamiento salvo el bajo.
La misma plataforma marca una contrapartida en eficiencia. A esfuerzo máximo, Opus 5.5 consume cerca de 119.000 tokens de salida por tarea, muy por encima de Opus 5 (73.000), de Fable 5.1 (78.000) y de GPT-6 Astra (27.000). Los precios más bajos por token mantienen su costo por tarea a la par de Opus 5, no por debajo. Cuatro de los cinco niveles de esfuerzo de Opus 5.5 caen en la frontera de Pareto, e igualan o superan a todo otro modelo sobre 50 puntos del índice en costo por tarea.