vLLM está cambiando su implementación interna para alcanzar el máximo rendimiento en el hardware de frontera, y ese cambio rompe la compatibilidad con torch.compile en modo fullgraph. La decisión tiene consecuencias para quien usa aceleradores fuera del árbol del proyecto, GPU de generaciones anteriores o modelos poco comunes. Para cubrirlos, el equipo presentó un conjunto nuevo de capas agnósticas del hardware. En GPU NVIDIA H100 esas capas alcanzan un caudal total de tokens que queda a 3,4% de la implementación nativa, medido como media geométrica sobre tres modelos recientes.
vLLM en la frontera
vLLM creció apoyado en una idea. Es la capa de abstracción que sostiene una variedad amplia de modelos sobre una variedad amplia de hardware. Con un conjunto de abstracciones bien diseñadas y torch.compile para optimización y fusión, el proyecto logró mantener relativamente simple el código que define la lógica de cada modelo, lo que en la jerga del proyecto se llama definiciones de modelo, y aun así rendir alto en GPU de NVIDIA, GPU de AMD, XPU de Intel, TPU de Google, IBM Spyre, Huawei Ascend y más.
Las arquitecturas de los modelos de pesos abiertos de frontera, sin embargo, se están separando entre sí a gran velocidad. Eso llevó a la comunidad a revisar si algunas de las abstracciones existentes siguen sirviendo. Los modelos llegan cada vez más con capas hechas a medida y kernels optimizados, y la divergencia alcanza incluso al mecanismo de atención, que es el corazón del modelo. DeepSeek V4 y Kimi K3 consiguen contexto de un millón de tokens por caminos completamente distintos.
Encajar uno de esos modelos en vLLM obliga a componerlo desde las capas compartidas de model_executor/layers y a mantener el modelo entero compilable en fullgraph. Eso significa escribirlo de forma que Dynamo pueda trazarlo, con cada kernel nuevo registrado como una operación de la biblioteca de torch, con su implementación falsa y sus anotaciones de mutación correctas. Ese trabajo es un impuesto sobre el desarrollo del modelo, y lo paga quien agrega el modelo, incluidos los usuarios avanzados que traen el suyo propio.
Al mismo tiempo, las GPU NVIDIA Blackwell y los sistemas a escala de rack como el NVIDIA GB300 NVL72 exigen ingeniería de kernels cuidadosa para aprovechar las funciones nuevas y solapar de forma efectiva el cómputo con la comunicación.
Mientras todo esto ocurre, aparecieron los agentes de programación. Herramientas como Claude Code y OpenAI Codex vuelven mucho más fácil generar código, y son efectivas diseñando optimizaciones para un modelo específico sobre un hardware específico. Rinden mejor cuando no tienen que preocuparse de si un cambio va a empeorar las cosas para otro modelo, sobre otro acelerador.
Esas tendencias confluyen en una conclusión incómoda. Para alcanzar el mejor rendimiento sobre el hardware de GPU más reciente, la comunidad quiere desarmar parte de las abstracciones que vLLM ya tiene. En concreto, el proyecto empezó a mantener definiciones de modelo específicas por hardware, conocidas también como modelos planos. En vez de usar torch.compile, los modelos planos recurren a fusiones propias y a otras optimizaciones específicas del modelo y del hardware. Todos los modelos de frontera agregados a vLLM en los últimos meses usan esa definición plana. El punto crítico es que las capas y operaciones que consumen las definiciones de modelo van a refactorizarse de un modo que las deja fundamentalmente incompatibles con torch.compile.
El esfuerzo es necesario para que vLLM siga compitiendo en los benchmarks de GPU más recientes. También importa que vLLM siga sirviendo a los usuarios que necesitan correr modelos diversos sobre hardware diverso, como GPU antiguas o aceleradores fuera del árbol.
¿Cómo funcionan hoy las definiciones de modelo?
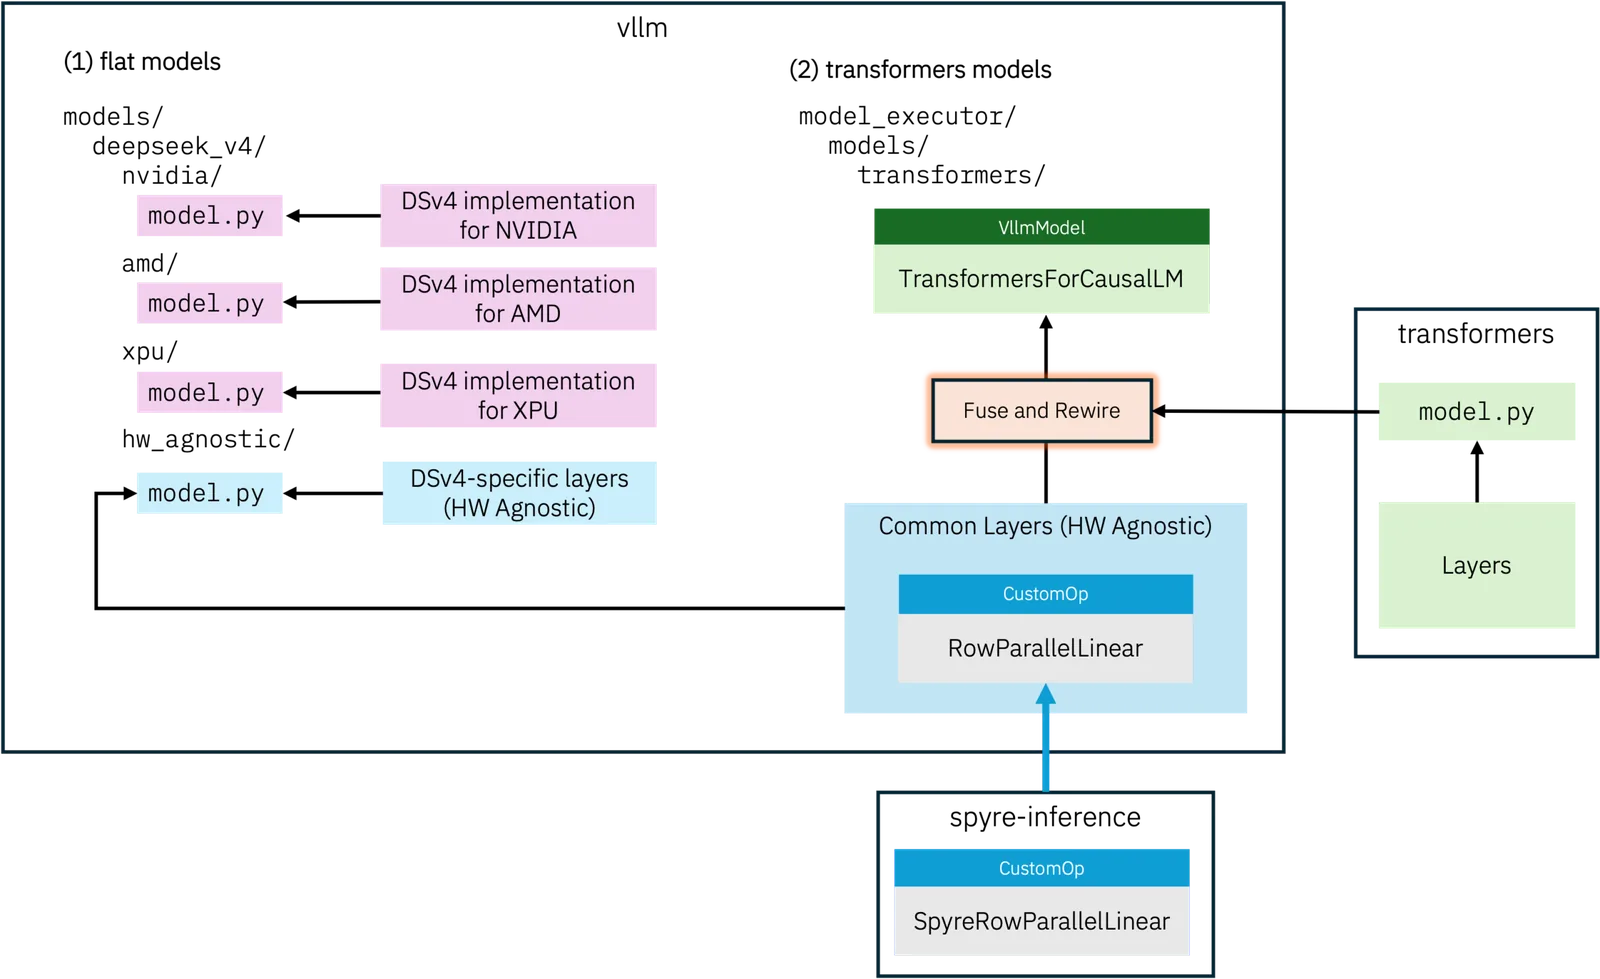
Hoy vLLM ofrece tres variantes de definición de modelo.
- Los modelos planos nuevos, que viven bajo
vllm/models/ - Los modelos heredados, que viven bajo
vllm/model_executor/models - El backend de modelado de transformers, que importa los modelos desde transformers
La lógica de modelado puede vivir en lugares distintos, pero la mayoría de los modelos se compone de capas comunes. Atención, mezcla de expertos, proyecciones lineales, normalizaciones y activaciones. En los tres casos de arriba esas capas comunes siguen implementadas en un solo lugar. En el primero y el segundo se importan explícitamente desde vllm/model_executor/layers. En el tercero, el modelo de transformers se fusiona y se recablea de forma automática para usar las capas de vLLM. Venga de donde venga la definición del modelo, se sigue usando una implementación común para la mayoría de las capas que lo sostienen.
Las implementaciones de capas de vLLM evolucionaron durante varios años y ofrecen dos características que conviene mirar en detalle. Una es el soporte de torch.compile y la otra la extensibilidad para complementos fuera del árbol.
El compilado fullgraph no lo usan los modelos planos, pero sigue siendo una función crítica para complementos externos como IBM Spyre. Spyre se apoya en TorchDynamo para trazar el grafo del modelo y en TorchInductor para bajarlo a representaciones que corren de forma óptima sobre el hardware de destino. torch.compile es además un componente necesario para que el backend de transformers de vLLM alcance velocidad nativa con modelos como Qwen3 sobre GPU de NVIDIA.
Para los complementos externos, sin embargo, el compilado no es toda la historia. Aceleradores como Spyre necesitan además inyectar comportamiento dentro de las capas, por ejemplo disposiciones de memoria propias, para alcanzar el rendimiento óptimo. Las capas de vLLM ofrecen dos mecanismos distintos para eso. CustomOp, que permite al complemento sobrescribir la función forward, y PluggableLayer, que le permite sobrescribir la capa entera. Sin esa extensibilidad, los complementos externos tendrían que reimplementar muchas de las capas por su cuenta.
¿Cuál es el problema?
Tener las definiciones de modelo en tres lugares ya es confuso. Hay un asunto más urgente que ese.
La línea de trabajo de los modelos planos necesita cambiar las definiciones de modelo, y las implementaciones de capa que las sustentan, para romper la compatibilidad con torch.compile y quitar el soporte de extensibilidad vía CustomOp. Eso les permite avanzar más rápido en optimizaciones de rendimiento específicas de hardware y de modelo, y abre tres frentes de preocupación.
El primero deja a los complementos externos ante la posibilidad de mantener su propio conjunto de definiciones de modelo y de capas, con la carga de mantenimiento que eso implica. Soportar un modelo nuevo pasaría por abrir pull requests en transformers, en vLLM y después potencialmente en cada complemento externo que quiera soportarlo. Los agentes de programación lo hacen más fácil, cierto, pero esto igual significa quemar presupuestos de tokens en varias organizaciones distintas sin beneficio real.
El segundo tiene que ver con los modelos antiguos. vLLM se apoya cada vez más en el backend de transformers para soportar modelos viejos o poco comunes. Las definiciones heredadas se están retirando de model_executor/models y sus entradas en el registro se actualizan para apuntar directo al backend de modelado de transformers. Sin capas compilables, el rendimiento de esos modelos sobre GPU cae de forma pronunciada.
El tercero es el hardware. El modelo plano y sus capas se optimizan para GPU de frontera, y el equipo no espera que den soporte a GPU antiguas ni a las de consumo o gama prosumidor. Las propias estadísticas de uso de vLLM muestran que una porción relevante de la base de usuarios sigue usando ese hardware.
Cuatro principios para las capas nuevas
El equipo está construyendo dentro del árbol de vLLM un conjunto de capas agnósticas del hardware. El objetivo es que vLLM siga soportando a la base de usuarios que corre modelos diversos sobre hardware diverso.
Las capas agnósticas se rigen por cuatro principios de diseño.
- Compilables. Las definiciones de modelo van a ser compilables con torch en modo fullgraph. Los aceleradores que necesitan el compilado para rendir pueden seguir usándolo como hasta ahora.
- Extensibles. Se mantienen mecanismos como CustomOp y PluggableLayer para que los complementos externos puedan sobrescribir la implementación cuando haga falta.
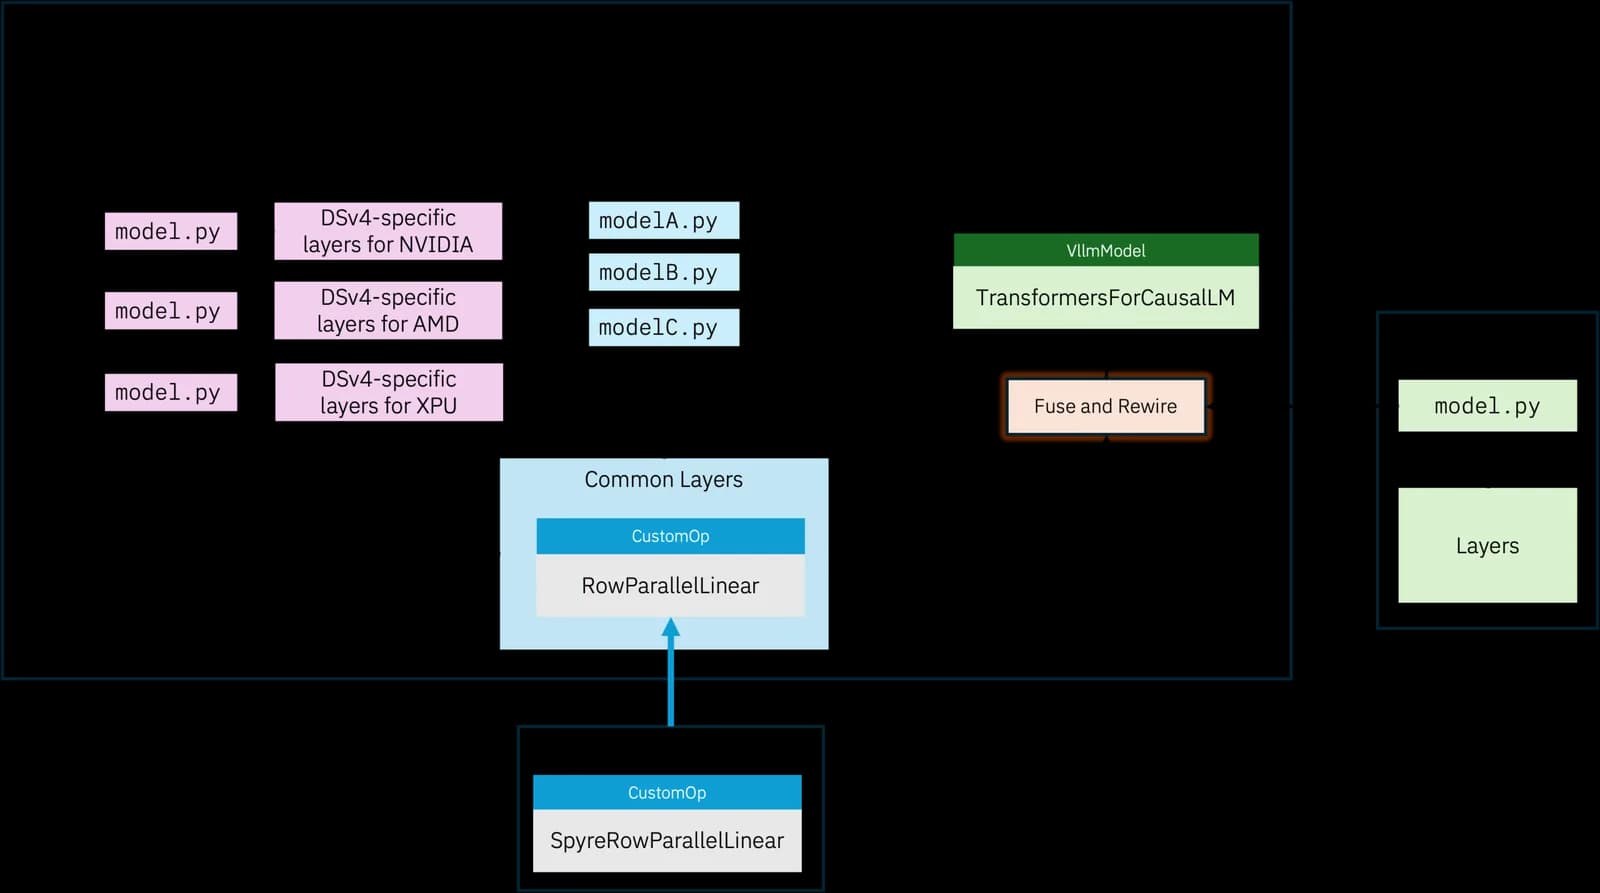
- Aisladas. Las definiciones de modelo se construyen con su propio conjunto de capas y operaciones, separado y aislado del que usan los caminos específicos de hardware. Así el desarrollo en las dos direcciones avanza rápido sin estorbarse.
- Portables. La intención es implementar todas las capas y operaciones con código nativo de PyTorch o con lenguajes específicos de dominio portables como Triton y Helion. Eso vuelve los modelos portables a todos los aceleradores que soporten esos marcos de trabajo.
A medida que las definiciones heredadas se retiren, los modelos van a reimplementarse de forma plana, con una implementación distinta para NVIDIA, AMD, XPU y el resto, o van a caer al backend de transformers. El equipo quiere ofrecer soporte agnóstico del hardware en los dos casos.
Para el backend de transformers ya modificaron el proceso de recableado, que ahora apunta a las capas agnósticas nuevas en model_executor/hw_agnostic en vez de las capas existentes en model_executor/layers. Ese soporte ya entró en la rama principal de vLLM, por ahora para un número limitado de capas, y se activa con la variable USE_HW_AGNOSTIC=1 al correr vLLM con el backend de transformers.
USE_HW_AGNOSTIC=1 vllm serve google/gemma-4-31B --model-impl=transformersEl camino nuevo se validó con el complemento externo de Spyre sobre modelos como Gemma 4, Qwen3 y Granite 4.2. El equipo anunció que pronto va a incluir modelos agnósticos en su integración continua y que lo dejará como la vía por omisión para servir modelos sobre Spyre.
Todavía no entra, pero el plan contempla un model.py nuevo para cada modelo plano, que implemente el modelo con las capas agnósticas. Las capas que se reutilicen entre varios modelos planos van a quedar en un lugar compartido, model_executor/hw_agnostic, mientras que las capas propias de un modelo, como DeepSeekV4FlashMLAAttention, van a vivir en el directorio local junto al model.py y aun así respetar los cuatro principios. Un ejemplo de eso es el pull request agnóstico de DeepSeek V4, que está en revisión.
¿Cómo rinde en GPU?
El equipo aclaró que el rendimiento máximo sobre Blackwell, CDNA 4 y lo que venga después no es el objetivo de estas definiciones de modelo. Lo que buscan es portabilidad de plataforma y de rendimiento sobre hardware diverso, incluidos los aceleradores externos, las GPU antiguas y las de gama prosumidor.
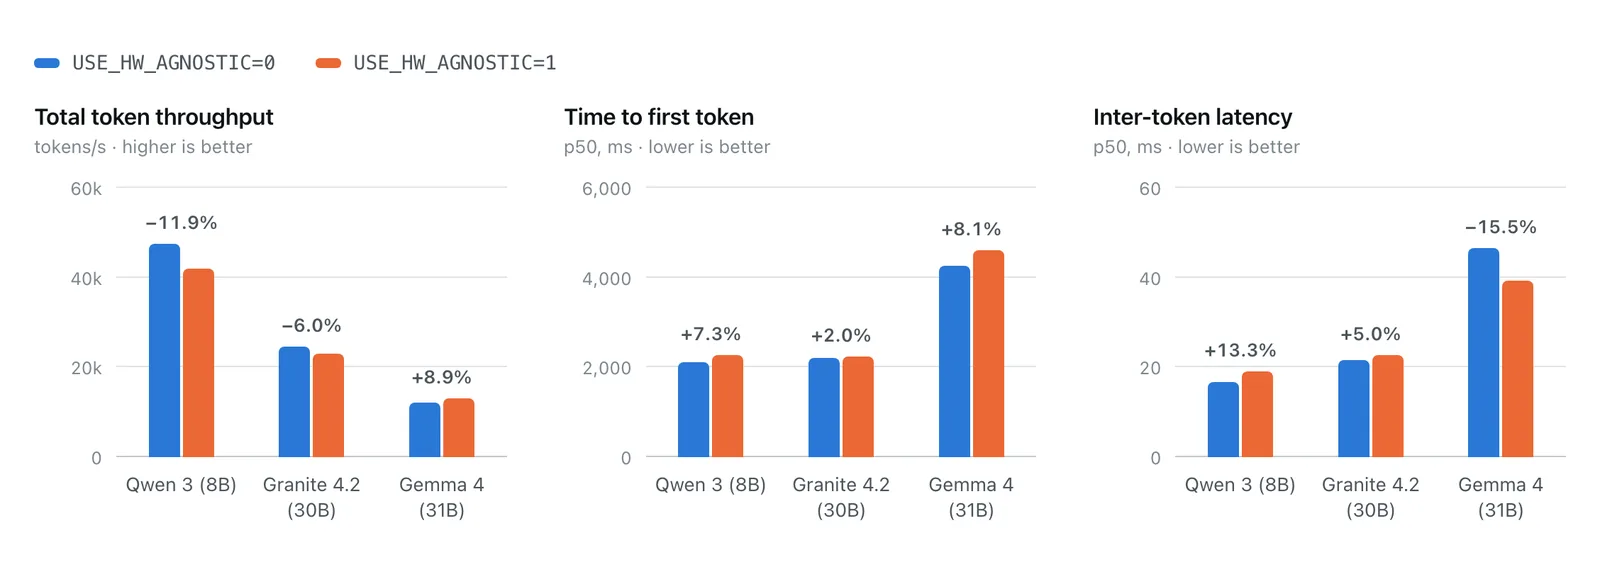
Para evaluar cómo se comporta el camino nuevo sobre GPU de amplia disponibilidad, corrieron experimentos en NVIDIA H100 con un puñado de modelos recientes, comparando el backend de transformers de vLLM con USE_HW_AGNOSTIC=0 contra USE_HW_AGNOSTIC=1. La cifra que resume esa comparación es la del encabezado del anuncio. El caudal total de tokens de las capas agnósticas queda a 3,4% del de la implementación nativa, como media geométrica sobre tres modelos recientes.