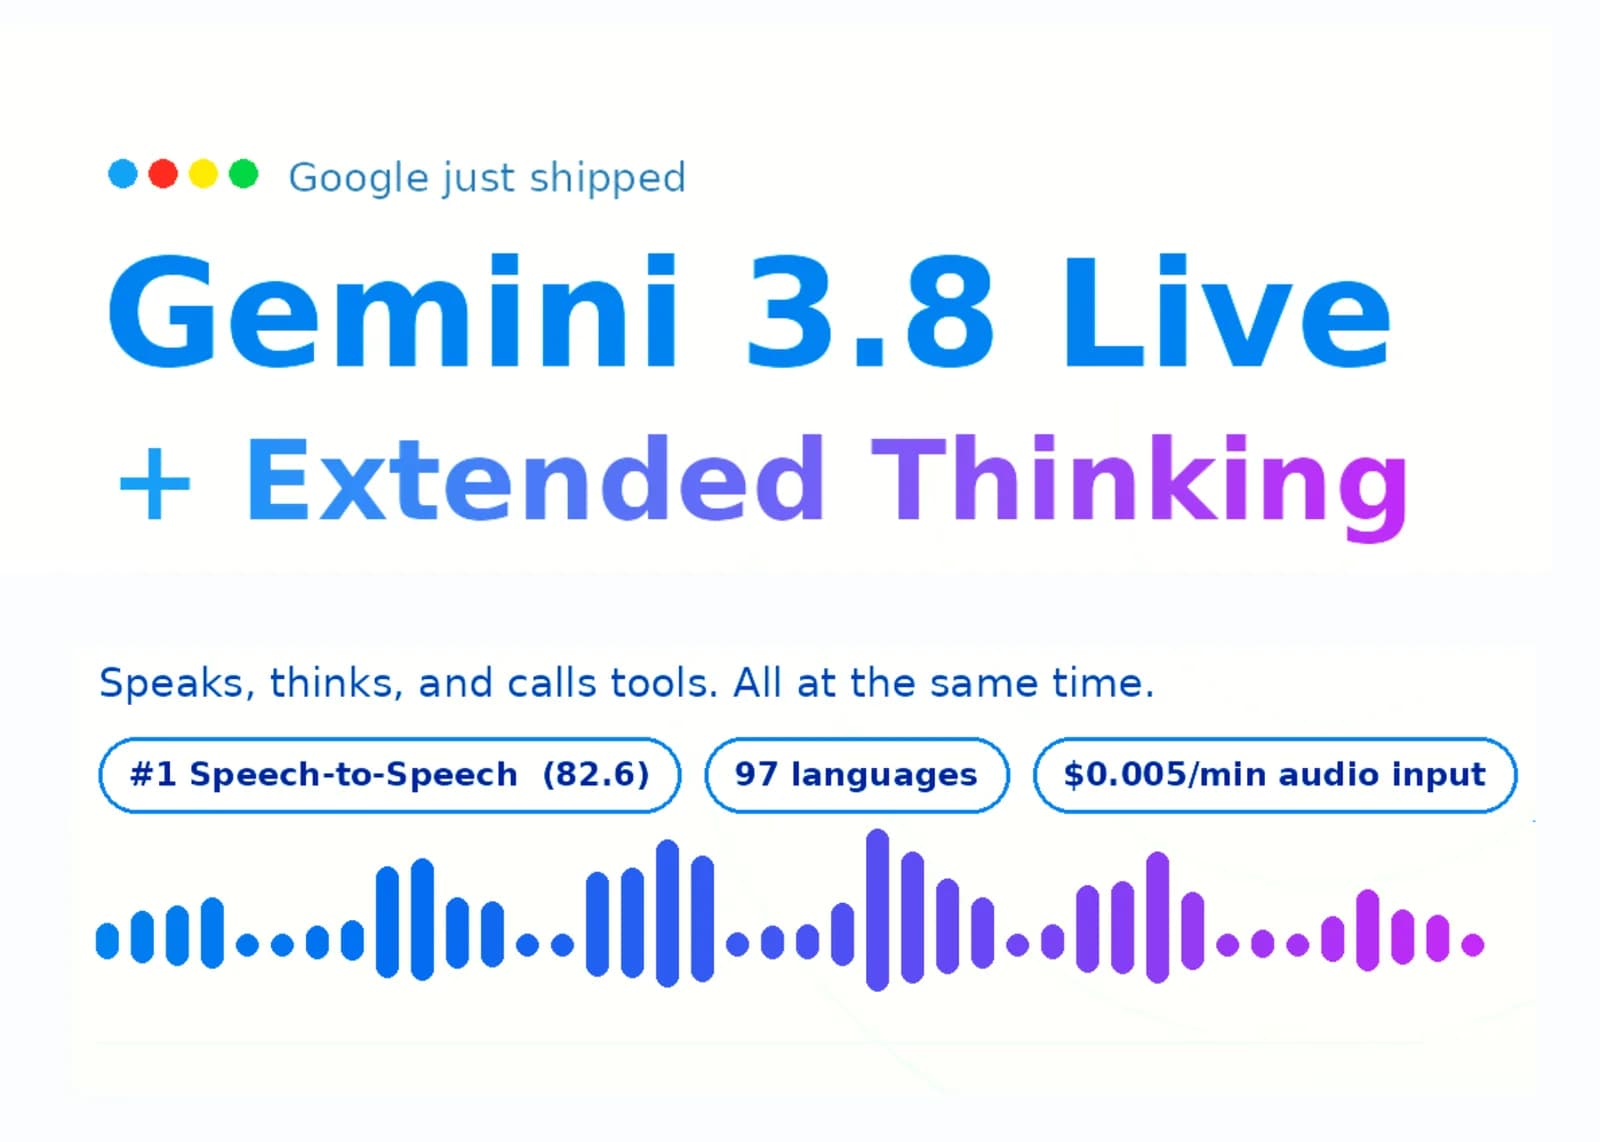
Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking quedaron disponibles el 15 de septiembre en el Gemini Live API y en Google AI Studio. Los dos son modelos nativos de voz a voz, es decir procesan el audio de entrada y generan el de salida sin pasar por una cadena de transcripción, modelo de texto y síntesis. Google los presentó como sus modelos de diálogo en vivo más avanzados hasta ahora.
El lanzamiento extiende la familia Gemini Audio, que la compañía amplió el mes pasado con Gemini 3.5 Transcribe. El hueco que apunta a tapar es concreto. Un agente de voz que necesita razonar o consultar un sistema externo se queda mudo mientras trabaja, y esa pausa rompe la conversación.
Los dos modelos son hospedados. No hay pesos abiertos ni opción de correrlos en infraestructura propia, así que el único camino a producción es la API.
¿Qué lanzó Google exactamente?
Son dos modelos con roles distintos. Gemini 3.8 Live apunta a escala y costo, y combina diálogo fluido con comprensión de lo que ve la cámara. Gemini 3.8 Live Extended Thinking está armado para tareas complejas y agrega razonamiento de varios pasos mientras el modelo habla.
Google presenta a los dos como alternativa a las cadenas de voz en cascada, esas que encadenan un reconocedor de voz, un modelo de lenguaje y un sintetizador. Cada eslabón de esa cadena suma latencia propia.
Los números que puso sobre la mesa
Gemini 3.8 Live Extended Thinking quedó primero en el Speech to Speech Quality Index de Artificial Analysis con 82,6 puntos. En ejecución de tareas agénticas anota 68,6% en τ-Voice y 35,1% en el τ-Voice-banking de Sierra. En Big Bench Audio, una prueba de razonamiento para modelos de audio, llega a 97,7%.
La variante liviana, Gemini 3.8 Live, quedó segunda en el Speech Agent Arena, una evaluación por preferencia humana. Sobre EVA-Bench, de ServiceNow, Google informa que los dos modelos empujan la frontera de Pareto en flujos de trabajo complejos, con mediciones hechas en la Live API sobre Gemini Enterprise Agent Platform.
¿Qué gana quien programa con la Live API?
La Live API expone cinco capacidades en los modelos nuevos:
- Llamadas a funciones asincrónicas. El modelo ejecuta llamadas a APIs y herramientas en segundo plano, y el audio sigue saliendo hacia el usuario mientras la tarea termina.
- Contexto visual. Procesa entradas visuales en vivo casi en tiempo real, así el agente entiende lo que el usuario dice y lo que le muestra.
- Precisión alfanumérica. Interpreta códigos de confirmación, números de siniestro y datos técnicos, que es justo donde fallan los sistemas de voz.
- Soporte multilingüe. Detecta y cambia entre 97 idiomas en medio de la conversación, con consistencia de acento.
- Actualización incremental de contenido. Mezcla el audio en tiempo real con datos estructurados para responder con el contexto puesto.
Extended Thinking suma además razonamiento configurable para encadenar varios pasos en segundo plano. Razona y habla al mismo tiempo, y usa señales verbales tempranas del tipo "déjame revisar eso" para acusar recibo de lo que le pidieron. Después narra el avance paso a paso mientras la tarea larga se ejecuta.
En las demostraciones de Google el modelo convierte bocetos y comentarios hablados en componentes React que funcionan, y coordina reservas de varios pasos sin cortar el diálogo.
Precio y socios de integración
El precio publicado es el mismo para los dos modelos. Son 0,005 dólares por minuto de audio de entrada y 0,018 dólares por minuto de audio de salida. Google aclara que esa estimación sale de cobrar 3 dólares por millón de tokens de entrada y 12 dólares por millón de tokens de salida.
Para el streaming de medios en tiempo real, la compañía lista socios de integración que ya soportan la Live API. Están Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel y Vision Agents.
Salesforce, Genspark y Lumeris figuran como empresas que ya trabajan con los modelos y que citan la baja latencia y la capacidad de llamar herramientas sin cortar la conversación. Los ejemplos de código están publicados en GitHub.
La marca de agua va incluida
Todo el audio que generan los dos modelos sale con SynthID, la marca de agua imperceptible de Google DeepMind. No es opcional para quien integra la API.