Un agente ReAct con GPT-4.1 aprueba el 77,4% de las corridas en AppWorld. Cuando se le pide cinco veces la misma tarea, acierta las cinco en apenas el 53,0% de los casos. Esa diferencia de 24,4 puntos es lo que IBM Research bautizó brecha de consistencia, y es la que casi ningún ranking muestra.
El escenario que abre el artículo lo conoce cualquiera que haya mostrado un agente en vivo. Funciona en el ensayo y, en la demostración, toma otro camino y falla la misma tarea. Arriba del escenario eso da vergüenza. En producción es un problema de confiabilidad, porque un flujo de trabajo que salió bien una vez puede fallar la próxima que un usuario pida exactamente lo mismo. Para tareas críticas, como cuadrar una transacción financiera o revisar si un contrato tiene una obligación, eso deja de ser una anécdota.
El grupo ya había presentado ALTK-Evolve, un sistema que convierte las trazas pasadas de un agente en guías reutilizables, destiladas de forma automática y reinyectadas al momento de la inferencia. Ese trabajo mejoraba la tasa de éxito, pero también medía el caso promedio. Lo nuevo son las guías de consistencia, un tipo de guía dentro de altk-evolve construido sobre una herramienta de diagnóstico que llamaron Consistency Analyzer.
La métrica que casi nadie reporta
La evaluación estándar de agentes reporta Mean@k. Se corre el banco de pruebas k veces y se promedia la tasa de aprobación. Muchas veces k es 3, a veces es 1. Ese es el número de todos los rankings y es lo que significa en la práctica un "77% de acierto".
Mean@k responde qué tan bueno es el agente en promedio. No responde la pregunta que le importa a un usuario real, que es si va a seguir siendo bueno cuando le pida exactamente lo mismo de nuevo. Para eso existe Pass^k, la fracción de tareas donde el agente acierta en todas las corridas.
El artículo marca una advertencia. Pass^k no es Pass@k. El conocido Pass@k es optimista, porque pregunta si al menos uno de los k intentos salió bien, que es la pregunta correcta cuando uno puede verificar y reintentar. Pass^k es su espejo pesimista, donde todos los intentos tienen que salir bien. Las mismas letras, la pregunta opuesta. Siempre se cumple que Pass^k es menor o igual que Mean@k, y que Mean@k es menor o igual que Pass@k.
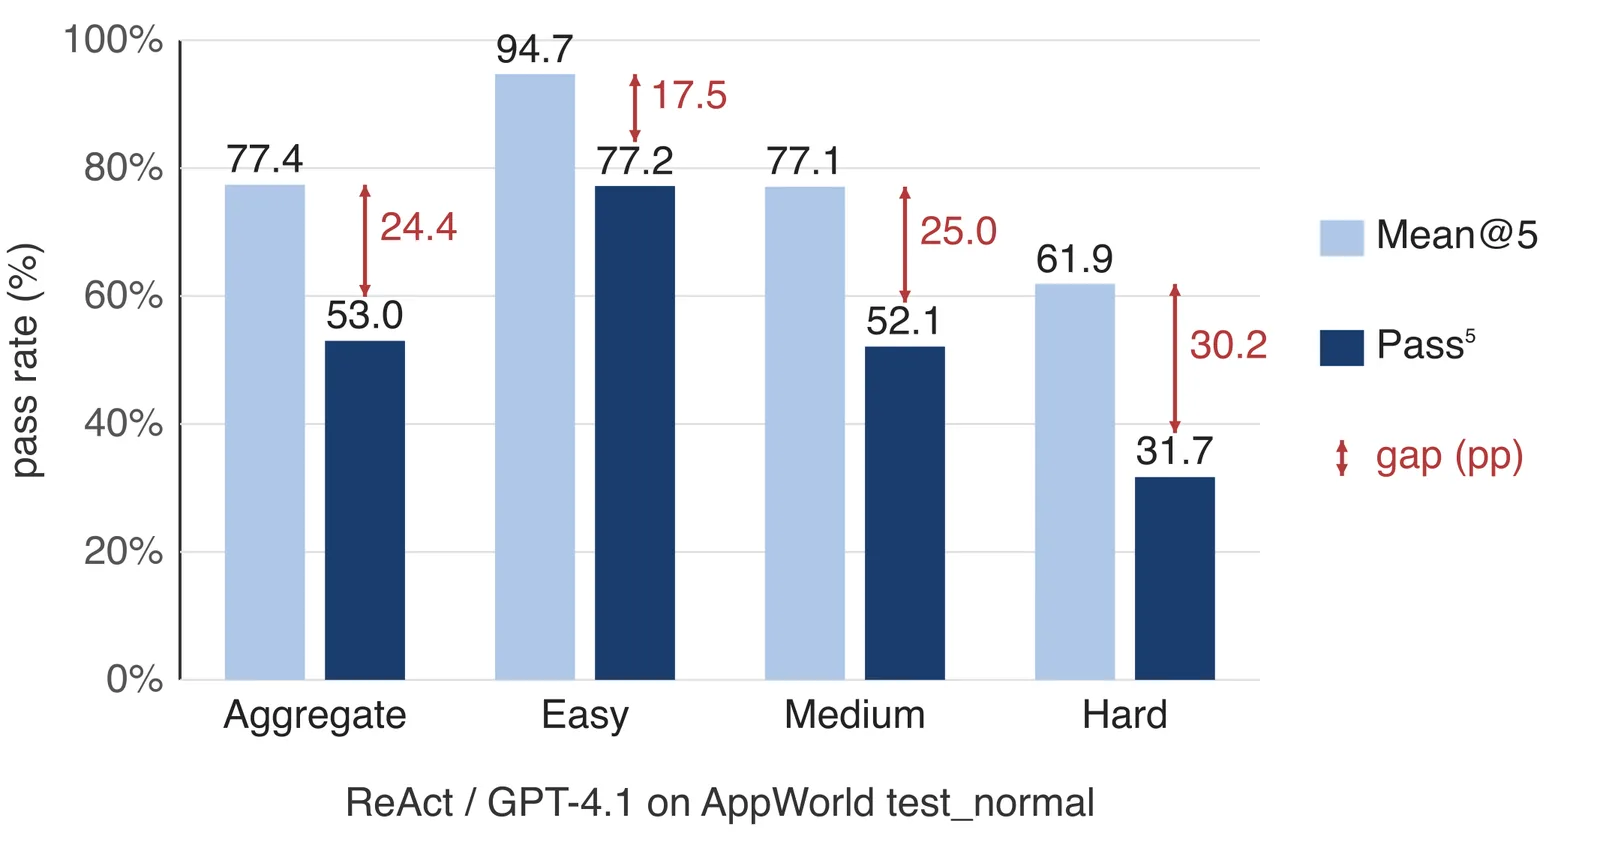
El agente ReAct con GPT-4.1 anota un Mean@5 de 77,4%, que es un resultado fuerte. Su Pass^5 es de 53,0%. Casi un cuarto del banco de pruebas son tareas que el agente a veces resuelve y a veces no, sin que nada cambie en la tarea entre una corrida y otra. En las tareas difíciles la brecha llega a 30 puntos.
IBM Research insiste en un punto. Esto no se arregla con un modelo más grande, porque la consistencia es un eje aparte de la capacidad. Un agente puede ser capaz e inconsistente al mismo tiempo.
¿Por qué el agente cambia de opinión?
Cada vez que un agente decide algo, a qué API llamar, qué argumento pasar, si reintenta o no, esa decisión sale de una distribución de probabilidad sobre el siguiente token. Lo que manda es la forma de esa distribución. Una distribución afilada concentra casi toda la masa en un solo token, los segundos lugares quedan lejos y la misma elección sale corrida tras corrida. Una distribución plana reparte masa parecida entre varios tokens casi empatados, y cuál gana se parece a tirar una moneda.
Esa forma decide cuánto ruido hace falta para cambiar el resultado. Las distribuciones afiladas aguantan. La no asociatividad del punto flotante en la GPU, el agrupamiento de solicitudes y otros efectos del lado de la plataforma mueven los números un poco, pero no alcanzan a reordenar a un ganador claro. Las distribuciones planas son vulnerables justo a ese empujón, porque los empates técnicos se pueden dar vuelta con perturbaciones mínimas. Y como una traza encadena decenas de decisiones, una probabilidad chica de dar vuelta en cada paso se acumula en una probabilidad alta de que alguna corrida salga distinta. De ahí salen los 24 puntos.
Esto también explica por qué el problema sobrevive a la configuración de decodificación. La decodificación voraz y una semilla fija gobiernan cómo se convierte una distribución en un token, y no dicen nada sobre la distribución misma. En un servicio hospedado las probabilidades se mueven un poco de una corrida a otra, así que el mismo prompt al mismo modelo con temperatura cero puede resolver un empate técnico para un lado hoy y para el otro mañana.
El agente ReAct del experimento corre a temperatura 0,0, o sea nada de esa varianza es muestreo ordinario.
Diagnosticar primero, después arreglar
El problema se convierte así en una búsqueda. Cuáles pasos de una traza dada fueron los planos, y qué se hace con ellos una vez que se sabe. Las guías de consistencia salen de un flujo de dos etapas que se enchufa a la maquinaria que ALTK-Evolve ya tenía, con una señal de origen nueva que decide qué se escribe.
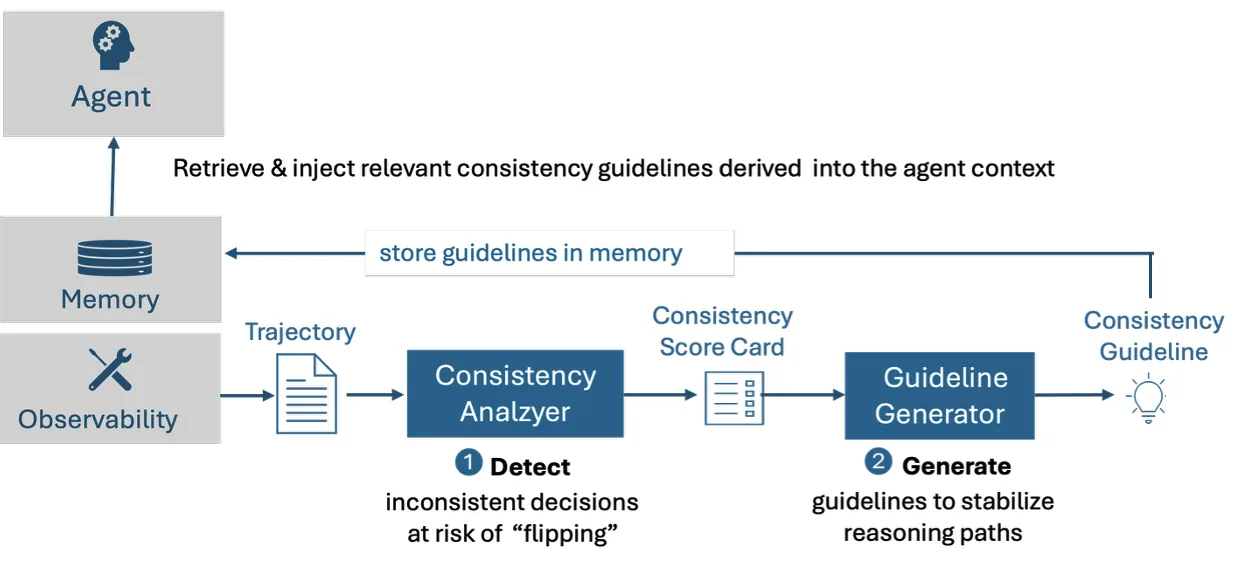
La primera etapa es la detección, a cargo del Consistency Analyzer. Con una traza grabada, el analizador vuelve a pasar cada paso de decisión por un remuestreo controlado y mide cuánto varía de verdad la salida del modelo en ese punto. En concreto es una llamada adicional al modelo por cada paso de decisión, hecha una sola vez y fuera de línea, pidiendo k respuestas de una vez (k vale 5 por omisión) contra el contexto ya registrado. No hay llamadas nuevas a herramientas, ni interacciones nuevas con el entorno, ni una segunda corrida completa de la tarea. El resultado es un puntaje de consistencia por paso, anotado en una tarjeta que señala qué decisiones corren riesgo de darse vuelta en la corrida siguiente. La detección es de caja negra, sin logits, sin acceso a las tripas del modelo y sin más instrumentación que la traza que ya se tenía.
La segunda etapa es la generación de guías dirigidas. Cada paso marcado se convierte en una guía candidata en el formato estándar de ALTK-Evolve, así entra en el almacenamiento y la recuperación que ya existen. El artículo muestra un ejemplo real, generado por GPT-4.1 a partir de la traza de una tarea de AppWorld que preguntaba cuántas actividades están hechas en la lista de pendientes según una nota de SimpleNote.
"[Guía 1] Al contar marcadores tipo casilla de verificación en el contenido de una nota, usa una coincidencia de expresión regular anclada a la línea en vez de un conteo simple de subcadenas, porque los títulos de las notas suelen repetir el símbolo del marcador en una línea de leyenda. [Guía 2] Verifica siempre los resultados de búsqueda de notas revisando si hay varias coincidencias y confirmando cuál es la nota correcta antes de seguir."
Ninguna de las dos guías es un dato suelto de esa tarea. Los errores al contar cadenas y los resultados de búsqueda sin verificar son puntos de decisión que aparecen con alta incertidumbre en muchas tareas de AppWorld. Ese es el punto del método, porque el analizador apunta a la inestabilidad y no al fracaso, así que caza pasos que el agente sacó bien esta vez y podría sacar mal la próxima.
IBM Research publicó una demostración de dos minutos donde cinco corridas paralelas del agente se dividen 3 a 2 en esa tarea por la incertidumbre sobre la estrategia de conteo, y después vuelven a correr con las guías en el contexto. Las cinco coinciden.
Los resultados, sin perder acierto promedio
La evaluación se hizo sobre AppWorld test_normal, que tiene 168 tareas, con un agente ReAct sobre GPT-4.1. Las guías de consistencia se generaron desde una sola traza base por tarea y se probaron en 5 corridas nuevas.
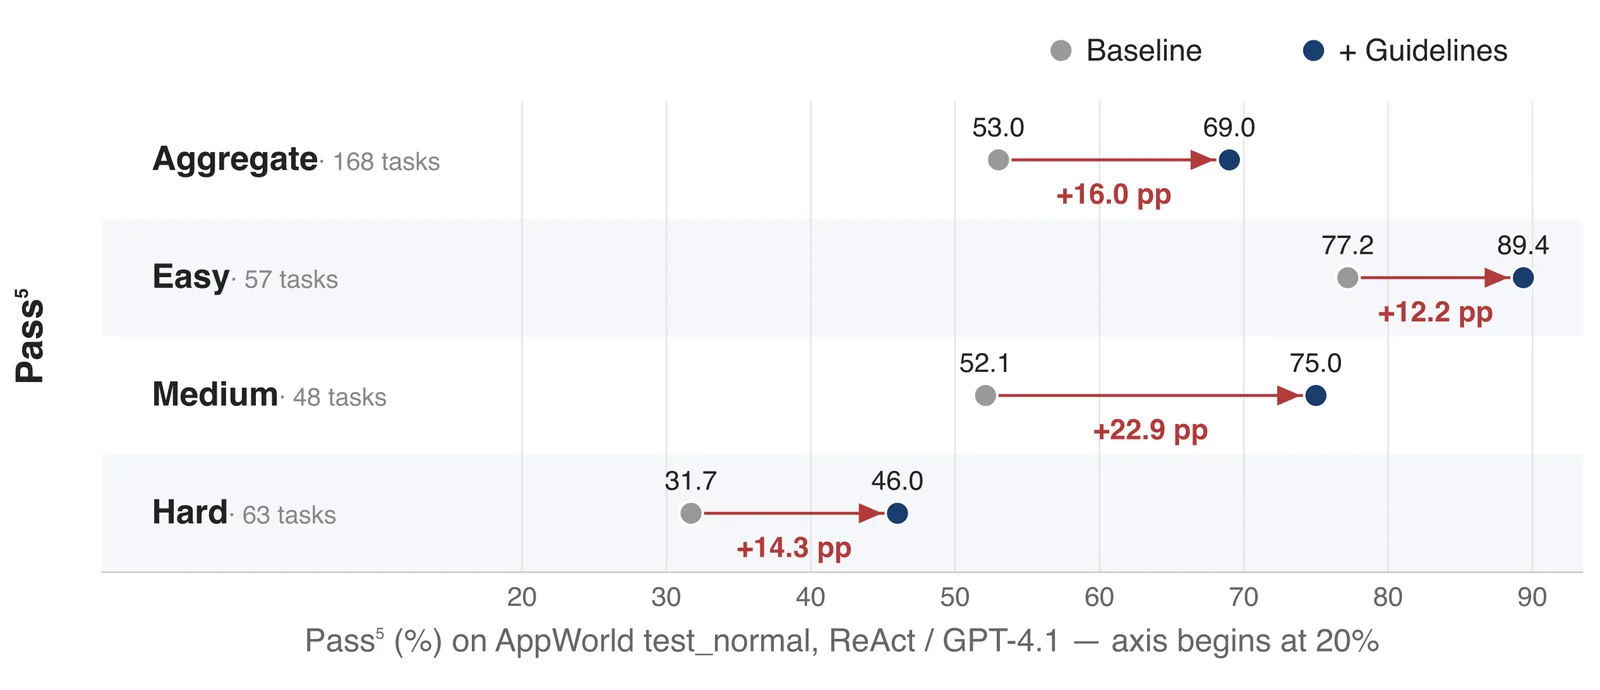
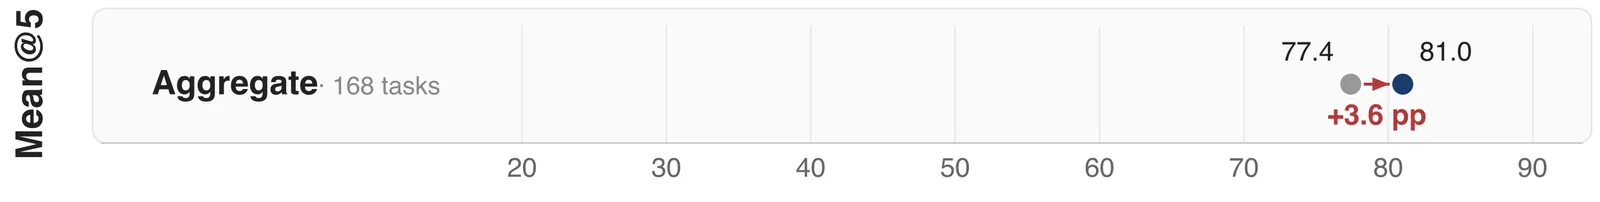
La brecha se corta casi a la mitad. El Pass^5 agregado sube de 53,0% a 69,0% mientras el Mean@5 sube de 77,4% a 81,0%, así que la distancia entre "parece capaz" y "se puede contar con él" baja de 24,4 a 12,0 puntos porcentuales. Casi un tercio de las tareas que antes eran inconsistentes pasan a ser tareas que el agente aprueba en todas las corridas.
Los tramos medio y difícil son los que más ganan. Medio suma 22,9 puntos, un 44% relativo, y difícil suma 14,3 puntos, un 45% relativo, o sea quedan empatados en términos relativos y el medio manda en términos absolutos. El tramo fácil sube 12,2 puntos, que era el que tenía menos espacio.
El Mean@5 nunca baja. Preservar el acierto promedio era un requisito duro del diseño, porque un sistema que sube el Pass^5 a costa del Mean@5 estaría moviendo la falta de confiabilidad de lugar en vez de arreglarla. El acierto promedio se mantiene o mejora en todos los niveles de dificultad.
Las guías sirven en otra tarea, no solo en la que salieron
Aplicadas a una tarea distinta pero emparentada dentro del mismo escenario de AppWorld, otra variante del escenario del que se extrajeron, las guías de consistencia igual suben el Pass^5 en 13,0 puntos, apenas 3 por debajo del número de la misma tarea. Una guía sacada de una corrida no está parchando esa corrida, está capturando algo que se transfiere.
La evidencia más filosa viene de un modelo más débil, gpt-oss-120b. Ahí el Pass^5 en la misma tarea subió 6,0 puntos desde una línea base mucho más baja, de 10,1% a 16,1%. El número de generalización a tareas parecidas, de 8,7 puntos, terminó por encima de la ganancia en la propia tarea, lo que apunta a que las guías capturan patrones de falla reutilizables y no los detalles de una traza.
Cuatro recomendaciones para quien pone un agente en producción
- Reportar Pass^k al lado de Mean@k. El promedio no distingue a un agente confiable de uno con suerte, y hasta con k igual a 3 aparece una brecha que nadie había visto.
- Esperar que la brecha se ensanche con la dificultad. El tramo más difícil es donde un solo número promedio engaña más.
- No partir por un modelo más grande. La consistencia es ortogonal a la capacidad, y un modelo más fuerte sube el Mean@k sin reducir necesariamente la brecha.
- El diagnóstico no necesita un evaluador ni una repetición en vivo. Basta una llamada extra al modelo por paso de decisión, con k igual a 5 por omisión, sin datos de referencia y sin volver a correr la tarea contra el entorno. Eso es lo que lo hace usable sobre tráfico de producción, donde muchas veces no se puede repetir una tarea completa ni una sola vez.
El código está en el repositorio abierto de ALTK-Evolve, que ya incluye el Consistency Analyzer y la generación de guías usadas en estos experimentos. La metodología completa está en el informe técnico en arXiv.