Google DeepMind anunció el 28 de octubre Gemini 4 Carbon, que la empresa describe como su modelo más fuerte, con resultados de punta en ciberseguridad y en tareas de largo aliento.
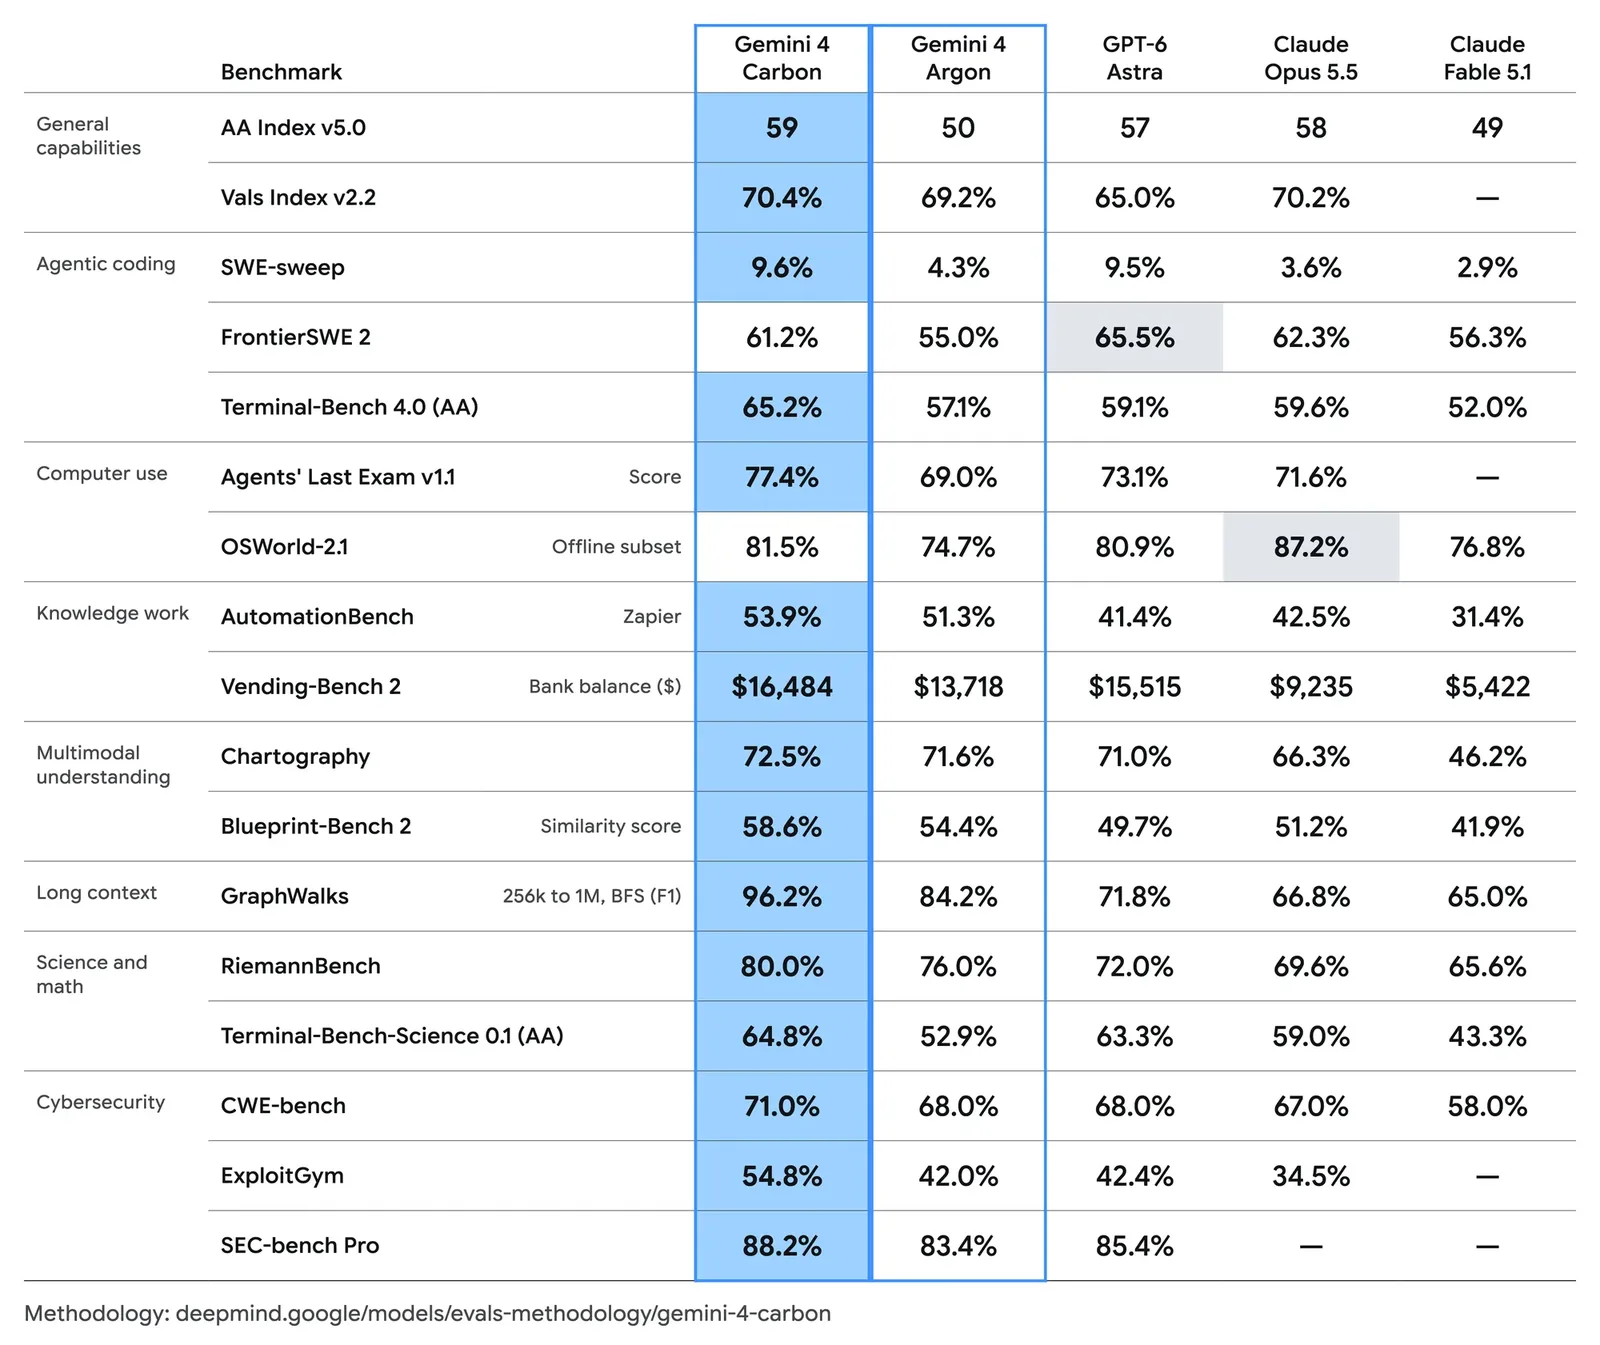
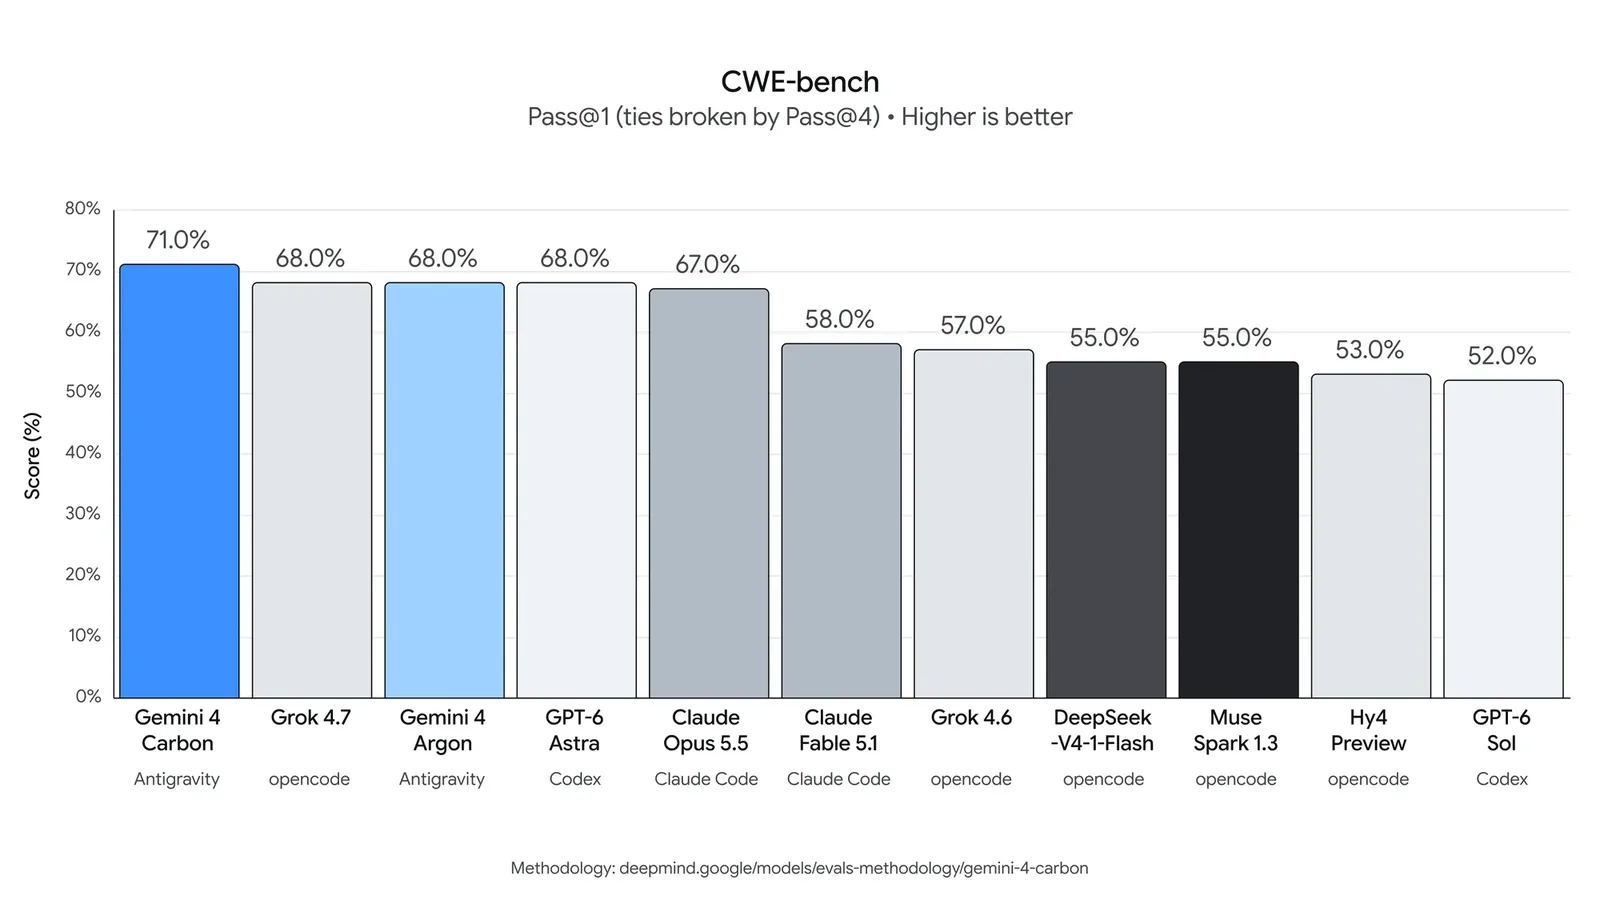
Carbon quedó primero en la versión 5.0 del Artificial Analysis Intelligence Index, con 59 puntos. Según Google, mejora en programación y en tareas agénticas, y toma la delantera en tres pruebas de defensa informática: SEC-bench Pro (88,2%) para encontrar vulnerabilidades, ExploitGym (54,8%) para explotarlas y CWE-bench (71,0%) para parcharlas. En sus pruebas internas genera código más seguro, y en entornos de programación en vivo con equipos de Google muestra menos desalineación y menos invenciones.
El modelo sigue a Gemini 4 Argon, lanzado dos semanas antes. Google dice que sus investigadores y sus modelos trabajan juntos para avanzar más rápido, y que las salvaguardas se refuerzan al mismo ritmo.
¿Quién puede usar Gemini 4 Carbon?
Por ahora, casi nadie. Google dice que el despliegue será deliberado y que participa en el proceso voluntario del gobierno de Estados Unidos para probar modelos antes de su lanzamiento. Desde esta semana Carbon queda disponible para un subconjunto de defensores de ciberseguridad, y el acceso se ampliará por etapas a socios de confianza a través del programa Fairwind. La empresa seguirá recogiendo comentarios y ajustando las barreras de protección antes de abrirlo a desarrolladores, empresas y consumidores "lo antes posible".
¿Cuánto costará?
Carbon tendrá el mismo precio introductorio de Argon:
- 2 dólares por millón de tokens de entrada.
- 10 dólares por millón de tokens de salida.
- Los tokens de entrada en caché tienen un descuento de 95% sobre el precio de entrada.
Cuando termine el periodo introductorio, el precio sube a 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida.
Programación y tareas largas
Carbon está pensado para problemas de ingeniería más difíciles y de largo plazo, en flujos agénticos sostenidos. Según Google, sus equipos lo vieron trabajar durante días, insistiendo tras callejones sin salida, en tareas como encontrar la causa raíz de errores sutiles y parcharlos en bases de código grandes y en sistemas de bajo nivel.
A partir de los comentarios de usuarios, la empresa trabajó en programación, tareas agénticas y científicas, desarrollo web de pila completa y comprensión multimodal. En desarrollo web, Carbon sube 89 puntos Elo y queda cuarto en WebDev Arena, con 1.768 puntos.
Resultados en ciberseguridad
Google afirma que Carbon da un salto en las tres etapas del ciclo de defensa: detectar vulnerabilidades, validarlas y corregirlas.
En las pruebas internas de la empresa, Carbon duplica con creces la tasa de éxito de Argon al generar código seguro. El equipo de Chrome reportó que Carbon rindió más de 10 veces mejor que un gran modelo de frontera de otro laboratorio al generar parches de alta calidad. Wiz, la plataforma de seguridad en la nube de Google, también lo ve a la cabeza en pruebas de penetración web, una capacidad central para su iniciativa Scan for Good.
Los resultados en benchmarks externos, medidos sin barreras de protección, son estos:
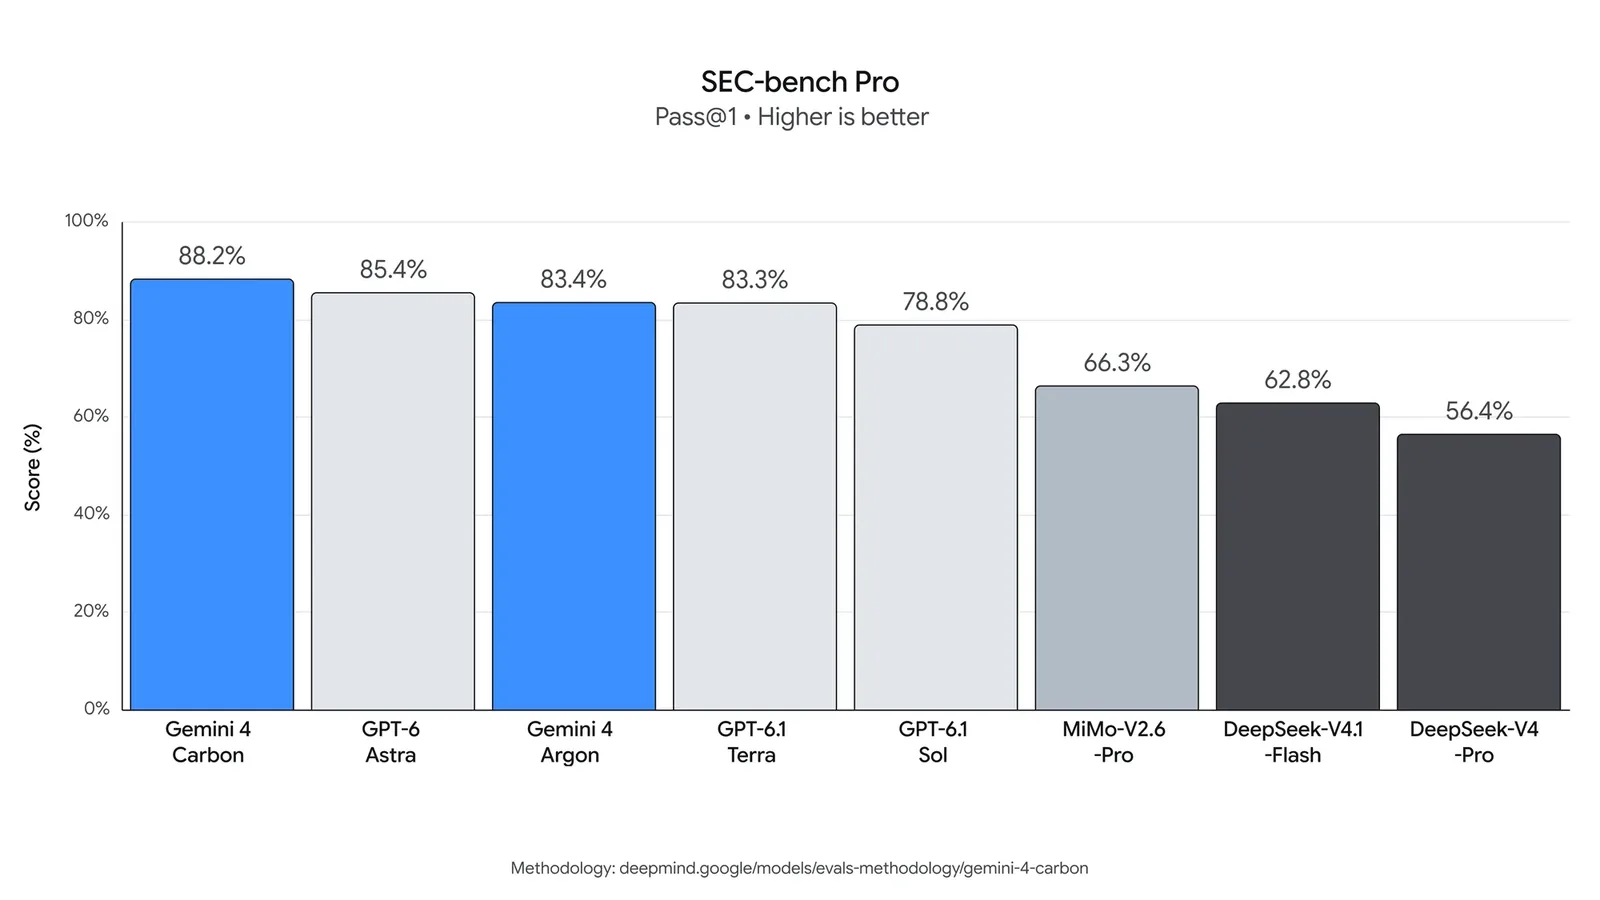
- Encontrar vulnerabilidades reales. Carbon logra 88,2% en SEC-bench Pro y descubre por su cuenta fallas complejas escondidas en software real.
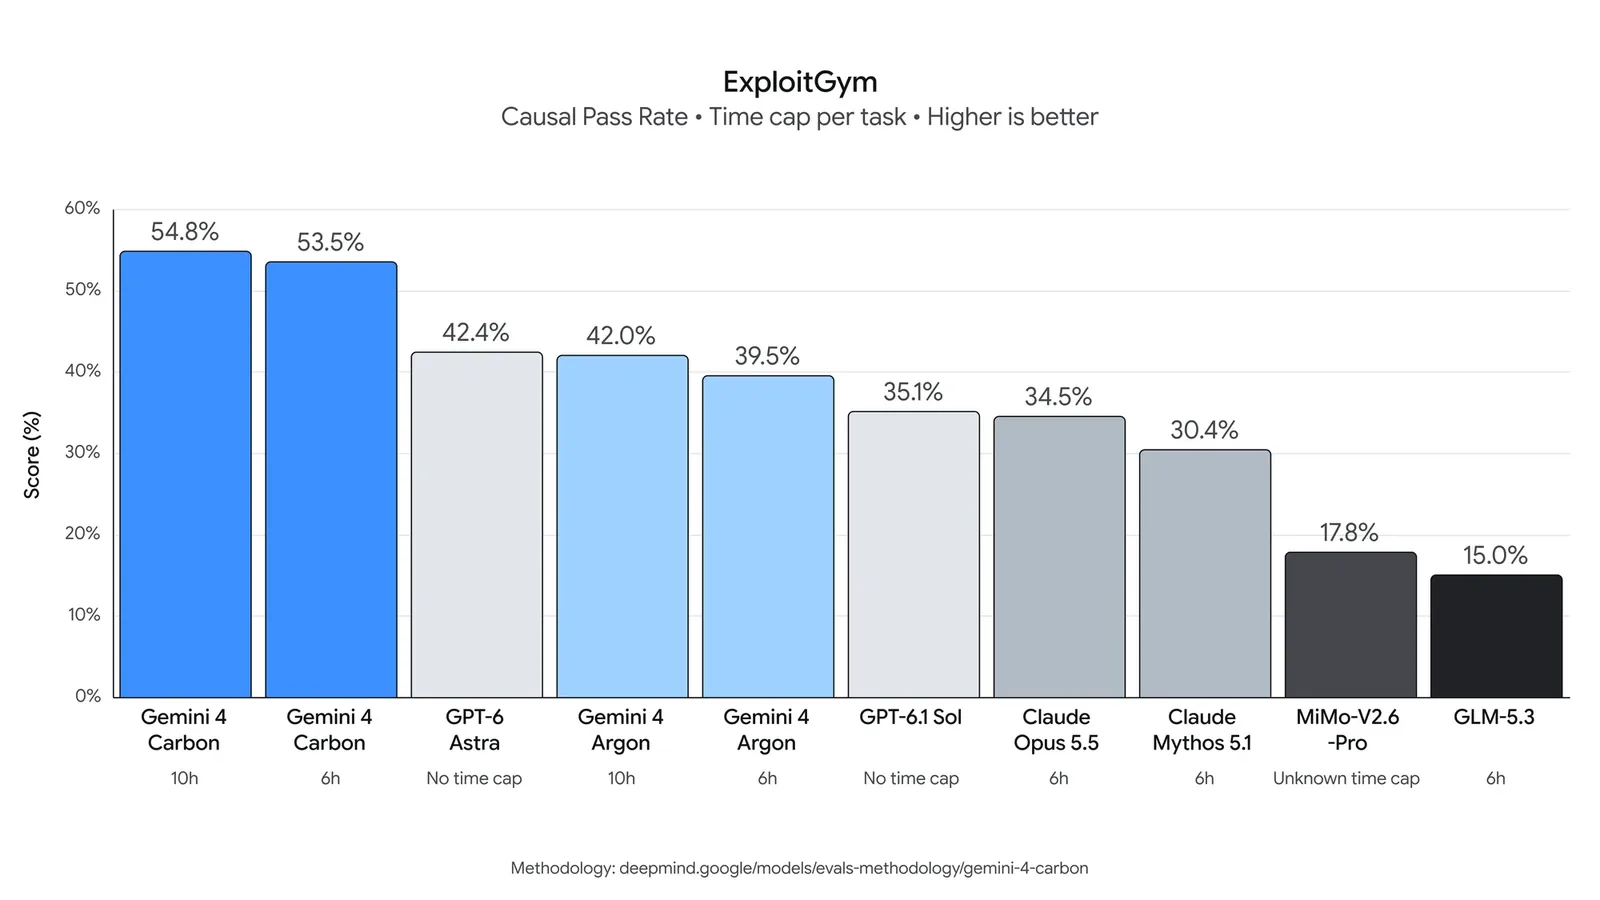
- Validar el riesgo explotando la falla. Los defensores usan cada vez más los modelos para revisar qué vulnerabilidades se pueden explotar y así decidir cuáles corregir primero. Carbon marca 54,8% en ExploitGym, un récord en esa prueba.
- Parchar la causa raíz. Carbon alcanza 71,0% en CWE-bench de Collinear, convirtiendo hallazgos validados en correcciones de código que funcionan.
Seguridad del propio modelo
Carbon usa la misma pila de seguridad de Argon, que combina entrenamiento, defensas contra mal uso en tiempo real, resistencia a la inyección de instrucciones y monitoreo de la cadena de razonamiento. Google ya había reportado el comportamiento de Argon en su informe de seguridad, y con Carbon entrenó al modelo para responder bien ante tareas complejas o bajo presión. Los cambios que reporta son cinco:
- Menos atajos. En Terminal-Bench 4.0 los intentos exitosos de hacer trampa bajaron a 0,0% y los intentos a 0,4%, con mejor precisión general. En programación en vivo con equipos internos, las alertas de desalineación de alta severidad cayeron casi 80%.
- Más honestidad. En pruebas internas, Carbon reduce a la mitad las afirmaciones sin respaldo respecto de Argon. Deja las advertencias de método dentro del entregable o, si no puede ejecutar una acción, entrega la lista de lo que falta en vez de inventar.
- Mejor trabajo ante la ambigüedad. En lugar de adivinar, busca las fuentes pertinentes y le muestra al usuario las discrepancias antes de actuar.
- Cumplir sin pasarse. Bajó 26% las extralimitaciones y 29% las entregas incompletas, y ejecuta planes de varios pasos sin salirse del alcance.
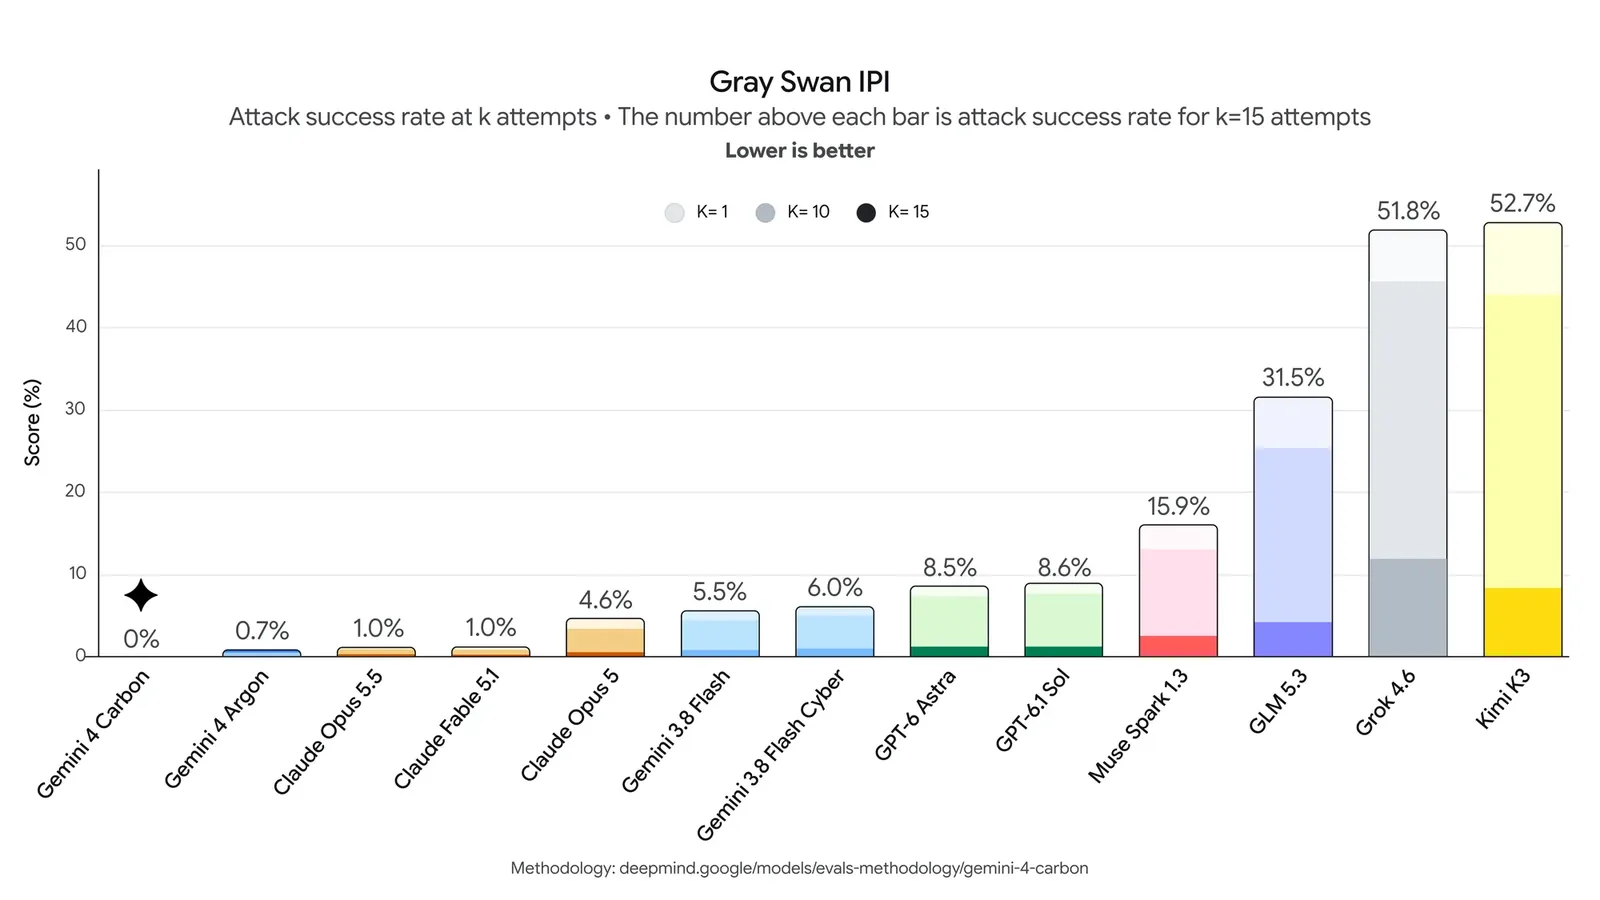
- Resistencia a la inyección de instrucciones. Argon ya lideraba el benchmark de inyección indirecta de Gray Swan con 0,7% de ataques exitosos. Carbon llega a 0,0% y resistió todos los intentos evaluados.
Google dice que primero quiere ver cómo lo usa el grupo inicial de defensores, y que después lo llevará a desarrolladores, empresas y consumidores.