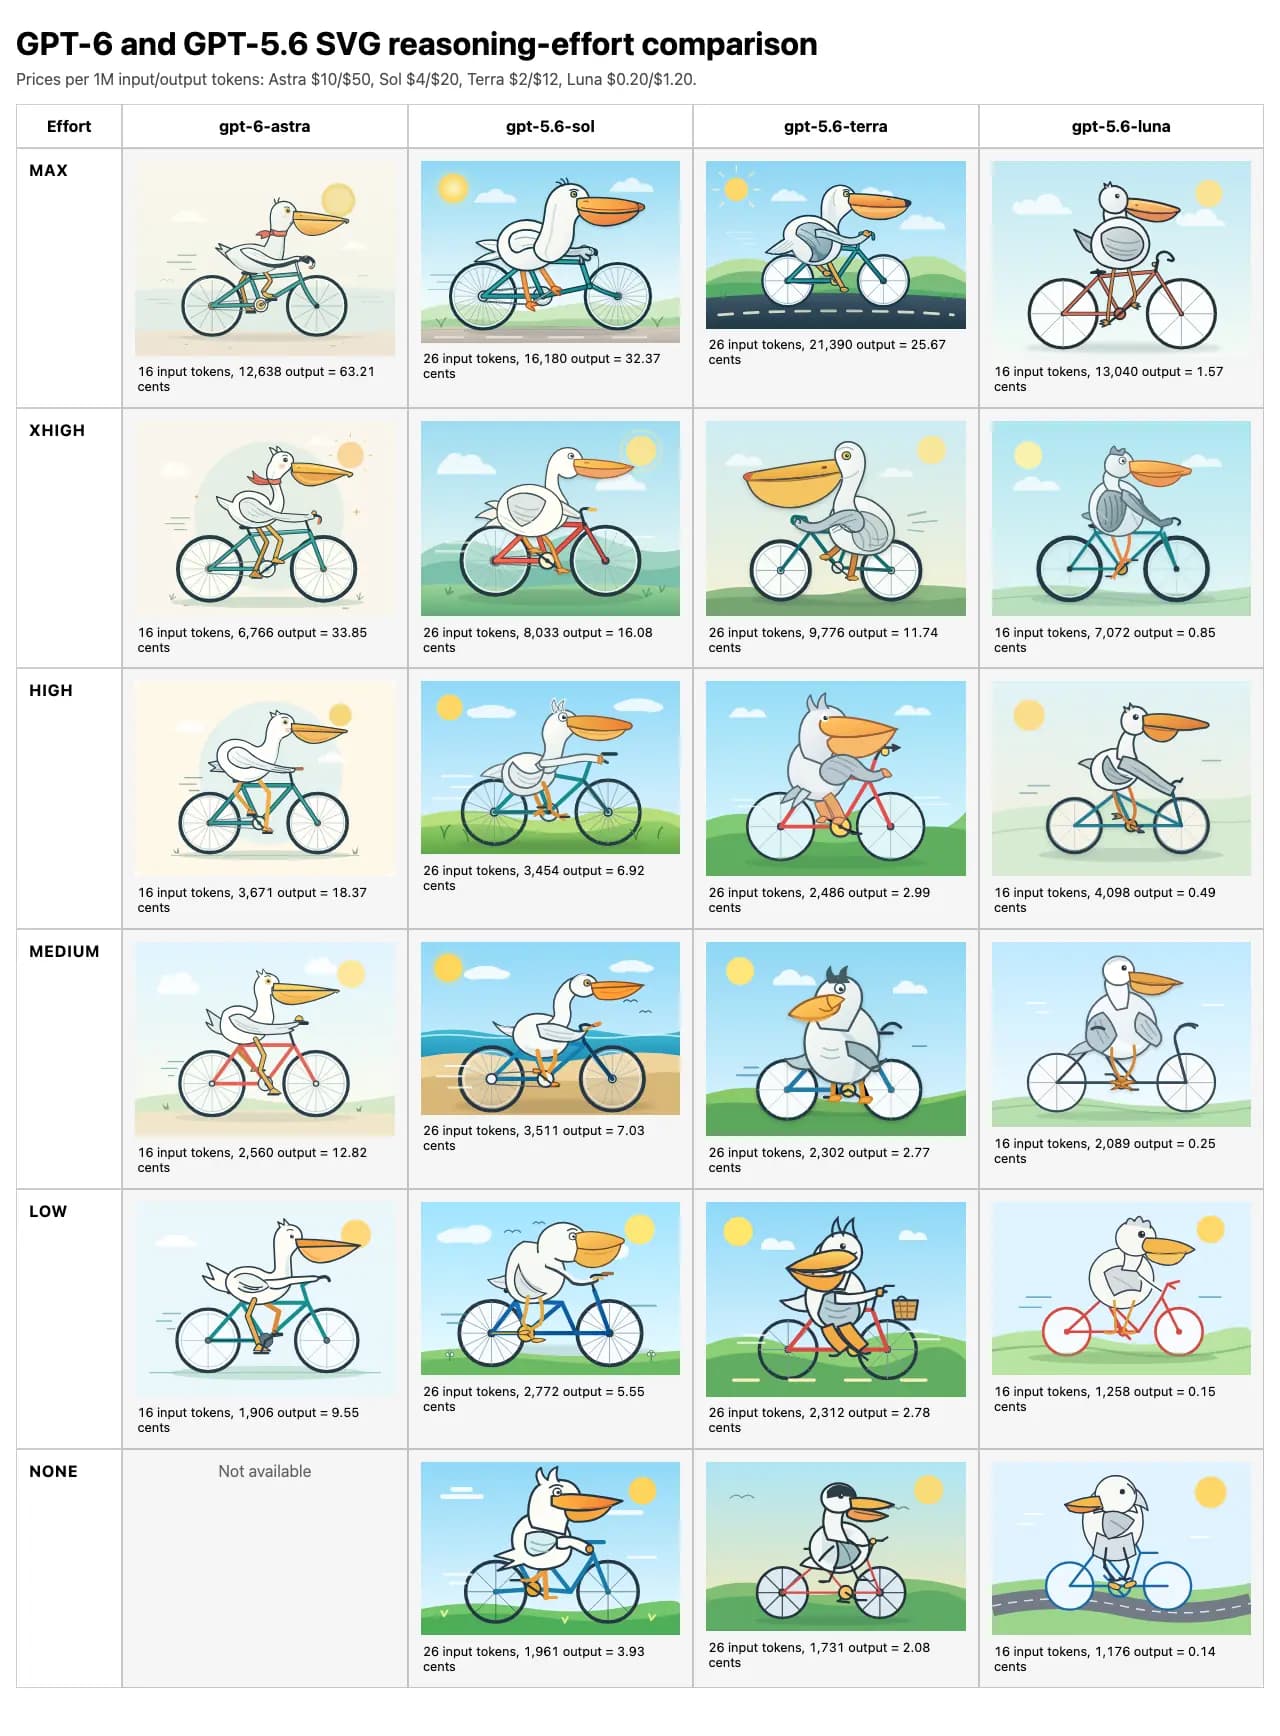
El precio por token de GPT-6 Sol y GPT-6 Luna quedó en la mitad del que tenían GPT-5.6 Sol y Luna. Es el cambio central del lanzamiento que OpenAI presentó el 22 de septiembre de 2026 y que cubrió Matthias Bastian en The Decoder. Sol pasó a 2 dólares por millón de tokens de entrada y 10 por millón de salida. Luna quedó en 0,10 y 0,50 respectivamente.
| Modelo | Entrada por millón | Salida por millón |
|---|---|---|
| GPT-6 Sol frente a GPT-5.6 Sol | 4 a 2 dólares | 20 a 10 dólares |
| GPT-6 Luna frente a GPT-5.6 Luna | 0,20 a 0,10 dólares | 1,20 a 0,50 dólares |
OpenAI atribuye la baja a mejoras en el cacheo y en la inferencia, y dice que traspasa ese ahorro directo a los usuarios. Con esos valores el catálogo queda en el mismo rango que varios modelos de pesos abiertos. Terra, que hasta ahora era el modelo más barato de la línea, dejó de estar disponible.
¿Para qué sirve cada modelo?
Según OpenAI, Sol apunta a tareas complejas que se repiten, como construir funcionalidades nuevas, revisar código, depurar y analizar datos. Luna está pensada para volúmenes grandes de tareas bien definidas y de bajo costo, entre ellas resumir documentos, extraer información y responder preguntas cortas.
Junto con el recorte de precio, OpenAI dice que mejoró el cacheo de prompts para GPT-6, con un descuento de 90% sobre los tokens de entrada cacheados. Sumó un panel de cacheo y una herramienta de diagnóstico para que los desarrolladores revisen cómo están usando la caché. Ahora se puede cambiar el nivel de esfuerzo de razonamiento y la disponibilidad de herramientas sin invalidar lo que ya está cacheado.
Los dos modelos arrancan disponibles en ChatGPT Work y en Codex para suscriptores Plus, Pro, Business, Enterprise y Edu. Los usuarios Free y Go acceden a Luna por la aplicación de escritorio. Ninguno de los dos entra de entrada al chat normal. En la API figuran como gpt-6-sol y gpt-6-luna, mientras que el acceso dentro de ChatGPT se libera por etapas.
¿Cómo se comparan con Claude?
OpenAI posiciona los modelos nuevos sobre todo por relación precio a rendimiento frente a la línea Claude de Anthropic.
En OSWorld 2.0, que mide uso de computador, OpenAI afirma que GPT-6 entrega resultados parecidos a los de Claude Opus 5 con un costo cerca de 80% menor. Astra sigue liderando esa categoría.
En AutomationBench, que prueba flujos de trabajo empresariales sobre 47 herramientas, Sol en su nivel de esfuerzo más alto supera a Claude Opus 5 en esfuerzo máximo. OpenAI sitúa el costo por tarea de Sol en 9% del de Opus. Luna mejora a su antecesor en 5,4 puntos porcentuales y cuesta 58% menos.
Para programación, OpenAI entrega resultados de dos pruebas. FrontierCode 1.1 revisa si los agentes producen código que de verdad se pueda integrar a una base existente, y mide calidad de los tests, estilo y cumplimiento de los requisitos. Sol marca 49,3% con esfuerzo máximo a 2,14 dólares por tarea, un resultado a la par de Claude Fable 5.1, que llega a 50,3% con esfuerzo máximo pero cuesta seis veces más, 12,83 dólares. Claude Opus 5 alcanza 53,4% por 4,31 dólares en esfuerzo medio, que es el ajuste donde da su mejor número en esta prueba.
Los niveles de esfuerzo se salieron de control
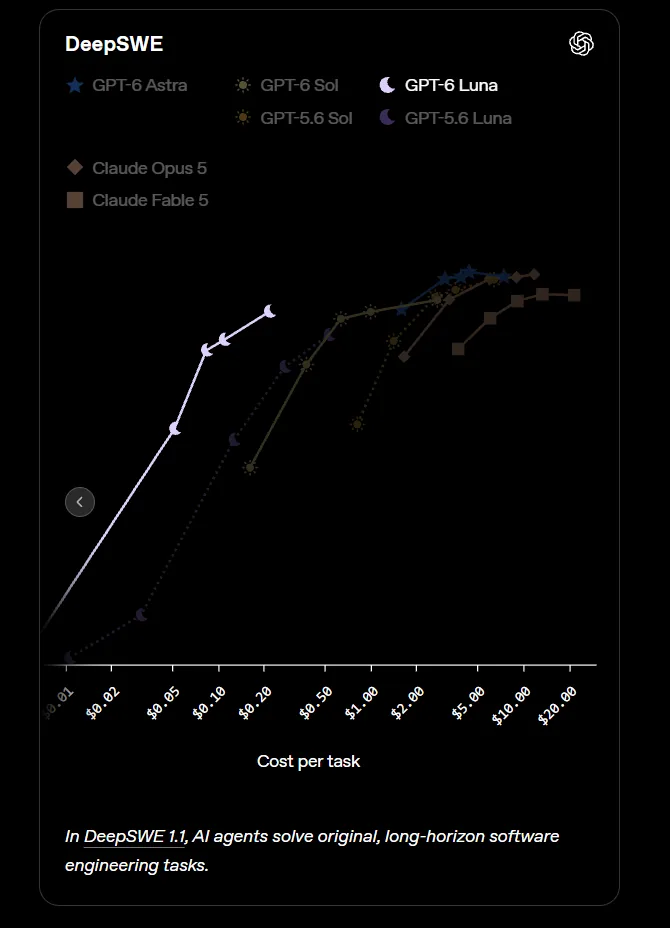
En DeepSWE v1.1, una prueba de tareas de ingeniería de software largas y exigentes sobre bases de código reales, OpenAI reporta 68,8% para Sol en esfuerzo máximo. Queda a 1,1 puntos porcentuales del mejor registro de Claude Fable 5, que marca 69,9% en el nivel "xhigh", mientras que Fable en "max" llega a 69,7% por 21,63 dólares la tarea.
Sol no está persiguiendo la frontera acá. Claude Opus 5 llega a 73,7% en esfuerzo máximo por 11,84 dólares la tarea, y el propio GPT-5.6 Sol de OpenAI marca 72,7% por 6,46. Lo que busca GPT-6 Sol es quedar cerca de esos números por una fracción del precio. En "xhigh" entrega 66,6% a 1 dólar por tarea. Luna sale aún más barata y iguala ese resultado en esfuerzo máximo por 0,22 dólares. OpenAI dice que el registro de Luna es comparable al de Claude Opus 5 y Claude Fable 5 en esfuerzo medio, con un costo 93% menor que el de Opus y 96% menor que el de Fable.
Esos mismos números convierten la elección entre los modelos de OpenAI en un dolor de cabeza. Luna en esfuerzo máximo iguala a Sol en "xhigh" y cuesta 78% menos. Subir Sol hasta el esfuerzo máximo solo lo lleva a 68,8%, apenas 2,2 puntos porcentuales sobre Luna.
La selección de pruebas que publicó OpenAI deja fuera varias de las habituales. No aparecen GDPval, que mide trabajo de conocimiento, ni Terminal-Bench 4.0, para programación agéntica. La comparación tampoco toma en cuenta el lanzamiento de Opus 5.5, que es hasta 40% más barato que Opus 5 con un rendimiento bastante mejor.
El análisis independiente ve poco avance
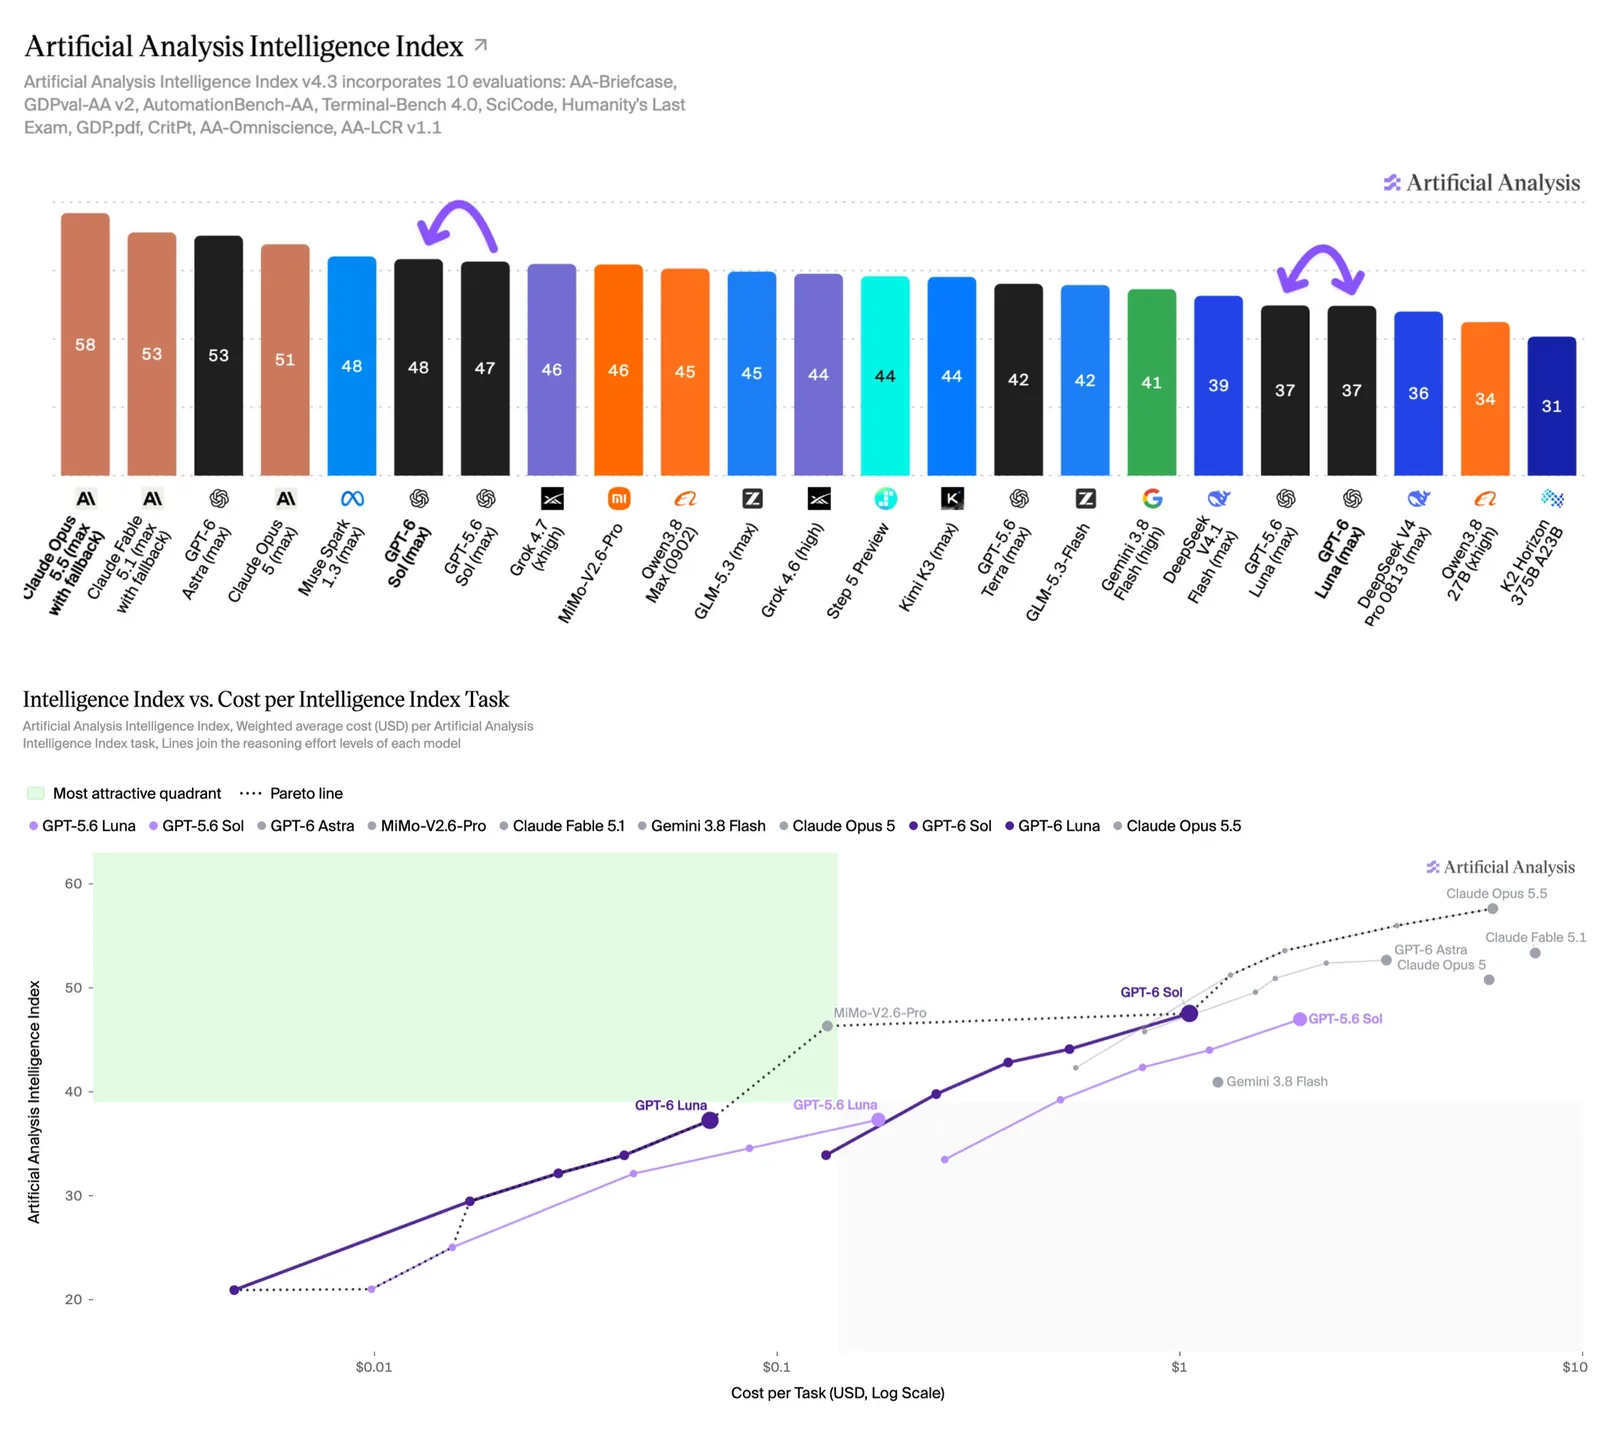
Según Artificial Analysis, GPT-6 Sol y Luna reducen a la mitad el costo por tarea frente a sus antecesores, pero los puntajes de inteligencia se quedan en los valores de GPT-5.6, con mejoras en algunas evaluaciones y retrocesos en otras. En el índice de agentes de programación, Sol sube 2 puntos y Luna baja 2.
En el Artificial Analysis Intelligence Index, Sol pasa de 47 a 48 puntos respecto de su antecesor y Luna se queda en 37. La diferencia real está en el costo por tarea, bastante más bajo.
Artificial Analysis también encontró retrocesos en dos pruebas de trabajo de conocimiento. En GDPval-AA v2.1, que evalúa trabajo de oficina en 44 campos profesionales, Sol pierde cerca de 100 puntos Elo y Luna alrededor de 75. La revisión manual atribuyó esos retrocesos sobre todo a una calidad de presentación más baja y a resultados incompletos.
La misma consultora ya recibió críticas antes, cuando calificó demasiado bajo al modelo Astra de OpenAI por usar pruebas desactualizadas. Después de eso vinieron dos actualizaciones de sus evaluaciones y Astra volvió a quedar arriba.