Un modelo de lenguaje que resuelve una tarea paso a paso hace cosas distintas en el camino (lee los datos, descompone el problema, recupera una fórmula, ejecuta un cálculo). Investigadores del KAIST y de Naver AI Lab, en Corea del Sur, quisieron saber si esos pasos también se pueden separar unos de otros dentro de las representaciones numéricas del modelo. Se pueden, y la señal es más fuerte en las capas intermedias.
¿Cómo midieron los pasos de razonamiento?
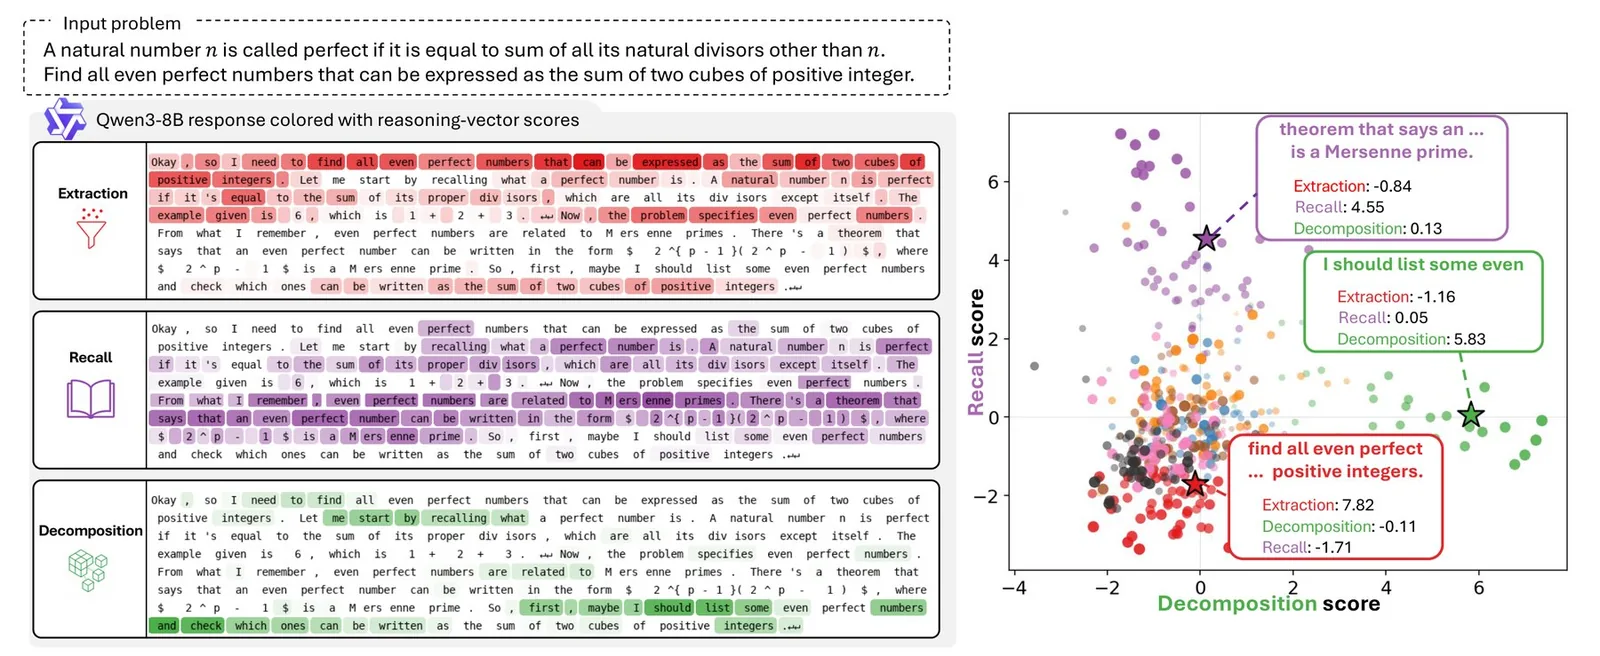
El equipo definió ocho operaciones de razonamiento recurrentes, entre ellas la extracción, la descomposición, la recuperación de fórmulas, la deducción y el cálculo. Después hizo que tres modelos resolvieran problemas de matemática, partió los caminos de solución en segmentos y usó GPT-5 para etiquetar cada segmento con una de esas operaciones.
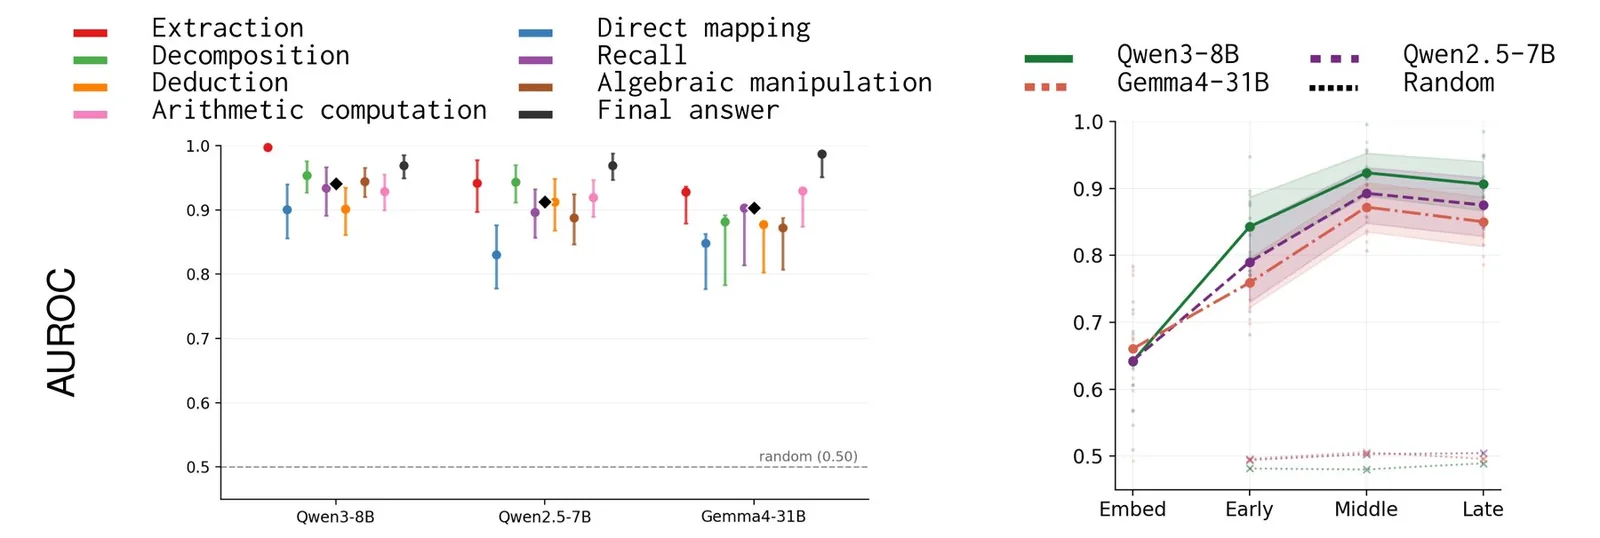
Los tres modelos evaluados fueron Qwen2.5-7B, Qwen3-8B y Gemma4-31B. En los tres, las distintas operaciones de razonamiento se distinguen de manera confiable en las representaciones internas, y la separación alcanza su punto máximo en las capas intermedias.
Los investigadores revisaron si el efecto se podía explicar por algo más simple, como la elección de palabras. Un clasificador que miraba únicamente los tokens usados rindió peor que uno que analizaba las representaciones internas. La posición dentro del camino de solución tampoco explicaba el resultado. Eso significa que los estados internos cargan información sobre el tipo de paso de razonamiento que va más allá de la redacción superficial.
La misma palabra cambia según el paso que la rodea
Palabras funcionales comunes como "un", "es" o "el" aparecen en pasos de razonamiento muy distintos. En las capas tempranas sus representaciones siguen mezcladas, pero hacia las capas intermedias y tardías se separan según la operación que las rodea. La misma palabra recibe una representación interna diferente dependiendo del paso de razonamiento al que pertenece.
El equipo probó además si un paso de razonamiento se forma de manera aislada. Cuando bloquearon la atención hacia los 30 tokens anteriores mediante una intervención dirigida, la señal de esa operación se debilitó. Los pasos de razonamiento no surgen solos, se construyen sobre el contexto previo.
¿Qué pasa cuando el modelo se equivoca?
Incluso en problemas resueltos de manera incorrecta, el tipo de paso que el modelo estaba ejecutando se mantuvo identificable, ya fuera calcular, recuperar una fórmula o deducir. Un paso de cálculo defectuoso seguía viéndose internamente como un paso de cálculo, aunque el resultado estuviera mal.
La separabilidad también aguantó en pruebas adicionales. Se replicó con Llama-3-8B, y para Qwen3-8B los clasificadores entrenados se transfirieron con éxito a GPQA-Diamond y a MATH-500.
Dicho eso, los experimentos se limitan a tareas de matemática y a un puñado de modelos. Si estos hallazgos sirven para detectar errores o para dirigir a un modelo en plena generación queda como pregunta abierta para trabajos futuros.
Lo que cambia para la supervisión de modelos
La relación entre lo que el modelo escribe y lo que computa por dentro importa para la seguridad de la IA. Leer la cadena de pensamiento es una de las pocas herramientas de supervisión disponibles, según OpenAI, pero Anthropic mostró que los modelos declaran las pistas que efectivamente usaron solo en entre 25% y 39% de los casos.
Un método que traduce los vectores internos de un modelo a texto legible reveló que Claude Opus 4.6 procesa más de lo que aparece en su razonamiento de salida. Y en el modelo Astra de OpenAI, la técnica de profundidad recurrente traslada parte del razonamiento hacia las representaciones numéricas internas, que es justamente el espacio que investiga el estudio del KAIST.