Liquid AI publicó en Hugging Face LFM2.5-24B-A2B, un modelo de razonamiento de 24.000 millones de parámetros que activa solo 2.000 millones por token. Está pensado para agentes rápidos y privados que corren en el dispositivo. Piensa antes de responder, llama herramientas y resuelve tareas de varios pasos dentro de los entornos de agentes más usados. Como cada token activa pocos parámetros, razonar sale barato y los agentes pueden quedar corriendo de forma continua en hardware propio.
Liquid AI resume el lanzamiento en tres puntos.
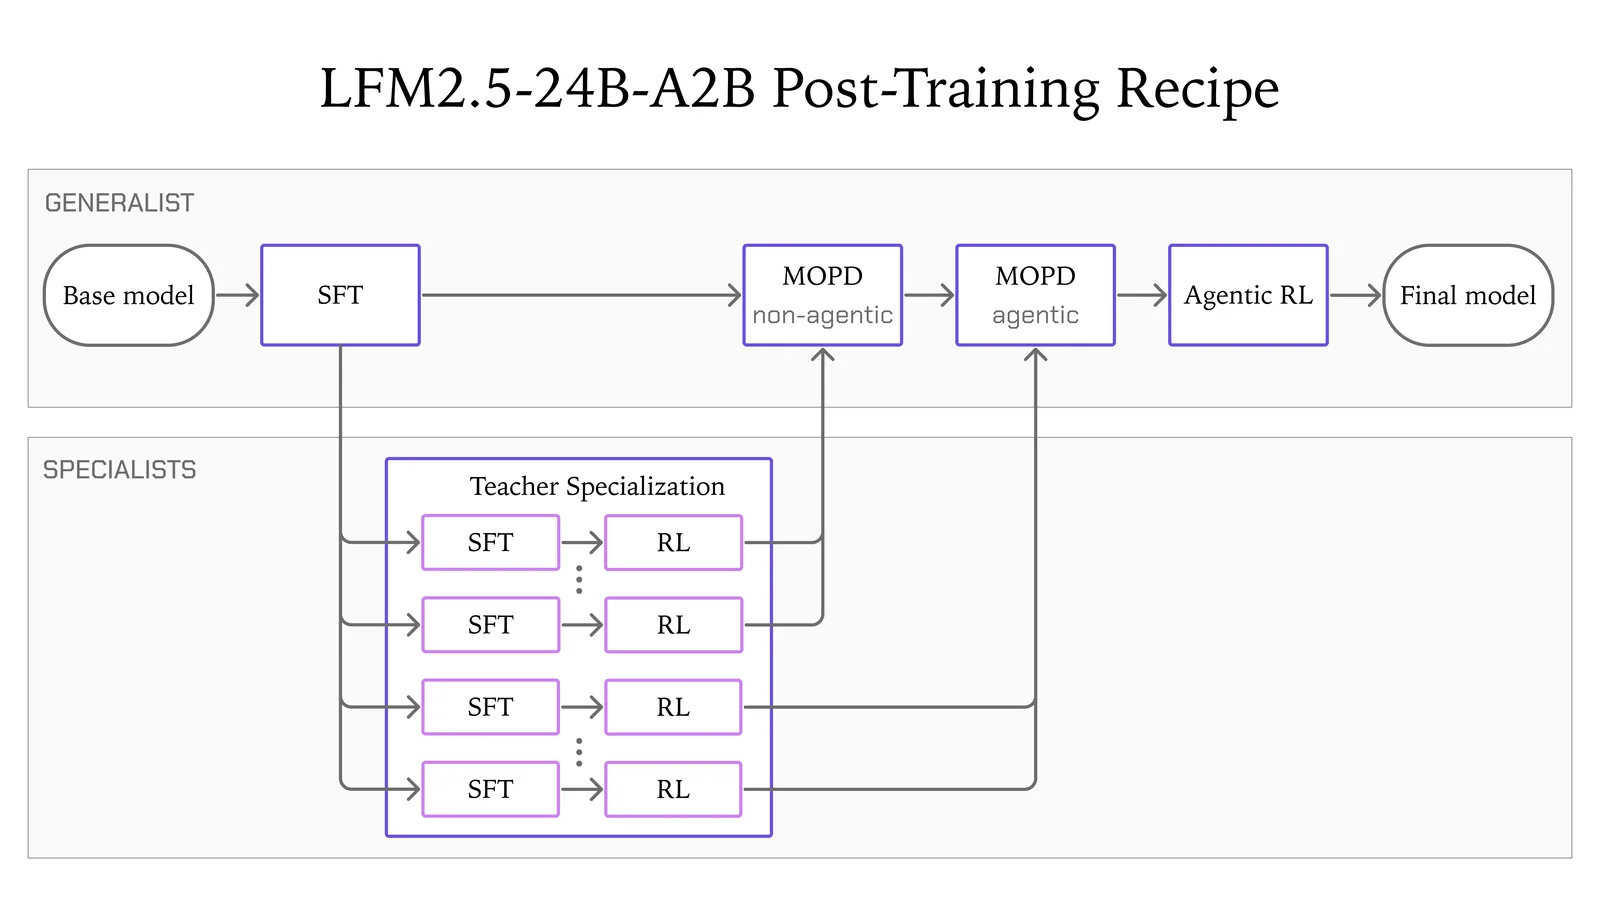
- Agentes. Compite con Qwen3.6-35B-A3B, que tiene cerca de 50% más parámetros totales y activos, en tareas de agentes y uso de herramientas. En LiveClaw marca 48,09 contra 38,19.
- Razonamiento con velocidad de MoE. Siempre razona antes de contestar, y con 2.000 millones de parámetros activos cada token de razonamiento cuesta poco.
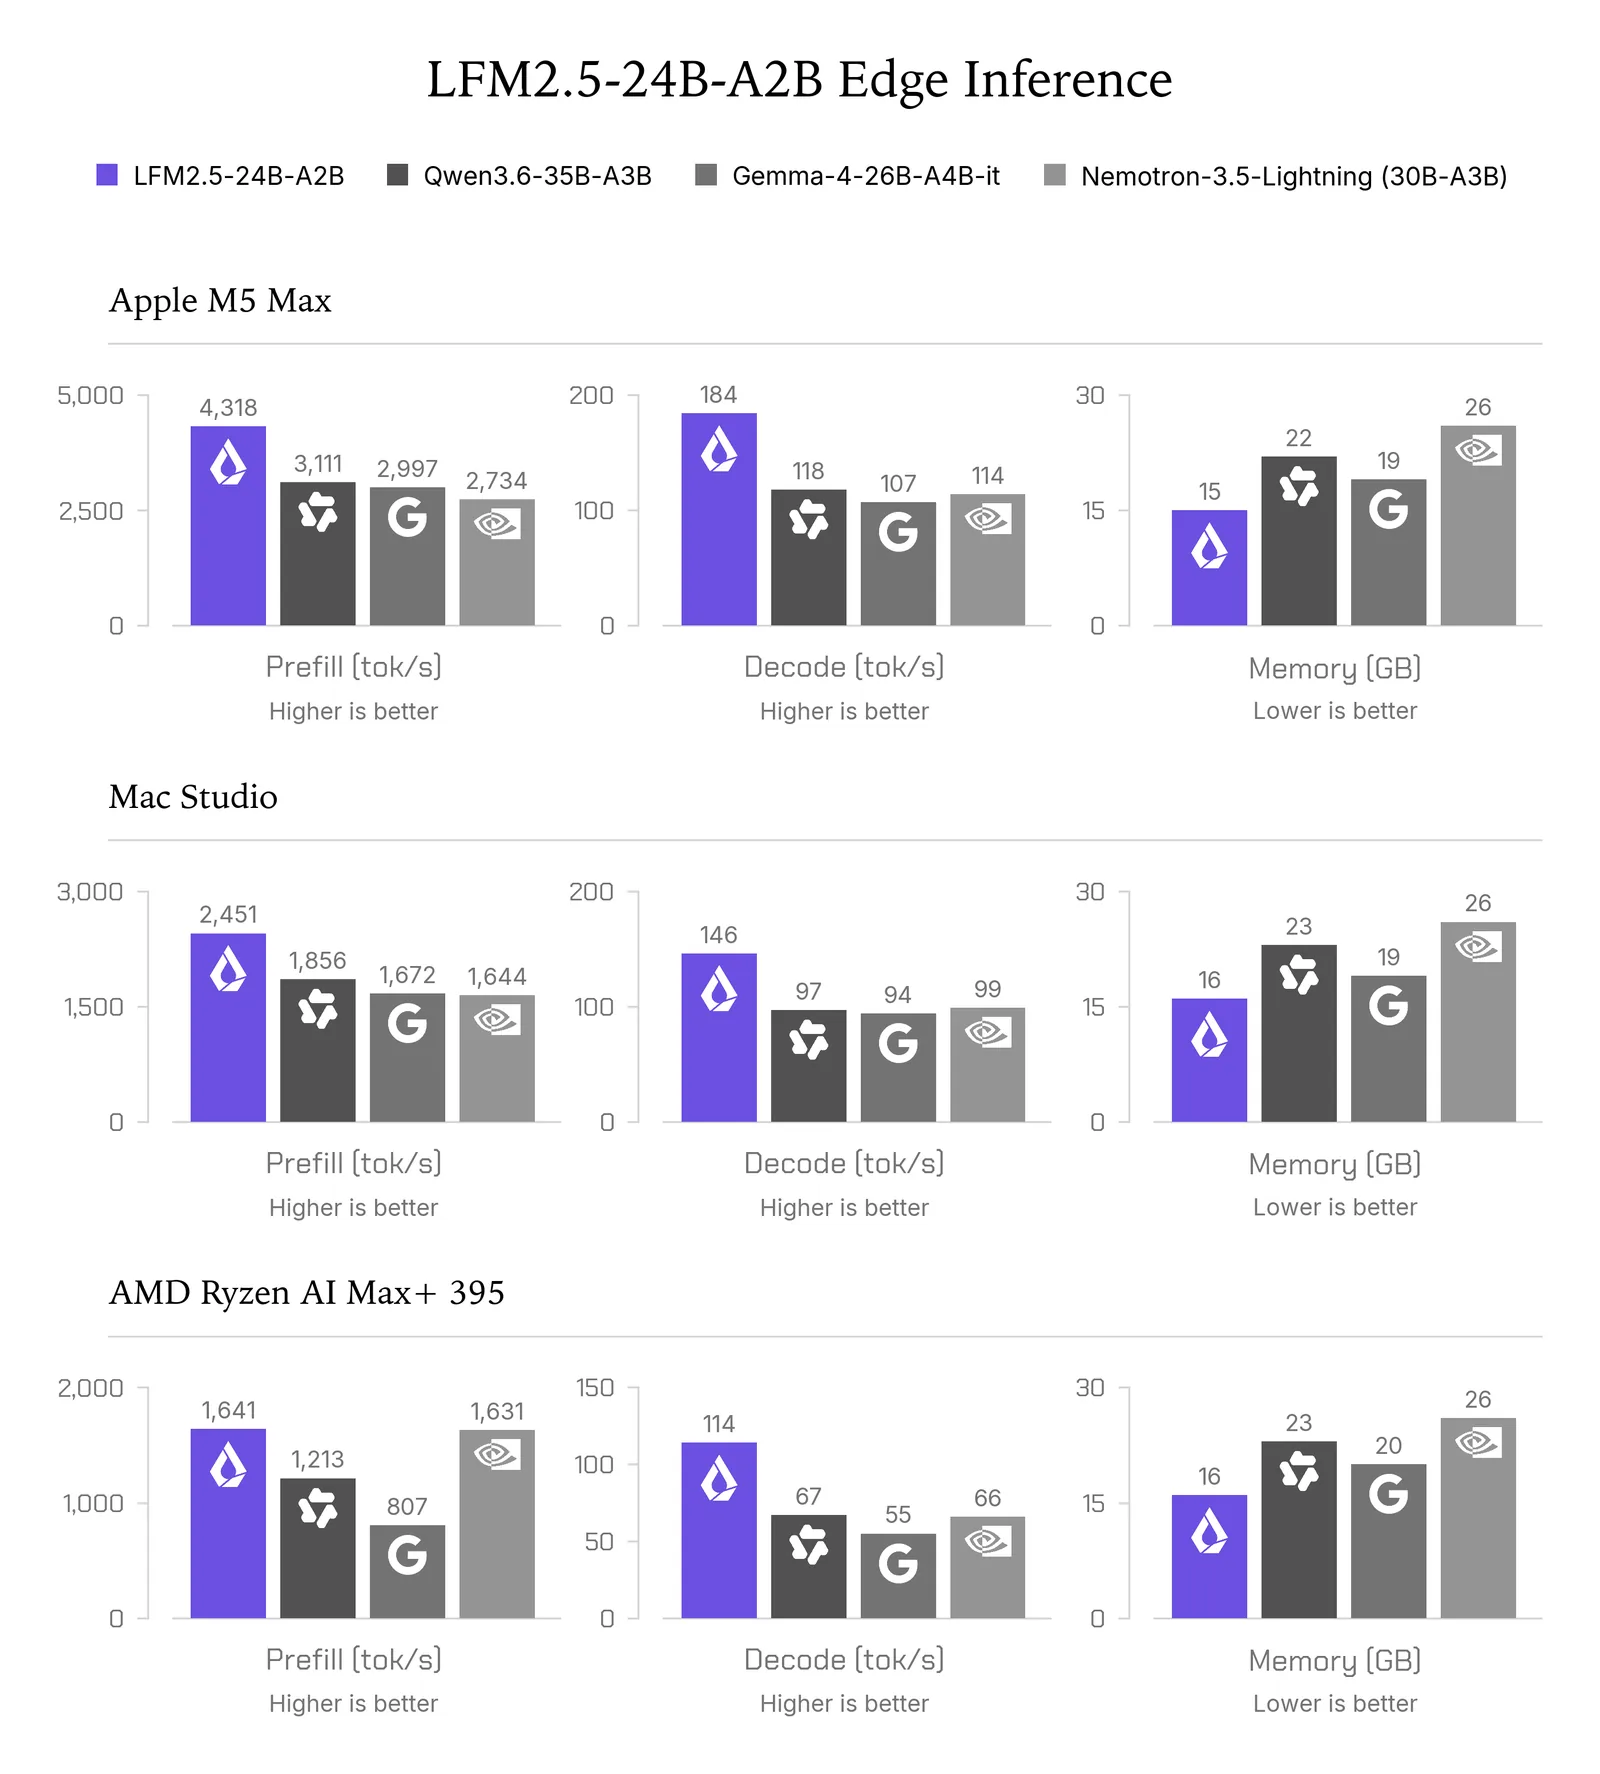
- Inferencia eficiente. Llega a 184 tokens por segundo en un Apple M5 Max y hasta 21.000 tokens de salida por segundo en una sola GPU NVIDIA B300.
¿Cómo se construyó?
LFM2.5-24B-A2B parte de LFM2-24B-A2B y mantiene su arquitectura. Son 40 capas, 64 expertos por bloque MoE con enrutamiento top-4 y la misma mezcla híbrida de convoluciones cortas con compuerta y atención GQA. La ventana de contexto sube de 32.000 a 131.000 tokens, y una ampliación del tokenizador en el lugar duplica el vocabulario de 65.000 a 128.000 tokens para tokenizar mejor los idiomas con alfabetos no latinos. A diferencia de su antecesor, es un modelo solo de razonamiento, que produce una cadena de pensamiento explícita antes de la respuesta final.
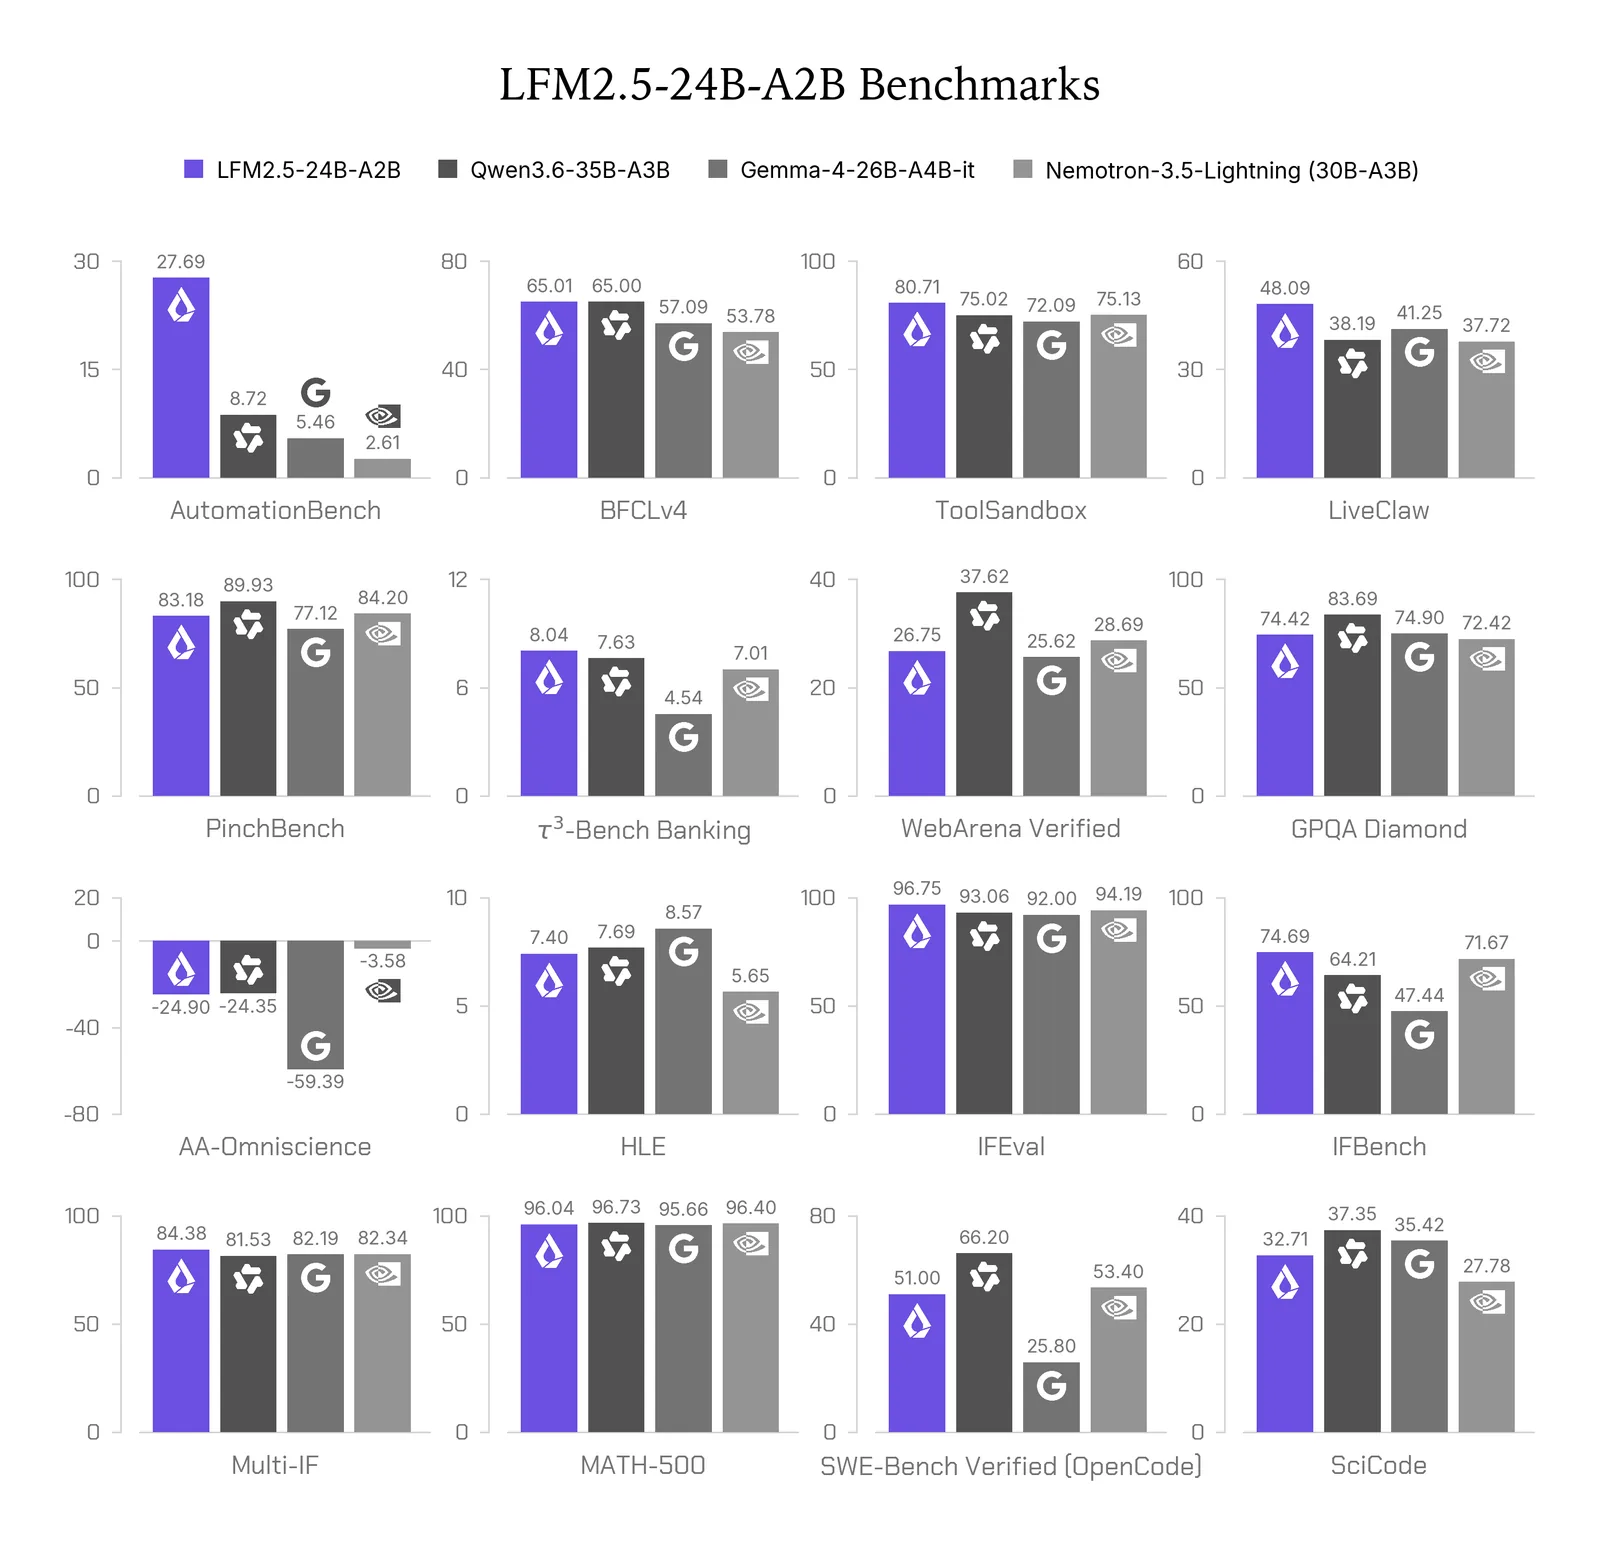
El preentrenamiento pasó de unos 17 billones a unos 33 billones de tokens. Después, una fase intermedia agrega 2 billones de tokens con contexto de 32.000, cargados hacia razonamiento, matemáticas, código, seguimiento de instrucciones y texto multilingüe, y otros 300.000 millones con contexto de 131.000, cargados hacia datos de contexto largo. Las llamadas a herramientas y las conversaciones de varios turnos aparecen en ambas fases. El postentrenamiento convierte el modelo base en un agente en cinco etapas.
- Ajuste fino supervisado (SFT).
- Especialización de modelos maestros.
- Destilación multidominio con datos del propio modelo (MOPD), sin agentes. Destila a los maestros especialistas en tareas que no son de agentes.
- MOPD con agentes. Una segunda etapa de destilación centrada en tareas de agentes.
- Aprendizaje por refuerzo con agentes. Entrena el modelo dentro de entornos de agentes como OpenClaw, Hermes Agent, Pi y OpenCode.
¿Cómo le va en los benchmarks?
Liquid AI comparó LFM2.5-24B-A2B con Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it y Nemotron-3.5-Lightning en 16 benchmarks de uso de herramientas, flujos de agentes, conocimiento, seguimiento de instrucciones, matemáticas y código. Es el modelo más chico del grupo y aun así compite con MoE que tienen cerca de 50% más parámetros totales y activos. Todos los modelos se evaluaron con vLLM y con los parámetros de generación que recomienda cada benchmark.
Sus fortalezas son el uso de herramientas y el seguimiento de instrucciones. Lidera o empata en cinco de los ocho benchmarks de herramientas y agentes (AutomationBench, BFCLv4, ToolSandbox, LiveClaw y τ³-Bench Banking), y en AutomationBench saca más del triple que el segundo mejor modelo. También lidera los tres benchmarks de seguimiento de instrucciones.
Los modelos más grandes mantienen ventaja en pruebas de conocimiento como GPQA Diamond, HLE y AA-Omniscience, y en código, con SWE-Bench Verified (sobre OpenCode) y SciCode. Para cargas que dependen de conocimiento, Liquid AI recomienda combinarlo con recuperación de documentos o búsqueda web.
Velocidad en CPU y GPU
El modelo sale con soporte desde el primer día en llama.cpp, MLX, vLLM, SGLang y ONNX.
En el borde. Es el más rápido de los MoE comparados. Decodifica 184 tokens por segundo en un M5 Max y 114 en un Ryzen AI Max+ 395, hasta 1,7 veces más rápido que el siguiente modelo, y usa la menor cantidad de memoria.
En GPU. Es el más rápido de su categoría de tamaño y supera los 21.000 tokens de salida por segundo con alta concurrencia en una sola B300.
¿Cómo se usa?
Hay que instalar la versión más reciente de transformers (compatible con transformers>=5.0.0).
pip install -U transformersDespués se carga y se ejecuta el modelo.
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
Dentro de un entorno de agentes
El modelo se puede servir de forma local detrás de cualquier backend compatible con la API de OpenAI y conectar el entorno de agentes a ese servidor. Con Hermes Agent, por ejemplo, la configuración queda así.
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
El puerto depende del backend. llama.cpp y MLX usan el 8080, vLLM el 8000, SGLang el 30000 y LM Studio el 1234. La ficha del modelo trae las configuraciones para OpenClaw y Pi, y la guía de Liquid AI explica la instalación completa. El blog del lanzamiento tiene ejemplos en video.
Dónde descargarlo
LFM2.5-24B-A2B y LFM2.5-24B-A2B-Base son de pesos abiertos y ya están en Hugging Face.
- Descarga. LFM2.5-24B-A2B-Base y LFM2.5-24B-A2B.
- Uso en agentes. La guía explica cómo correr un agente local con OpenClaw, Hermes Agent o Pi.
- Ajuste fino. Liquid AI publica tutoriales de ajuste fino para adaptar el modelo a una tarea.